快速导读:GOTT 把灵巧执行拆成靠近、获取接触与沿物体轨迹运动,用同一个跨本体闭环原语把近似初始化收成稳定接触。
基础模型与大规模人类数据可以给出操作意图,平行夹爪也已有抓取、放置与轨迹跟随等底层技能。多指灵巧手却缺少可在任务与机器人之间复用的对应原语:任务特定策略要为每个新行为重训,运动重定向又常缺少感知反馈,接触丰富的任务在真机上很难跑稳。物体轨迹能说明刚体应如何运动,却不说明手该在何处、以何种方式建立功能接触——抓住电钻夹头也许几何稳定,却没法干活。GOTT(General Object Trajectory Tracking,arXiv:2610.03861,Amazon FAR、UC San Diego、University of Chicago、UC Berkeley)把高层接口收成一条与机器人无关的物体轨迹,外加一份把手当到任务相关接触区附近的靠近规格。项目页为 https://dex-gott.github.io
框架按靠近、获取接触、再运动三段执行。靠近阶段只负责可行接近;一个共享的闭环接触获取原语从这份近似初始化建立稳定接触;随后位姿条件控制器跟踪目标物体运动。原语只看局部手–物体几何与本体感觉历史,并用规范链表示在不同灵巧手之间共享。仿真统一策略平均抬升成功78.7%,真机三平台抬升90–96%;Franka-Sharpa上四项操作任务平均任务成功80.0%,两个开环抓取基线为35.0%。预印本尚未同行评审。
英文题目:GOTT: Object-centric Dexterous Manipulation with a Reusable Cross-Embodiment Primitive
论文出处:arXiv 每日论文精选 · arXiv:2610.03861
原始论文:PDF / 论文页面
这篇论文解决什么问题?
把高层意图翻译成多指行为仍然难。现有灵巧操作多走任务特定sim-to-real,或从演示恢复运动学目标。前者难以扩展,后者缺少闭环反馈。关键问题是:高层操作意图与底层灵巧执行之间,什么样的接口才合适。
物体中心运动是一个候选:许多刚体任务可以由目标物体运动描述,从而抽象掉本体特定的机器人轨迹。缺口在于接触。先前工作要么额外提供预抓取或手部参考,要么把接触获取与轨迹执行联合学习。它们有效,但没有把接触获取暴露成可跨高层来源与机器人本体复用的技能。GOTT的选择是:高层只提供物体轨迹与任务相关的靠近,一个轨迹无关的原语在跟踪开始前把近似到达收成稳定接触。
核心创新
- 把灵巧执行拆成靠近、获取接触与运动,让接触原语与高层来源、手臂可达性解耦。
- 用带掩码的规范链/关节表示训练一个跨手闭环获取策略。
- 默认用VLM功能区与未来感知IK构造靠近规格,也兼容演示与外部模型。
方法概览
GOTT(General Object Trajectory Tracking)的高层接口是物体轨迹τo与靠近规格ρ=(ξapp,ginit)。靠近阶段沿接近轨迹到达近似初始构型;获取阶段用只看局部手–物体几何与本体感觉历史的闭环RL策略建立稳定接触;运动阶段把接触后的手–物体变换近似为固定,用位姿条件控制器跟踪τo。原语用链到物体点云最近点的位移、链位置、关节与历史目标,输出6D腕部增量与关节增量。跨本体时把不同手映射到21关键点与26槽规范关节,缺失项填充并加二值掩码,执行前再掩掉填充关节。默认规划用VLM从四视图标出任务相关接触区,BODex轻量初始化采样N=10个候选,再沿整段τo做碰撞自由接近与未来感知IK,丢掉后期不可行者,选累计关节运动最小的候选。也可用参考抓取或人手接近轨迹替换部分规划。部署用SAM2分割、FoundationPose跟踪,本体感觉接触预测器决定从获取切到跟踪。
- 给定物体轨迹τo={TO,t}与靠近规格ρ=(ξapp,ginit),靠近阶段沿接近轨迹走到近似初始构型ginit;获取阶段由闭环策略接管腕与手指;运动阶段在检测到稳定接触后沿τo跟踪。高层因此不必给出精确可执行的最终抓取,只要一份可行的近似到达。
- 接触获取策略在仿真里用强化学习训练并迁到真机。观测含三部分:每条链到物体点云最近点的位移(link-distance)、链位置,以及关节位置与上一时刻关节目标;后两部分堆叠最近五步。动作是6D腕部增量加手指关节增量。奖励为wd r_dist + wc r_contact + wl r_lift + wo r_obj,分别鼓励链靠近物体、拇指与另一指形成对向接触、接触后抬升,以及物体稳定。训练随机化物体尺度、摩擦与质量,机器人链摩擦,执行器刚度与阻尼,并在握住后施加力/力矩扰动。部署时另训本体感觉接触预测器,输出五指接触概率;当拇指与至少另一指连续k步超过阈值τc,获取结束。
- 跨本体时,不同手被映到含1个手掌加每指4点的21关键点拓扑,以及26槽规范关节顺序。缺失项用最近链填充或零填充,二值掩码区分有效与填充。策略输出6D末端增量与规范关节增量,执行前掩掉填充关节并映回本体索引,从而不必为每只手做专用编解码器。训练集为16个YCB物体;每个物体–静止位姿对用BODex生成4000个初始手部构型,策略从这些构型出发建立接触并抬起物体。
- 默认物体中心设定下,规划器还要决定在哪接触、选哪个初始构型,使接近与后续手臂运动沿整段τo都可行。作者用VLM看物体四视图,标出任务相关抓取部位关键点,反投到网格并跨视图投票得到接触区R。再在R内用BODex轻量初始化采样N=10个候选。对每个候选先规划无碰接近,再把接触时的手–物变换固定、沿τo滚出手部运动并逐步求IK;接近不可行、关节越限或求解失败的候选被丢弃,剩下的选累计关节运动最小者。人手演示或外部模型也可以直接提供接触区、初始构型或接近轨迹,替换相应规划步骤;更丰富的指导会少做规划,但未必考虑机器人可达性,因此手臂–灵巧手执行仍默认保留未来感知规划。真机用SAM2分割目标、FoundationPose以45 Hz估计位姿,策略10 Hz取最新位姿;手链到物体表面最小距离低于ε_approach时切入原语。
逐图理解论文
靠近获取再运动
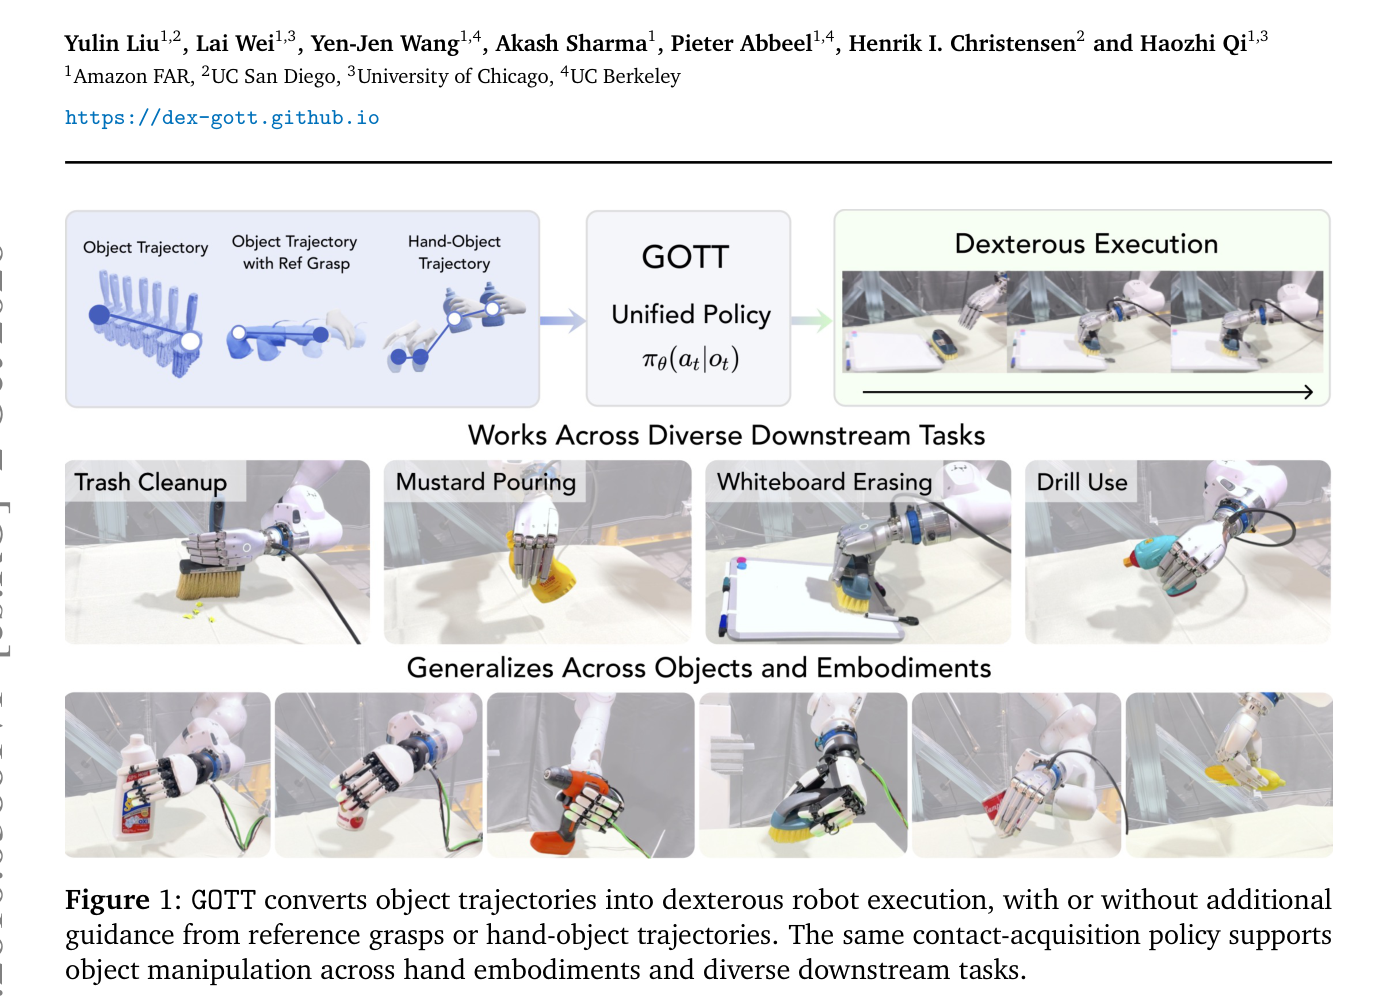
图1是GOTT总览,宜作特色图。页眉有作者单位与项目页https://dex-gott.github.io。顶行从左到右:浅蓝框列出Object Trajectory、Object Trajectory with Ref Grasp、Hand-Object Trajectory三种输入,经GOTT Unified Policy πθ(at|ot)接到绿色Dexterous Execution三连帧。中行Works Across Diverse Downstream Tasks给出Trash Cleanup、Mustard Pouring、Whiteboard Erasing、Drill Use四张真机图。底行Generalizes Across Objects and Embodiments是七张不同物体与灵巧手的抓取照片。
规划与多种来源
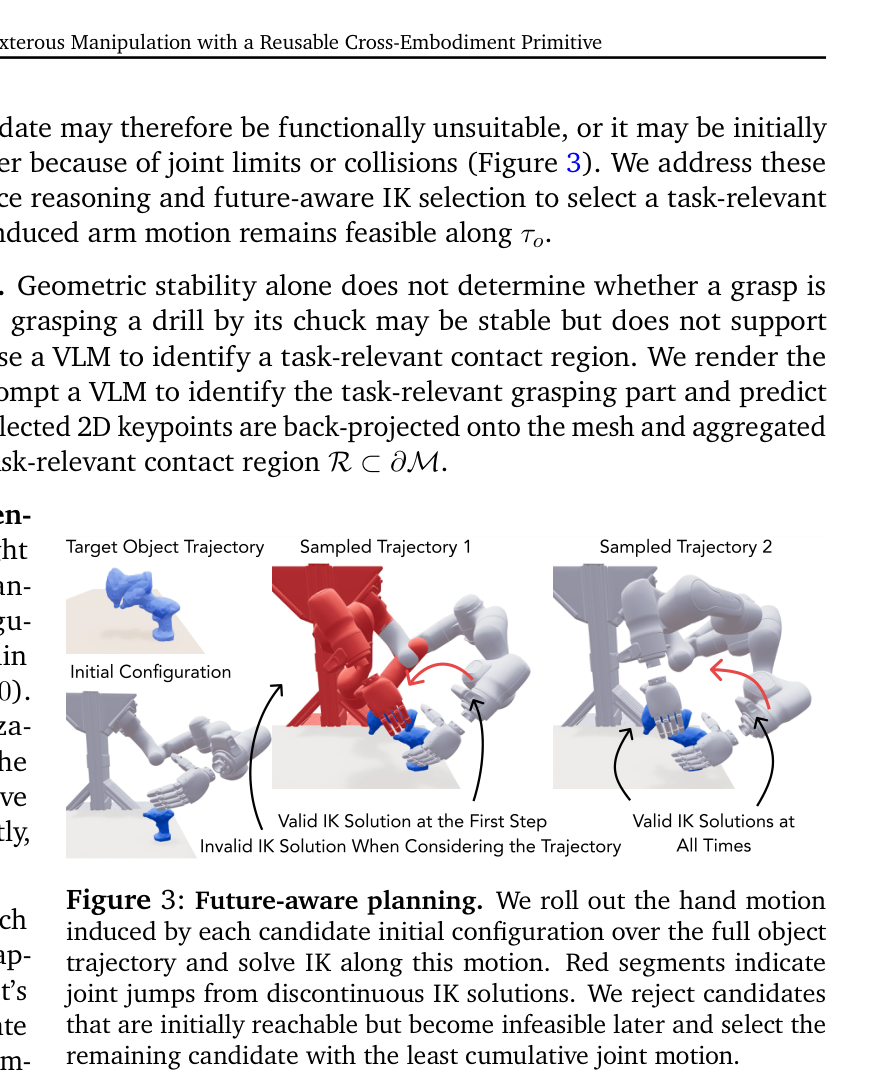
图3说明未来感知规划。三块仿真:左为Target Object Trajectory,灰色臂手靠近蓝色电钻,标Initial Configuration;中为Sampled Trajectory 1,手臂变红并带红箭头,标Valid IK Solution at the First Step与Invalid IK Solution When Considering the Trajectory;右为Sampled Trajectory 2,全程灰色,标Valid IK Solutions at All Times。红段表示不连续IK造成的关节跳变。裁切左侧残留正文,讲图时忽略。
Figure 2: Contact-acquisition training and cross-embodiment policy
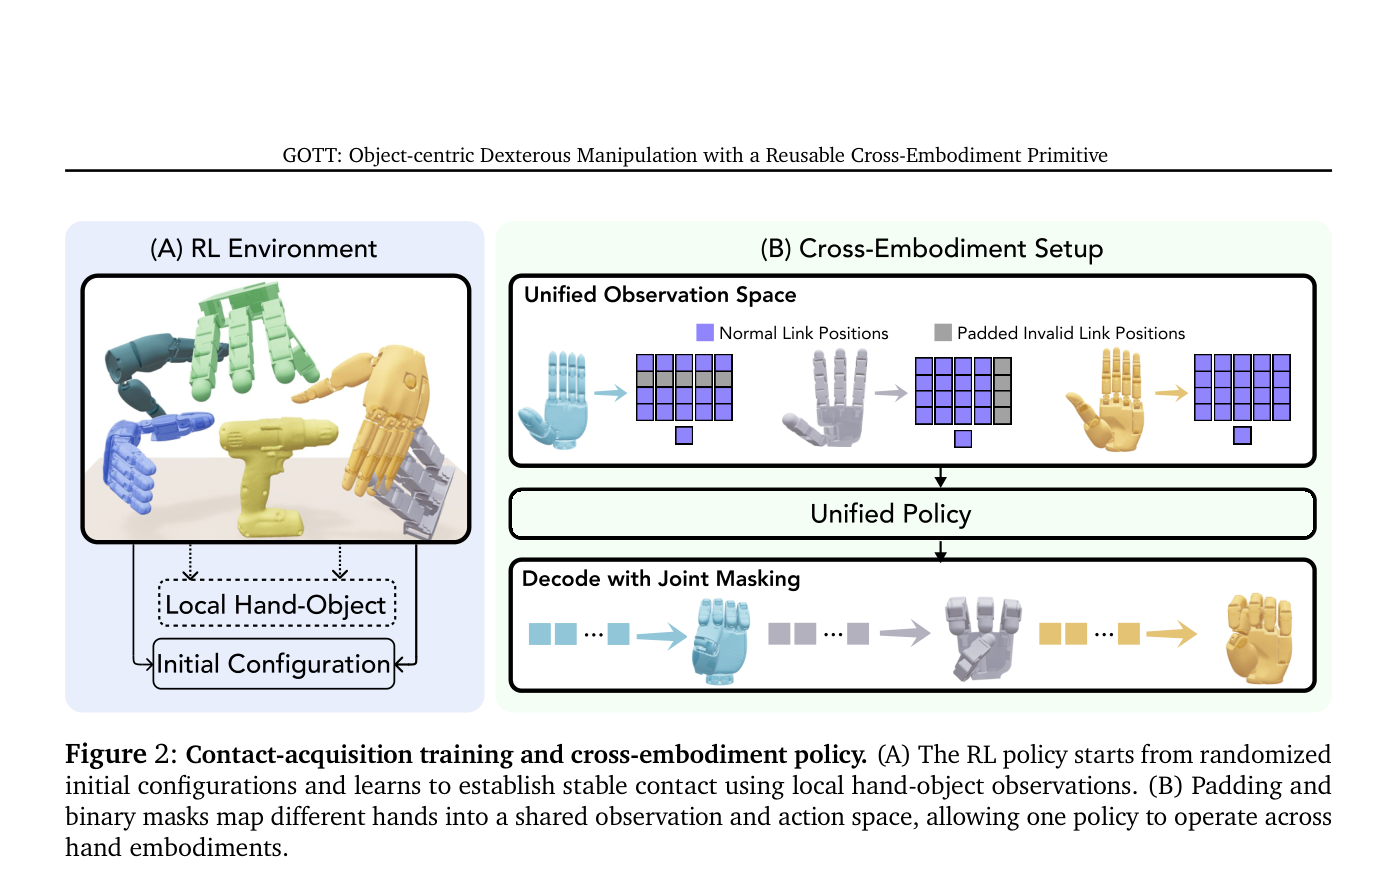
图2分(A)(B)。左侧蓝色(A) RL Environment:蓝、青、绿、黄四只仿真手围着桌上黄色电钻,标注Local Hand-Object与Initial Configuration。右侧绿色(B) Cross-Embodiment Setup:Unified Observation Space把三只手映到格子,紫色为Normal Link Positions、灰色为Padded Invalid Link Positions;经Unified Policy后,Decode with Joint Masking再映回各手关节。页眉为论文标题。
实验如何设计?
- 统一策略在IsaacLab用PPO训练XHand、Sharpa与Allegro,2000个epoch、4096并行环境。仿真抬升用浮动手桌面设定,评DexGraspNet:去掉扁平物体并四档缩放后9588个资产、54149个实例,摩擦1.5、质量100 g。每个实例用BODex第一阶段生成20个共享初始位姿。BODex与DRO开环执行其预测的预抓取;GOTT从原始初始位姿做闭环获取。成功定义为建立接触、抬升至少5 cm并在评测地平内保持稳定。
- 真机在Franka Research 3与Tianji两台7自由度臂上配对XHand(12 DoF)与Sharpa Wave(22 DoF)。物体网格用AR Code采集。抬升实验每平台10个物体各5次,共50次,成功需抬升至少5 cm并稳定至少3秒。端到端任务在Franka-Sharpa上评清扫、芥末倾倒、白板擦除与电钻使用,各10次变化初始位姿;开环对照只把区域条件候选生成换成BODex或DRO的完整抓取生成,其余感知、VLM功能推理、未来感知IK与跟踪保持不变。
- 跨形态评测包括三手联合训练对比专家策略,以及去掉指节的未见Allegro变体。工作空间实验在SimToolReal的橡皮对象上做5 cm抬升、600个仿真回合,扫平面位置与桌高偏移。高层来源实验包括人类演示、生成视频与关键点插值得到的物体轨迹,以及499条DexYCB左手序列的零样本执行。消融一次改一项观测或奖励,并在20个匹配的电钻场景上比较功能区与未来感知选取。
关键结果与论文证据
- Table 1上GOTT在三只左手上的抬升都高于开环BODex与DRO。统一策略平均78.7%(XHand 74.1、Sharpa 75.0、Allegro 87.1),高于专家策略平均75.4%,也高于同一框架内重实现的CrossDex统一策略51.7%。策略只在16个YCB物体上训练,却泛化到9588个DexGraspNet资产。作者强调其基线数字低于原论文,因为物体从一开始就在重力下的桌面上,而不是接触后再开重力。
- 同一检查点在Franka-Sharpa、Franka-XHand与Tianji-XHand上真机抬升成功90%、90%与96%。零样本到未见Allegro变体时,三手统一策略平均72.1%,几乎对齐每变体oracle的72.2%,而只在原版Allegro上训练的策略仅17.2%,说明迁移来自多形态联合训练,而不是规范表示本身。
- Table 3上GOTT在四项真机任务都取得最高抓取与任务成功,平均抓取87.5%、任务80.0%,两个开环基线均为57.5%与35.0%。失败模式包括不合适的接触区、接近时把物体撞开,以及缺少拇指–手指对向接触的笼状抓取;后者使DRO在清扫上任务成功0/10,刷子在清扫中滑脱。闭环控制器可以用腕与手指从不完美的初始化里恢复。
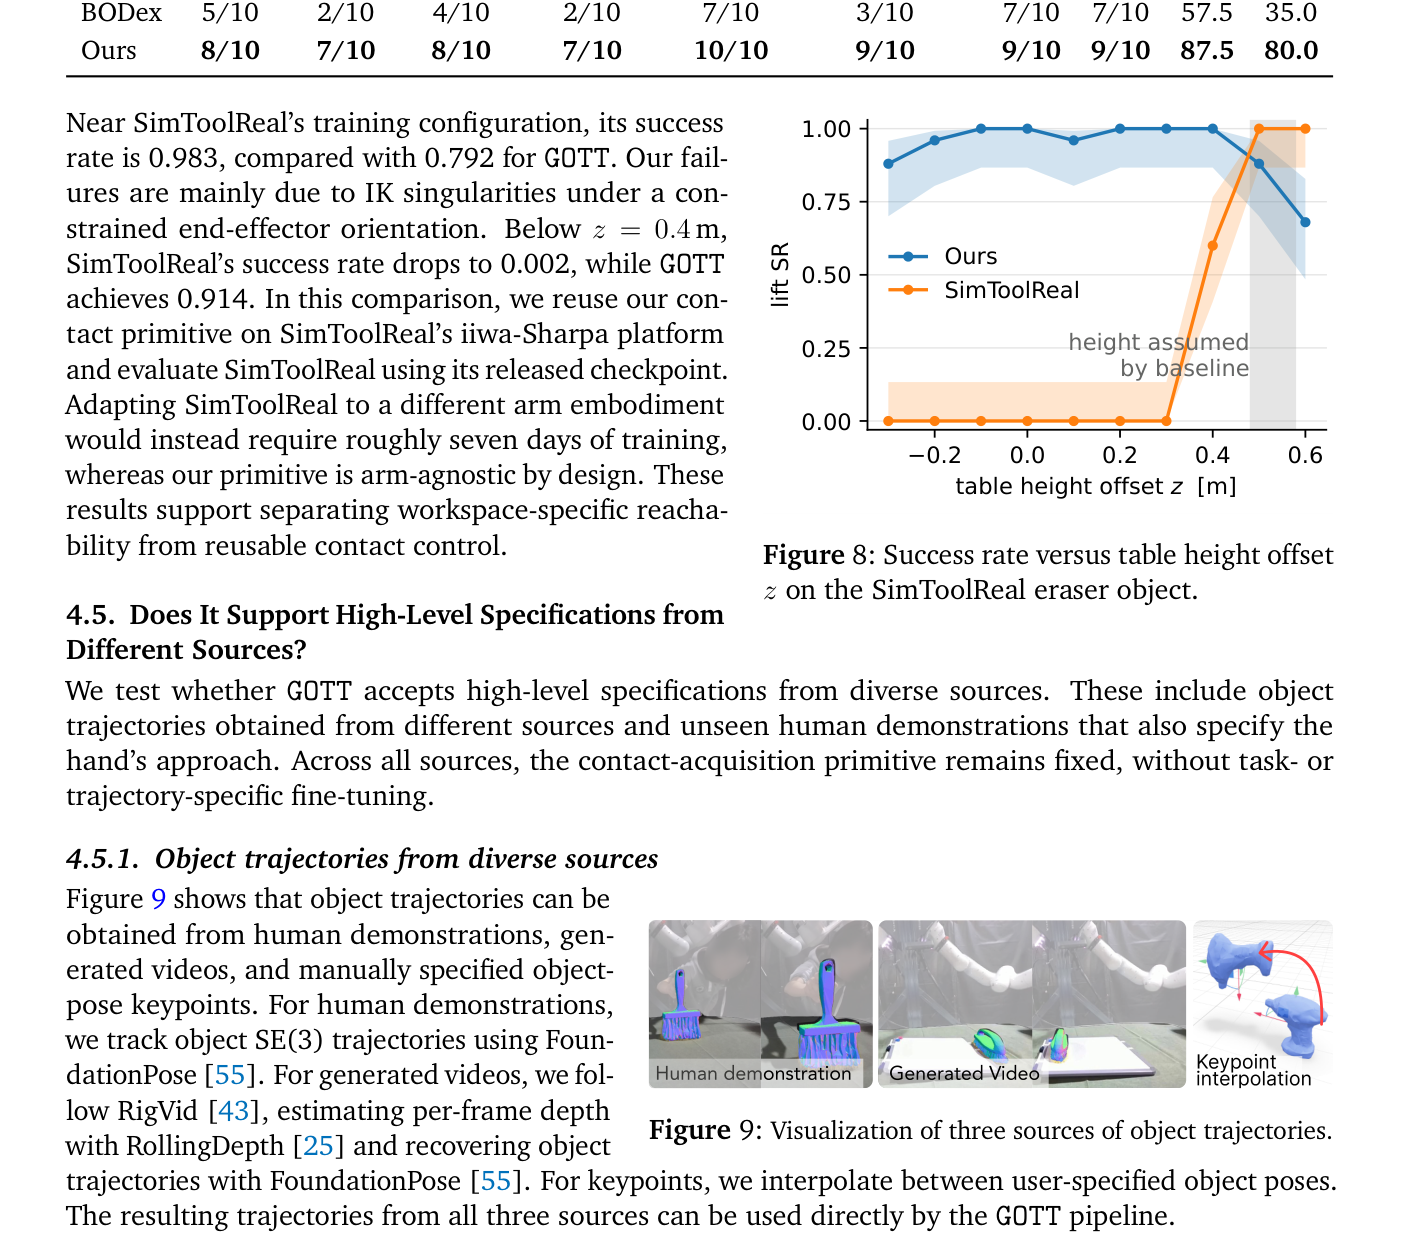
- 在SimToolReal训练配置附近,其成功率为0.983、GOTT为0.792,失败主要来自受约束末端朝向下的IK奇异。桌高偏移低于0.4 m时,SimToolReal降到0.002,GOTT在其iiwa-Sharpa上为0.914;把SimToolReal迁到另一只手臂约需七天训练,而接触原语按设计与手臂无关。499条未见DexYCB上,开环运动重放在MuJoCo仅12.6%,GOTT在IsaacLab/ManiSkill/MuJoCo为71.5/72.9/69.7%,无需逐条微调;SPIDER在MuJoCo 76.0%但要逐条物理优化。
- Table 4显示去掉对向接触或抬升奖励后平均成功低于2%;本体感觉历史缩到一步平均掉15.7个百分点;OHRA风格点云观测即使改成更轻的PointNet也只有25.7%。r_dist在训练手上只温和提升抬升,但能抑制手指反转;去掉后未见Allegro变体从72.1%降到55.1%。电钻20场景上,随机选取抓取成功100%但任务成功仅20%;加上未来感知IK后轨迹成功升到90%,功能正确与整体任务仍约30%;VLM功能区把功能正确提到65–85%,整体任务成功50–65%。
阅读时需要注意
- 高层规划与接触获取仍然串行。更紧的反馈才可能从糟糕的靠近规格中在线恢复。轨迹跟踪依赖视觉物体位姿,严重手–物遮挡时会失败;触觉或视触状态估计是自然下一步。
- 接触后把手–物体变换当作近似固定,限制了旋松一类需要变换改变的手内操作。仿真对照使用比原论文更严的桌面重力协议,不宜把表中BODex/DRO数字与其原报告直接混比。预印本未同行评审。
关联工作
- ManipGen把可复用局部策略与基础模型和运动规划结合;SPOT从人类演示学物体位姿轨迹再条件化机器人策略;VLM-Scaffold把类似管线接到灵巧手,但依赖任务特定残差RL;LUCID从无结构人类视频学本体无关意图,再经物体光流与粗略掌心位姿连到本体特定策略。GOTT用物体轨迹加灵活靠近规格,经可复用接触原语落地。
- D-Grasp、Human2Sim2Robot、ManipTrans、REGRIND与SPIDER把参考轨迹迁到机器人,常绑定特定演示或需要测试时优化。ObjDex、DexTrack、AdaDexTrack、OmniGrasp、SimToolReal与Dex4D在多条参考上条件化策略,并把接触获取与运动执行联合处理。CrossDex、OHRA、UniMorphGrasp与GET-Zero推进跨手抓取或手内旋转;GOTT把接触获取当成跟踪之前的中间原语,而不是只做抓取本身。