快速导读:SAPrune 按动作注意力选剪枝层,再用双路径保留动作相关视觉 token,免训练加速 VLA。
视觉–语言–动作(VLA)模型要把大量视觉 token 送进深层 Transformer 才出机器人动作,推理贵。现有剪枝多用注意力或特征多样性,并在预设层或均匀间隔上动手;这对 VLA 有风险,因为浅层还不知道哪些区域对当前动作重要,先看起来不重要的 token 可能在语言指令对上之后才有用。澳门大学 Tianjun Shi、Haotian Xiong、Ziyu Gong、Qi Lu 与通讯作者 Li Li 在预印本 arXiv:2610.05273 提出免训练框架 SAPrune:先用一小份校准 rollout 观察动作到视觉注意力何时变得更可靠,再选剪枝层;在选定层上走双路径,一条保护高注意力视觉 token,另一条防止有用的周围上下文被扔掉。摘要写视觉 token 剪掉 87.5%,最高 1.718× 加速,任务成功率仍有竞争力。未见独立项目页。
LIBERO 上 OpenVLA、OpenVLA-OFT、π0 都把最终视觉 token 从 256 收到 32。OpenVLA 平均成功率 74.9%→74.0%,1.608×;OpenVLA-OFT 95.4%→94.5%,1.718×;π0 93.9%→93.1%,1.532×。SIMPLER 同样 32 token 时平均 52.5%,接近满模型 53.5%,明显高于 FastV 的 18.7%。AgileX Piper 实机四任务平均 54.0% 对满模型 55.5%。长程套件更敏感,剪枝层选错会明显掉点。预印本尚未同行评审。
英文题目:When and What to Prune? Stage-Aware Visual Token Pruning for Efficient VLA
论文出处:arXiv 每日论文精选 · arXiv:2610.05273
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VLA 把图像观测与语言指令映射成可执行动作,视觉 token 通常占多模态序列的大部分。ViT 与 VLM 上的剪枝已很多:DynamicViT、EViT、ToMe 做稀疏或合并;FastV、SparseVLM 等按注意力排序;另一些保多样性或用校准选层。这些多为理解任务设计,没有显式建模动作依赖的视觉证据。
VLA 免训练加速还有跨步特征复用(VLA-Cache)、自适应计算(VLA-ADP)和 EfficientVLA、SP-VLA、SpecPrune-VLA、VLA-Pruner 等。它们揭示了大量冗余,但常依赖固定剪枝位置、语义相关、时间复用或额外模块。作者把问题收成两句:何时剪才可靠,以及该保留哪些与动作相关的证据。图1显示浅层注意力广、中深层才收到目标;图2a 的 top-k 注意力质量从浅到中升得快、之后变慢;图2b 说明只靠注意力会扎堆、只靠特征多样性会留下与动作弱相关的显眼块。
核心创新
- 用动作注意力动态决定何时剪,而不是固定层。
- 双路径同时保住高注意力核心与功能上下文。
- 免训练、不改结构,可接到不同 VLA 骨干。
方法概览
校准 rollout 记录动作到视觉注意力,按浅中深选更稳的剪枝层。每层在候选池上双路径:注意力核心加查询条件功能多样性,λ 由保持分与集中分自适应。文本不剪,最终默认留 32 个视觉 token。
- SAPrune 分两步,如图3。校准只记注意力统计,不用奖励、成功标签或任务结果。默认用 LIBERO;也考虑 SIMPLER、实机和混合划分,rollout 数分别为 30、40、270。按相对深度把候选层分成浅中深 R1/R2/R3,最后一层不剪。度量每层 top-κ 动作到视觉注意力质量(默认 κ=0.125)及其层间再分配:三点滑动平均后,用分位阈值找平台起点和再分配事件。中深层若存在主导再分配区间,就在其后搜索;每区取最早平台起点,否则取局部平均位移最小的层。OpenVLA 上选出 [2,16,26]。超参默认 qs=0.4、qr=0.8、m=2、lmin=1。
- 在选定层 l 把视觉集合收到 Kl。先把选择限制在动作引导的扩大候选池 Top-M(γ=1.75),再用注意力探针看高注意力子集是否已覆盖主子空间。用探针特征的薄 QR 得保持分 Pl,用归一化熵得集中分 Al,η=√(Pl Al) 把注意力路径预算 λ 在 0.1 到 0.9 之间插值:探针又代表又集中时多给注意力路径,否则多给覆盖路径。
- 注意力路径保留候选池中动作注意力最高的 Kattn 个。覆盖路径用动作查询加上按动作注意力选出的 top-Kx 文本查询(Kx=6,文本本身不剪),为每个候选构造查询条件功能签名。相对已保留集合的残差证据做贪心:对齐缺失功能证据,同时用余弦惩罚冗余(β=0.3)。两路合并,缺额按注意力补齐后送入后续层。
逐图理解论文
阶段差异
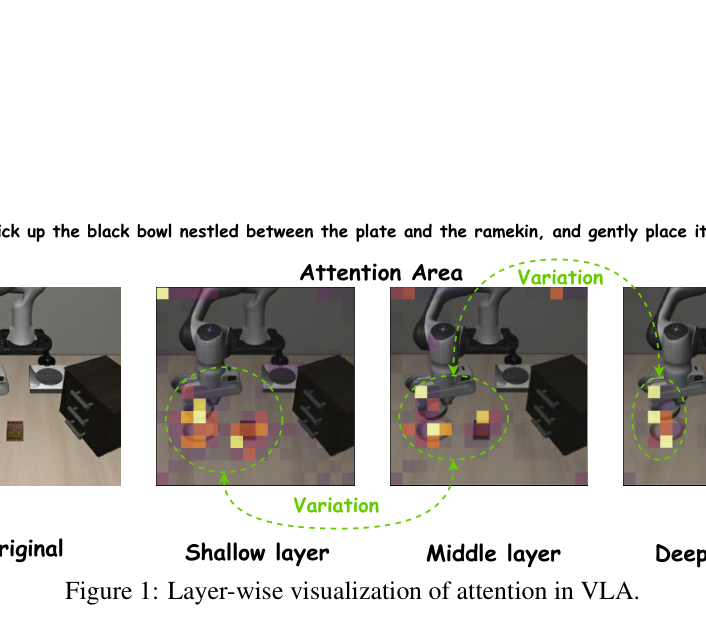
图1是 VLA 层间注意力可视化,任务句为 Pick up the black bowl nestled between the plate and the ramekin, and gently place it onto the plate。四帧从左到右:Original 为机械臂、黑碗、盘子、黑色抽屉柜;Shallow layer 在桌面中央有大片橙黄注意块;Middle layer 收到碗和邻近物体;Deep layer 更紧地落在目标碗上。绿色虚线圈与箭头标 Variation,标题 Attention Area。裁切左右略切到任务句和 Original/Deep 字样,但仍能读出“浅层广、深层收”的趋势。
何时剪
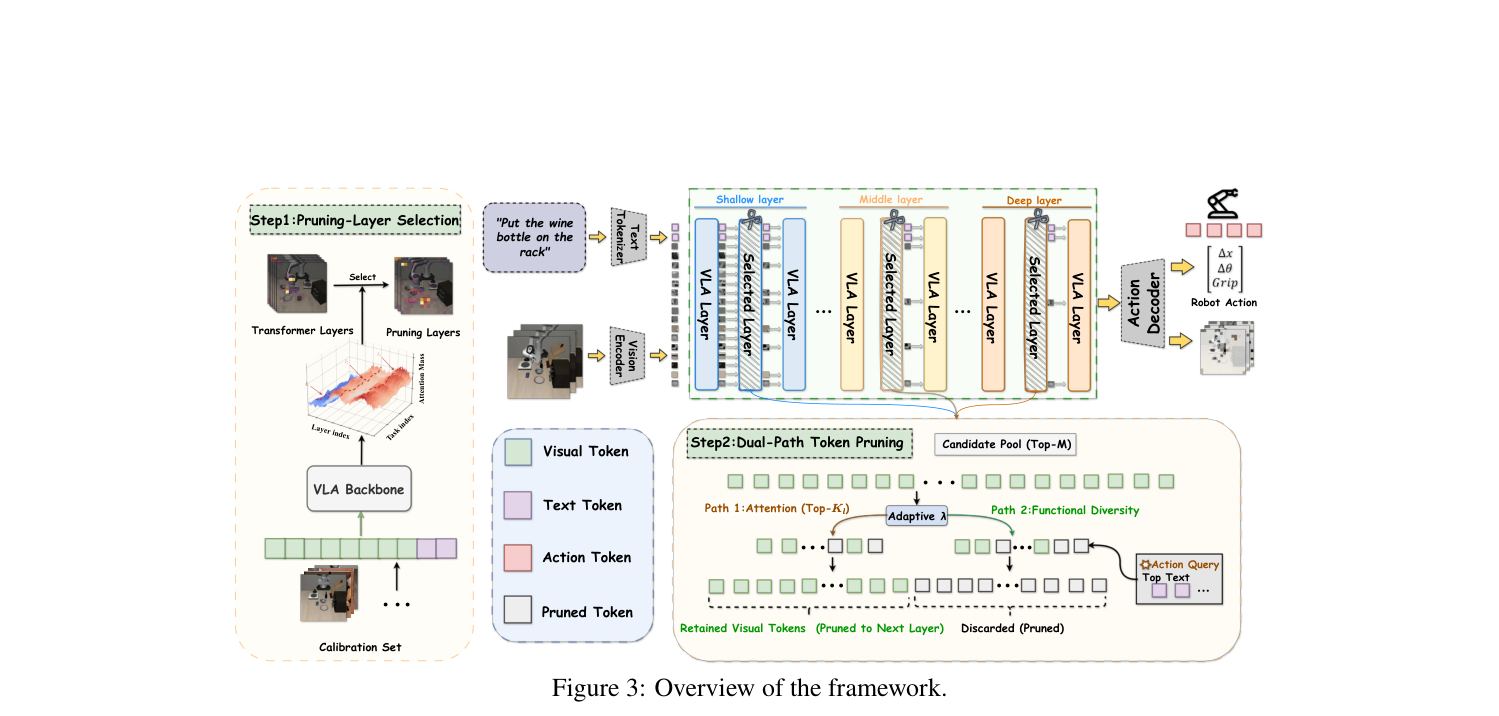
图3是 SAPrune 总览,宜作特色图。左侧 Step1: Pruning-Layer Selection:Calibration Set 的图像–文本序列进 VLA Backbone,三维图横轴 Layer index、纵轴 Task index、高度 Attention Mass,再从 Transformer Layers 选出 Pruning Layers。中上指令气泡 Put the wine bottle on the rack,经 Text Tokenizer 与 Vision Encoder 进入浅/中/深 Transformer,斜线块为 Selected Layer,最后 Action Decoder 输出 Δx、Δθ、Grip。右下 Step2: Dual-Path Token Pruning:Candidate Pool (Top-M),Path 1 Attention (Top-Kl) 与 Path 2 Functional Diversity 由 Adaptive λ 分流,保留绿块、丢弃灰块,覆盖路径连到 Action Query 与 Top Text。图例区分 Visual/Text/Action/Pruned Token。上沿略裁,完整框图亦见于同页另一裁切。
Figure 6: Tasks on LIBERO Benchmark, SIMPLER and Real World Environment
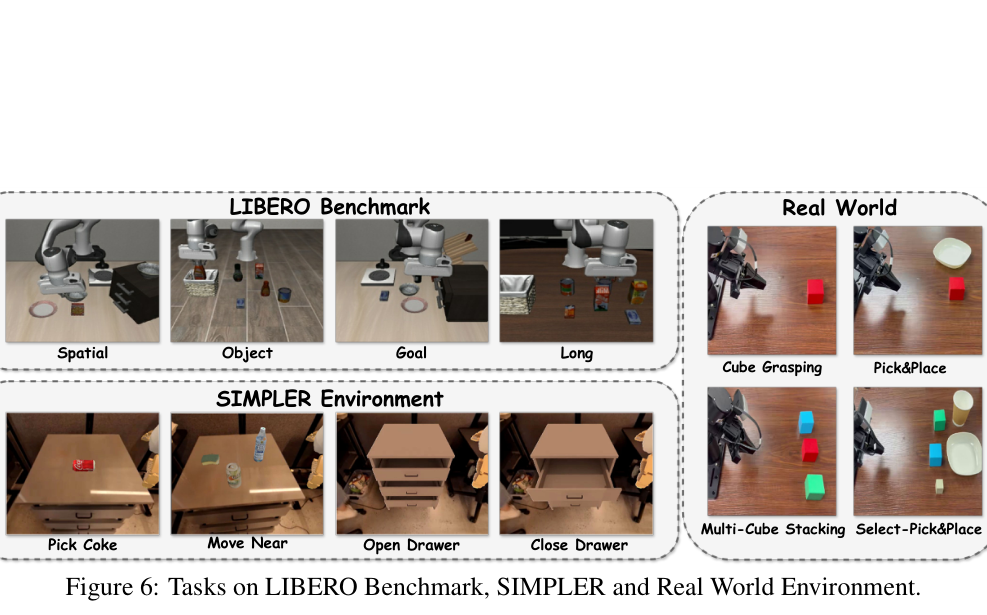
图6是评测任务拼图。左上 LIBERO Benchmark 四格 Spatial、Object、Goal、Long,均为仿真桌面与机械臂。左下 SIMPLER Environment:Pick Coke、Move Near、Open Drawer、Close Drawer。右侧 Real World 四格:Cube Grasping 红方块、Pick&Place 红块对白盘、Multi-Cube Stacking 红绿蓝块、Select-Pick&Place 多物体加纸杯。用来对照 LIBERO/SIMPLER/实机三套数字,不是定性成功展示。
实验如何设计?
- 仿真评 LIBERO 与 SIMPLER,实机四任务。基线 FastV、DivPrune、SP-VLA、VLA-ADP、EfficientVLA,骨干 OpenVLA、OpenVLA-OFT、π0;另在 π0.5 上比 FastV 与 VLA-Pruner。主表跟各方法报告或默认 token 数,满模型 256,本文最终 32;另有统一 32 token 对照。实机部署 AgileX Piper。延迟在 NVIDIA RTX 5090 上用 PyTorch SDPA 测,含剪枝开销,默认无编译;FlashAttention-2 在附录。成功率、FLOPs Ratio、延迟与加速;E2E 从观测预处理到动作发送,不含物理执行与底层伺服。
- LIBERO 报 Spatial/Object/Goal/Long 与平均。SIMPLER 可见任务为 PickCoke、MoveNear、Open/Close。实机 Cube Grasping、Pick&Place、Select-Pick&Place、Multi-Cube Stacking,每任务 100 次。消融在 OpenVLA+LIBERO 上改剪枝位置,并扫浅中深的平衡因子 λ。校准统计按任务平均后,深度方向趋势大体一致。
关键结果与论文证据
- Table 1:OpenVLA 上 SAPrune 32 token,Spatial/Object/Goal/Long 为 84.9/85.1/75.3/50.8,平均 74.0,对满模型 74.9;延迟 178.46→110.96 ms,1.608×,FLOPs 39.5%。OpenVLA-OFT 平均 94.5 对 95.4,60.30 ms、1.718×、37.8% FLOPs。π0 平均 93.1 对 93.9,1.532×、38.6%。主要掉点在 Long。π0.5 上平均 95.9 对 96.6,视觉 token 每图 32 对 256,E2E 91.47→59.68 ms。
- Table 2 在 SIMPLER、统一 32 token:SAPrune 平均 52.5(PickCoke 53.2、MoveNear 56.3、Open/Close 47.9),满模型 53.5;FastV 18.7,SP-VLA 35.6,VLA-ADP 40.0,EfficientVLA 42.3。Table 4 实机平均 54.0 对 π0 的 55.5,延迟 51.45 ms、FLOPs 39.3%,在剪枝方法里成本最低;同次运行 E2E 88.68→61.97 ms,策略频率 11.28→16.14 Hz。Table 5:OpenVLA 选层 [2,16,26] 平均 74.0,均匀 [1,11,23] 只有 65.8,单层 [2] 55.1。图5显示浅层宜小 λ 多留上下文,深层 λ 可增大,但 λ=1.0 仍不是最优。
阅读时需要注意
- Long 套件对极端压缩和累积执行误差更敏感,平均接近满模型并不等于长程无损失。剪枝位置靠校准 rollout 的注意力统计,换骨干或域要重做校准;校准虽不用成功标签,仍假设能记下动作到视觉注意力。
- 主对比未统一所有基线的 token 预算,公平性部分依赖 32 token 对照表。实机只有 π0 加 AgileX Piper 四任务。方法免训练,不能靠微调把剪错的证据找回来。预印本未同行评审,也未见独立代码或项目页。
关联工作
- RT-1、RT-2、RT-X、Octo、OpenVLA、π0 把视觉与语言映射到动作,但密集视觉 token 让实时部署贵。VLM 剪枝里 FastV 类方法按注意力排序,DivPrune 类保存特征多样性,校准或层自适应方法从统计里选层与比例,主要服务理解而非动作生成。
- VLA-Cache 复用相邻时刻视觉特征,VLA-ADP 动态减计算,EfficientVLA、SP-VLA、SpecPrune-VLA、VLA-Pruner 在推理中减视觉 token。SAPrune 强调两件事:用动作注意力动态选更稳的剪枝阶段,以及用查询条件功能签名而不是几何多样性来补上下文。