快速导读:把反射当位姿信号:每帧光场估深度并分解环境图,重打光后优化六自由度跟踪。
镜面或高光物体一动,表面就会换一块环境进来,像素颜色同时绑着几何、材质和照明。现有六自由度跟踪器多半假定外观稳定、深度可信,这两条在反射面上都会断。悉尼大学 Australian Centre for Robotics 的 Nikolai Goncharov 与 Donald G. Dansereau 在预印本 arXiv:2610.04883 里提出:与其把反射当噪声压掉,不如把它当成位姿信号。方法每帧吃一张标定光场,抗反射地估深度和法向,把视角相关外观拆成逐点漫反射反照率和一份共享环境图,再按上一帧累积的环境图给表面光场重打光,用光度残差优化相对位姿。作者称代码与数据放在 https://nagonch.github.io/lightfield_tracking,公开状态仍待核验。
为把反射率当成可控变量,他们把 YCBInEOAT 的八条序列按四档反射率 r∈{0.0,0.5,0.7,1.0} 重渲染,几何、光照和真值位姿跨档对齐,并配上模拟消费级 RGB-D 在亮面上崩掉的深度。物体序列上本文是唯一随反射升高仍稳住的方法;全反射时 ADD-S、ATE、ARE 全部最好。漫反射物体上它落后 FoundationPose 与 BundleSDF,平面立方体上优势也不成立。两段实拍芥末瓶(素面与锡箔)上本文各项最好或并列。预印本尚未同行评审。
英文题目:Reflection-Robust 6DoF Object Tracking with Light Fields
论文出处:arXiv 每日论文精选 · arXiv:2610.04883
原始论文:PDF / 论文页面
这篇论文解决什么问题?
自动驾驶、动态 SLAM 和空中机器人都要跟运动刚体的六自由度位姿。反射面上每个像素的颜色把位姿、几何、材质和周围照明耦在一起,很多组未知量都能解释同一观测,只靠外观不够。Model-based 与 model-free 跟踪器都把外观当光照不变,消费级 RGB-D 又靠红外图案在两视之间亮度恒常,镜面会同时毁掉外观和深度。
可重打光的重建能在新光照下恢复外观,但通常离线、多视角拟合。镜面流与稀疏反射对应能从反射运动推形状,却依赖理想镜子、已知远场照明和光滑可预测运动。反射分离多在图像空间拆层,拿不到产生反射的照明。作者指出,此前没有跟踪器在线建可重打光物体模型,并把反射当成在线位姿线索。
核心创新
- 在线重建并重打光,把反射变成六自由度位姿线索。
- 单帧光场恢复几何、法向与材质,外观随物体运动正确变化。
- 把外观在线拆成漫反射与反射环境,并随运动补全环境图。
方法概览
每帧从光场用子集一致性斜率估深度并拟合法向,把视角颜色拆成反照率与共享环境图并在线累积。LoFTR 在漫反射上粗对齐,并行彩色 ICP;再按上一帧环境图重打光,溅射渲染后用光度加深度锚优化相对位姿。物体用文本提示分割并在序列中传播。
- 输入是静态相机采集的标定光场序列 Lt,子视角相对位姿已知。物体只用文本提示指定,估计相邻帧相对刚体变换。假设物体无遮挡、照明在序列内静止:反射用远处环境图 E,漫反射效果收成一盏点光源。外观跟 dichromatic 模型:出射辐射是 Phong 漫反射着色加上沿镜面方向采样的环境,α∈[0,1] 是漫反射比例,α=0 为理想镜子。
- 每帧用 Grounding DINO 在首帧出框,SAM 2 成掩膜,Cutie 往后传。深度在经典光场斜率模型上改成只在最一致的子视角子集上打分,避免镜面破坏全视角亮度恒常;全反射时只剩轮廓、角点和反射边的稀疏斜率,再用边缘感知加权最小二乘向中心视图亮度边内加密,反演得到度量深度。掩膜内像素反投影成点云,在三维邻域拟合法向,再投回各子视角采方向颜色,构成该帧表面光场。
- 分解在序列上递推:第一帧环境图为空、置信为零。固定 α 后用视角样本拟合反照率与共享环境图,用上一帧地图热启动,并对观察不足的方向做总变差插值;再做一次多尺度去纹理,按点光源反着色得到 D(xi)。覆盖只增不减,物体一动就补新方向。α 由子视角亮度标准差的上分位线性标定。位姿分两段:漫反射中心视图上 LoFTR 反投影加 RANSAC,并行用彩色 ICP;随后把源高斯按候选位姿着色并沿 Ê_{t-1} 重打光,溅射到中心视图,带深度锚和按环境置信加权的光度残差做梯度下降。
逐图理解论文
外观假设
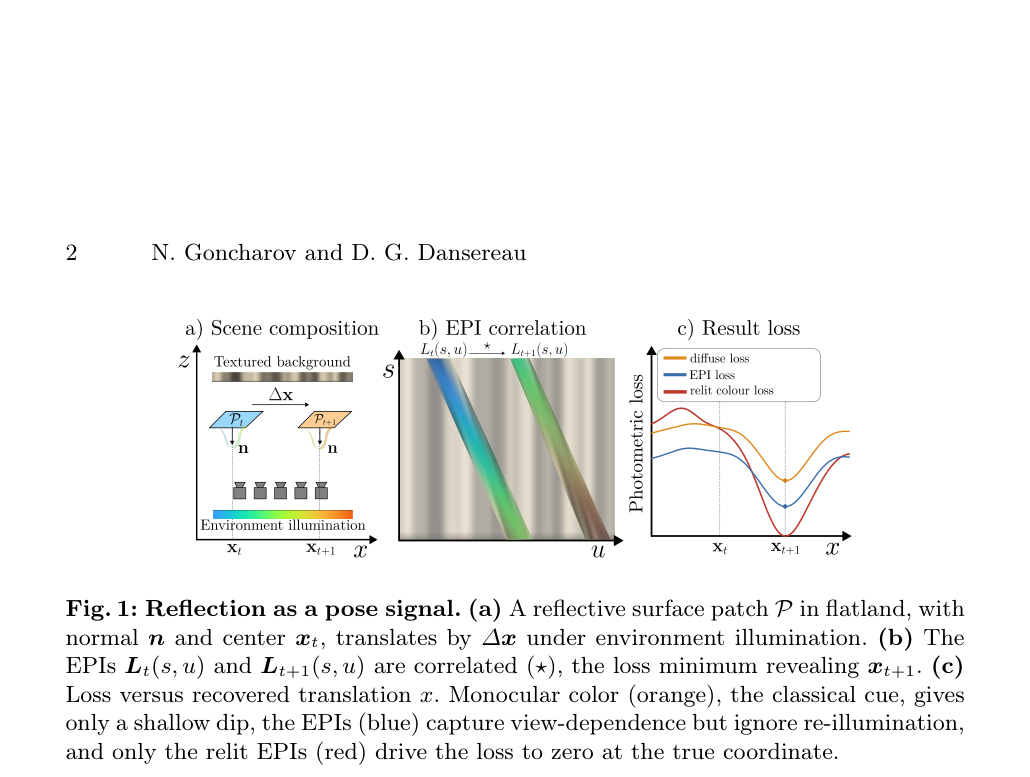
图1把反射写成位姿信号,三栏示意,页码 2。(a) Scene composition:竖轴 z、横轴 x,上方 Textured background,蓝色块 P_t 与橙色块 P_{t+1} 标法向 n 和位移 Δx,下方一排针孔相机,底边 Environment illumination 色条,位置 xt 与 xt+1。(b) EPI correlation:s–u 平面上蓝绿与绿褐两条斜带,顶标 Lt(s,u)⋆Lt+1(s,u)。(c) Result loss:橙 diffuse loss、蓝 EPI loss、红 relit colour loss;红线在 xt+1 落到零,橙线只有浅谷。裁切含页眉作者行,讲图时忽略。
光场分解
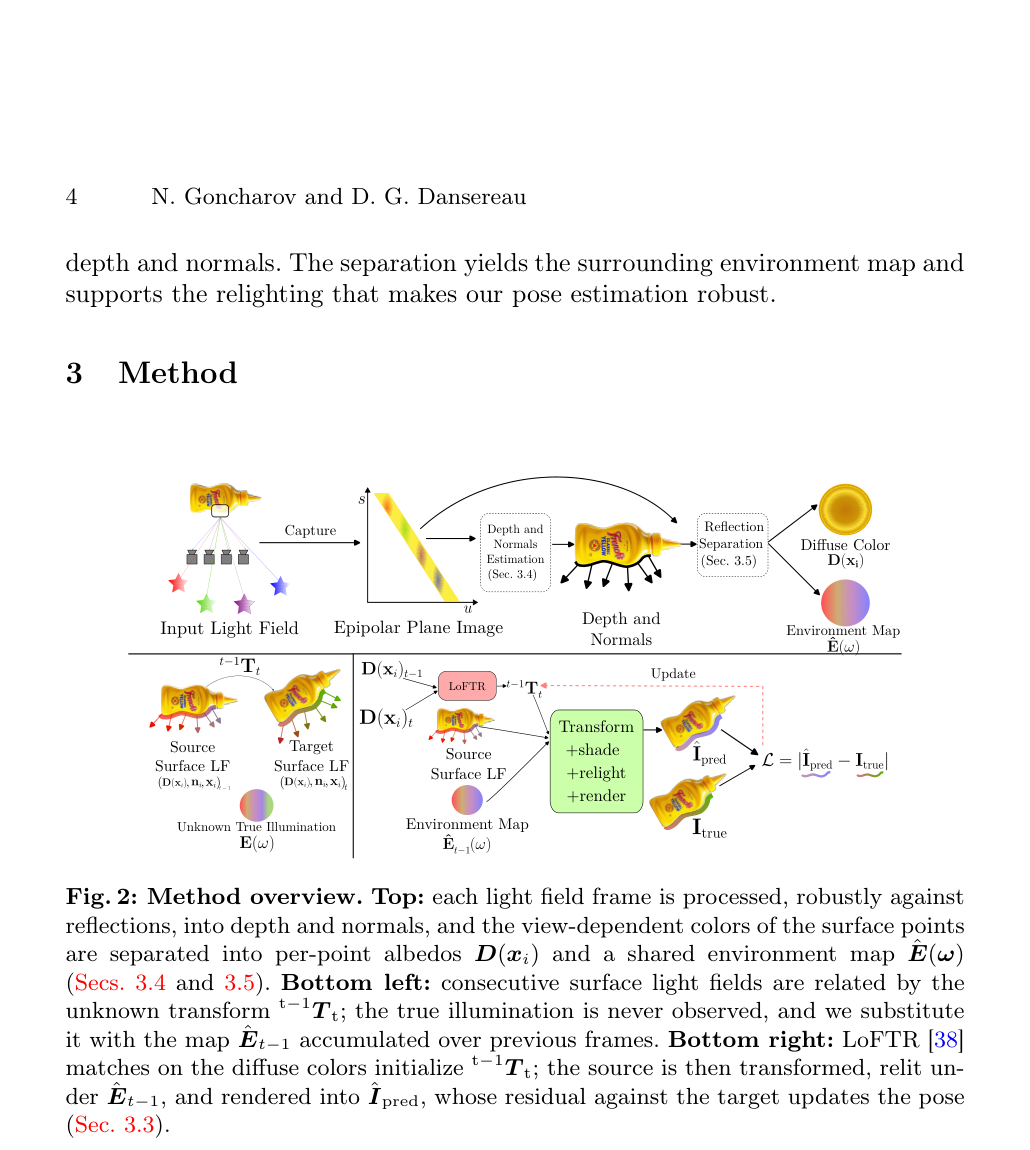
图2是方法总览,宜作特色图。上半:Input Light Field 为黄芥末瓶、五台相机和彩色星形光源,经 Capture 到 Epipolar Plane Image,再经 Depth and Normals Estimation(Sec. 3.4)得到带法向箭头的瓶,Reflection Separation(Sec. 3.5)分成 Diffuse Color D(xi) 与 Environment Map Ê(ω)。下左:Source/Target Surface LF 由未知 t−1Tt 相连,真照明 E(ω) 不可见。下右:两帧 D(xi) 经 LoFTR 初始化位姿,源表面光场加 Ê_{t−1}(ω) 进入绿色块 Transform+shade+relight+render,得到 Î_pred 与 I_true 的光度损失 L,虚线 Update 回传。图上方残留第 3 节正文,讲图时忽略。
关键证据
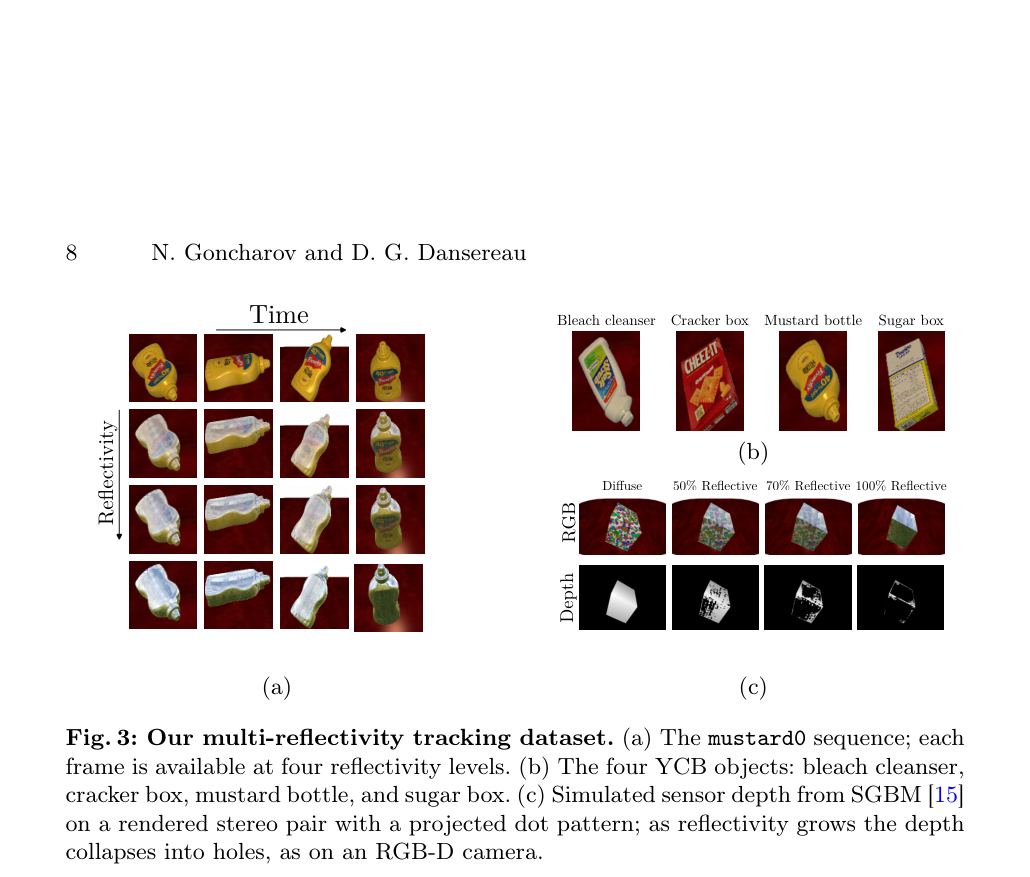
图3是多反射率跟踪数据集。(a) mustard0,右为 Time、下为 Reflectivity,4×4 红底图:上行接近漫反射黄瓶,往下越来越像镜子,环境高光在瓶身滑动。(b) 四个 YCB:Bleach cleanser、Cracker box、Mustard bottle、Sugar box。(c) 两行 RGB 与 Depth,列 Diffuse、50%、70%、100% Reflective:RGB 从彩块立方体变成镜面,Depth 从完整几何变成大片黑洞,对应消费级 RGB-D 在亮面上的失效。
结论与局限
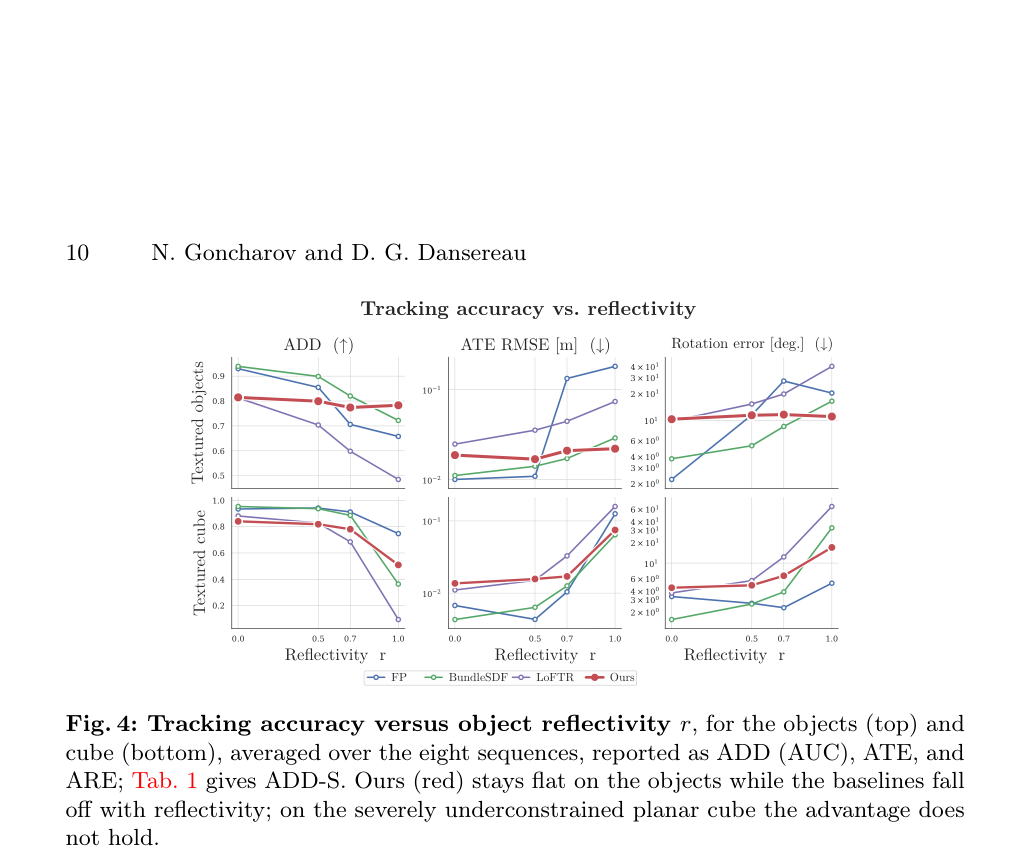
图4是跟踪精度对反射率 r。上三图 Textured objects,下三图 Textured cube,列为 ADD(↑)、ATE RMSE[m](↓)、Rotation error[deg.](↓)。蓝圈 FP、绿圈 BundleSDF、紫圈 LoFTR、红圈 Ours。物体行红线几乎水平:ADD 约 0.8 不掉,ATE 停在约 2×10⁻²,旋转停在约 10 度;基线随 r 从 0 到 1 明显变差。立方体行高反射时大家一起掉,红线不再独占优势。横轴刻度为 0.0、0.5、0.7、1.0。
实验如何设计?
- 数据集重渲染 YCBInEOAT 的八条序列、四个 YCB 物体(漂白水瓶、饼干盒、芥末瓶、糖盒),每条还有近似尺度的立方体变体。每帧是 5×5、640×480、基线 5 mm 的平面光场,中心子视角对齐原基准,并带掩膜、真值深度、六维位姿和标定。四档反射率几何、光照、位姿相同:I0 为纹理 Phong,I1 为固定远场的理想镜子,中间按像素混合,对应 α=1−r。模拟深度在投影点图案的立体对上跑 SGBM,仿 Intel RealSense,反射升高后匹配代价失去极小值、深度出洞。
- 所有方法跟踪全部八条序列的四档反射率。指标为 ADD 与 ADD-S 的 AUC(阈值 0.1 倍物体直径),以及 ATE 与 ARE。基线只看中心子视角,当作普通 RGB-D;本文看全光场。为去掉分割差异,全部提供真值掩膜。基线用模拟传感器深度,本文用自己从光场估的深度。各方法都从第 0 帧真值位姿初始化。基线含 SIFT+PnP、彩色 ICP、LoFTR、模型无关 FoundationPose(离线按物体与反射率建神经参考模型)和在线 BundleSDF。另有 EPIModule 实拍两条各 46 帧:素面芥末瓶与锡箔包裹,UR5e 带动,运动学加手眼标定、再按轮廓对齐作为真值。实现上平面扫描 192 个逆深度、保留 60% 最一致子视角,分解每帧 300 步 Adam,光度细化 60 步。
关键结果与论文证据
- Table 1 在八条物体序列上,本文 ADD-S 在 r=0.0/0.5/0.7/1.0 为 0.898/0.893/0.881/0.885,ATE 为 0.019/0.017/0.021/0.022 米,ARE 为 10.3/11.4/11.6/11.0 度,几乎不随反射率掉。全反射时全面最好;BundleSDF 的 ADD-S 仍有 0.857 但 ARE 到 16.4 度,FoundationPose 的 ATE 升到 0.182 米。漫反射上 FoundationPose 与 BundleSDF 的 ADD-S 约 0.95,本文 0.898,旋转也落后。图 4 红线在物体行保持平坦,基线随 r 下滑;立方体行几何欠约束,优势不成立。
- Table 2 实拍:素面瓶本文 ADD-S 0.925、ATE 0.013 米、ARE 14.0 度,略优于 BundleSDF 的 0.921/0.013/19.9;锡箔瓶 ADD-S 与 BundleSDF 同为 0.941,ATE 0.009 对 0.011、ARE 6.9 对 11.2。FoundationPose 只在素面上还能跟。定性上全反射糖盒里 LoFTR 早漂、FoundationPose 在反射突变后漂,本文无位姿图、无预存模型仍能靠光度细化纠姿态。通量约 1.03 fps、峰值显存 12.9 GB(RTX 6000 Ada),快过 BundleSDF 的 0.16 fps,慢于 12–34 fps 的其余基线。消融在 r=1.0:换成传感器深度伤害最大;去掉光度细化或反射分离会把平移和旋转误差大约抬高四分之一。
阅读时需要注意
- 实拍只有同一只芥末瓶的两条序列。方法假定无穷远处静态环境图,用 dichromatic 而非空间变化 BRDF,不处理透明物体,超参换场景可能要重调。几何、本征分解和运动基本串行求解,尚未从光场联合优化,也未把逐帧估计收成一份全局可重打光模型。
- 漫反射物体上落后使用预存模型或全局位姿图的最强基线;平面立方体上几何与外观不可辨,优势消失。整条流水线约 1 fps,未到实时。数据集的中间反射率是两帧混合而非物理实测材质。预印本未同行评审;代码页公开状态待核验。
关联工作
- 经典跟踪用 ICP/彩色 ICP 或 RANSAC-PnP。学习方法把观测对齐到已知模型,FoundationPose 把估计与跟踪收成一套。BundleSDF 等 model-free 跟踪器在线建参考模型,但无论 Lambert 还是视角相关,模型都按构建时照明冻结。
- 光场深度可读 EPI 梯度、散焦与对应,非 Lambert 扩展做遮挡感知或去高光聚合,仍靠跨视角亮度恒常。NeRF、高斯溅射及其可重打光变体保真度高,却是离线多视图拟合。镜面流把反射运动连到形状,条件对在线跟踪过强。反射分离压层或拆本征,却不恢复照明。本文把反射分量绑到深度和法向,在线出环境图并重打光。