联合音视频生成,怎样拆开纠缠的奖励信号?
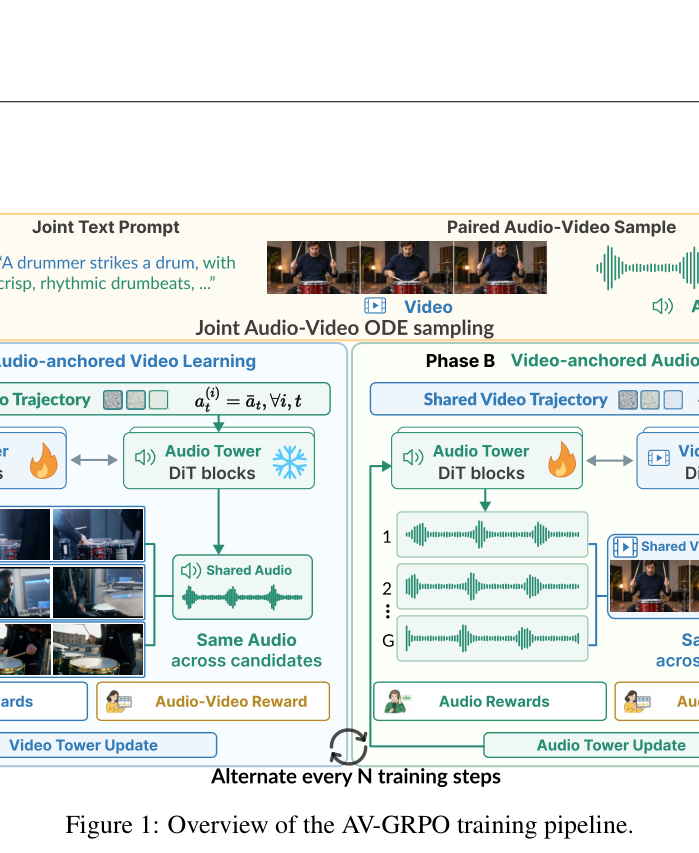
上科院、港理工等提出 AV-GRPO:用模态锚定 rollout、轨迹锁定冻结塔与模态自适应目标,把纠缠的多模态奖励拆成条件单模态子问题,并配 5DAV 数据集;在 LTX-2.3 上 LoRA/全参后训练均优于基线与 GDPO。
上科院、港理工等提出 AV-GRPO:用模态锚定 rollout、轨迹锁定冻结塔与模态自适应目标,把纠缠的多模态奖励拆成条件单模态子问题,并配 5DAV 数据集;在 LTX-2.3 上 LoRA/全参后训练均优于基线与 GDPO。