OmniKVQuant:面向 Omni-LLM 的 KV 缓存量化
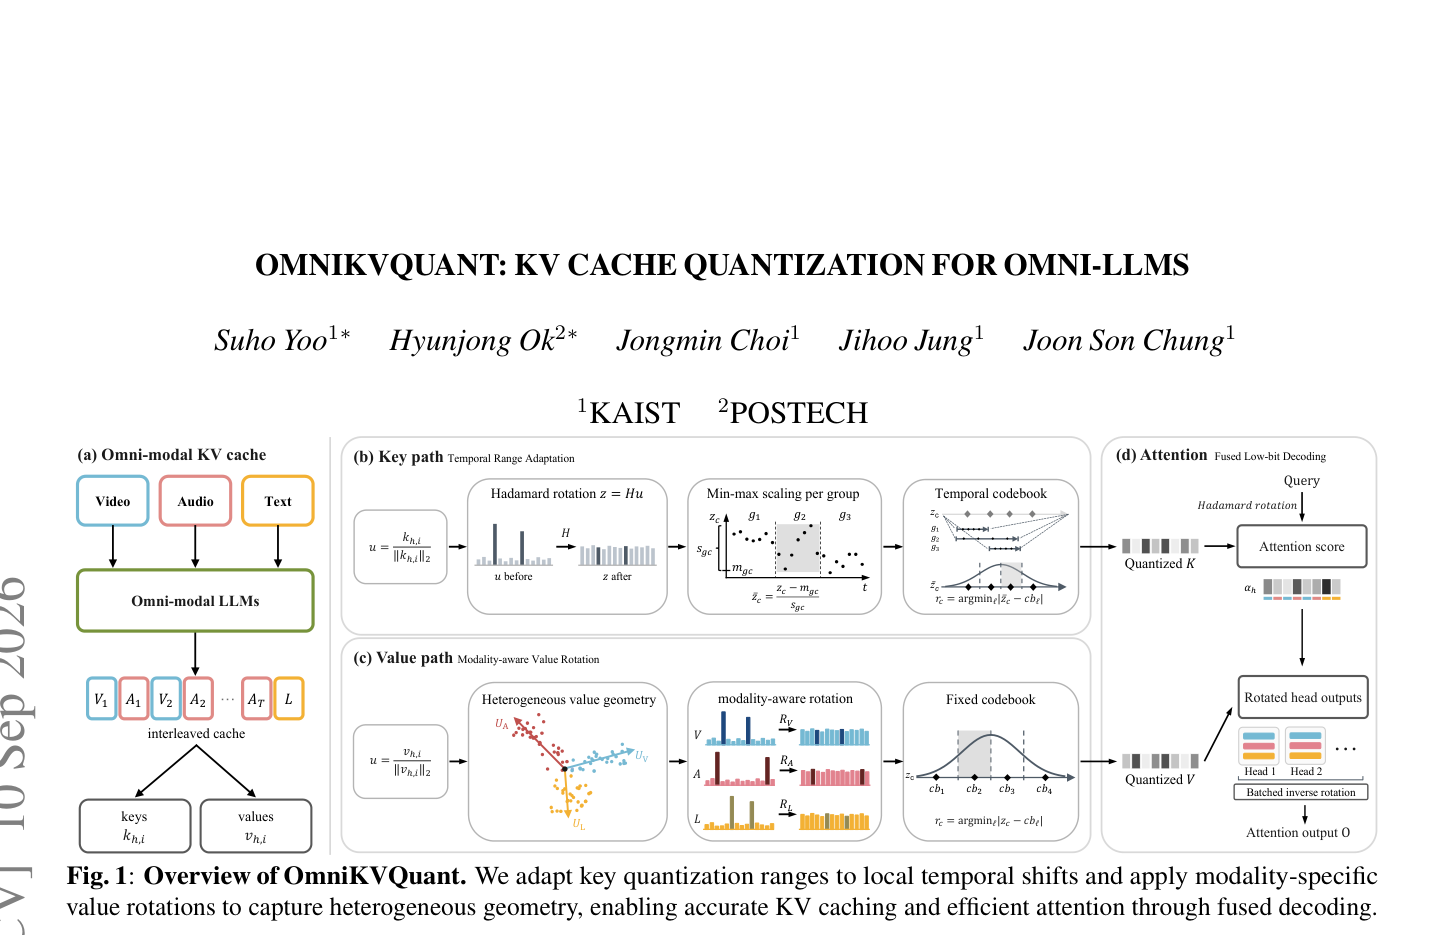
本文提出 OmniKVQuant,一种针对多模态大语言模型(Omni-LLM)的免训练 KV 缓存量化框架,通过局部时间范围自适应和模态感知值旋转,在 2-bit 精度下显著优于 TurboQuant。
本文提出 OmniKVQuant,一种针对多模态大语言模型(Omni-LLM)的免训练 KV 缓存量化框架,通过局部时间范围自适应和模态感知值旋转,在 2-bit 精度下显著优于 TurboQuant。
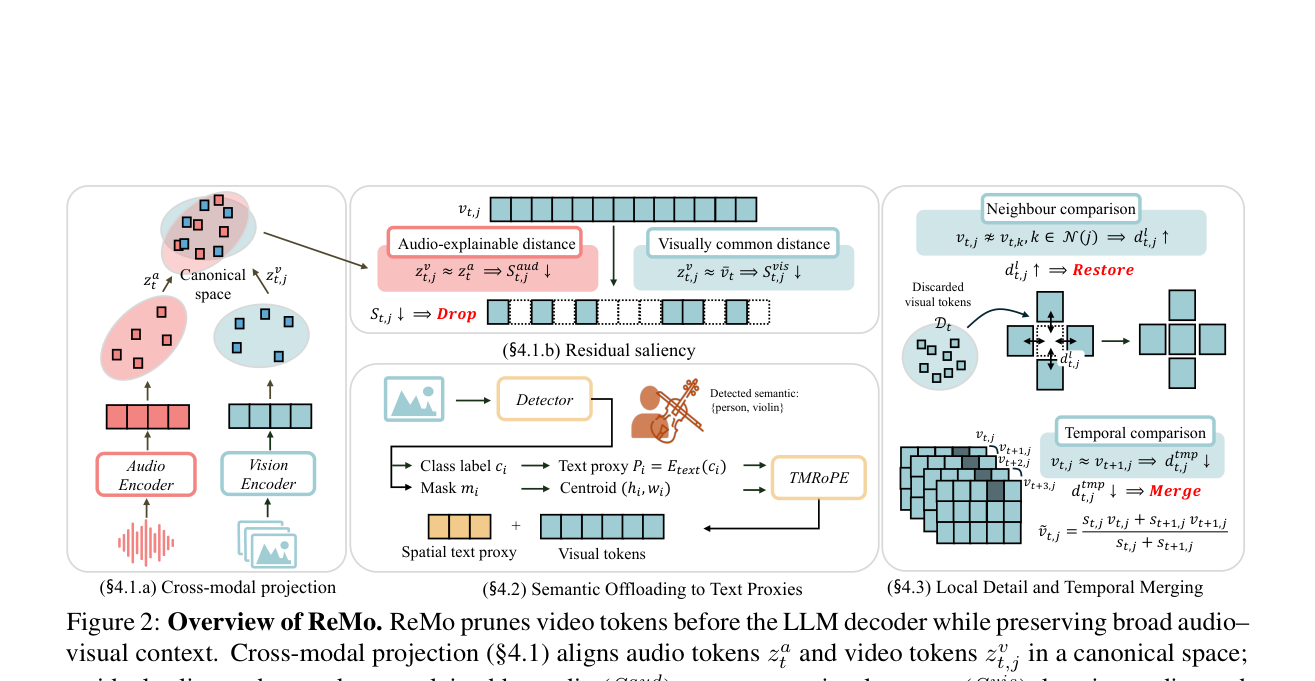
Omni-LLM 处理音视频时,视觉 Token 冗余严重导致计算瓶颈。ReMo 提出无需训练的压缩框架,通过 Cross-modal Projection 对齐音频与视觉空间,利用 Residual Saliency 剪枝冗余 Token,并引入 Text Proxy 保留对象语义。实验显示其在 Qwen2.5-Omni 和 Qwen3-Omni 上均超越全 Token 模型准确率,同时大幅降低延迟。需注意其依赖离线投影和检测器词汇表。