快速导读:本文首次对机器人操作中的潜在动作学习(LAM)进行系统性实证研究,统一了代表性方法并考察41种设计选择,揭示潜在动作建模范式、正则化强度与集成策略对下游操作性能的影响。
潜在动作模型(Latent Action Model, LAM)试图从大规模无标注视频中自监督地提取紧凑的动作表示,以缓解机器人动作数据稀缺对具身基础模型扩展性的制约。然而,该领域长期处于碎片化状态:各方法在孤立且不一致的实验设置下评估,研究者难以判断哪些设计因素真正决定下游操作性能。本文首次对LAM进行系统性实证研究,将代表性方法统一到自编码框架中,在LIBERO、LIBERO-Plus和RoboTwin2.0三个基准上考察41种设计选择,并在Franka Panda真机上验证关键结论。
研究的核心发现可以概括为三点:第一,原始LAPO在原始数据上仍是强基线,简单语义特征差分ΔDINO即可获得有竞争力的潜在动作表示,说明复杂建模范式并非性能提升的必要条件;第二,正则化强度的选择比正则化方法本身更重要,过强正则化会抑制转移动力学信息;第三,潜在动作应作为结构化辅助目标贯穿下游策略学习,而非仅在预训练阶段使用。
英文题目:What Matters for Latent Actions in Robot Learning
论文出处:arXiv 每日论文精选 · arXiv:2608.19613
原始论文:PDF / 论文页面
这篇论文解决什么问题?
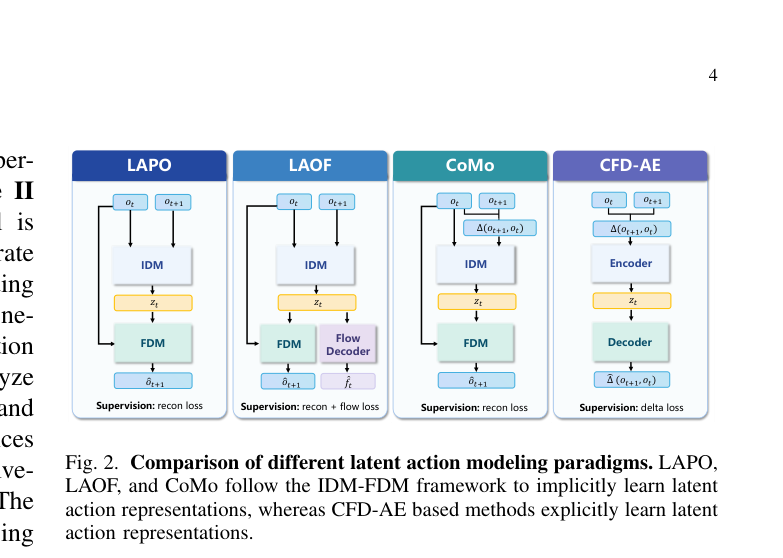
机器人操作数据的采集成本远高于视觉或语言数据,这直接限制了具身基础模型的可扩展性。LAM的核心思路是:既然物理动作标注昂贵,能否从海量无标注视频中学习一种紧凑的潜在动作表示,作为物理动作的替代信号?代表性框架LAPO采用逆动力学模型(IDM)与正动力学模型(FDM)的自编码结构:IDM从连续帧推断潜在动作,FDM基于当前帧和潜在动作预测未来帧,通过重建约束迫使潜在动作编码转移动力学信息。
然而,后续方法如LAOF引入光流辅助监督、CoMo用连续帧差分替代未来帧输入以缓解捷径学习、StaMo使用DINOv2语义特征差分显式学习潜在动作,这些改进各自在特定设置下报告增益,却缺乏统一的比较基准。研究者无法回答一个基本问题:这些设计选择中,哪些真正对下游机器人操作性能有因果性影响,哪些只是实验设置差异造成的假象?
更棘手的是评估协议问题。完整的LAM评估需要三阶段训练流程:Stage I预训练潜在动作模型,Stage II用潜在动作微调VLM骨干,Stage III在下游操作任务上微调策略。这一流程计算成本高昂,研究者迫切需要可靠的代理指标来快速筛选模型,但现有代理指标与下游性能的相关性从未被系统验证。
核心创新
- 首次对潜在动作学习进行覆盖41种设计选择的系统性实证研究,统一隐式IDM-FDM与显式CFD-AE范式
- 证明原始LAPO在原始数据上仍是强基线,简单语义特征差分(ΔDINO)即可获得有竞争力的潜在动作表示
- 系统评估五种潜在动作集成策略,提出潜在动作应作为结构化辅助目标贯穿下游策略学习的实用设计原则
- 发现FDM重建指标(SSIM Gain、MSE Gain)比探针指标(Linear/MLP Probe)更可靠地预测下游操作性能
- 证明用潜在动作微调VLM骨干能为下游策略学习提供更强初始化,且扩大潜在动作预训练规模持续提升性能
方法概览
将代表性LAM方法统一到自编码框架中,在LIBERO、LIBERO-Plus和RoboTwin2.0三个基准上系统考察三个维度的41种设计选择:潜在动作建模范式(隐式IDM-FDM与显式CFD-AE)、学习目标与正则化方法(AE、VAE、VQ-VAE、Sparsity、SIGReg)、潜在动作集成策略(DAP、LAP、JAP、JAP-DAP、JAP-LAP);并评估四种代理指标与下游性能的相关性,在Franka Panda机器人上做真实验证。
- 统一框架设计:将代表性LAM方法统一到自编码框架中,区分隐式IDM-FDM范式(LAPO、LAOF、CoMo)与显式CFD-AE范式(连续帧差分自编码),使不同方法可以在相同数据、相同下游流程下公平比较。
- 建模范式维度:比较7种潜在动作建模范式,包括LAPO、LAOF、CoMo、RAFT、SEA-RAFT、ΔRGB和ΔDINO,覆盖隐式学习与显式像素/语义差分学习两条路线。
- 正则化维度:考察5种正则化方法(AE、VAE、VQ-VAE、Sparsity、SIGReg)在不同正则化强度下的表现,共21种配置,系统分离正则化方法选择与强度选择的影响。
- 集成策略维度:比较5种动作头架构——DAP(直接动作预测,潜在动作仅用于微调VLM骨干)、LAP(潜在到动作预测,潜在动作作为中间控制表示)、JAP(联合潜在动作预测)、JAP-DAP和JAP-LAP,覆盖物理动作不可及与可及两种设置。
- 代理指标评估:评估4种代理指标(−Linear Prob、−MLP Prob、SSIM Gain、MSE Gain)与下游操作性能的Pearson和Spearman相关性,检验哪些指标可用于快速模型筛选。
- 维度分析:评估8种潜在动作维度{8,16,32,64,128,256,512,1024}对下游性能的影响,确定维度选择的敏感区间。
- 真机验证:在Franka Panda 7-DoF单臂机器人上对4个操作任务进行真实验证,比较OpenVLA-OFT与LA-Tuned版本,确认仿真结论在真实硬件上的可迁移性。
逐图理解论文
研究缺口
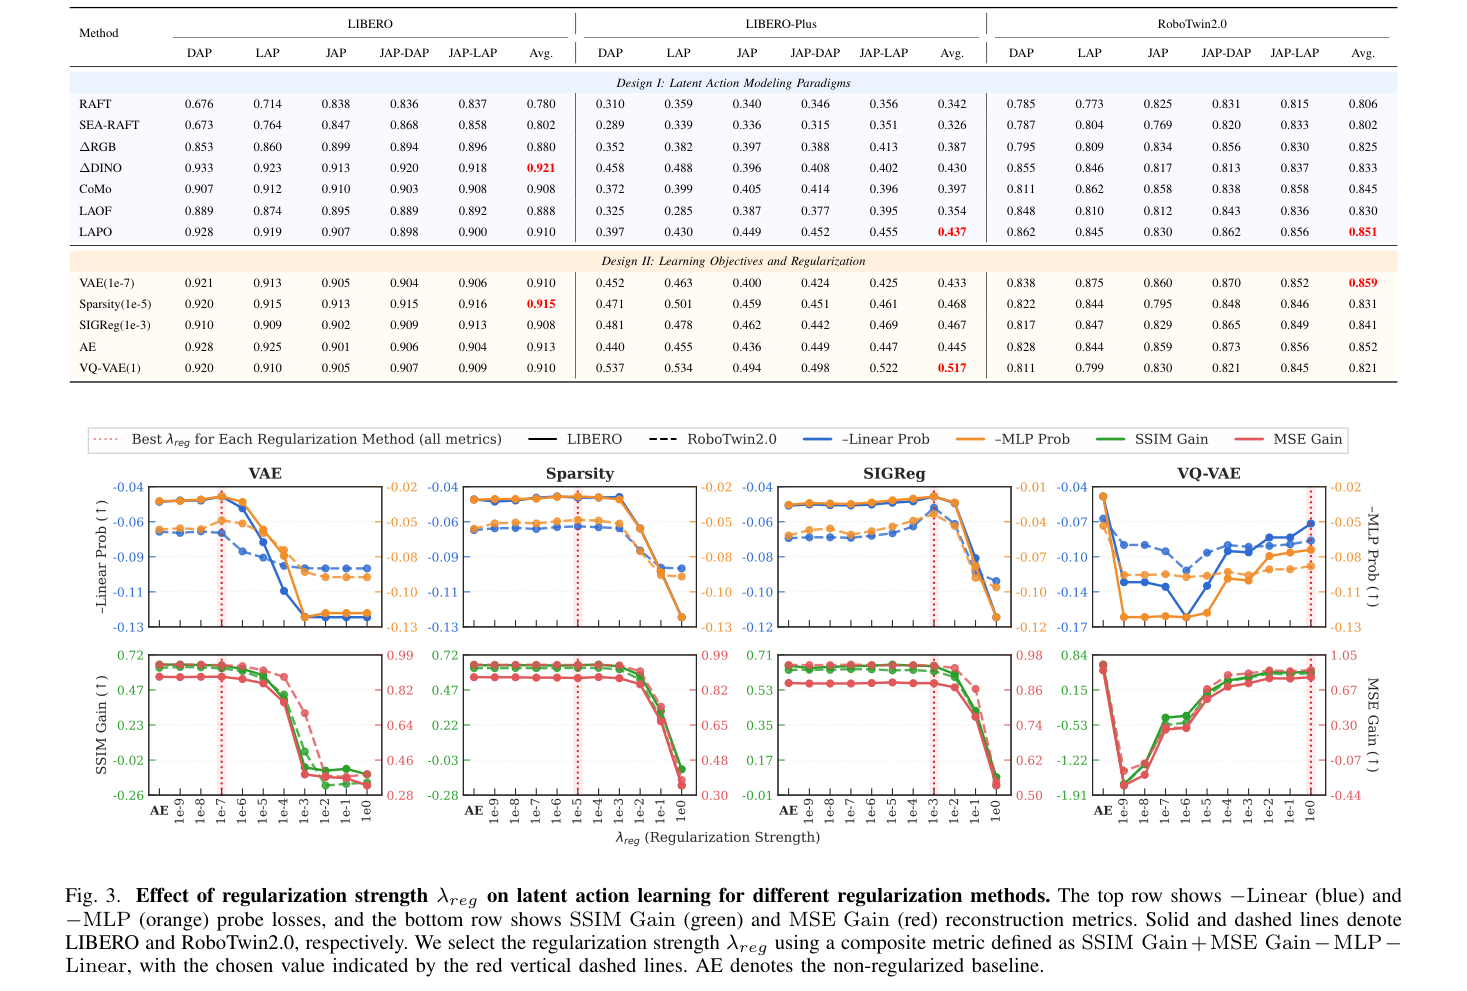
该图展示正则化强度λreg对四种代理指标的影响曲线。观察要点:红色虚线标记的复合指标选择点在不同正则化方法间差异显著,且探针指标与重建指标随强度变化的趋势并不一致,说明单一指标无法指导强度选择。
最强结论
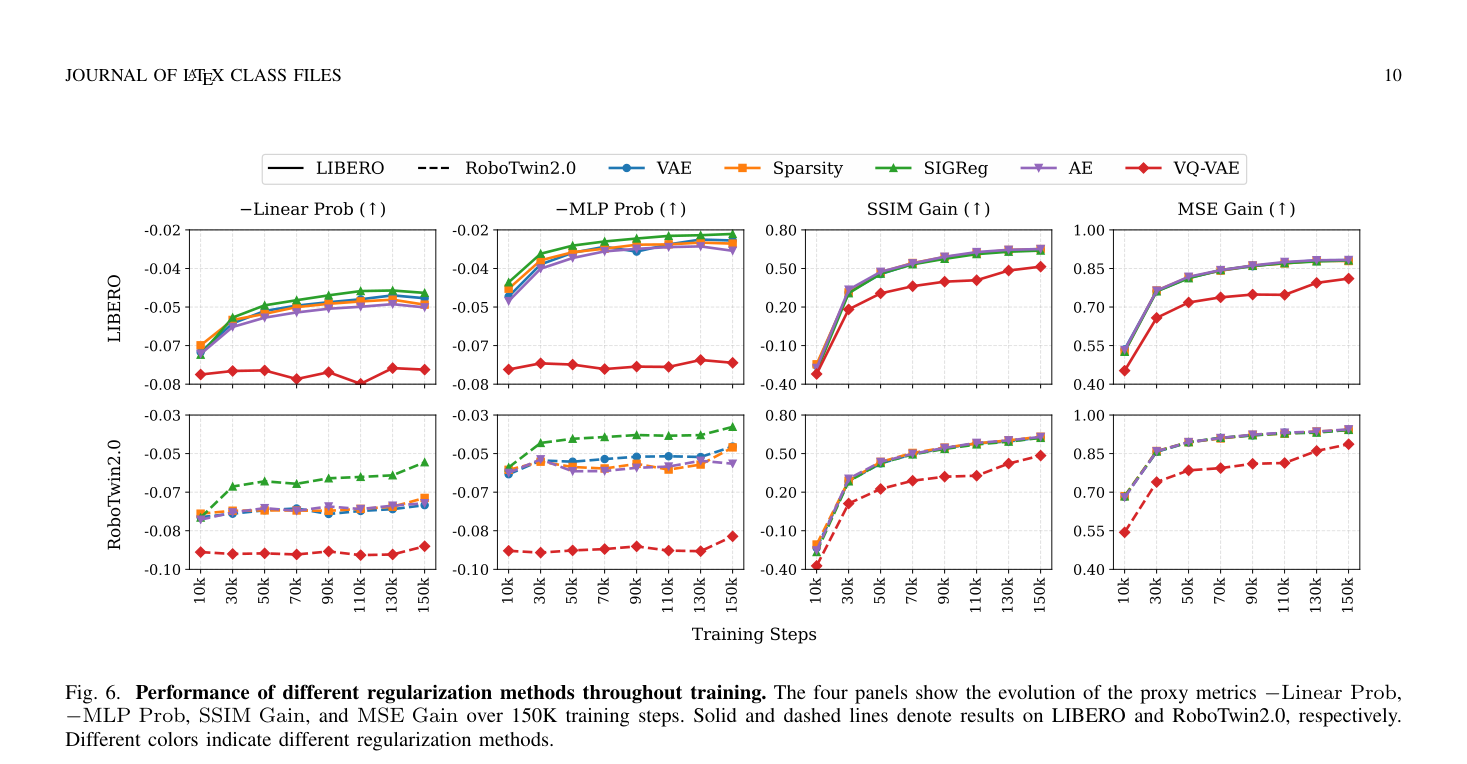
该图展示不同正则化方法在150K训练步内代理指标的演化轨迹。观察要点:重建指标(SSIM Gain、MSE Gain)在训练后期趋于分化,而探针指标趋于饱和,这解释了为何重建指标与下游性能相关性更强。
意义与局限
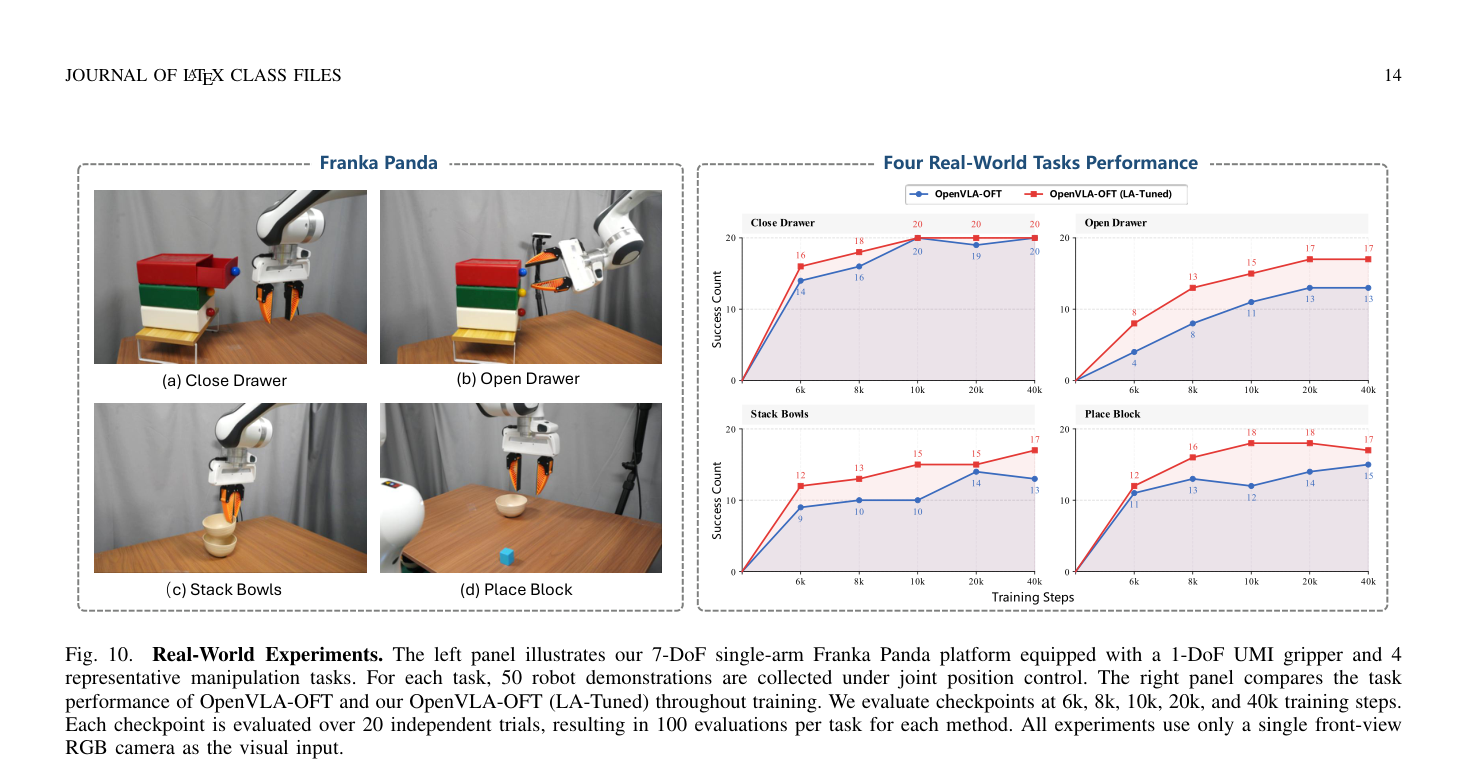
该图展示真机实验平台与LA-Tuned对比OpenVLA-OFT的训练曲线。观察要点:LA-Tuned在训练早期即获得更高成功率且优势持续到40k步,说明潜在动作微调带来的初始化优势在低数据真机场景下尤为显著。
实验如何设计?
- 三个基准:LIBERO、LIBERO-Plus和RoboTwin2.0,覆盖多样化的操作任务与场景分布,避免单一基准的过拟合结论。
- 三阶段训练流程:Stage I在无标注视频上预训练潜在动作模型,Stage II用潜在动作微调VLM骨干(OpenVLA-OFT),Stage III在下游操作任务上微调策略,所有方法共享相同的Stage II和III配置以隔离Stage I设计的影响。
- 物理动作可及性设置:区分Physical Action Inaccessible(仅潜在动作用于微调VLM骨干,对应DAP和LAP)与Physical Action Accessible(潜在动作与物理动作联合微调,对应JAP系列),模拟不同的数据可用性场景。
- 真机实验配置:Franka Panda 7-DoF单臂机器人配备1-DoF UMI夹爪,每个任务采集50条演示,在6k、8k、10k、20k、40k训练步评估检查点,每个检查点20次独立试验,仅使用单目前视RGB相机。
关键结果与论文证据
- LAPO平均排名第一(0.7327),优于ΔDINO(0.7280)、CoMo(0.7167)和ΔRGB(0.6973),说明原始IDM-FDM框架在原始数据上仍是强基线,复杂改进并未带来一致增益(第9页)。
- 简单语义特征差分ΔDINO以极低的实现复杂度获得与LAPO接近的性能,表明显式语义差分是潜在动作学习的高性价比路线(第9页)。
- 光学流方法RAFT和SEA-RAFT表现最差(0.6427和0.6433),显式像素位移建模在噪声环境下性能显著下降,不适合作为潜在动作学习的基础表示(第9页)。
- VQ-VAE在LIBERO-Plus上平均成功率0.517,优于AE(0.445)和VAE(0.433),但离散化优势不跨基准泛化,在LIBERO和RoboTwin2.0上表现相对较差(第10页)。
- 正则化强度的选择比正则化方法本身更重要:过强正则化会抑制转移动力学信息,导致下游性能下降,这一模式在所有正则化方法中一致出现(第10页)。
- 潜在动作维度32在所有基准上一致取得最佳整体性能,维度过小信息不足、过大则引入冗余噪声(第11页)。
- FDM重建指标(SSIM Gain、MSE Gain)与下游性能的相关性强于探针指标(−Linear Prob、−MLP Prob),但代理指标仅适用于粗粒度模型选择,不足以可靠识别最优模型(第12页)。
- 潜在动作归一化在适当预训练正则化下不必要:归一化与未归一化设置的性能差异在零带附近波动,无一致方向(第12页)。
- 用潜在动作微调VLM骨干能为下游策略学习提供更强初始化,且扩大潜在动作预训练规模持续提升性能(第13页)。
- 真机实验中LA-Tuned版本在4个任务上均优于OpenVLA-OFT基线,确认仿真结论在真实硬件上的可迁移性(第14页)。
阅读时需要注意
- 代理指标仅适用于粗粒度模型选择,不足以可靠识别最优模型,完整三阶段训练流程的下游评估仍不可替代。
- 光学流方法在噪声环境下性能显著下降,显式像素位移建模不适合潜在动作学习,但本文未深入分析噪声类型与光流退化机制的关系。
- VQ-VAE的离散化优势不跨基准泛化,其适用条件尚不明确,需要进一步研究离散表示在何种数据分布下有益。
- 研究主要基于视频-only设置,未深入探讨异构机器人平台控制接口差异对潜在动作学习的影响,跨形态泛化仍是开放问题。
关联工作
- LAPO(第4页):标准自监督IDM-FDM框架,本文的基准方法,其原始设计在系统比较中仍表现最强,说明后续改进的增益被高估。
- LAOF(第4页):在LAPO基础上引入光流作为辅助监督信号,但本文发现光流类方法整体表现最差,辅助监督的收益值得重新审视。
- CoMo(第4页):用连续帧差分替代未来帧输入以缓解捷径学习,在本文比较中表现中游,说明捷径学习问题可能被过度强调。
- StaMo(第2页):使用DINOv2语义特征差分显式学习潜在动作,本文的ΔDINO基线验证了这一思路的有效性,但StaMo的完整框架并未带来超越简单差分的增益。
- OpenVLA-OFT(第8页):Stage II和III的基线VLA模型,本文的LA-Tuned版本通过潜在动作微调获得更强初始化,验证了LAM作为VLA预训练增强手段的实用性。