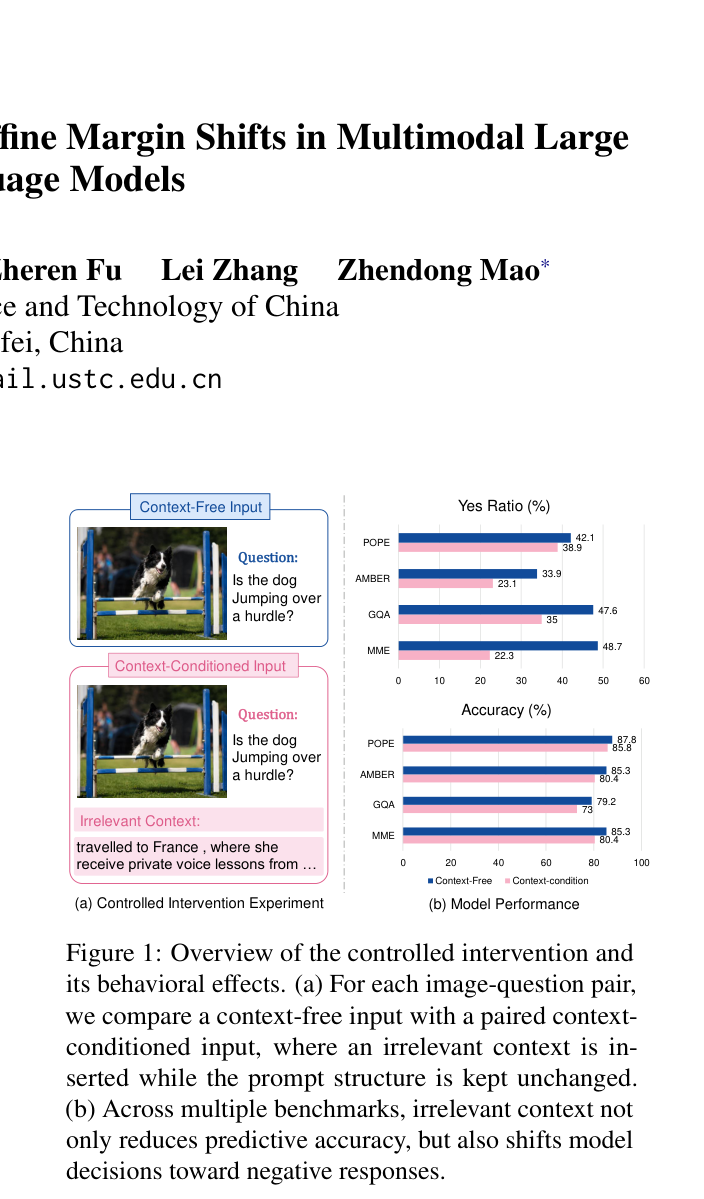
快速导读:本文通过受控干预实验发现,图像无关文本会以可估计的仿射变换方式系统性扭曲MLLM的决策边际,使其预测偏向否定回答。
多模态大语言模型(MLLM)在视觉问答中常暴露于辅助文本上下文,但无关文本如何影响其视觉决策,此前缺乏机制层面的系统刻画。本文通过受控干预实验发现,图像无关文本会以可估计的仿射变换方式系统性扭曲模型的决策边际,使其预测偏向否定回答。
这一发现的意义在于:它把此前零散的文本偏差与幻觉现象,统一到一个可拟合、可解释、可校准的数学框架中。作者进一步证明,仿射参数具有稳定的语义解释,并据此设计了无需更新模型参数的事后校准方法。
英文题目:When Irrelevant Text Matters: Affine Margin Shifts in Multimodal Large Language Models
论文出处:arXiv 每日论文精选 · arXiv:2608.19208
原始论文:PDF / 论文页面
这篇论文解决什么问题?
NLP 领域已有研究表明 LLM 对无关上下文敏感,例如 Jia 和 Liang(2017)的对抗性阅读理解实验,以及 Shi 等人(2023)展示的推理任务中的注意力分散现象。在 MLLM 领域,Deng 等人(2025)研究了视觉语言模型对文本的盲信问题,Yoran 等人(2024)则关注 RAG 中无关上下文对 LLM 鲁棒性的影响。
然而,这些工作大多停留在行为层面的现象描述,即报告准确率下降或预测翻转,缺乏对决策边际这一中间变量的机制性刻画。决策边际定义为肯定与否定答案的对数概率差,它比离散的预测标签包含更丰富的模型内部状态信息。
本文的核心问题是:无关文本对 MLLM 决策边际的影响,是否遵循某种可估计的结构化规律?如果存在这样的规律,能否利用它来设计轻量级的校准方法?
核心创新
- 首次系统揭示无关文本对MLLM决策边际的仿射变换规律mc≈a·m0+b
- 提出将仿射参数解释为视觉承诺保持度(a)与方向性答案偏移(b)
- 设计无需更新模型参数的轻量级事后仿射校准方法,可跨数据集迁移
- 通过支持/无关/冲突三类上下文干预验证参数解释的单调性
方法概览
将无关文本作为受控干预,在二值视觉判断框架下比较context-free与context-conditioned输入;定义决策边际为肯定/否定答案的对数概率差,发现mc≈a·m0+b的仿射关系,并基于此设计事后校准方法。
- 受控干预设计:对每个图像-问题对,比较 context-free 输入与 context-conditioned 输入,后者在保持提示结构不变的前提下插入无关文本。
- 三种输入条件:context-free、context-neutral(无关文本被明确标记为与图像无关)、context-conditioned(无关文本被呈现为可能与图像相关),用于考察语义框架的影响。
- 决策边际定义:m = log P(yes) – log P(no),即肯定与否定答案的对数概率差。
- 仿射拟合:在四个基准上拟合 mc ≈ a·m0 + b,其中 m0 为无上下文边际,mc 为有上下文边际,a 为斜率,b 为偏移。
- 参数解释验证:通过支持/无关/冲突三类上下文干预,检验斜率 a 是否单调变化,以验证其作为视觉承诺保持度的解释。
- 事后校准:利用拟合的仿射参数对 context-conditioned 边际进行逆变换,恢复接近 context-free 的决策边界,无需更新模型参数。
- 跨数据集迁移:在 POPE 上拟合参数,直接应用于 AMBER、MME、GQA 等其他基准,检验仿射规律的模型级稳定性。
- 消融实验:对提示模板、文本长度、文本来源、标签措辞、上下文角色等因素进行系统消融。
逐图理解论文
一个具体失败案例
想象一个简单的二值视觉问答:模型本来对图像内容有明确的肯定或否定倾向。现在,我们在提示中插入一段与图像完全无关的文本,比如一段维基百科的随机段落。结果不是随机的噪声扰动,而是模型整体变得更倾向于回答否定。更关键的是,当这段无关文本被包装成可能与图像相关时,这种否定偏移会进一步加剧。这说明问题不在于文本内容本身,而在于模型如何解读文本与图像的关系。
研究空白:从行为现象到边际机制
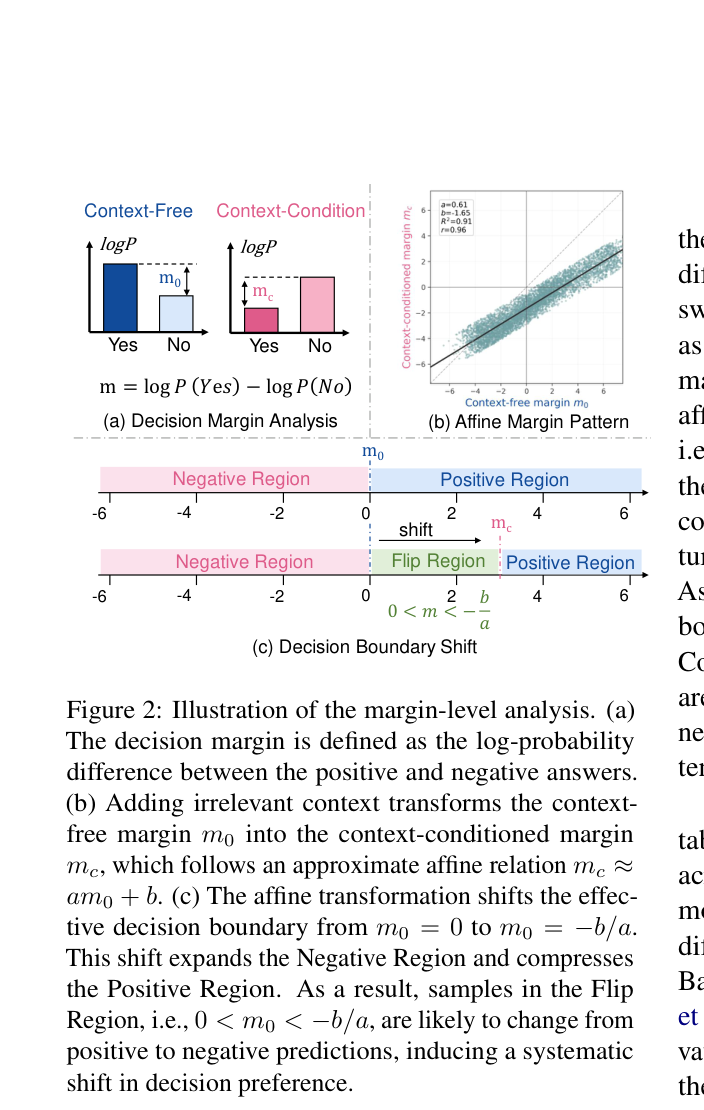
该图是全文机制的核心示意:决策边际 m0 在加入无关文本后被仿射变换为 mc,有效决策边界从 m0=0 移到 m0=-b/a。注意 Flip Region 的标注,它解释了为什么边界附近的样本最容易发生预测翻转。
核心贡献:仿射变换规律与事后校准
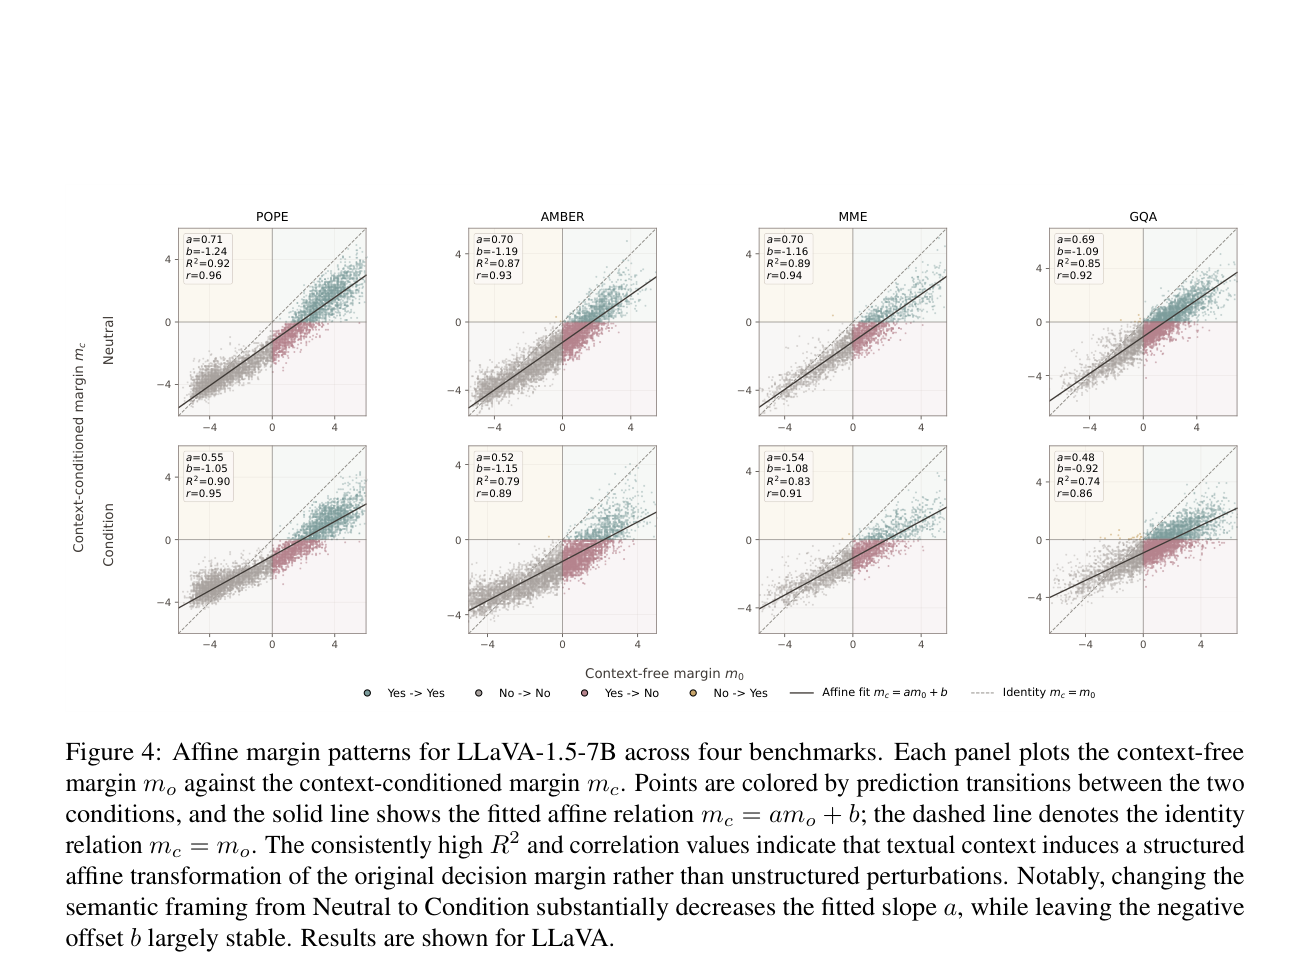
该图展示 LLaVA-1.5-7B 在四个基准上的仿射拟合散点图。点按预测转移着色,实线为拟合的仿射关系,虚线为恒等关系。高 R² 和相关系数表明上下文诱导的是结构化变换而非无结构扰动。
参数解释的验证
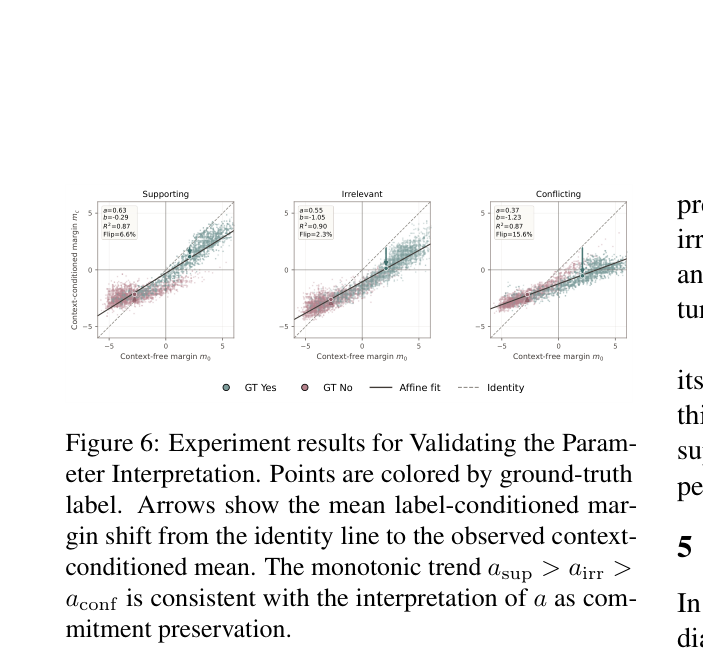
该图验证仿射参数的语义解释:支持、无关、冲突三类上下文的斜率呈单调递减趋势。箭头显示标签条件化的平均边际偏移,asup > airr > aconf 的单调性支持将 a 解释为视觉承诺保持度。
校准的迁移能力
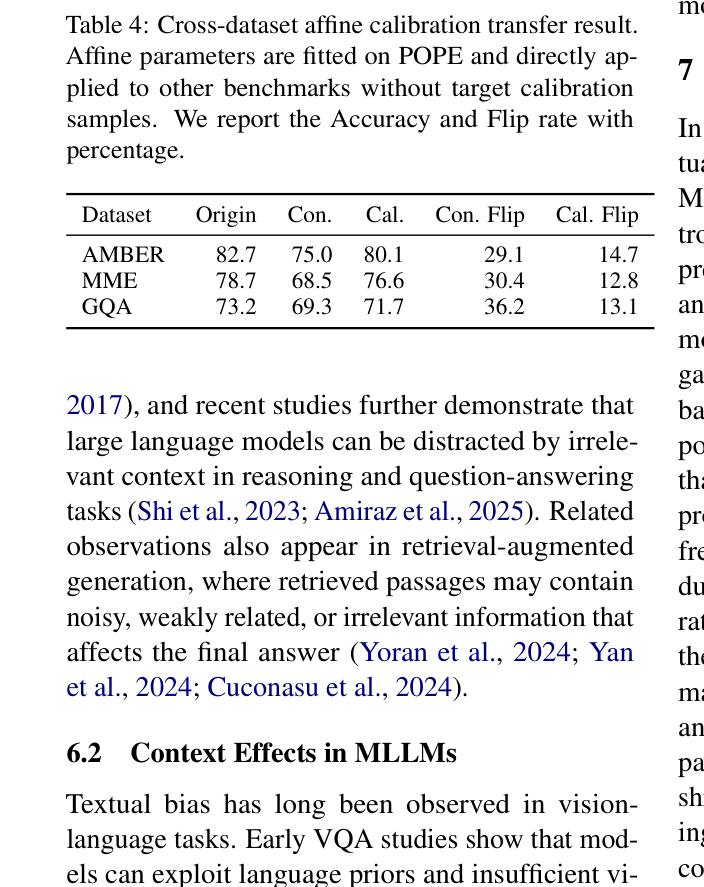
该表展示跨数据集校准迁移:POPE 拟合的参数直接应用于其他基准,无需目标数据集校准样本。准确率的提升支持仿射规律是模型级失真而非基准特定伪影的结论。
实验如何设计?
- 模型:LLaVA-1.5-7B、Qwen2-VL-2B/7B、InternVL3-8B,覆盖不同架构与规模。
- 基准:POPE、AMBER、MME、GQA 四个二值视觉判断基准。
- 评估指标:准确率、Yes Rate(肯定回答比例)、Flip Rate(预测翻转比例)、仿射拟合的 R² 与 MAE。
- 校准协议:在域内设置中,仿射参数在 calibration split 上拟合,在 held-out test split 上评估;跨数据集设置中,参数在源数据集拟合后直接应用于目标数据集。
- 上下文来源:主要使用 WikiText 作为无关文本来源,并通过消融验证文本来源的影响。
关键结果与论文证据
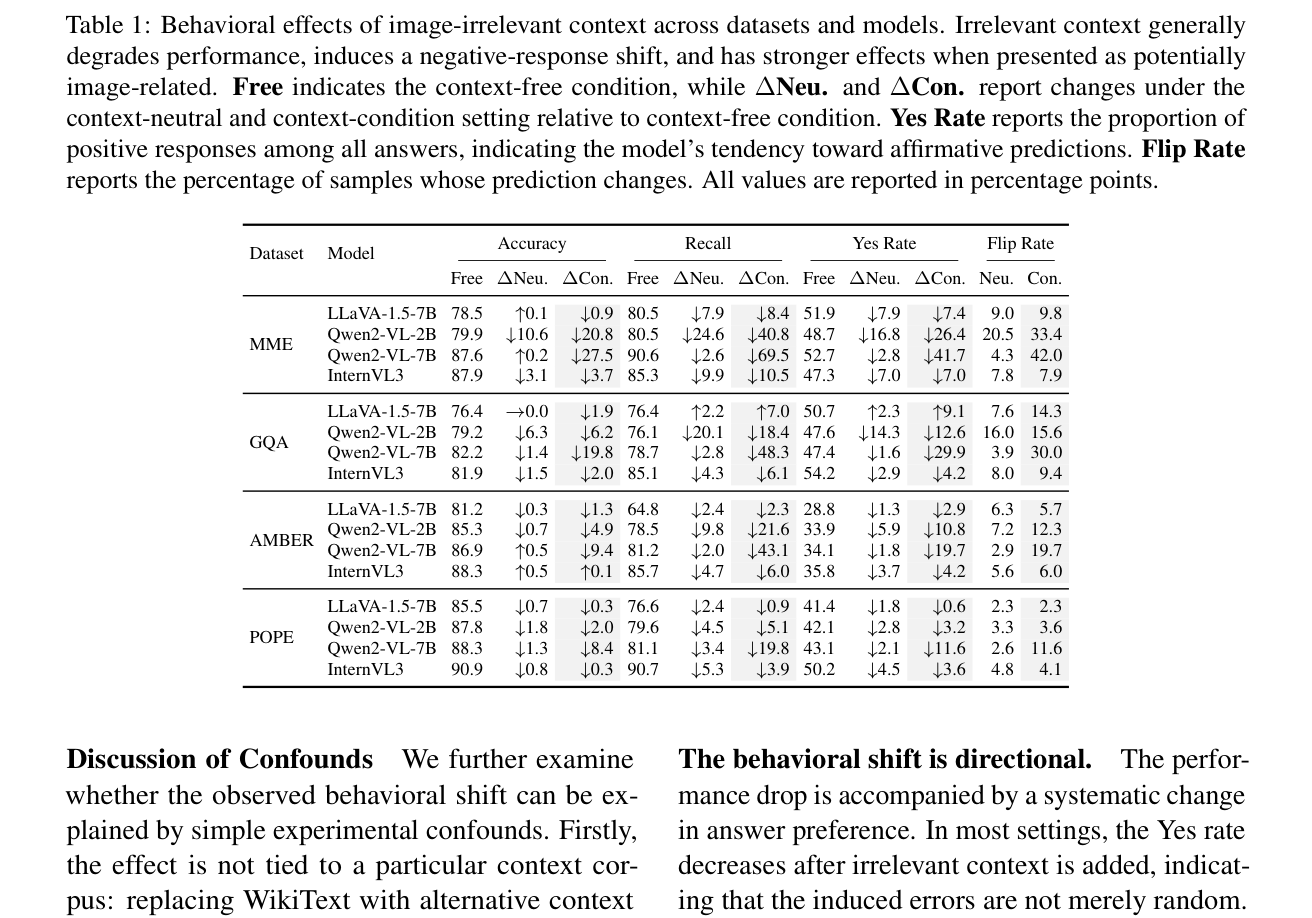
- 行为效应:无关文本普遍降低预测准确率,并诱导否定回答偏移;当无关文本被呈现为可能与图像相关时,效应更强(第4页,Table 1)。
- 仿射规律:LLaVA-1.5-7B 在 POPE 上 Condition 设置下仿射拟合 R²=0.90,a=0.55,b=-1.05,表明无关文本对决策边际的影响高度结构化(第5页,Figure 4)。
- 边界偏移机制:仿射变换将有效决策边界从 m0=0 移到 m0=-b/a,扩大否定区域、压缩肯定区域,Flip Region 中的样本(0 < m0 < -b/a)倾向于从肯定翻转为否定(第2页,Figure 2)。
- 翻转集中性:翻转率在 |m0| 较小的样本上显著更高,说明上下文诱导的翻转集中在原始决策边界附近(第6页,Figure 5)。
- 参数解释验证:支持/无关/冲突上下文的斜率呈单调关系 asup > airr > aconf(0.63 > 0.55 > 0.37),与 a 作为视觉承诺保持度的解释一致(第7页,Figure 6)。
- 域内校准:逆仿射校准使 LLaVA-1.5-7B 准确率相对 Context 提升 3.2–7.9 个百分点,Flip 降低 10.5–21.5 个百分点(第13页,Table 6)。
- 跨数据集迁移:POPE 拟合参数迁移到 AMBER 使准确率提升 5.1 个百分点(75.0→80.1),Flip 从 29.1 降至 14.7,表明仿射规律具有模型级稳定性(第8页,Table 4)。
- 模型完备性:完整仿射模型在 POPE 上 held-out MAE=0.52,R²=0.92,Flip 预测 F1=0.85,优于仅偏移或仅缩放的简化模型(第17页,Table 13)。
阅读时需要注意
- 分析主要限于二值视觉问答设置,未完全覆盖开放式多模态生成任务。
- 实验采用受控干预的无关上下文,未涵盖真实应用中异构、动态的辅助上下文。
- 缺乏对仿射规律的完整理论解释与因果机制识别,目前仍以经验拟合为主。
- 仿射校准仅能部分补偿上下文引起的边际偏移,无法完全消除其影响。
- 仿射参数受问题格式、提示措辞、上下文位置等因素影响,可能是更广泛上下文干扰现象的特例。
关联工作
- Jia 和 Liang(2017)的对抗性阅读理解研究,展示了无关干扰句如何误导 QA 模型,是本文问题动机的重要来源。
- Xie 等人(2021)将 in-context learning 解释为隐式贝叶斯推断,为本文仿射参数的概率解释提供了理论视角。
- Zhao 等人(2021)提出校准 ICL 中的系统性偏差,与本文事后校准思路在方法论上相关。
- Deng 等人(2025)研究视觉语言模型对文本的盲信问题,Yoran 等人(2024)研究 RAG 中无关上下文的影响,共同构成了本文的问题背景。