快速导读:SpurCon 提出一种轻量级框架,通过少样本虚假标签估计(Pick-and-Predict)和加权监督对比损失(WtSupCon)利用元数据(如患者ID)重塑表示几何,以缓解医学影像中的虚假相关性。
医学影像模型常利用与病理共现的虚假线索(如导管、手术标记、背景)做出预测,在分布内看似准确,却在少数群体上严重失效。SpurCon 针对这一问题的核心主张是:虚假相关性的缓解不应依赖昂贵的全量标注或重型两阶段训练,而可以通过冻结预训练编码器、仅训练轻量投影头,并利用患者元数据重塑对比学习的表示几何来实现。
SpurCon 由两个组件构成:Pick-and-Predict 用少量专家标注样本估计全数据集的虚假标签;WtSupCon 将正样本对按 [类别, 虚假标签, 患者ID] 划分为三个集合,赋予递减权重。实验在 Toy dataset、Waterbirds、CheXpert-Pneumothorax 和 ISIC 2020 上验证,SpurCon 在最差组精度上全面超越 JTT、DFR 和 Contrastive Adapters,同时训练时间大幅缩短。
英文题目:SpurCon: Weighted Supervised Contrastive Learning for Mitigating Spurious Cues in Medical Imaging
论文出处:arXiv 每日论文精选 · arXiv:2608.17598
原始论文:PDF / 论文页面
这篇论文解决什么问题?
医学影像中的虚假相关性具有临床危险性。以 CheXpert-Pneumothorax 为例,气胸患者常带有胸腔引流管,模型可能学会识别引流管而非气胸本身。当测试分布中气胸患者不再带管时,模型性能急剧下降。ISIC 2020 皮肤病变数据集中,良性样本常带有特定标记或背景,Baseline 模型在最差组精度上甚至降到 0.0,而平均精度高达 98.2,说明模型完全依赖虚假线索。
现有缓解方法各有代价。JTT 需要两阶段训练,先训练 ERM 模型识别错误样本,再上采样重训;DFR 需要先训练完整模型再重训最后一层;Contrastive Adapters 基于 CLIP 构建对比适配器。这些方法要么计算开销大,要么未充分利用基础模型的语义知识。
监督对比学习(SupCon)在自然图像上表现良好,但对所有正样本等权处理。在医学影像中,同一患者的不同图像可能共享大量非病理视觉特征,等权拉近所有同类样本会强化虚假相关性。SpurCon 的关键洞察是:患者ID 提供了天然的组结构信息,可以用来区分哪些正样本对应该被更强地拉近。
核心创新
- 提出 Pick-and-Predict:无需网络训练的少样本虚假标签估计方法,利用预训练编码器原型与余弦相似度
- 提出 WtSupCon 加权监督对比损失,按 [类别, 虚假标签, 元数据] 组合分配样本特定权重
- 将元数据(如患者ID)纳入对比学习以增强虚假相关性缓解
- 仅训练轻量投影头,大幅降低计算开销
方法概览
SpurCon 包含两部分:(1) Pick-and-Predict:利用冻结的预训练编码器(如 BiomedCLIP)提取少量专家标注样本的嵌入,按虚假标签计算原型,通过余弦相似度最近邻为其余样本分配虚假标签;(2) WtSupCon:将正样本对按 [类别, 虚假标签, ID] 划分为三个集合,赋予递减权重(同ID不同虚假标签 > 同ID同虚假标签 > 仅同类),并采用 ID-paired 或 Balanced-groups 采样器。仅训练轻量投影头,编码器冻结。
- Pick-and-Predict(第3页,图2):专家为每个虚假类别标注 N 个样本,均匀分布在各类别上。用冻结的 BiomedCLIP 编码器提取这些样本的嵌入,按虚假标签求平均得到原型。其余训练和验证样本通过余弦相似度最近邻分配到虚假标签。整个过程无需任何网络训练。
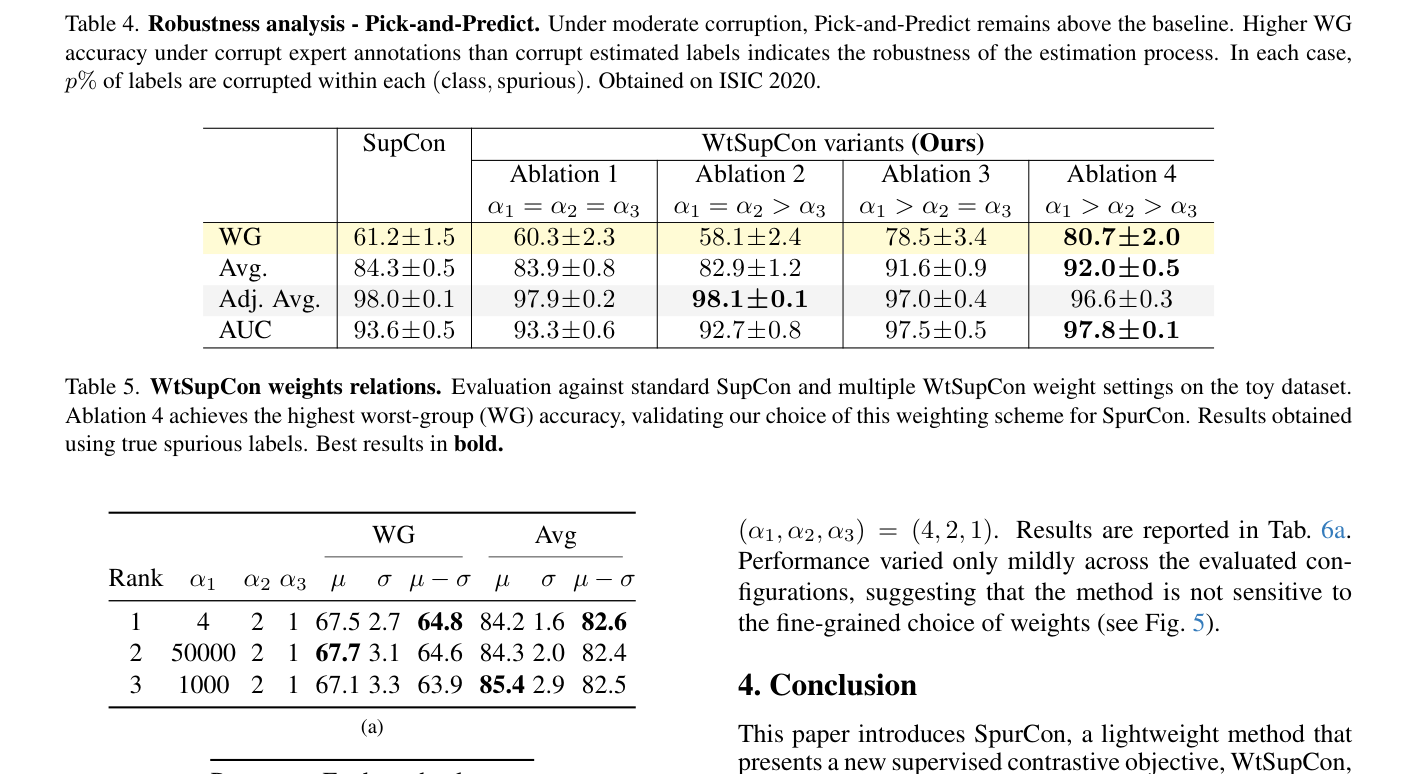
- WtSupCon 损失(第3页,表1):对每个锚点,正样本被划分为三个集合。集合1:同ID且不同虚假标签;集合2:同ID且同虚假标签;集合3:仅同类。三个集合的权重满足 α1 > α2 > α3,即最强调同ID不同虚假标签的正样本对,迫使模型忽略虚假线索而关注病理本身。
- 采样器设计:ID-paired sampler 偏向将同ID样本放入同一批次,保证集合1和集合2有足够的正样本对;Balanced-groups sampler 优先保证每个批次覆盖多个组,避免批次内组分布失衡。
- 训练策略:编码器完全冻结,仅训练轻量投影头。这大幅降低了计算开销,同时避免了在有限医学数据上微调大模型带来的过拟合风险。
- 元数据的作用:患者ID 是医学影像中天然可得的元数据。同一患者的多次成像共享解剖结构和成像设备特征,但可能跨越不同的病理状态和虚假属性,这为对比学习提供了理想的负例对和加权正例对。
- 与 Correct-n-Contrast 的区别:后者在自然图像上利用无监督推断的虚假标注进行对比学习,而 SpurCon 专门针对医学影像设计,利用预训练生物医学基础模型的语义知识进行标签估计。
逐图理解论文
失败案例与直觉
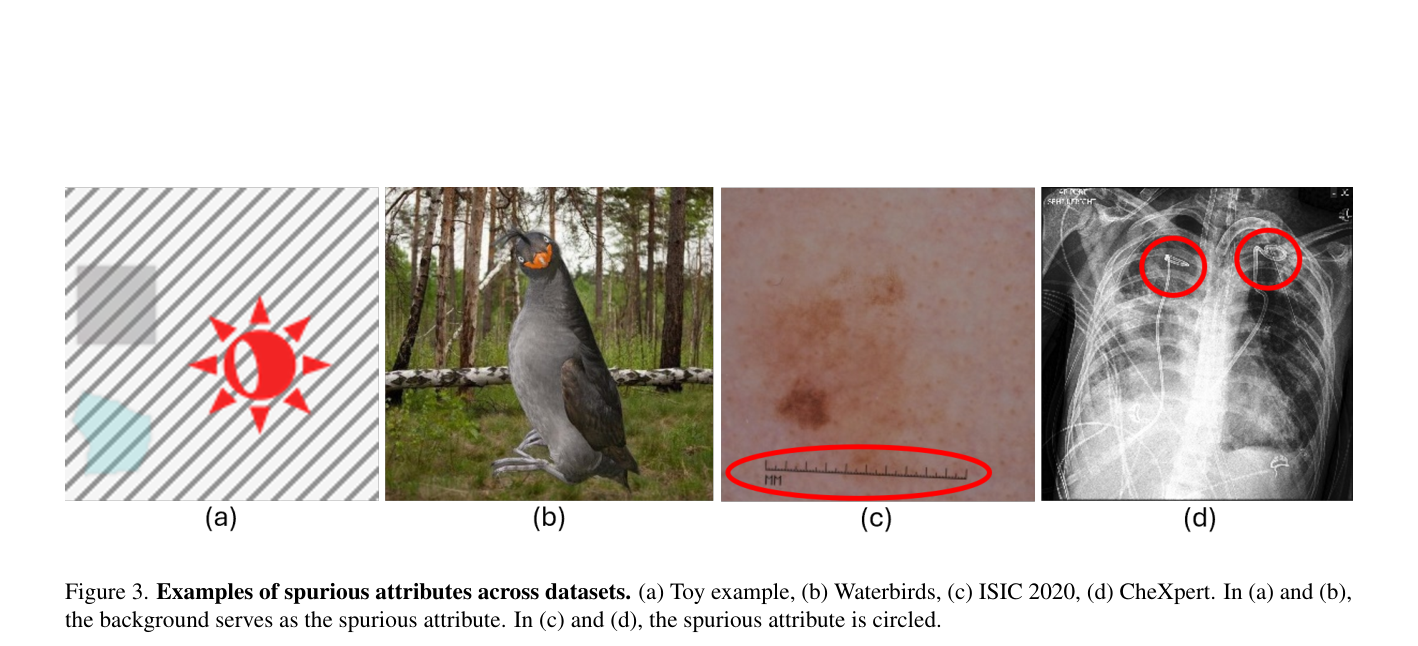
先看一个触目惊心的失败案例。在 ISIC 2020 皮肤病变数据集上,一个标准模型平均精度高达 98.2%,但最差组精度却是 0.0。也就是说,模型在大多数样本上看似完美,却对某一类患者完全失效。原因在于它学会了识别良性样本上的标记或背景,而不是病变本身。这种虚假相关性在医学影像中尤其危险,因为导管、手术标记等伪影常与病理共现,模型一旦依赖这些线索,临床部署就会酿成灾难。
方法贡献
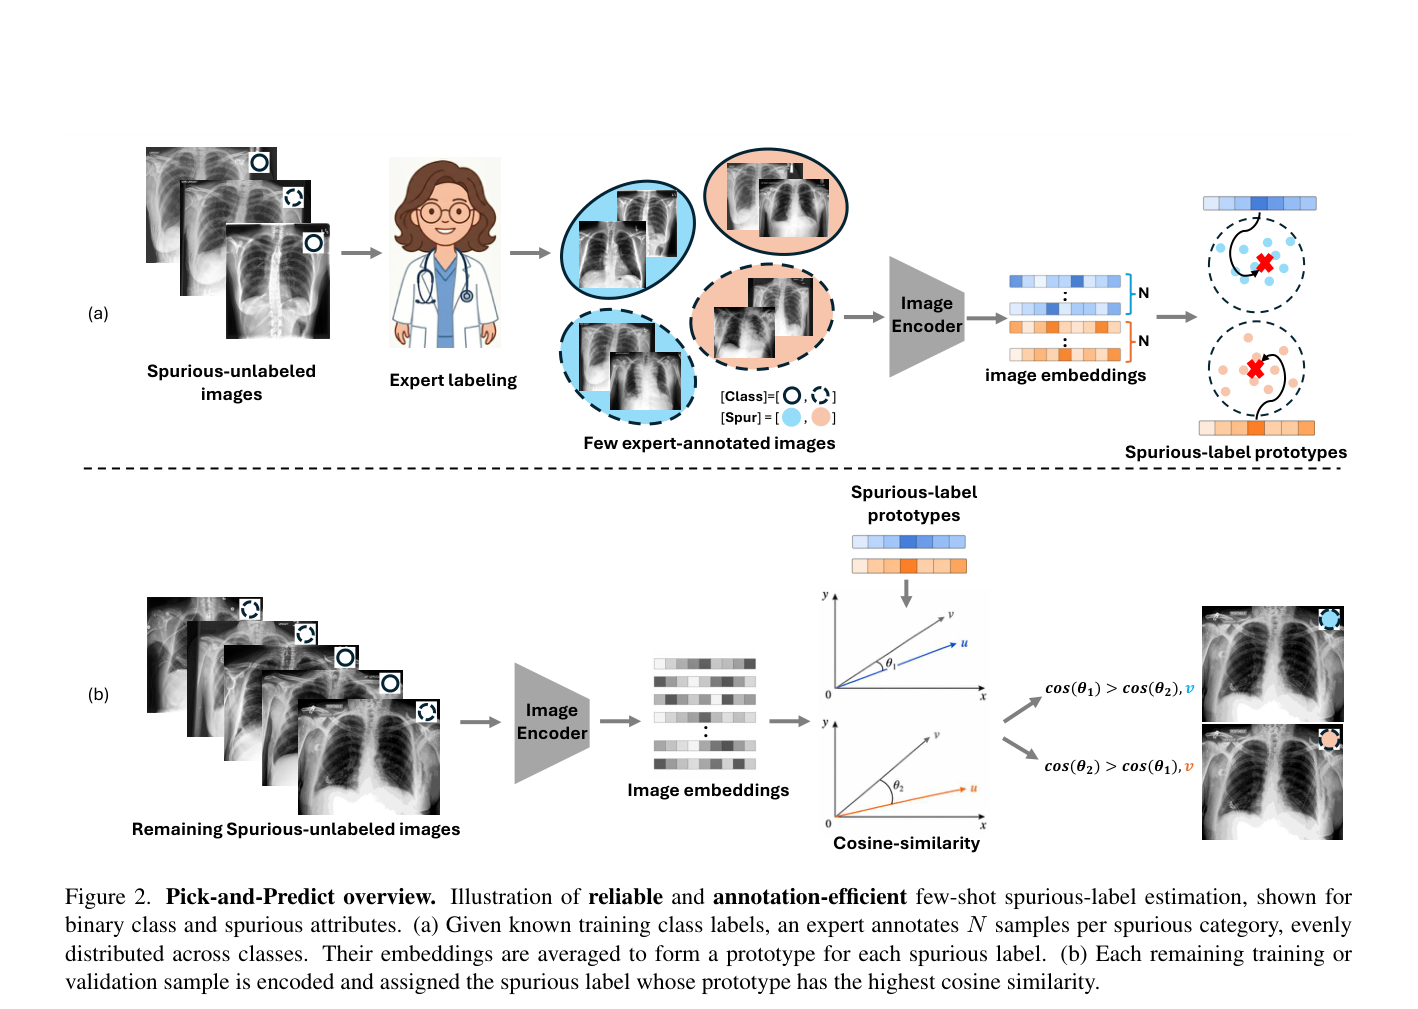
Pick-and-Predict 的两步流程。左图展示专家标注样本的嵌入如何按虚假标签聚合成原型;右图展示剩余样本如何通过余弦相似度分配到最近原型。注意整个过程无需训练,仅依赖冻结编码器的嵌入空间。
验证与结论
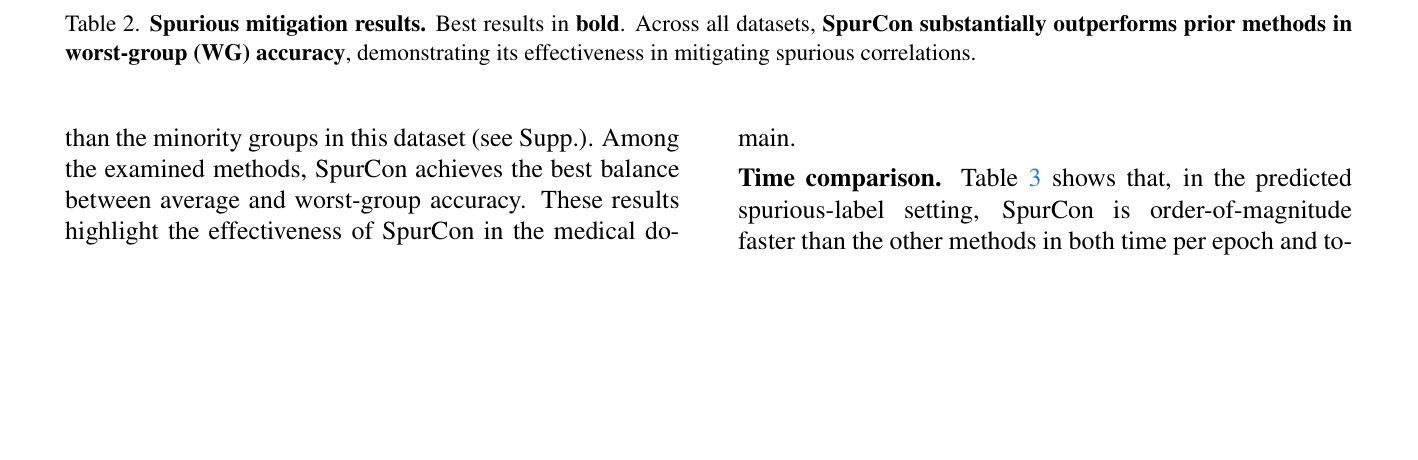
实验在 Toy dataset、Waterbirds、CheXpert-Pneumothorax 和 ISIC 2020 上全面验证。SpurCon 在所有数据集的最差组精度上大幅超越 JTT、DFR 和 Contrastive Adapters,尤其在 ISIC 2020 上,将最差组精度从 0.0 提升到 65.0。同时,训练时间比 DFR 快约 9 倍,比 JTT 快约 5.5 倍。消融实验证实,权重关系 α1 大于 α2 大于 α3 是关键,且对具体权重值不敏感。
意义与局限
SpurCon 的意义在于证明了:缓解医学影像虚假相关性,不需要昂贵的全量标注或重型两阶段训练,冻结编码器加轻量投影头就足够。但它的局限也很诚实:Pick-and-Predict 在 ISIC 2020 上的标签估计 AUC 只有 80.9%,且需要患者ID 等元数据才能发挥最佳效果。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 数据集:Toy dataset(合成,背景为虚假属性)、Waterbirds(自然图像基准,背景为虚假属性)、CheXpert-Pneumothorax(胸腔引流管为虚假属性)、ISIC 2020(皮肤病变,标记/背景为虚假属性)。
- 对比方法:Baseline(ERM)、Baseline-WT、JTT、DFR、Contrastive Adapters。评估指标包括最差组精度(WG)、平均精度、调整平均精度和 AUC。
- 虚假标签设置:ISIC 2020 和 CheXpert 的训练/验证集使用 Pick-and-Predict 预测的虚假标签,测试集使用真实虚假标签。调整平均精度使用训练+验证集的真实组比例计算。
- 计算环境:单张 NVIDIA GeForce RTX 3090 GPU 和 20 个 CPU 核心,在 ISIC 2020 上测量训练时间。
- 消融设置:Toy dataset 上对比标准 SupCon 与四种 WtSupCon 权重变体,使用真实虚假标签;ISIC 2020 上评估 15 种权重组合的排名稳定性。
- 鲁棒性设置:在 ISIC 2020 上分别对专家标注和估计标签注入 10%、20%、30% 噪声,观察 WG 精度变化。
关键结果与论文证据
- 主结果(第6页,表2):SpurCon 在所有数据集上大幅超越先前方法的最差组精度。Waterbirds WG 87.1±0.8,CheXpert WG 73.0±0.6,ISIC 2020 WG 65.0±3.8。ISIC 2020 上 Baseline WG 为 0.0,SpurCon 将其提升至 65.0,这是最显著的改进。
- 训练效率(第7页,表3):SpurCon 每 epoch 7.9±0.6 秒,总训练时间 497±36 秒;JTT 总时间 2742±107 秒,DFR 4494±61 秒,CA 2767±69 秒。SpurCon 比 DFR 快约 9 倍,比 JTT 快约 5.5 倍。
- 标签估计质量(第7页):Pick-and-Predict 的虚假标签估计 AUC 在 Waterbirds 上为 95.4%,CheXpert 上为 97.3%,ISIC 2020 上为 80.9%。ISIC 2020 的估计精度相对较低,但主结果仍显著优于基线。
- 少样本敏感性(第7页,图4):在 Waterbirds 上,指标在少量标注样本下基本饱和,选择 N/2 = 10 即可平衡标注效率和性能。
- 权重消融(第8页,表5):Toy dataset 上,标准 SupCon WG 为 61.2±1.5,而满足 α1>α2>α3 的 Ablation 4 达到 WG 80.7±2.0,验证了加权方案的有效性。
- 权重鲁棒性(第8页,表6):15 种权重组合中,(α1, α2, α3) = (4, 2, 1) 在 ISIC 2020 验证集上排名第一,且各组合间方差较低,说明对权重选择不敏感。
- 噪声鲁棒性(第8页,表4):在 20% 专家标注噪声下,ISIC 2020 WG 仍达 58.9±4.6,高于 baseline-WT 的 58.6。专家标注噪声下的 WG 高于估计标签噪声下的 WG,说明估计过程本身具有一定鲁棒性。
- 元数据必要性:WtSupCon 的三集合划分依赖患者ID。无元数据时退化为两集合形式,性能提升有限,说明元数据是 SpurCon 效果的关键因素。
阅读时需要注意
- Pick-and-Predict 依赖少量专家标注,标注质量直接影响估计效果。ISIC 2020 上估计 AUC 仅 80.9%,说明在复杂医学影像上虚假标签估计仍有较大误差空间。
- 需要患者ID 等元数据才能发挥最佳效果。对于缺乏可靠元数据的医学影像数据集,SpurCon 的优势会减弱。
- 仅在冻结编码器、训练投影头的设置下验证,未探索端到端微调编码器的可能性。冻结策略虽然高效,但可能限制了表示学习的上限。
- ISIC 2020 上最差组精度 65.0±3.8 的方差较大,说明在严重类别不平衡和虚假标签估计误差的联合作用下,性能稳定性仍有待提升。
关联工作
- SupCon(Khosla et al., 2020)是 WtSupCon 的基础,标准监督对比损失对所有正样本等权处理。SpurCon 的核心创新在于引入样本特定的权重,区分不同粒度的正样本对。
- Contrastive Adapters(Zhang & Ré, 2022)是最接近的先前方法,基于 CLIP 的对比适配器用于组鲁棒性。SpurCon 在所有数据集的 WG 上大幅超越 CA,且训练效率更高。
- DFR(Kirichenko et al., 2023)通过最后层重训练缓解虚假相关性,但需要先训练完整模型。SpurCon 在 WG 上优于 DFR,且训练时间快约 9 倍。
- JTT(Liu et al., 2021)是两阶段训练方法的代表,先识别错误样本再上采样重训。SpurCon 在 WG 上优于 JTT,且训练时间快约 5.5 倍。
- MedAug(Vu et al., 2021)利用患者元数据的对比学习用于胸部X光表示,启发了 SpurCon 的元数据使用思路,但 MedAug 未针对虚假相关性缓解设计加权机制。