快速导读:提出MDD方法,通过解耦模型输出的幅度与方向分量,用轻量小模型估计幅度、残差复用提供方向,实现流匹配视频生成模型的免训练加速。
流匹配(Flow Matching)模型在视频生成中展现出收敛快、可控性好的优势,但其迭代去噪的推理延迟极高,严重制约实际部署。现有免训练加速方法主要分为两类:缓存复用(如TeaCache)利用相邻时间步输出冗余,大小模型协作(如SRDiffusion)用同族轻量模型替代部分步骤。然而,前者存在幅度不一致导致的误差累积,后者存在方向偏差影响视觉保真度。
本文提出幅度-方向解耦(Magnitude-Direction Decoupling, MDD)方法,将模型输出向量分解为幅度(ℓ2范数)和方向(单位向量)两个分量,分别用轻量小模型和残差复用进行估计。这一解耦思路的核心洞察是:同族轻量模型虽然方向预测不够准确,但其幅度估计相当可靠;而残差复用虽然幅度不准确,但其方向近似相当可靠。将两者结合,就能构建一个方向校准的轻量替代输出。
英文题目:Magnitude-Direction Decoupling for Fast Video Generation with Flow Matching Models
论文出处:arXiv 每日论文精选 · arXiv:2608.17695
原始论文:PDF / 论文页面
这篇论文解决什么问题?
流匹配模型通过ODE建模从先验分布到数据分布的确定性映射,在视频生成中比扩散模型收敛更快、可控性更好。但每次推理需要数十次甚至上百次大模型前向传播,单张A100上生成一段5秒视频可能需要数百秒。这种延迟使得交互式应用几乎不可行。
免训练加速的核心思路是用更廉价的输出来近似大模型在部分时间步的去噪输出。TeaCache等缓存方法复用相邻时间步的残差,但残差复用的幅度与真实输出存在系统性偏差,误差会沿轨迹累积。SRDiffusion等大小模型协作方法用轻量模型替代部分步骤,但轻量模型的方向预测与大模型存在偏差,导致生成轨迹偏离原始ODE路径。
一个关键问题是:能否同时解决幅度误差和方向偏差?本文的实证分析(图2)给出了线索:轻量模型的输出方向与大模型差异较大,但其幅度比值接近1;残差复用的方向与大模型高度一致,但其幅度比值波动明显。这意味着幅度和方向两个分量各自有更合适的估计来源。
核心创新
- 实证发现同族轻量模型能可靠估计大模型输出幅度分量,残差复用能可靠近似方向分量
- 提出MDD方法,将小模型幅度估计与残差复用方向引导结合,构建方向校准的轻量替代输出
- 引入CFG幅度复用,利用条件与无条件输出幅度近似相等进一步减半小模型推理开销
- 设计基于累积方向误差的自适应切换策略,在误差超阈值时调用大模型进行方向重校准
方法概览
MDD将模型输出解耦为幅度和方向分量:用轻量小模型估计幅度(∥vφ∥₂),用残差复用输出提供方向(ˆvθ/∥ˆvθ∥₂),组合为方向校准的轻量替代输出。通过累积方向误差阈值τ自适应触发大模型重校准,并利用CFG条件与无条件输出幅度近似相等的特点复用幅度以减半小模型推理成本。
- MDD将大模型输出vθ(xt, t)解耦为幅度∥vθ∥₂和方向vθ/∥vθ∥₂两个分量。轻量替代输出由小模型估计幅度、残差复用提供方向,组合为∥vφ∥₂ · (ˆvθ/∥ˆvθ∥₂)。
- 残差复用方向ˆvθ来自缓存的大模型残差,其方向与大模型真实输出方向高度一致(余弦相似度接近1),但幅度不可靠。小模型幅度∥vφ∥₂与大模型幅度比值接近1,但方向偏差较大。两者互补。
- 引入累积方向误差阈值τ:当轻量替代输出的累积方向误差超过τ时,调用大模型进行方向重校准,重置误差累积。τ越大,轻量替代比例越高,加速越明显,但视觉质量下降。
- CFG幅度复用:在Classifier-Free Guidance中,条件输出vφ(xt, t|c)与无条件输出vφ(xt, t|c=∅)的幅度近似相等(图2c,f),因此可以只计算一次幅度,复用给两个分支,将小模型推理成本减半。
- 算法流程(第9页):每个时间步先检查累积方向误差是否超阈值,未超则用轻量替代输出,超则调用大模型重校准并重置累积误差。CFG分支共享幅度估计。
- 与TeaCache的区别:TeaCache直接复用残差(幅度和方向都复用),MDD只复用方向、用轻量模型修正幅度。与SRDiffusion的区别:SRDiffusion直接用轻量模型输出(幅度和方向都来自小模型),MDD用残差复用修正方向。
逐图理解论文
失败案例与直觉
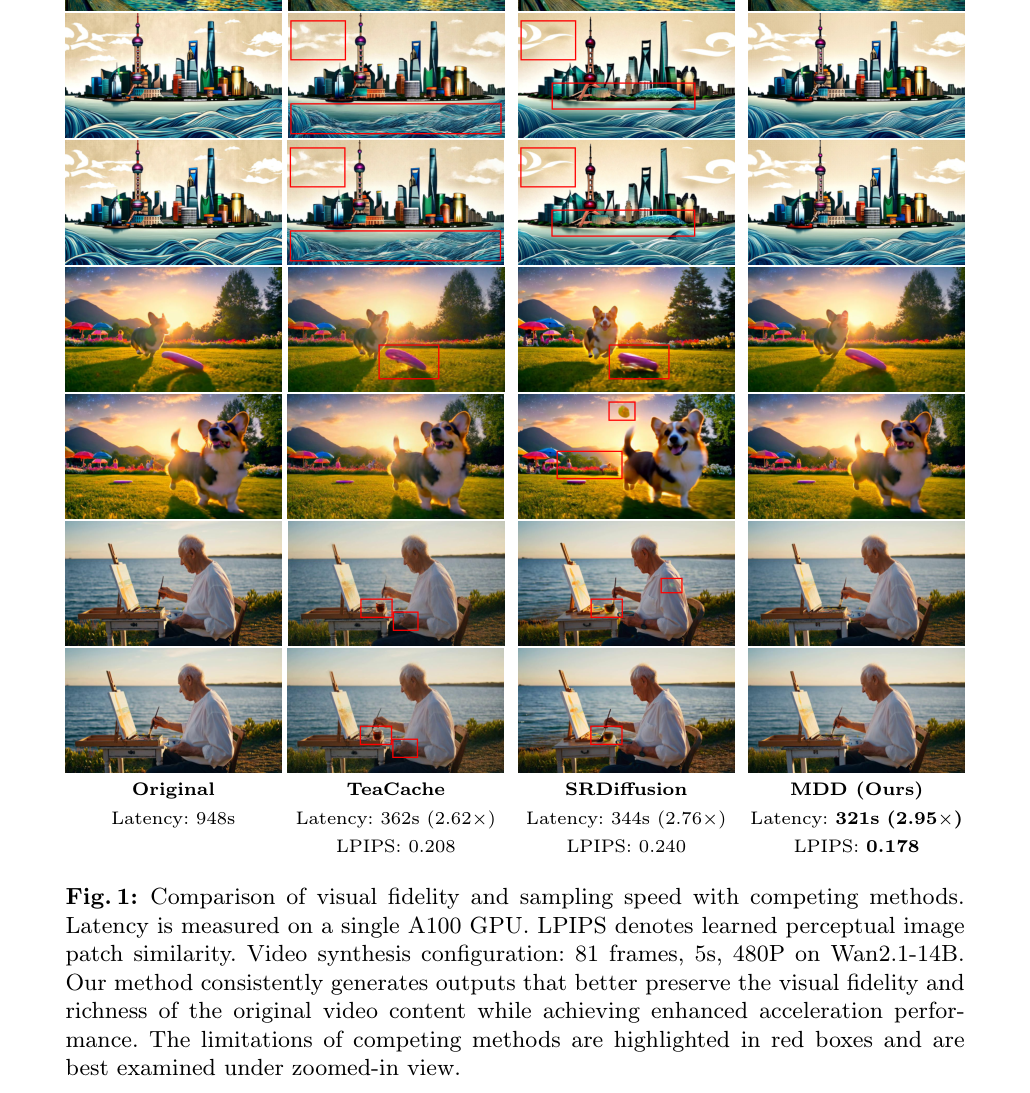
图1对比了MDD与竞争方法在视觉保真度和采样速度上的表现。红框标注了竞争方法的失效区域,放大查看可见TeaCache和SRDiffusion在细节纹理上的退化,而MDD保持了更丰富的原始内容。
核心区分:幅度与方向解耦
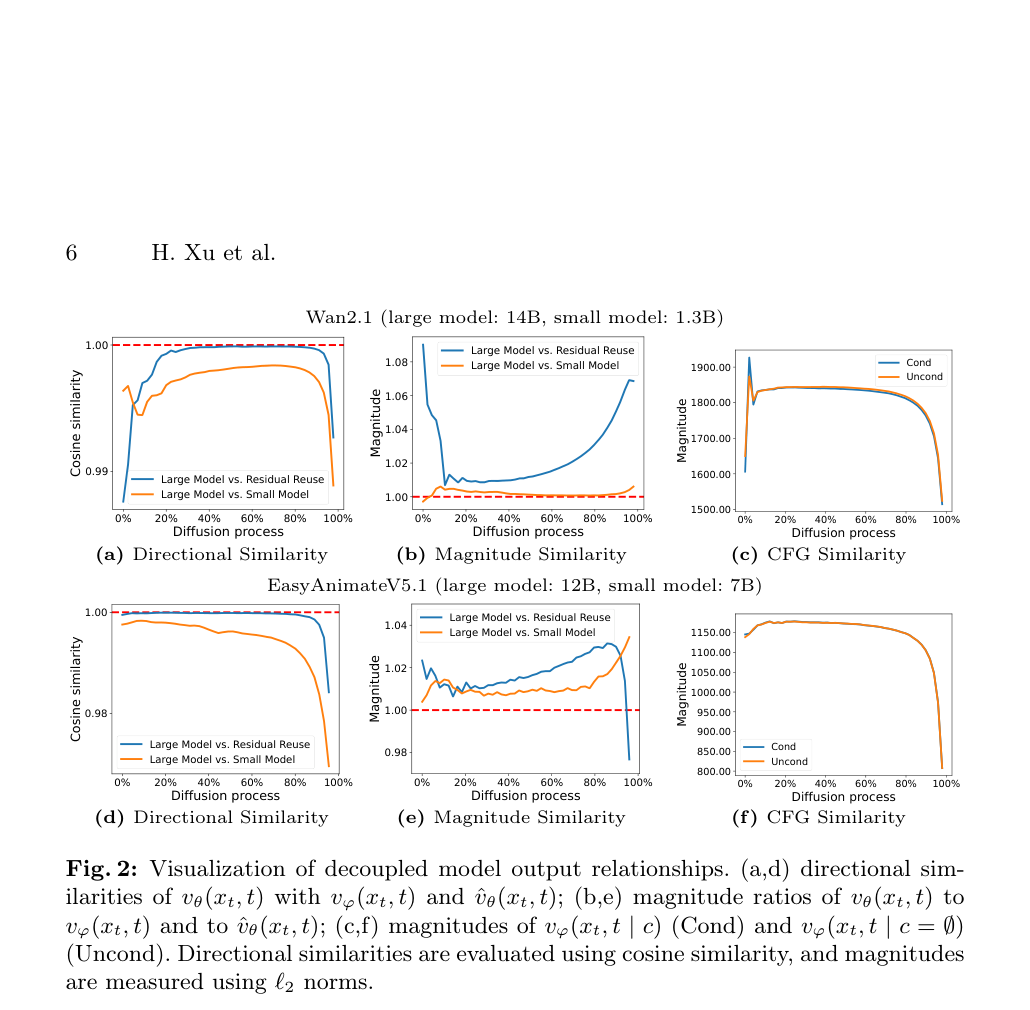
图2是本文核心实证依据。子图(a,d)显示残差复用方向与大模型方向余弦相似度接近1,而小模型方向相似度较低;子图(b,e)显示小模型幅度比值接近1,而残差复用幅度比值波动明显。这直接支撑了幅度-方向解耦的设计。
实验验证
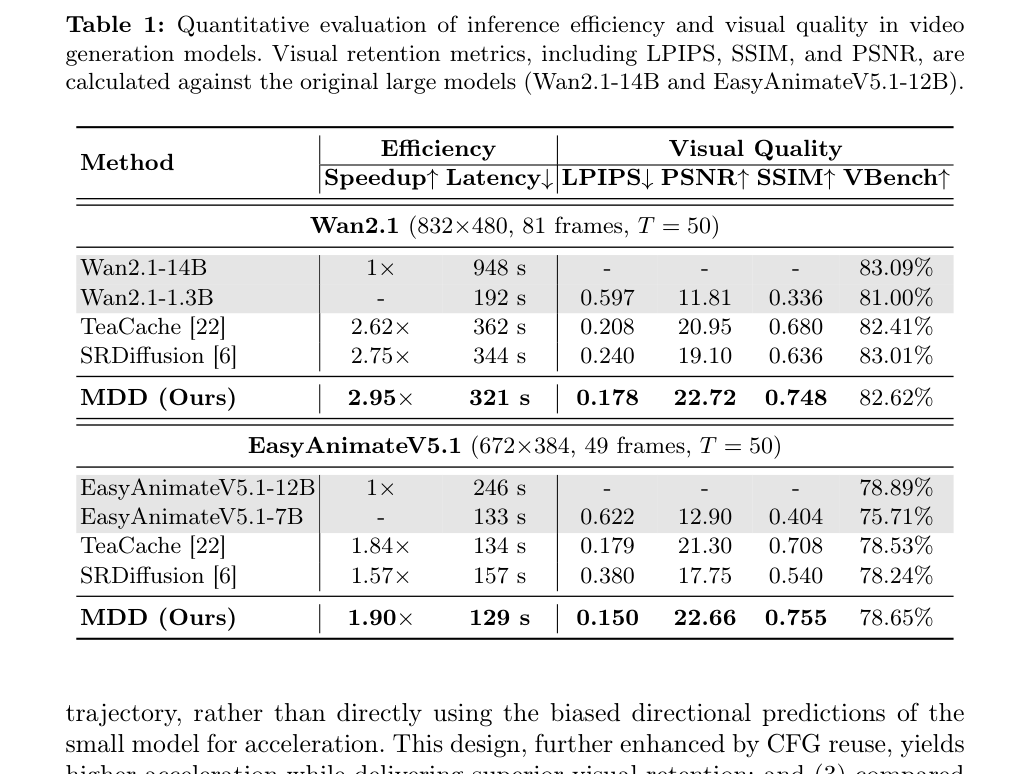
Table 1是主实验结果,展示MDD在两个模型家族上的加速比和视觉保真度指标。MDD在加速比和LPIPS/SSIM/PSNR上均优于TeaCache和SRDiffusion。
实验如何设计?
- 主实验在Wan2.1-14B/1.3B和EasyAnimateV5.1-12B/7B两个模型家族上进行,对比TeaCache和SRDiffusion两个基线。
- 视觉保真度指标为LPIPS、SSIM、PSNR,均以原始大模型输出为参考计算。加速比以延迟比值衡量,单张A100上测量。
- 消融实验覆盖阈值τ(Table 2)、幅度重缩放(Table 3)、CFG复用(Table 4)三个维度。
- 扩展实验包括720p分辨率(8×A100)、与高效ODE求解器(UniPC、DPM++)的兼容性、早期去噪阶段轻量替代影响、多GPU推理效率。
关键结果与论文证据
- Wan2.1-14B上MDD加速2.95×,延迟321s,LPIPS 0.178,PSNR 22.72,SSIM 0.748,在加速比和视觉保真度上均优于TeaCache和SRDiffusion(Table 1,第11页)。
- EasyAnimateV5.1-12B上MDD加速1.90×,延迟129s,LPIPS 0.150,SSIM 0.755,验证了跨模型家族的泛化性(Table 1,第11页)。
- 阈值τ消融显示:τ=0.001时加速2.21×、LPIPS 0.131;τ=0.010时加速3.12×、LPIPS 0.207,呈现清晰的加速-质量权衡(Table 2,第12页)。
- CFG复用带来额外1.20×加速,视觉质量几乎无下降(LPIPS 0.178 vs 0.177),验证了条件与无条件输出幅度近似相等的假设(Table 4,第13页)。
- 720p分辨率下MDD(τ=0.005)加速2.77×,LPIPS 0.292,SSIM 0.655,优于TeaCache的2.37×和SRDiffusion的2.47×(Table 5,第13页)。
- MDD与DPM++结合(T=40)加速2.68×,LPIPS 0.169,SSIM 0.765,表明MDD可与高效ODE求解器叠加使用(Table 7,第14页)。
- 0%–95%区间轻量替代加速3.85×但LPIPS恶化至0.567,验证早期去噪阶段方向冗余度低、必须保留大模型(Table 6,第14页)。
阅读时需要注意
- 阈值τ需要在新模型上通过参数扫描确定,缺乏完全自动化的选择机制。
- 方向估计依赖残差复用,在早期去噪阶段(0%–20%)冗余度低,无法应用轻量替代。
- 实验仅覆盖Wan2.1和EasyAnimateV5.1两个模型家族,泛化性有待进一步验证。
- 论文中Table 6与Table 7的标题和内容存在交叉引用不一致,阅读时需注意。
关联工作
- TeaCache(第4页):基于时间步嵌入的缓存方法,复用残差加速推理,但幅度不一致导致误差累积。
- SRDiffusion(第4页):大小模型协作推理,早期用大模型构建语义、后期用小模型细化,但方向偏差影响视觉保真。
- AdaCache(第4页):基于内容复杂度的自适应缓存方法,与MDD的自适应切换策略有相似动机。
- MagCache(第16页):幅度感知缓存方法,与本文幅度-方向解耦思路相关,但未同时处理方向分量。