快速导读:通过诊断筛选出与物体幻觉相关的32个注意力头,仅对这些头做 LoRA 适配并叠加推理时 grounding 控制器,在 COCO 上显著降低 CHAIRs/CHAIRi,同时使生成更短更保守。
本文研究 LLaVA-1.5-7B 在图像描述中的物体幻觉问题:模型会生成图像中不存在的物体。与以往要么在解码时干预、要么做宽泛参数高效微调的方法不同,本文主张干预位置和时机应由物体级诊断信号决定。
作者提出三阶段流水线:先用消融筛选定位与幻觉相关的注意力头,再仅对这些头做 LoRA 适配,最后在推理时用同一头集计算图像注意力占比并惩罚低接地物体词。核心发现是:头选择本身比 LoRA 容量更关键,而 grounding 控制器是 LoRA 之上的修饰器而非独立干预。
英文题目:Targeting the Attention Heads Behind Object Hallucination in LLaVA
论文出处:arXiv 每日论文精选 · arXiv:2608.24966
原始论文:PDF / 论文页面
这篇论文解决什么问题?
物体幻觉是视觉语言模型在图像描述中的典型失败模式。CHAIR 将其形式化为:生成的物体提及是否出现在图像标注中。LLaVA-1.5-7B 在 COCO 上 CHAIRs 高达 0.37,意味着超过三分之一的描述至少含有一个幻觉物体。
已有缓解方法大致分两类。一类是训练自由解码干预,如 VCD 对比真实与噪声图像下的输出分布、SPIN 动态抑制低图像注意力头;另一类是宽泛的参数高效微调,如全模型 LoRA。但这些方法很少由物体级诊断信号决定干预位置与时机。
本文沿用 diagnose-then-target 思路,与最接近的 Yang et al. 2025 不同之处在于:补充了随机头对照、固定预算分析和精度-覆盖权衡刻画,从而更严格地检验'头选择'这一核心主张。
核心创新
- 提出 diagnosis-to-intervention 流水线:同一消融筛选的32头集同时决定 LoRA 适配位置和推理时 grounding 控制器。
- 引入 layer-matched random-head LoRA 对照,分离头选择与 LoRA 容量的贡献。
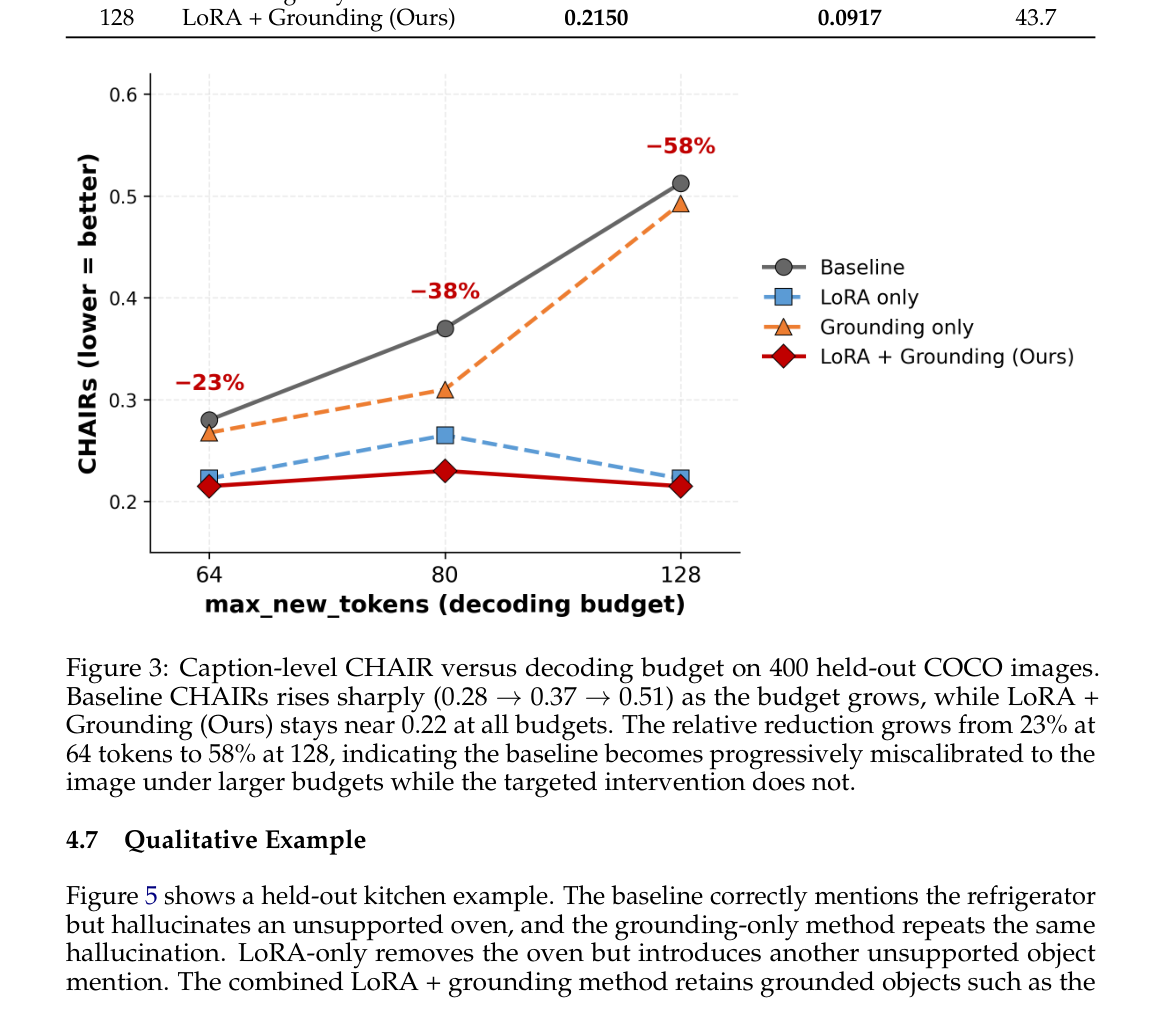
- 用固定解码预算(64/80/128 tokens)分析排除纯 max-token/截断伪影。
- 将干预报告为行为画像(幻觉、长度、召回、对照、敏感性)而非单一分数。
方法概览
三阶段流水线:(1) 在200张 COCO 筛选集上按幻觉物体词处图像注意力下降幅度排序注意力头,再逐一消融并按幻觉 token log-prob 变化筛选出32个头;(2) 仅在这些头的 Q/K/V 投影上附加 LoRA,用 DPO 目标以 COCO 真值描述为 chosen、模型幻觉描述为 rejected 训练;(3) 推理时用同一头集计算图像注意力占比 gt,低于阈值 θ=0.08 时对 COCO 物体词 logits 施加惩罚(λ=10)。
- 头筛选:在200张 COCO 筛选集上,按幻觉物体词处图像注意力下降幅度排序注意力头,再逐一消融并按幻觉 token log-prob 变化筛选出32个头。
- 头切片 LoRA:仅在这32个头的 Q/K/V 投影上附加低秩适配,用 DPO 目标训练,chosen 为 COCO 真值描述,rejected 为模型幻觉描述。
- grounding 控制器:推理时用同一头集计算图像注意力占比,低于阈值 θ=0.08 时对 COCO 物体词 logits 施加惩罚(λ=10)。
- 随机头对照:逐层匹配的随机头 LoRA 与 selected-head adapter 对比,分离头选择与 LoRA 容量的贡献。
- 固定解码预算:在64/80/128 tokens 下与 SPIN、VCD 及 baseline 对比,排除纯 max-token/截断伪影。
- 敏感性检查:LoRA 尺度扫描、阈值 θ∈{0.04,…,0.12}、top-16 vs top-32 头。
逐图理解论文
一个具体失败案例
定性示例展示 held-out 厨房图像上四种方法的输出。应关注 baseline 和 grounding-only 都幻觉出 oven,而 LoRA+Grounding 抑制该幻觉但生成更短更保守。
研究缺口
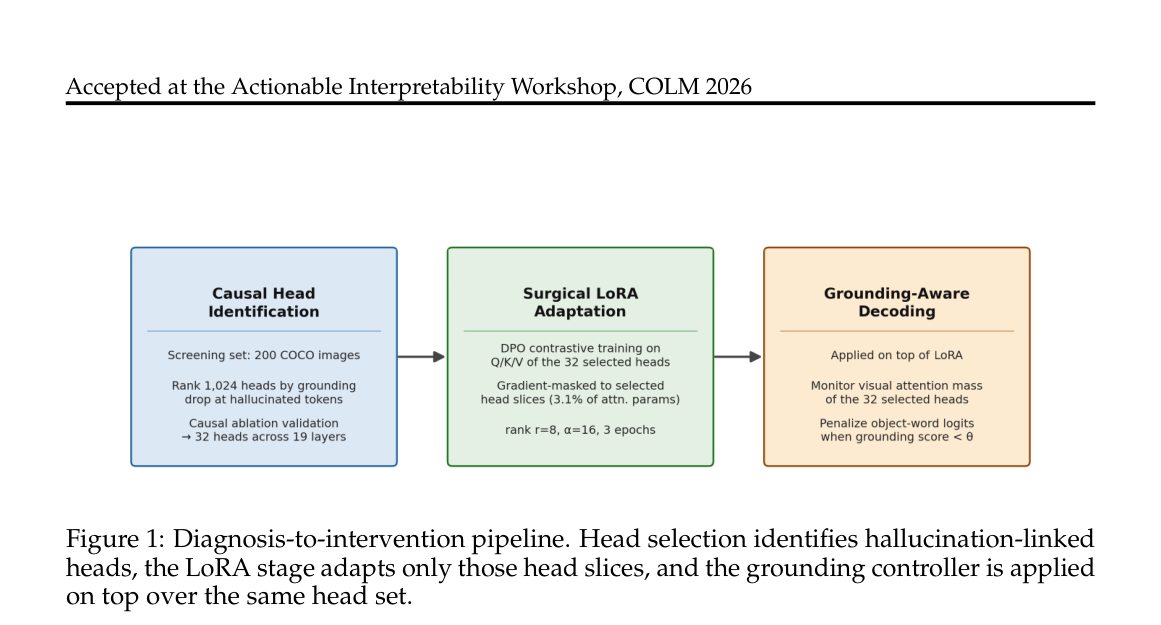
该图展示 diagnose-to-intervention 流水线的整体结构:头筛选、头切片 LoRA 和 grounding 控制器三个阶段如何共享同一头集。观察重点是头选择信号如何同时决定训练位置和推理干预时机。
头选择是关键
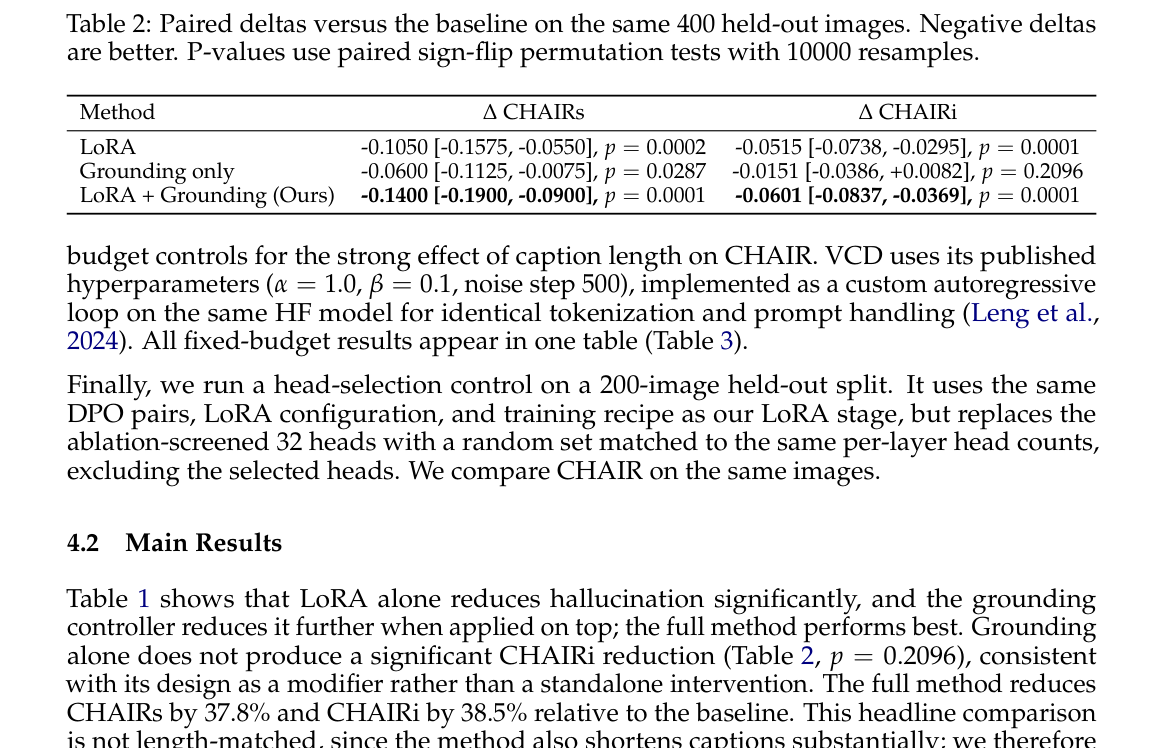
配对差值表展示各条件相对 baseline 的 ΔCHAIRs 和 ΔCHAIRi,含 p 值。应关注 Grounding only 的 p=0.2096,说明其单独使用不显著。
结论与局限
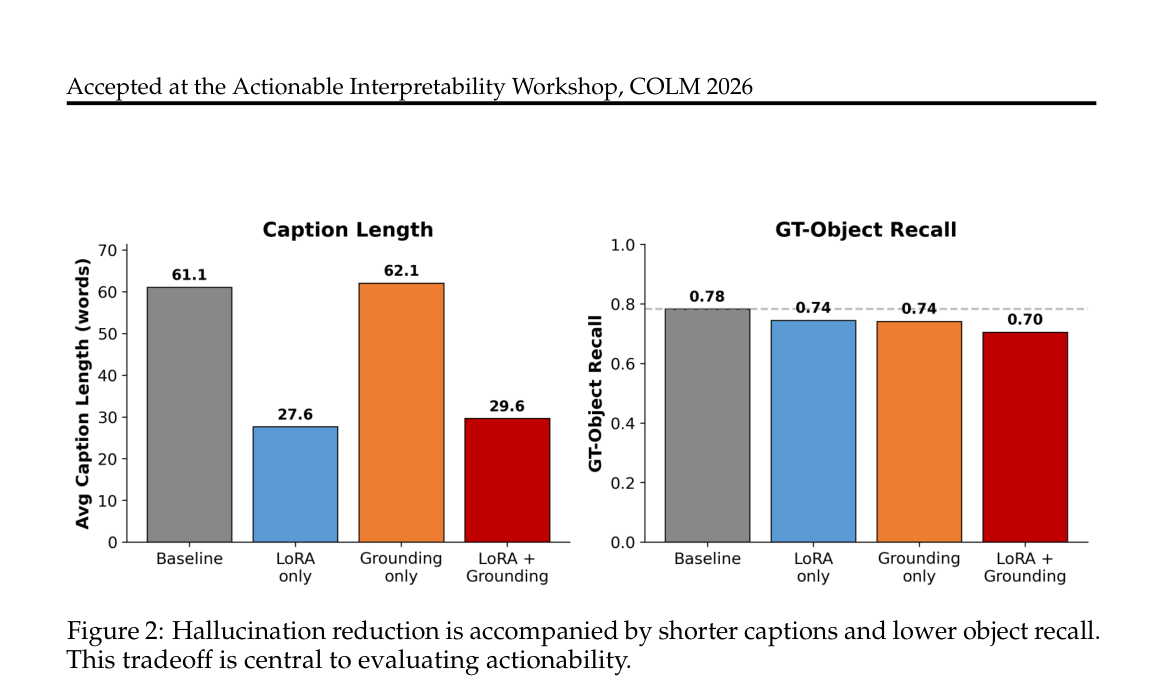
该图展示幻觉下降伴随 caption 长度缩短和 object recall 下降的权衡。应关注这一精度-覆盖权衡对方法可操作性的影响。
实验如何设计?
- 主实验:400张 held-out COCO val2014 图像,四个条件(Baseline、LoRA、Grounding only、LoRA+Grounding),报告 bootstrap 95% CI 和配对 sign-flip 检验。
- 随机头对照:200张 held-out 控制集,layer-matched random-head LoRA 与 selected-head adapter 对比。
- 固定预算比较:64/80/128 tokens 下与 SPIN、VCD 及 baseline 对比。
- 敏感性检查:LoRA 尺度扫描、阈值 θ∈{0.04,…,0.12}、top-16 vs top-32 头。
- 定性示例:held-out 厨房图像上四种方法的幻觉与保留物体对比。
关键结果与论文证据
- LoRA + Grounding 将 CHAIRs 从 0.370 降至 0.230,CHAIRi 从 0.156 降至 0.096(p<0.001),相对降低约38%(第5页)。
- Grounding only 的 ΔCHAIRi = -0.0151,p=0.2096,不显著,说明其应视为 LoRA 之上的修饰器(第5页)。
- 随机头 LoRA 对照 CHAIRs=0.400,与 baseline 无差别;selected-head adapter CHAIRs=0.100,证明头选择是关键(第5页)。
- 平均 caption 长度从 61.1 降至 29.6 words,object recall 从 0.78 降至 0.70,幻觉下降伴随生成更短更保守(第5页)。
- 固定预算下,64 tokens 时 CHAIRs 从 0.280 降至 0.215(相对降低23.2%);128 tokens 时 baseline 升至 0.5125,Ours 保持 0.2150(相对降低58%)(第6-7页)。
- SPIN 在 64/80 tokens 下 CHAIRs 数值上差于 baseline;VCD 在三个预算下 CHAIRi 均升高(第7页)。
- 阈值 θ∈{0.04,…,0.12} 时 CHAIRs 稳定在 0.24–0.26;top-16 vs top-32 头 CHAIRs 均为 0.24(第6页)。
阅读时需要注意
- 仅研究 LLaVA-1.5-7B 一个模型家族、单一 prompt 和 COCO 风格标注。
- CHAIR 依赖标注覆盖和同义词匹配,有效但未标注的物体会被误判为幻觉。
- 注意力权重不保证是忠实解释,grounding score 只是轻量代理。
- 缺少完全长度匹配的对照、all-head LoRA 基线和 plain DPO 基线。
- 缺少人类评估来衡量流畅性、信息量和忠实度。
关联工作
- Jiang et al. 2025 用注意力透镜将幻觉定位到 LLaVA 中间层,发现 grounded token 比 hallucinated token 获得更高视觉注意力。
- Yang et al. 2025 用因果中介分析识别中深层过度关注文本的 hallucination heads,并用解码调整和头级微调缓解,与本文最接近。
- VCD(Leng et al. 2024)对比真实与噪声图像下的输出分布抑制语言先验 token,作为训练自由解码基线。
- SPIN(Sarkar et al. 2025)推理时动态抑制低图像注意力头,是最接近的解码基线,但本文用固定消融筛选头集并训练头限制 adapter。