看见不够:视觉语言模型感知到证据却没有按证据做决定
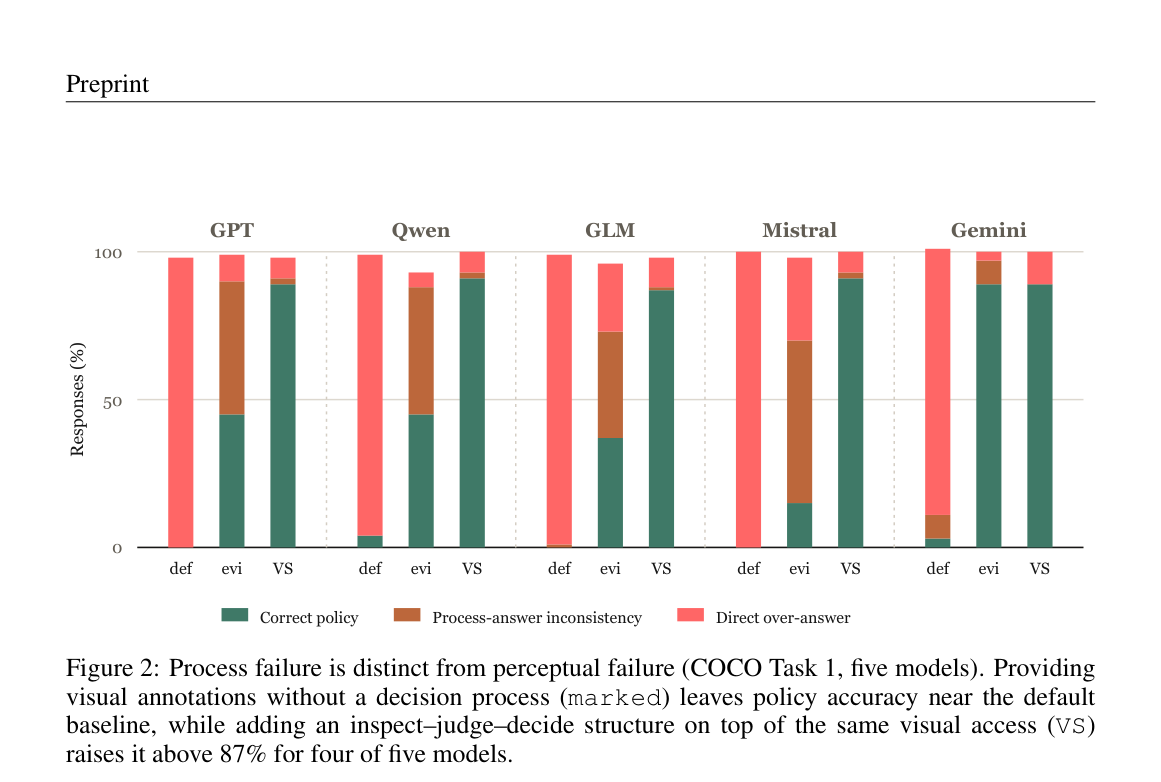
佛罗里达州立大学与 JAIST 的工作区分感知失败和过程失败:模型可以正确列出证据仍给出与证据矛盾的答案;SRT 用状态抽取、相关性核验和目标承诺约束决策,而增益取决于过程先验是否对齐图像当前的阶段边界。
佛罗里达州立大学与 JAIST 的工作区分感知失败和过程失败:模型可以正确列出证据仍给出与证据矛盾的答案;SRT 用状态抽取、相关性核验和目标承诺约束决策,而增益取决于过程先验是否对齐图像当前的阶段边界。
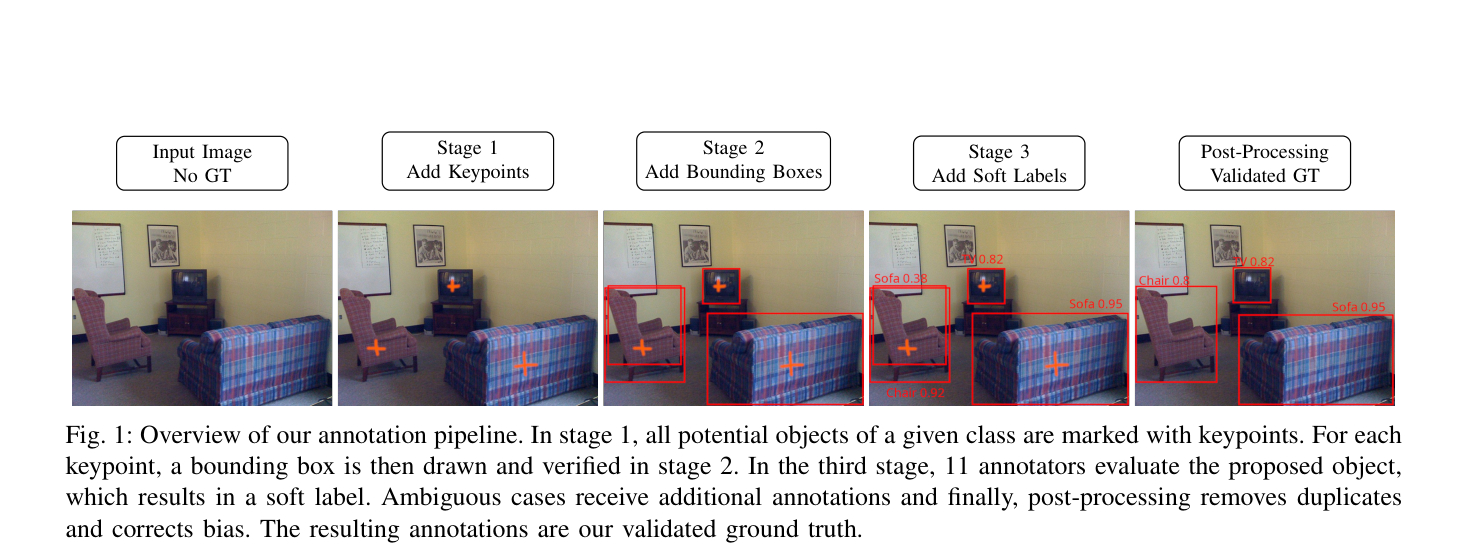
Osnabrück、Wuppertal 与 Wayve 用高召回众包流水线重标 COCO、Pascal VOC、Cityscapes 与 KITTI,用至少 11 名标注者的软标签揭示漏标主导的标签错误,并给出面向软标签的检测评测与真实漏标检测基准。
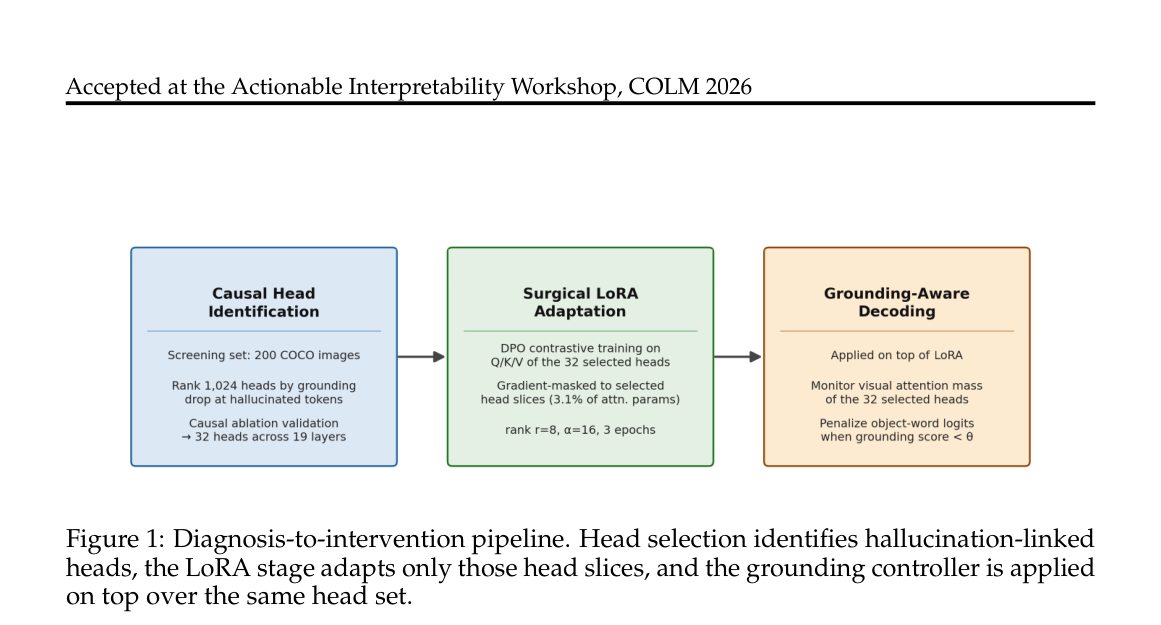
通过诊断筛选出与物体幻觉相关的32个注意力头,仅对这些头做 LoRA 适配并叠加推理时 grounding 控制器,在 COCO 上显著降低 CHAIRs/CHAIRi,同时使生成更短更保守。