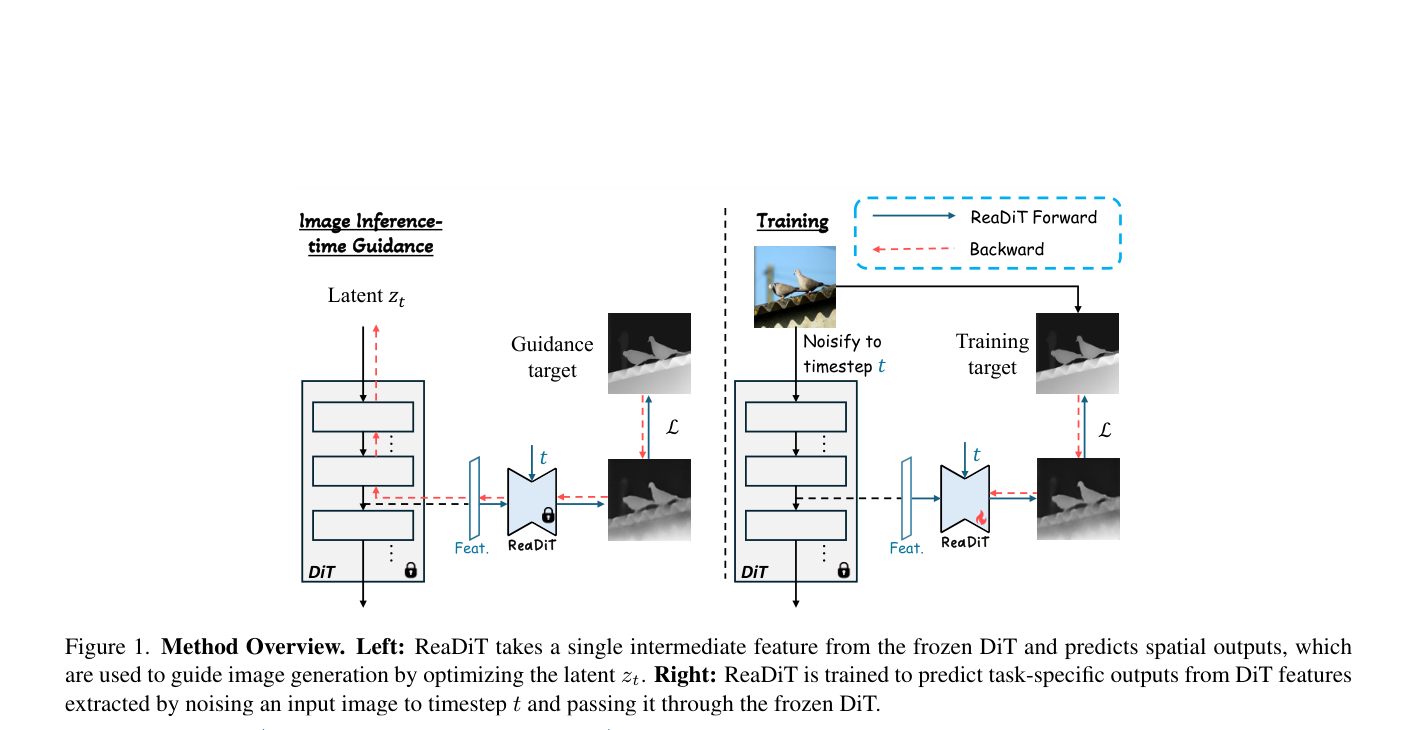
快速导读:本文提出了 ReaDiT,一种轻量级框架,通过提取冻结 DiT 模型中单个 Transformer 块的特征来预测空间目标(如深度、姿态、边缘)或光流,并在推理时通过优化潜变量引导图像和视频生成,无需修改基础模型即可实现统一的空间与运动控制。
ReaDiT 提出了一种基于扩散 Transformer(DiT)特征的轻量级控制框架。它通过提取冻结 DiT 模型中单个 Transformer 块的特征,预测深度、姿态、边缘或光流等空间与运动信号,并在推理时通过优化潜变量引导生成过程。该方法无需修改基础模型,即可实现图像和视频的统一细粒度控制。
与 ControlNet 等适配器方法不同,ReaDiT 不引入大量额外参数,也不依赖大量配对训练数据。它利用 DiT 特征在不同块间高度冗余的特性,仅用单块特征即可实现有效预测,显著降低了计算与存储开销。
英文题目:ReaDiT Guidance: Control for Image and Video Generation using Diffusion Transformer Features
论文出处:arXiv 每日论文精选 · arXiv:2609.04649
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有扩散模型控制方法面临两大挑战:一是 ControlNet 等适配器方法需要大量配对数据并引入大量参数,难以无缝扩展到视频生成;二是基于 U-Net 特征的控制方法(如 RG)不适用于 DiT 架构,因为 DiT 的特征空间与 U-Net 存在根本差异。
U-Net 特征在不同层间差异较大,需要多层融合;而 DiT 特征在不同块间高度冗余,这为利用单块特征提供了理论基础。然而,如何从 DiT 单块特征中有效提取空间与运动信息,并用于引导生成,仍是开放问题。
ReaDiT 旨在解决这一研究空白,通过设计专门的时间条件化读出架构,从 DiT 单块特征中预测任务特定输出,并在推理时通过潜变量优化实现控制。
核心创新
- 提出 ReaDiT 框架,证明 DiT 单个 Transformer 块的特征足以预测空间属性,无需像 U-Net 方法那样使用多层特征。
- 设计了时间条件化的多分辨率读出架构,有效处理 DiT 特征的时间步依赖性。
- 实现了统一的图像和视频控制框架,支持空间控制(深度、姿态、边缘)和运动控制(光流),无需修改基础模型。
- 展示了 ReaDiT 与适配器方法(如 ControlNet)的互补性,结合使用可进一步提升性能。
方法概览
ReaDiT 包含一个轻量级的读出模块(Readout Module),该模块从冻结 DiT 的单个块中提取特征,通过 AdaLN 进行时间步调制,利用多分辨率分支和融合块生成空间预测。训练时,使用日志采样策略平衡不同噪声水平的时间步,以任务特定损失优化预测。推理时,通过梯度下降优化潜变量 $z_t$,使预测结果匹配目标空间图或光流,从而引导生成过程。该方法可统一应用于图像的空间控制(深度、姿态、边缘)和视频的空间及运动控制。
- ReaDiT 包含一个轻量级读出模块,从冻结 DiT 的单个块中提取特征,通过 AdaLN 进行时间步调制,利用多分辨率分支和融合块生成空间预测。
- 训练时,使用日志采样策略平衡不同噪声水平的时间步,以任务特定损失优化预测,确保模型在不同噪声水平下均能准确预测空间属性。
- 推理时,通过梯度下降优化潜变量 z_t,使预测结果匹配目标空间图或光流,从而引导生成过程,无需修改基础模型的前向传播。
- 该方法可统一应用于图像的空间控制(深度、姿态、边缘)和视频的空间及运动控制,支持单任务或多任务联合引导。
- 对于不一致的双引导(如深度和姿态来自不同图像),ReaDiT 引入掩码机制解耦信号,避免冲突,生成连贯高质量图像。
- ReaDiT 与适配器方法(如 ControlNet)具有互补性,结合使用可进一步提升性能,提供灵活的控制组合策略。
逐图理解论文
直觉与失败案例
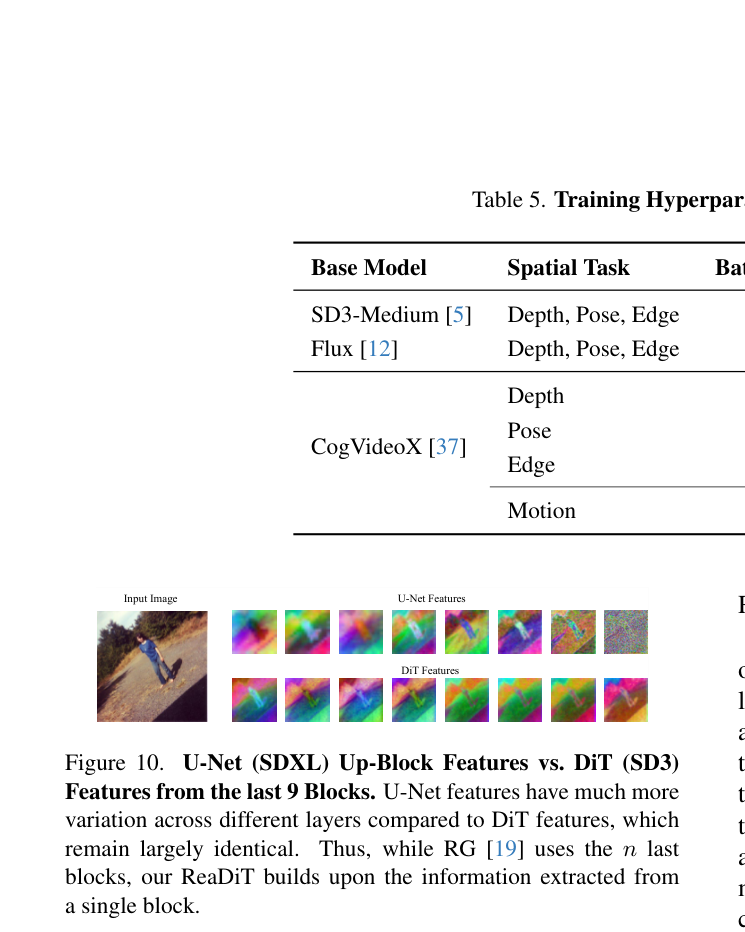
该图通过 PCA 可视化对比了 U-Net 和 DiT 特征。U-Net 特征在不同层间差异显著,而 DiT 特征在不同块间高度相似。重点观察 DiT 特征的冗余性,这解释了为何单块特征即可用于预测,以及为何 RG 需要多层而 ReaDiT 不需要。
研究空白
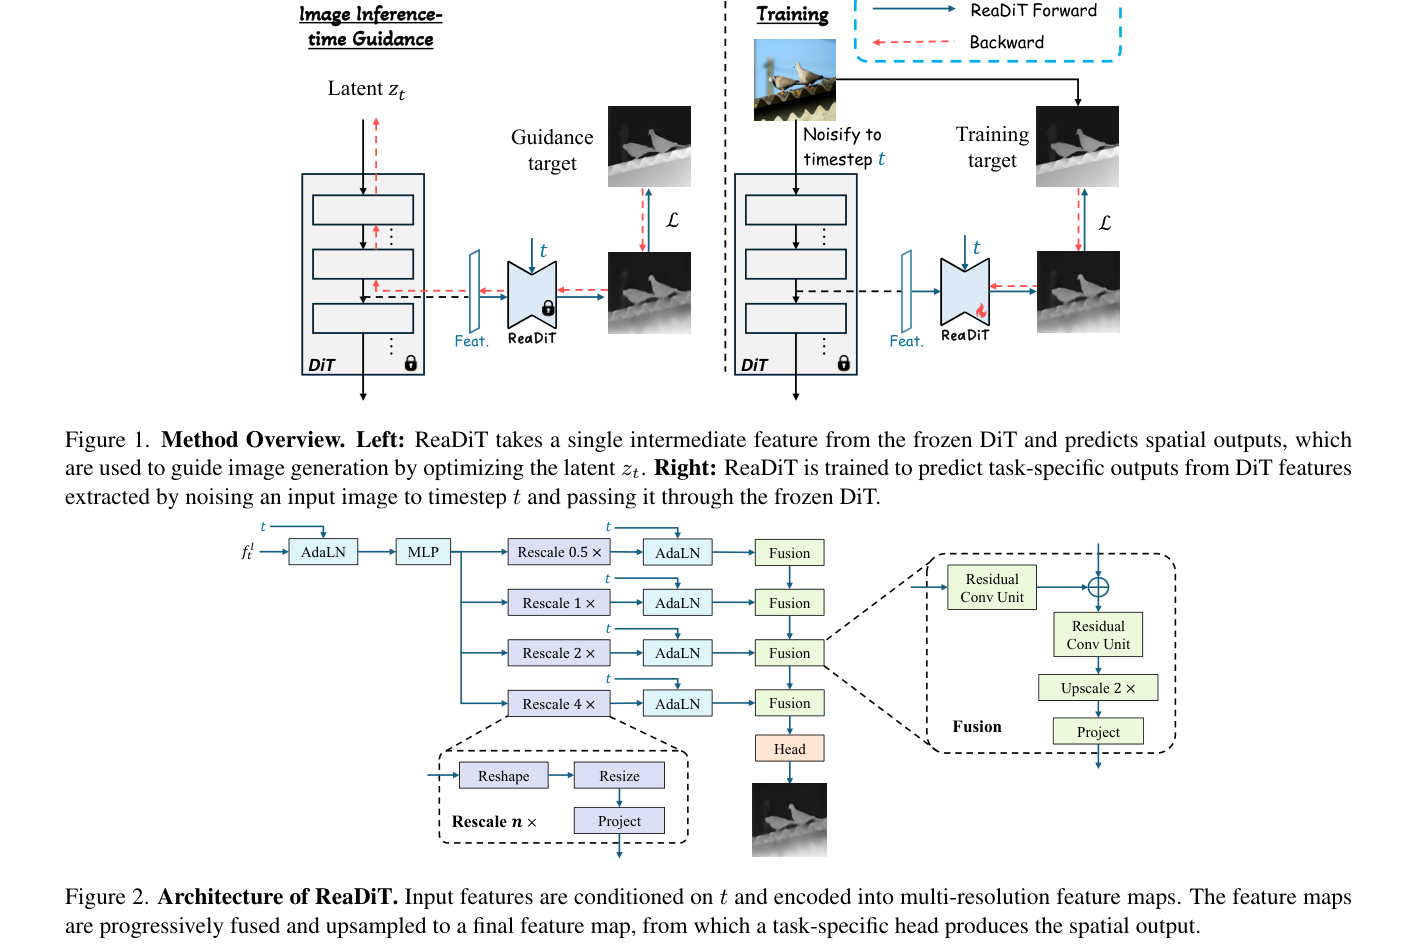
该图详细展示了 ReaDiT 的读出架构。输入特征通过 AdaLN 进行时间步调制,然后进入多分辨率分支和融合块,最终生成任务特定输出。重点观察多分辨率分支如何逐步上采样并融合特征,以及任务特定头如何产生最终预测。
最强结论
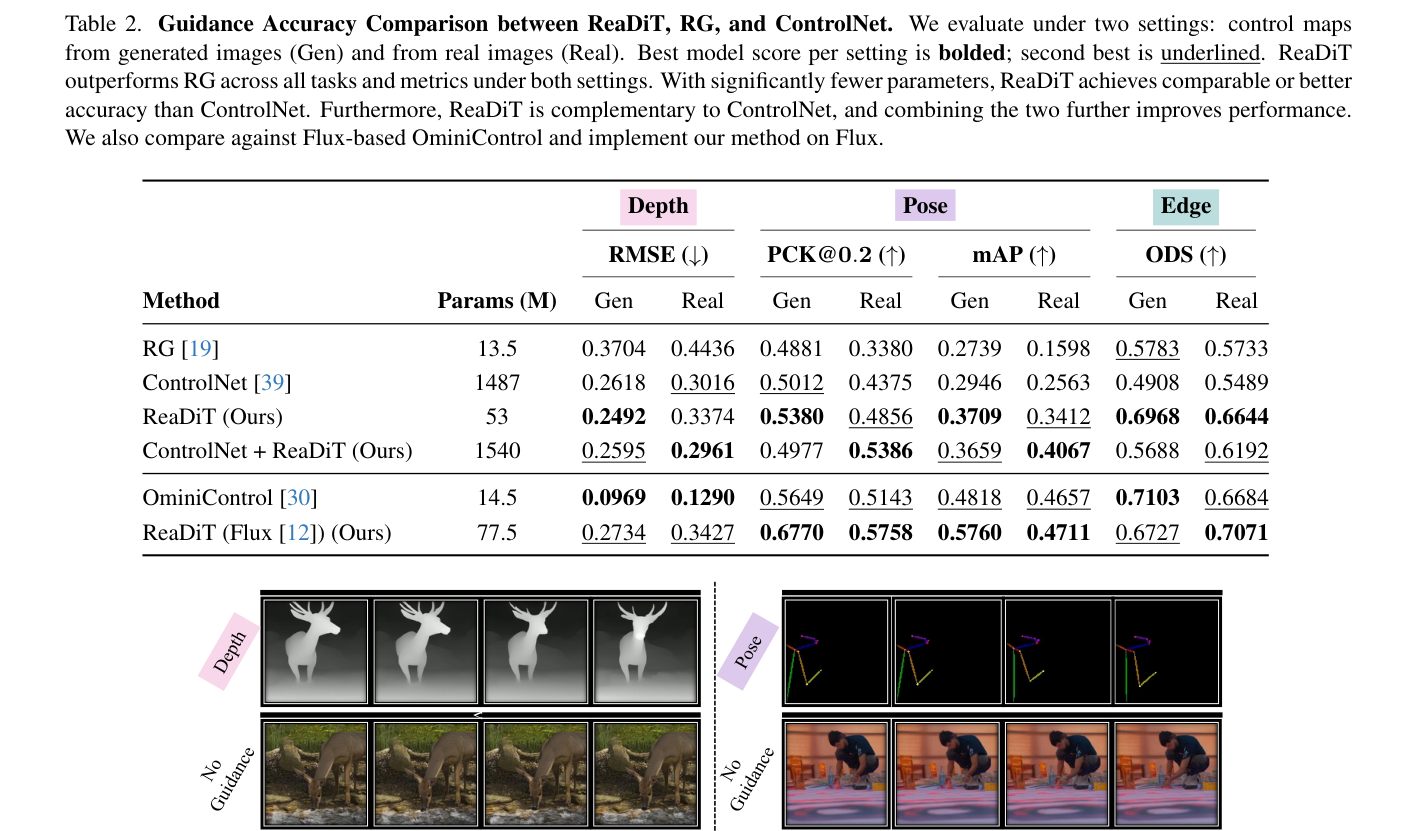
该表比较了 ReaDiT、RG 和 ControlNet 在图像空间引导中的性能。ReaDiT 在所有任务和指标上优于 RG,且在多数指标上优于 ControlNet,同时参数更少。重点观察 ReaDiT 与 ControlNet 的互补性,以及结合使用后的性能提升。
意义与局限
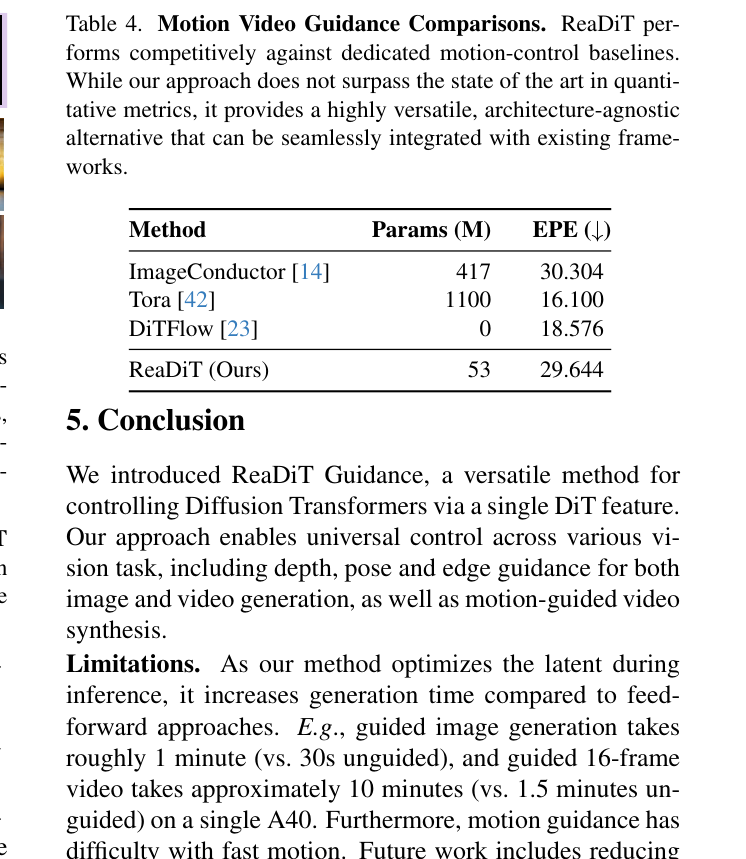
该表比较了 ReaDiT 与专门运动控制方法在视频运动引导中的性能。ReaDiT 与 ImageConductor 相当,但略逊于 Tora 和 DiTFlow。重点观察 ReaDiT 的通用性优势,以及其在快速运动场景下的局限性,理解其作为架构无关方案的定位。
实验如何设计?
- 在 SD3-Medium 和 FLUX.1-dev 上进行图像生成实验,在 CogVideoX 上进行视频生成实验,覆盖主流 DiT 架构。
- 使用 PascalVOC 数据集训练空间任务,使用 DAVIS 数据集训练光流任务,确保训练数据的多样性和代表性。
- 与 RG、ControlNet、OminiControl、Tora、DiTFlow 等基线方法进行定量和定性比较,全面评估 ReaDiT 的性能。
- 分析了不同 DiT 块特征用于深度预测的 RMSE,验证了单块特征的有效性和优越性。
- 评估了双引导(深度+姿态)在一致和不一致控制图下的表现,测试了方法的鲁棒性和灵活性。
关键结果与论文证据
- ReaDiT 在图像空间引导中全面优于 RG,且在多数指标上优于 ControlNet,同时参数数量显著更少(第7页 Table 2)。
- 在视频空间引导中,ReaDiT 优于 RG,证明其可扩展到视频生成(第9页 Table 3)。
- 在运动视频引导中,ReaDiT 与 ImageConductor 相当,但略逊于 Tora 和 DiTFlow,表明其在快速运动场景下仍有提升空间(第9页 Table 4)。
- DiT 块特征间的线性映射平均 R2 分数为 0.7,证实了块间特征的高度冗余性,支持单块特征的有效性(第12页 Figure 10)。
- 单块特征用于深度预测的 RMSE 一致优于使用最后10块特征,进一步验证了单块策略的优越性(第14页 Figure 11)。
- ReaDiT 与 ControlNet 结合使用可进一步提升性能,证明其互补性(第7页 Table 2)。
- 在不一致双引导下,ReaDiT 仍能生成连贯高质量图像,展示其鲁棒性(第9页 Figure 9)。
- ReaDiT 在复杂空间图下比 RG 更忠实地遵循目标,且无明显伪影(第6页 Figure 5, 第14页 Figure 14)。
阅读时需要注意
- 推理时优化潜变量导致生成时间显著增加,图像约1分钟 vs 30秒,视频约10分钟 vs 1.5分钟。
- 在快速运动场景下,运动引导效果较差,缺乏时间上采样能力以捕捉快速动态。
- 需要针对每个任务单独训练读出模块,尽管架构相同,增加了部署复杂度。
- 方法依赖于基础 DiT 模型的特征质量,若基础模型在特定领域表现不佳,ReaDiT 的控制效果也会受限。
关联工作
- ControlNet 是主流适配器方法,参数多,需大量数据,ReaDiT 参数更少且可与其结合。
- Readout Guidance (RG) 是前驱工作,基于 U-Net 特征,ReaDiT 将其扩展到 DiT 并改进了架构和训练策略。
- OminiControl 是基于 DiT 的轻量级控制方法,ReaDiT 在 FLUX 上与其比较,性能相当或更好。
- Tora 和 DiTFlow 是视频运动控制基线,ReaDiT 在运动引导定量指标上略逊于它们,但提供了更通用的架构无关方案。