GP-Refiner:用高斯过程校正扩散Transformer特征缓存的累积误差
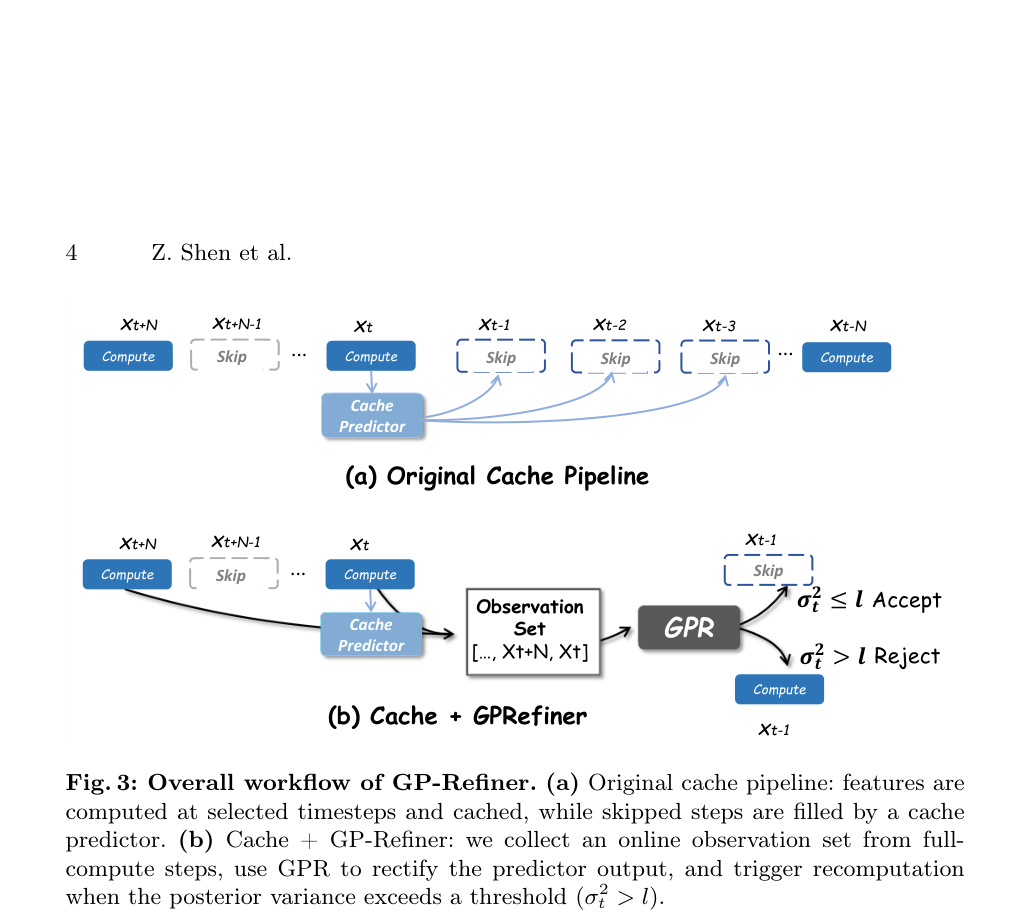
本文提出GP-Refiner,利用高斯过程回归(GPR)校正扩散模型特征缓存中的累积误差,并通过后验方差实现自适应重计算,在保持生成质量的同时显著提升推理速度。
本文提出GP-Refiner,利用高斯过程回归(GPR)校正扩散模型特征缓存中的累积误差,并通过后验方差实现自适应重计算,在保持生成质量的同时显著提升推理速度。
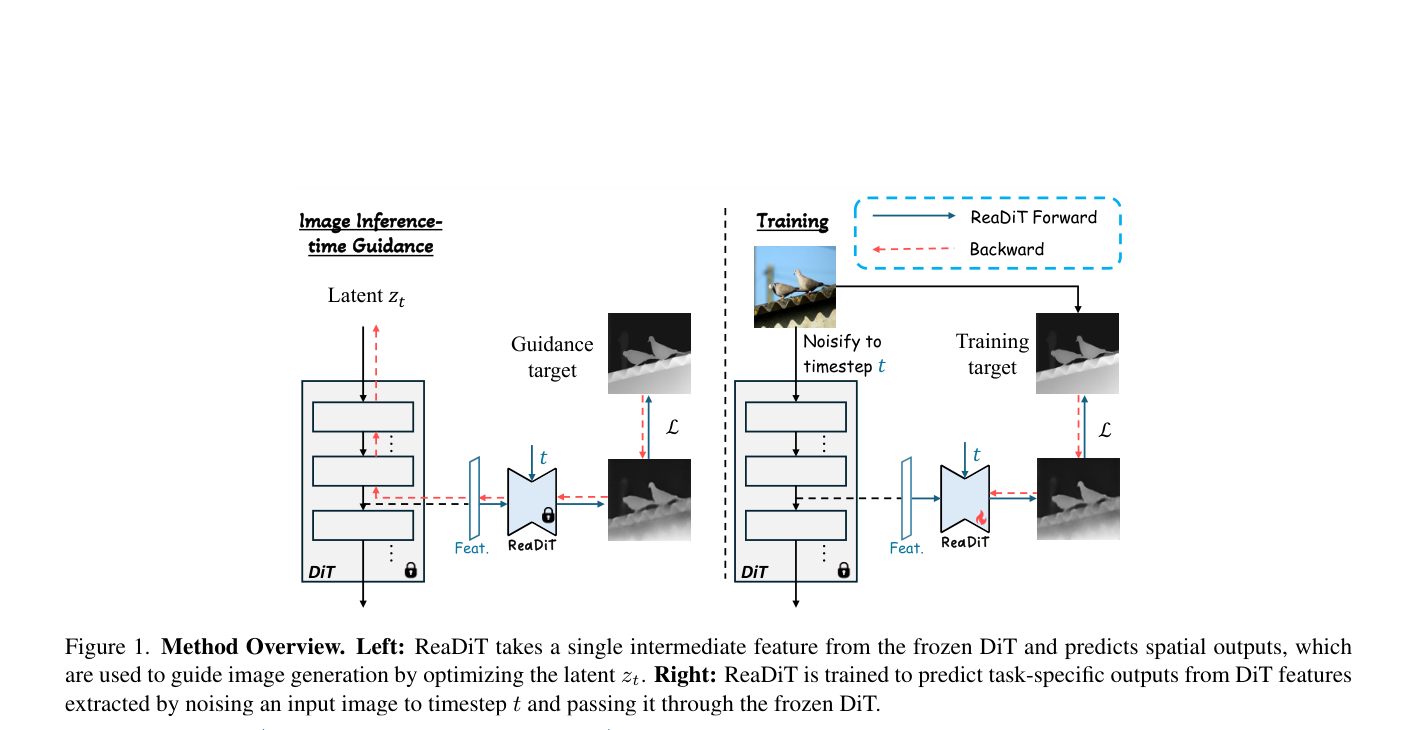
本文提出了 ReaDiT,一种轻量级框架,通过提取冻结 DiT 模型中单个 Transformer 块的特征来预测空间目标(如深度、姿态、边缘)或光流,并在推理时通过优化潜变量引导图像和视频生成,无需修改基础模型即可实现统一的空间与运动控制。
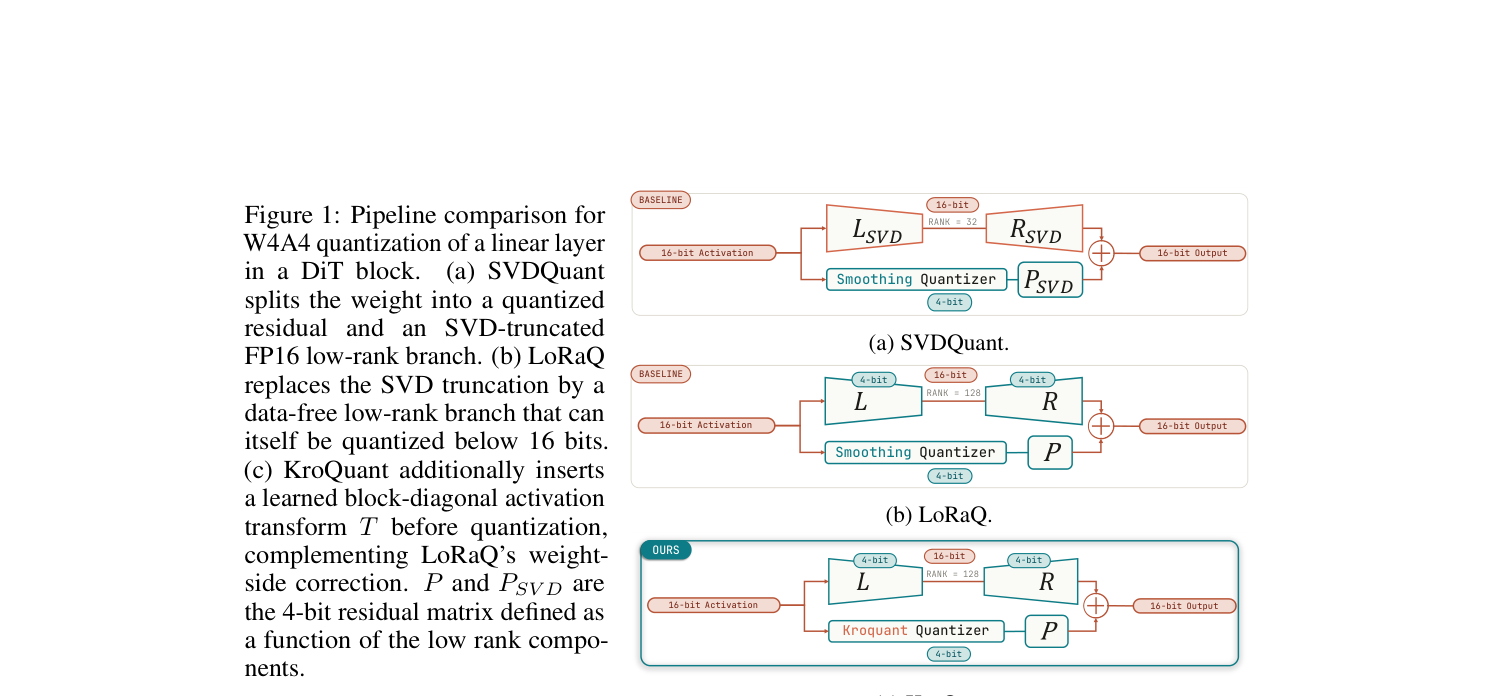
DiT模型的W4A4 PTQ因激活Outliers导致质量下降,且AdaLN层使传统离线吸收技巧失效。KroQuant提出一种基于Kronecker积的可学习块对角激活变换,结合LoRaQ权重校正,在保持推理速度的同时显著提升图像质量。实验表明,该方法在PixArt-Σ、SANA和FLUX.1-schnell上均优于基线。需注意,该方法依赖支持MXFP4格式的硬件,且在线变换增加了计算开销。
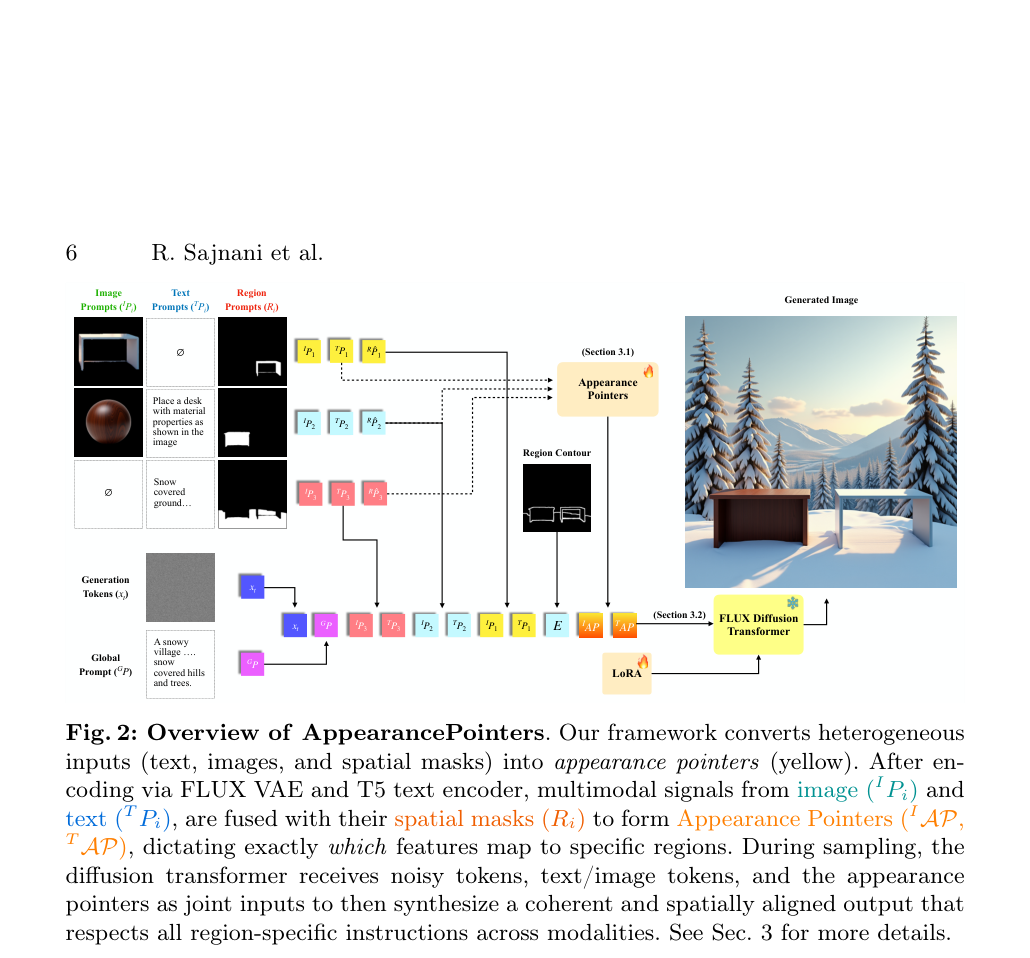
本文介绍AppearancePointers,一种用于扩散变换器(DiT)的多模态区域控制方法。通过生成紧凑的指针令牌,该方法在单次去噪步骤中实现文本、图像和空间掩码的精确对齐。实验显示其在CLIP-I、DINO-I和MIoU指标上优于MS-Diffusion和InsertAnything等基线。需注意,区域数量过多时性能会下降。
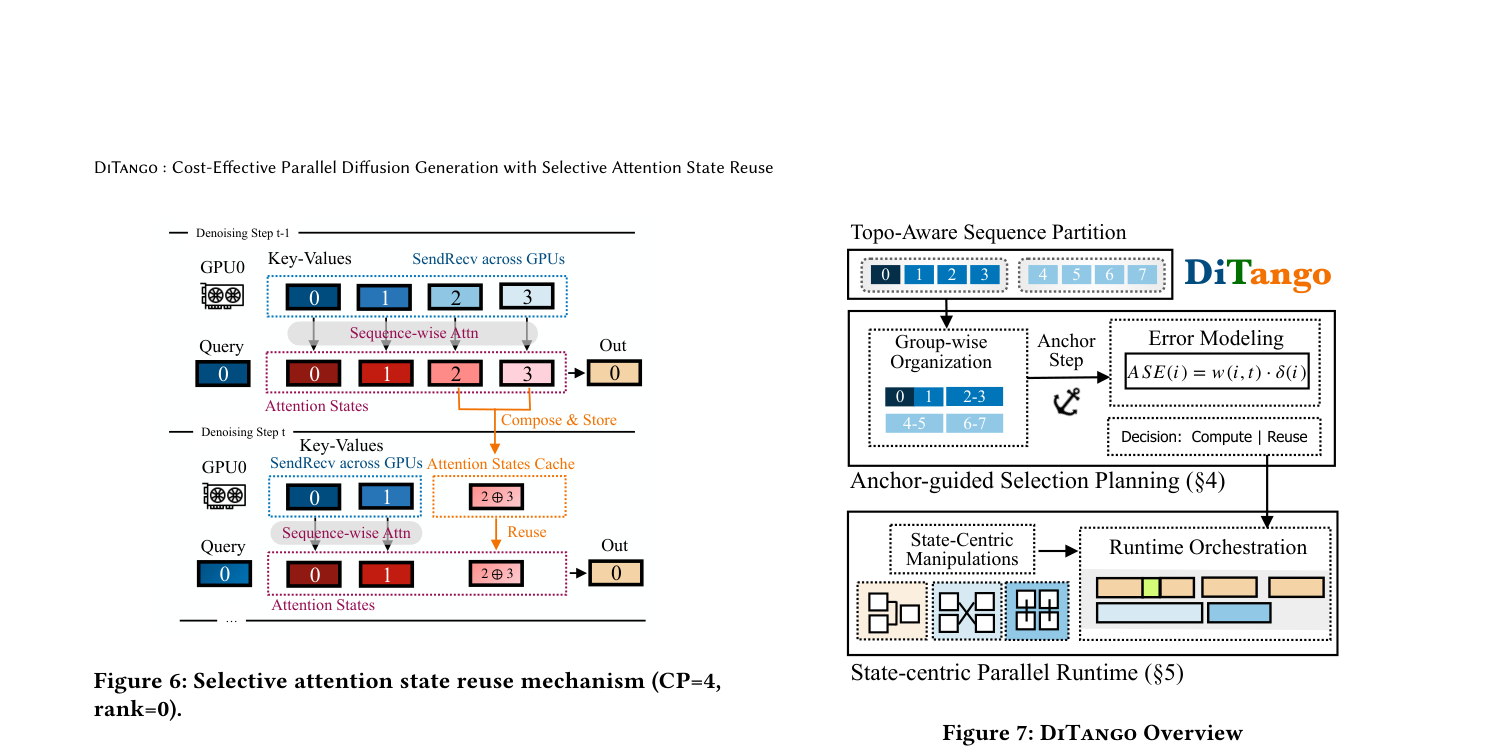
本文介绍DiTango,一种针对分布式DiT推理的低成本并行生成方法。针对现有Context Parallelism在多节点扩展时的通信瓶颈,DiTango利用注意力贡献的空间局部性,提出基于Attention State的可组合复用机制。通过Anchor-guided Selection Planner预测复用误差,结合State-centric Parallel Runtime优化通信与计算重叠。实验显示,在32 GPU上,Wan-14B模型获得1.9倍端到端加速,同时保持高质量生成。