快速导读:本文提出 FailSAE,一种基于稀疏自编码器(SAE)的三阶段故障感知训练框架,通过解耦 VLM 内部表示为稀疏概念方向,实现了比现有基线更准确且具备概念级可解释性的故障预测。
视觉-语言模型(VLM)在医疗、自动驾驶等高风险领域的应用日益广泛,但其故障预测机制往往缺乏可解释性。现有方法如基于置信度或辅助分类器的预测器,虽然能识别潜在错误,却无法揭示模型内部表示在故障发生时的具体变化机制。FailSAE 提出了一种基于稀疏自编码器(SAE)的故障预测框架,将 VLM 的内部表示解耦为稀疏且可解释的概念方向,从而实现了比现有基线更准确且具备概念级可解释性的故障预测。
该框架的核心在于将故障预测建模为对 SAE 潜在激活值的分类任务。通过三阶段训练流程,FailSAE 不仅提高了预测精度,还确保了 SAE 潜在方向保持人类可解释性。实验表明,故障发生时,类特定概念的激活被抑制,而模糊或风格相关概念的激活增加,这一发现为理解 VLM 的故障机制提供了新的视角。
英文题目:FailSAE: Towards Interpretable Failure Prediction for Vision-Language Models via Sparse Autoencoders
论文出处:arXiv 每日论文精选 · arXiv:2609.04276
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VLM 的故障预测对于风险感知部署至关重要,但现有方法存在显著局限。基于置信度或不确定性的方法(如 SSL)虽然简单有效,但无法提供概念级的解释。基于人类定义概念集的方法(如 ORCA-B)需要手动定义概念,泛化性受限。基于学习的故障预测器(如 SuperMentor)虽然性能较好,但本质上仍是黑盒模型,无法揭示内部表示的变化机制。
SAE 已被证明能将高维隐藏表示分解为稀疏且解耦的潜在方向,通常对应人类可解释的概念。然而,现有工作多停留在可视化分析,未将其转化为主动的故障预测机制。FailSAE 填补了这一研究空白,首次将 SAE 用于 VLM 故障预测,并通过故障感知训练使 SAE 潜在方向更具判别力且保持可解释性。
此外,VLM 的故障模式复杂多样,包括细粒度分类错误、模糊概念混淆等。现有方法难以区分这些不同的故障类型,而 FailSAE 通过细粒度四分类任务,能够更精确地识别故障类型,为后续的故障恢复策略提供基础。
核心创新
- 首次研究使用 SAE 进行 VLM 故障预测
- 提出三阶段故障感知训练流水线,使 SAE 潜在方向更具判别力且保持可解释性
- 揭示故障与概念激活变化的关联:故障时类特定概念抑制,模糊/风格相关概念激活增加
- 探索基于 SAE 潜在干预和图像掩码的运行时故障恢复策略
方法概览
将故障预测建模为对 SAE 潜在激活值的分类任务。采用三阶段训练:1) 预训练 SAE 以重建 token 嵌入并鼓励稀疏性;2) 冻结 SAE,训练故障预测头;3) 联合微调 SAE 和预测头,使用故障感知目标函数。在推理时,对平均后的 SAE 潜在激活进行 Top-K masking,保留最具判别力的 K 个方向输入预测头。
- 三阶段训练流程:1) 预训练 SAE 以重建 token 嵌入并鼓励稀疏性;2) 冻结 SAE,训练故障预测头;3) 联合微调 SAE 和预测头,使用故障感知目标函数。
- SAE 架构:采用标准 SAE 结构,将 CLIP 视觉编码器的 token 嵌入编码为稀疏潜在激活。SAE 的潜在维度设置为 16384,稀疏度通过 L1 正则化控制。
- 故障预测头:基于平均后的 SAE 潜在激活,使用多层感知机(MLP)进行分类。预测头输出细粒度四分类(正确、细粒度错误、模糊错误、其他错误)和二分类(正确、错误)结果。
- Top-K Masking:在推理时,对平均后的 SAE 潜在激活进行 Top-K masking,保留最具判别力的 K 个方向输入预测头。K 值通过验证集调优,最优 K=300 时性能最佳。
- 故障感知目标函数:在第三阶段联合微调时,使用故障感知目标函数,鼓励 SAE 潜在方向在故障样本上表现出更强的判别性。该目标函数结合了重建损失和分类损失,通过权重平衡两者。
- 概念级可解释性:通过 SAE 的解码器矩阵,将潜在方向映射回输入空间,生成参考图像。这些参考图像用于验证潜在方向的概念可解释性,确保 SAE 潜在方向对应人类可理解的概念。
- 运行时故障恢复:基于 SAE 潜在方向的概念可解释性,提出两种故障恢复策略:1) 定位并移除空间腐蚀区域;2) 通过 SAE 潜在干预纠正误分类。这些策略利用 SAE 潜在方向的概念信息,实现更精准的故障恢复。
逐图理解论文
研究空白
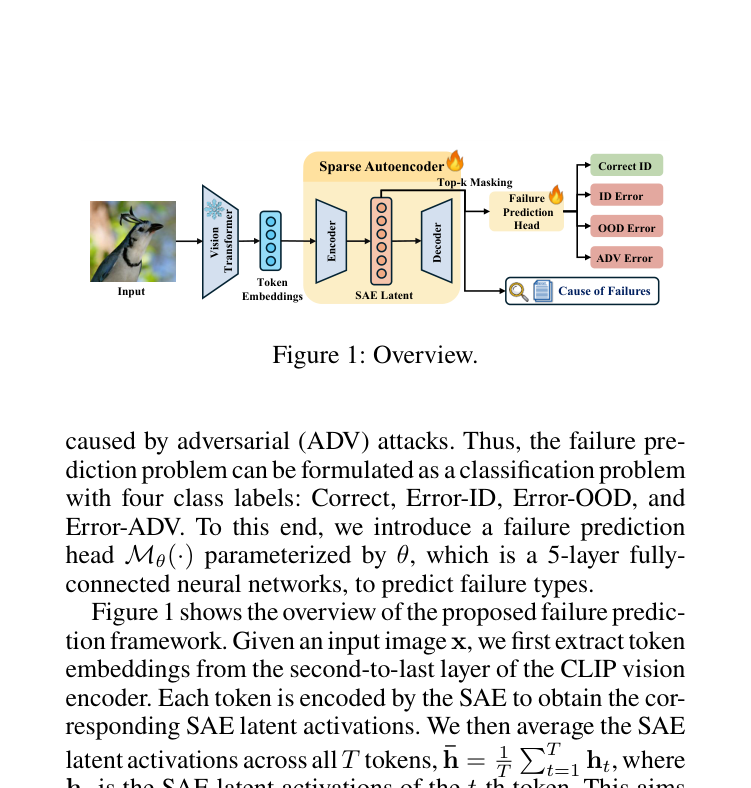
SAE 已被证明能将高维隐藏表示分解为稀疏且解耦的潜在方向,通常对应人类可解释的概念。但现有工作多停留在可视化分析,未将其转化为主动的故障预测机制。FailSAE 填补了这一研究空白,首次将 SAE 用于 VLM 故障预测。
核心贡献
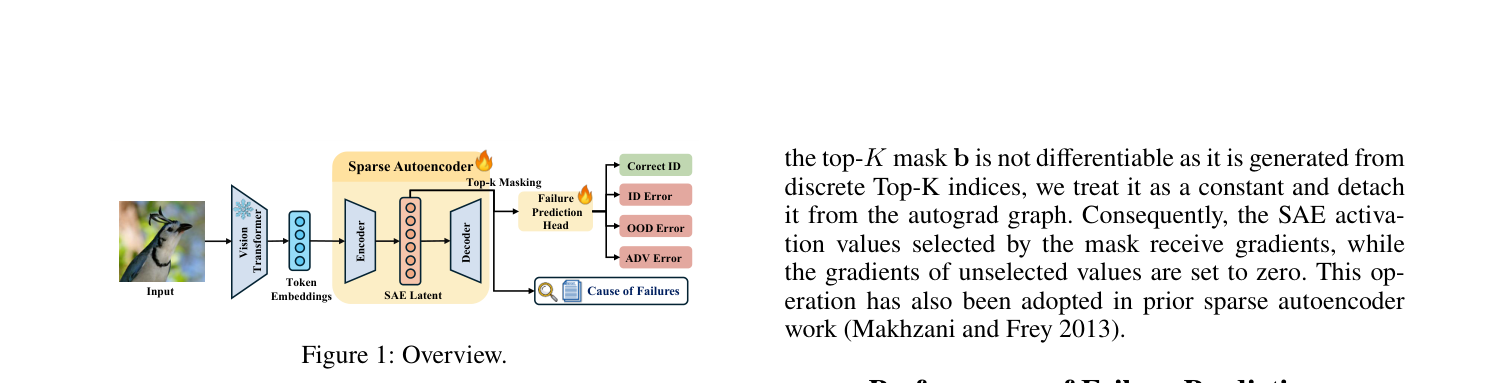
该图展示了 FailSAE 的整体框架。输入图像 x 经过 CLIP 视觉编码器提取 token 嵌入,每个 token 通过 SAE 编码为潜在激活。平均后的 SAE 潜在激活经过 Top-K masking 后输入故障预测头,输出故障预测结果。该图清晰展示了 FailSAE 的数据流和核心组件,是理解整个框架的关键。
关键发现
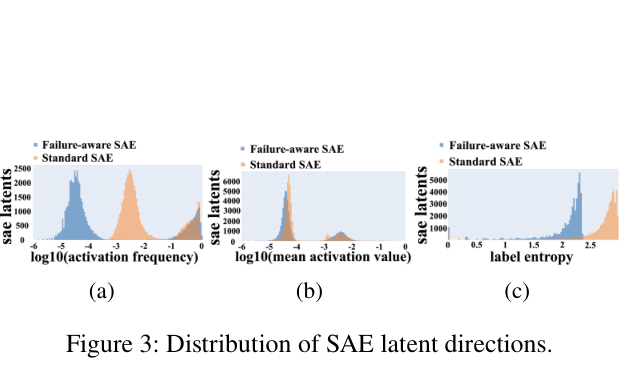
该图展示了 SAE 潜在方向的分布。通过比较正确预测与故障预测中 Top 激活潜在方向的分布,揭示了故障与概念激活变化的关联。该图是理解 FailSAE 可解释性的重要视觉证据。
价值与局限
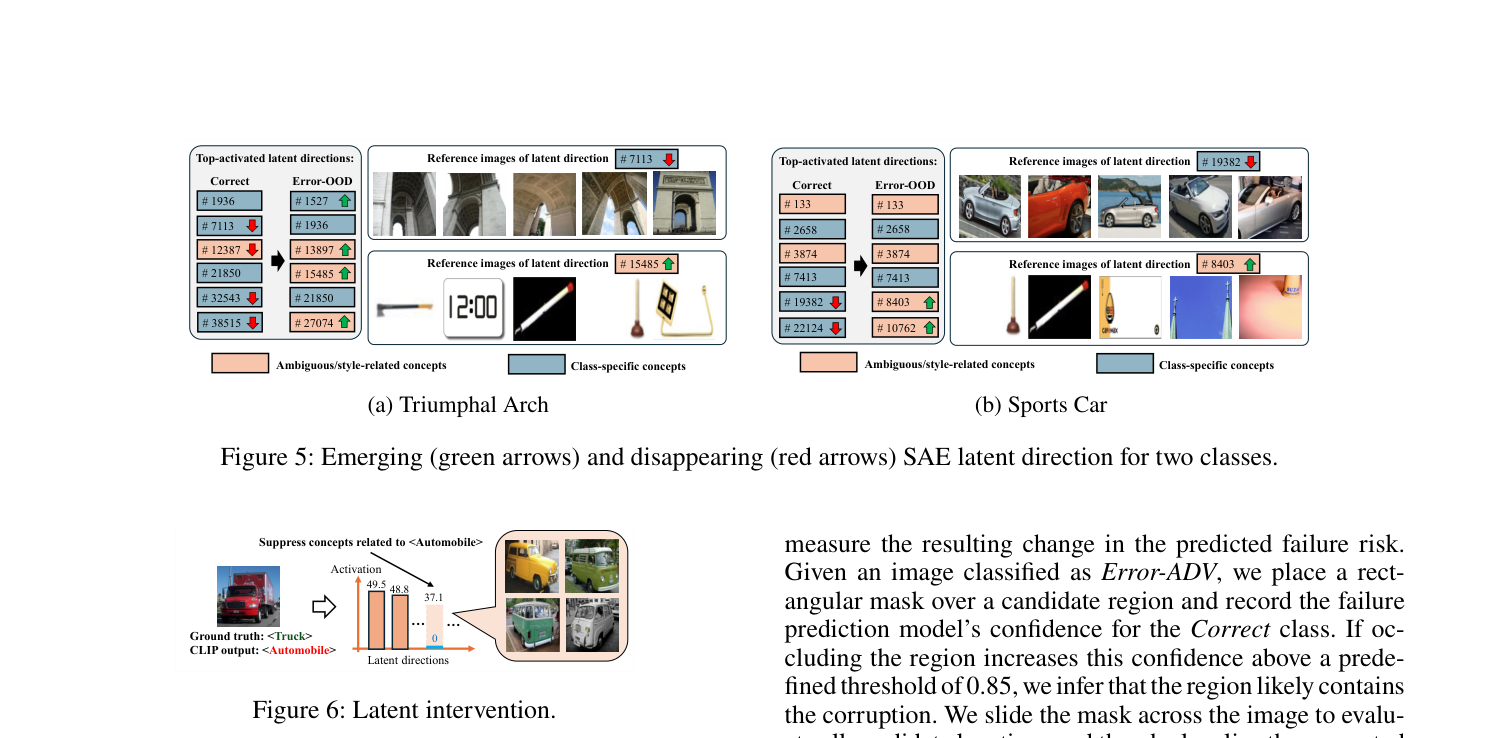
该图展示了基于 SAE 潜在干预的故障恢复策略。通过定位并移除空间腐蚀区域,或通过 SAE 潜在干预纠正误分类,实现运行时故障恢复。该图是理解 FailSAE 实际应用价值的重要视觉证据。
实验如何设计?
- 数据集:在 CIFAR-10, CIFAR-100, ImageNet-1K 上评估故障预测性能。故障预测数据集构建依赖于目标 VLM 的误分类样本,确保覆盖多种故障类型。
- VLM 架构:在 CLIP-B/32, SigLIP-B/16, CLIP-L/14 上测试泛化性,验证 FailSAE 在不同 VLM 架构上的适用性。
- 评估指标:使用细粒度四分类和二分类的准确率(Acc)、AUROC、FPR@95 等指标评估故障预测性能。
- 消融研究:验证三阶段训练各阶段及 SAE 分解的必要性,分析 Top-K masking 中 K 值对性能的影响。
- 概念分析:比较正确预测与故障预测中 Top 激活潜在方向的分布,揭示故障与概念激活变化的关联。
- 故障恢复:评估基于 SAE 潜在干预和图像掩码的运行时故障恢复策略的有效性。
关键结果与论文证据
- FailSAE 在 CIFAR-10 上实现细粒度 Acc 88.0%,AUROC 93.9%,显著优于现有基线(Page 5, Table 1)。
- Top-K masking 最优 K=300 时,CIFAR-10 Acc 达到 88.1%,表明保留最具判别力的潜在方向对性能至关重要(Page 4, Figure 2)。
- 故障感知 SAE 平均标签熵从 2.598 降至 1.955,表明故障感知训练提高了概念特异性(Page 6, Table 4)。
- Top 5% 激活方向中,故障感知 SAE 有 25.5% 代表有意义概念,Standard SAE 为 18.6%,验证了故障感知训练对概念可解释性的提升(Page 6, Table 4)。
- 故障时类特定概念抑制,模糊/风格相关概念激活增加,这一发现为理解 VLM 故障机制提供了新视角(Page 6, Table 4)。
- Patch 攻击故障恢复率 81.2%,表明基于 SAE 潜在干预的故障恢复策略有效(Page 7, Figure 6)。
- FailSAE 在 CLIP-B/32, SigLIP-B/16, CLIP-L/14 上均表现出良好的泛化性,验证了其在不同 VLM 架构上的适用性(Page 5, Table 3)。
- 三阶段训练各阶段均对性能有显著贡献,消融研究验证了 SAE 分解的必要性(Page 5, Table 2)。
阅读时需要注意
- 主要基于 CLIP 架构的视觉编码器进行实验,对其他 VLM 架构的适用性虽有所验证但范围有限。
- 故障预测数据集构建依赖于目标 VLM 的误分类样本,可能受限于 VLM 本身的错误分布。
- Top-K masking 的 K 值需要手动调优,不同数据集最优 K 值可能不同。
- 故障感知训练虽然提高了概念特异性,但可能牺牲部分通用重建能力(尽管重建误差变化很小)。
- 概念级分析基于统计相关性,不能直接证明因果关系。
- 运行时故障恢复策略在复杂腐蚀或对抗攻击场景下的鲁棒性有待进一步验证。
关联工作
- ORCA-B / ORCA-R:基于人类定义概念集的故障预测基线,本文方法无需手动定义概念集(Page 2)。
- SuperMentor:基于学习的故障预测基线,本文方法在可解释性上优于其(Page 3)。
- SSL (Luo et al. 2021):基于置信度/不确定性的故障预测基线(Page 3)。
- Zaigrajew et al. 2025:使用分层 SAE 解释 CLIP,本文将其扩展为故障预测机制(Page 2)。
- Lim et al. 2024:使用 SAE 揭示 VLM 视觉概念重映射,本文借鉴其 SAE 架构和训练流程(Page 2)。