快速导读:本文提出 DF26 基准,包含由最新 T2V/I2V 模型生成的单人公开演讲视频,显示当前 SOTA 检测器与人类在识别这些 AI 生成视频时性能接近随机猜测。
随着视频生成模型逼真度持续提升,传统基于局部操纵的deepfake检测基准已难以评估现代全场景生成模型的鲁棒性。本文提出DF26基准,聚焦单人公开演讲这一高风险场景,系统评估当前SOTA检测器与人类对AI生成视频的识别能力。
DF26通过多阶段流水线构建包含真实与合成视频的受控数据集,利用七个现代视频生成模型覆盖T2V和I2V模式,并开展人类感知研究。实验揭示现有检测体系在现代生成器上性能大幅下降,部分接近随机猜测,为评估生成视频检测鲁棒性提供关键基准。
英文题目:DF26: We Cannot Tell Fake From Real Anymore
论文出处:arXiv 每日论文精选 · arXiv:2609.07369
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有deepfake检测基准如FaceForensics++和CDFv3主要关注面部替换或局部操纵,无法有效评估针对现代全场景生成模型的鲁棒性。随着T2V和I2V模型逼真度提升,传统检测器在跨生成器场景下泛化能力显著下降。
公开演讲场景具有高风险性,AI生成的演讲视频可能用于政治操纵、金融欺诈等场景,但现有基准缺乏针对该场景的受控评估协议。人类对AI生成视频的识别准确率也接近随机水平,亟需新的基准来衡量对现代生成模型分布偏移的鲁棒性。
ViF-Bench等开放域基准虽涵盖AI生成视频,但缺乏对公开演讲场景的聚焦,且未提供受控的生成器与场景元数据,难以进行细粒度的检测器性能分析。
核心创新
- 提出首个针对单人公开演讲场景的受控生成视频检测基准 DF26。
- 提供可复现的数据集协议,包含生成器标签、场景标签、提示词及生成模式元数据。
- 揭示 SOTA 视觉检测器在现代生成器上性能大幅下降,部分接近随机猜测。
- 通过人类研究量化 DF26 的感知难度,显示其 fake 视频识别准确率仅 52.6%。
方法概览
构建包含 271 个真实视频和 2420 个合成视频的基准。通过多阶段流水线(过滤、语义分类、人工筛选、提示词生成)从 OpenVid、TalkingCelebs 等数据源获取真实视频,并使用 Gemini 2.5 VLM 生成语义提示词。利用 7 个现代视频生成模型(3 个开源,4 个商业)生成对应的合成视频,覆盖 T2V 和 I2V 模式。评估包括帧级和时序级 SOTA 检测器,并开展人类感知研究。
- 数据集构建采用多阶段流水线:从OpenVid、TalkingCelebs等数据源获取真实视频,通过过滤、语义分类、人工筛选确保质量,并利用Gemini 2.5 VLM生成语义提示词。
- 利用七个现代视频生成模型(三个开源、四个商业)生成对应的合成视频,覆盖T2V和I2V模式,确保生成器多样性与场景一致性。
- 提供可复现的数据集协议,包含生成器标签、场景标签、提示词及生成模式元数据,支持细粒度的检测器性能分析。
- 评估包括帧级和时序级SOTA检测器,对比CDFv3基准,并按生成器来源、生成模式和语义场景进行分层分析。
- 开展人类感知研究,比较DF26、CDFv3和DSv2上人类对真实/伪造视频的识别准确率,量化DF26的感知难度。
- 在DF26的Official Statement I2V子集上重新训练GenD-PE,评估跨生成器泛化能力,验证检测器对现代生成器的适应性。
逐图理解论文
失效直觉
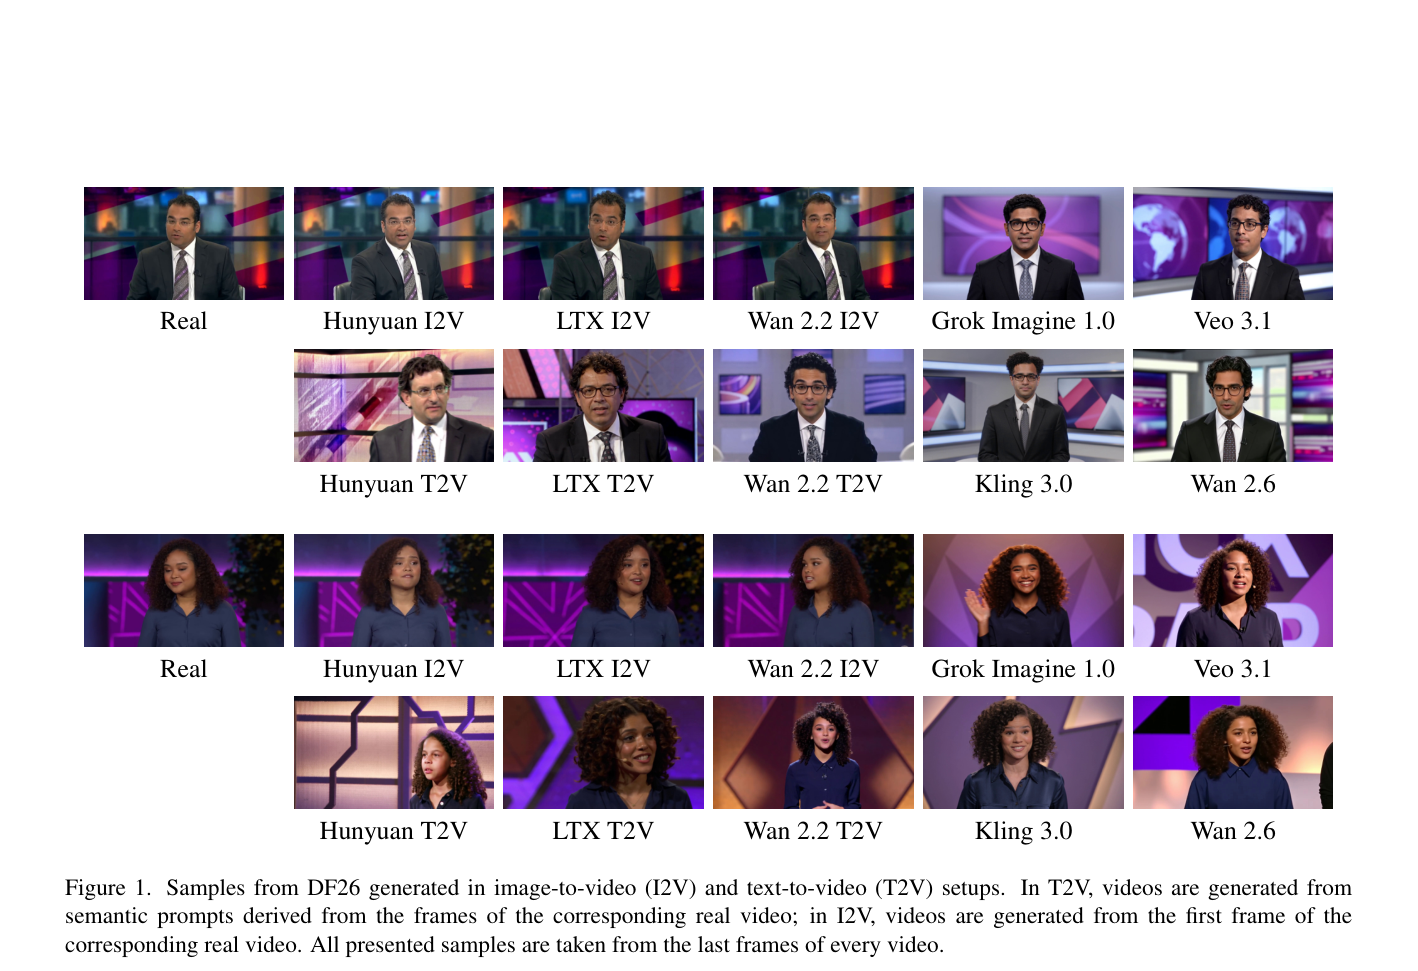
该图展示DF26中I2V和T2V生成的样本,取自每个视频的最后帧。观察T2V样本可发现语义提示词对生成内容的影响,I2V样本则展示首帧对生成结果的约束。该图直观呈现DF26生成视频的逼真度,为理解检测难度提供视觉基础。
研究缺口
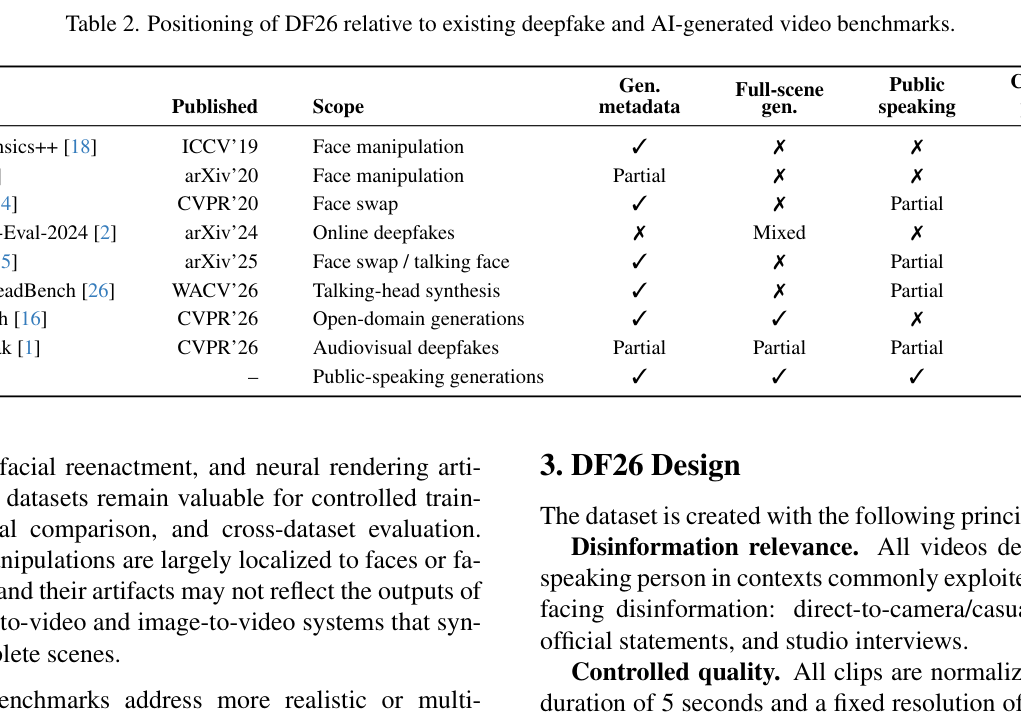
该表定位DF26相对于现有deepfake和AI生成视频基准的位置。观察各基准在场景聚焦、生成器覆盖、元数据完整性等维度的差异,可清晰理解DF26在公开演讲场景受控评估上的独特贡献。
核心贡献
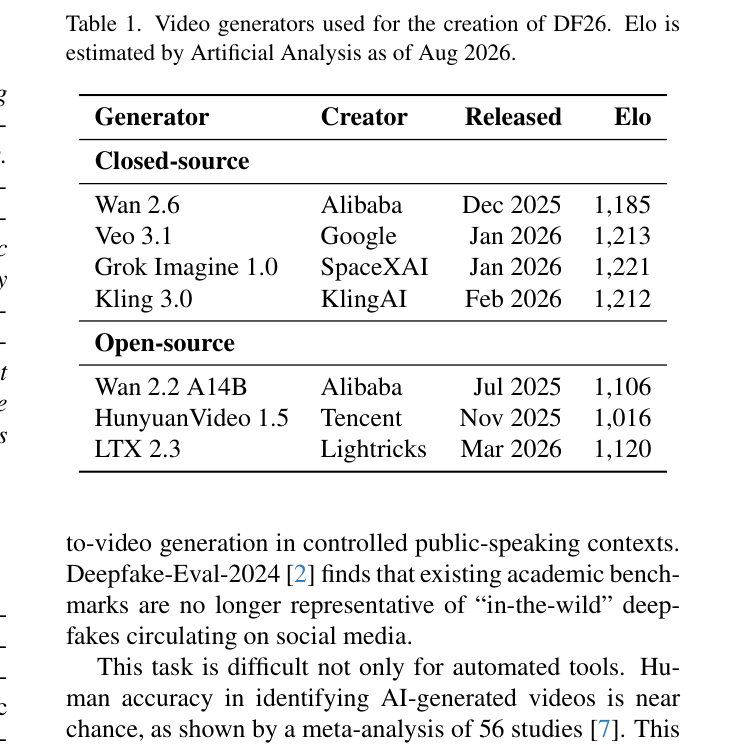
DF26通过多阶段流水线构建真实与合成视频对,利用七个现代生成模型覆盖T2V和I2V模式,并开展人类感知研究,系统评估检测器与人类的识别能力。
关键发现
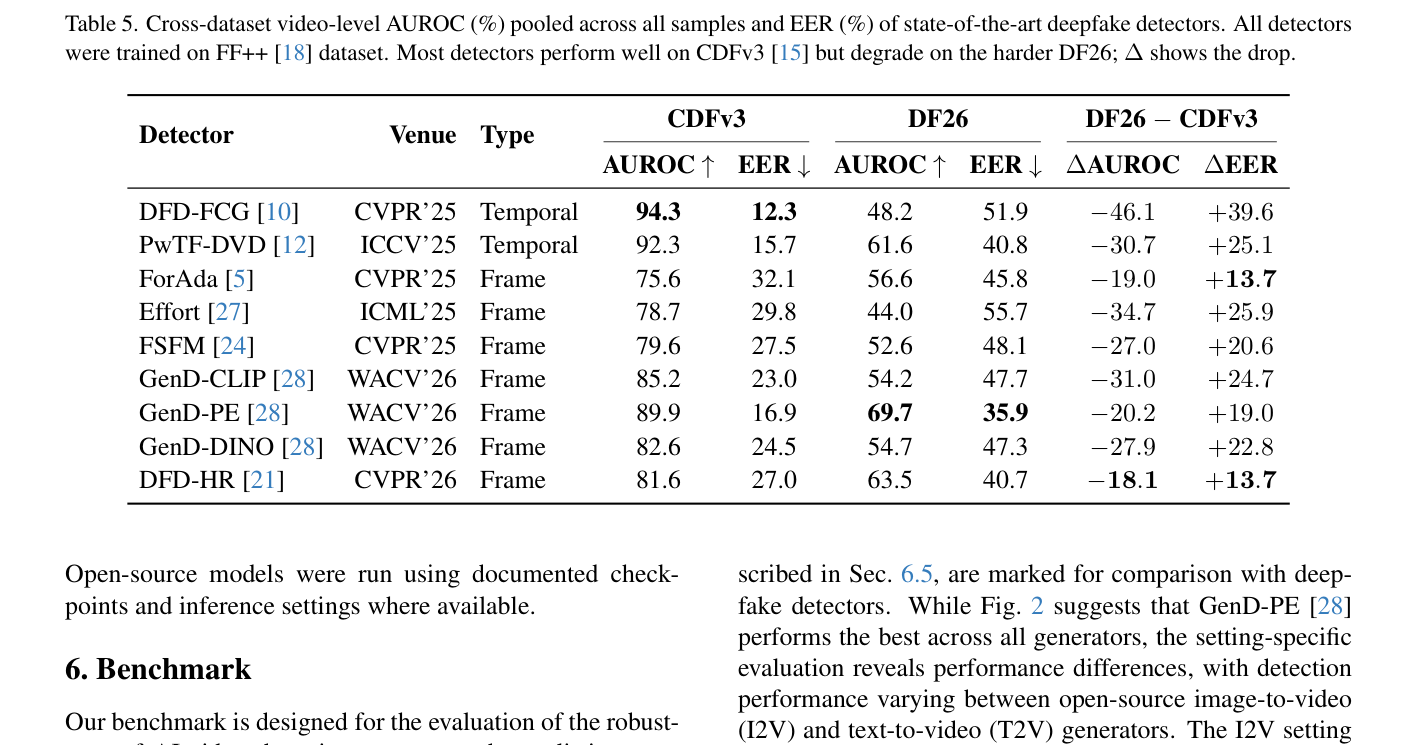
该表展示SOTA检测器在DF26和CDFv3上的AUROC和EER,以及性能下降幅度(Δ)。观察Δ列可发现检测器在DF26上性能大幅下降,部分接近随机猜测,证实现代生成视频对现有检测体系的冲击。
结论与局限
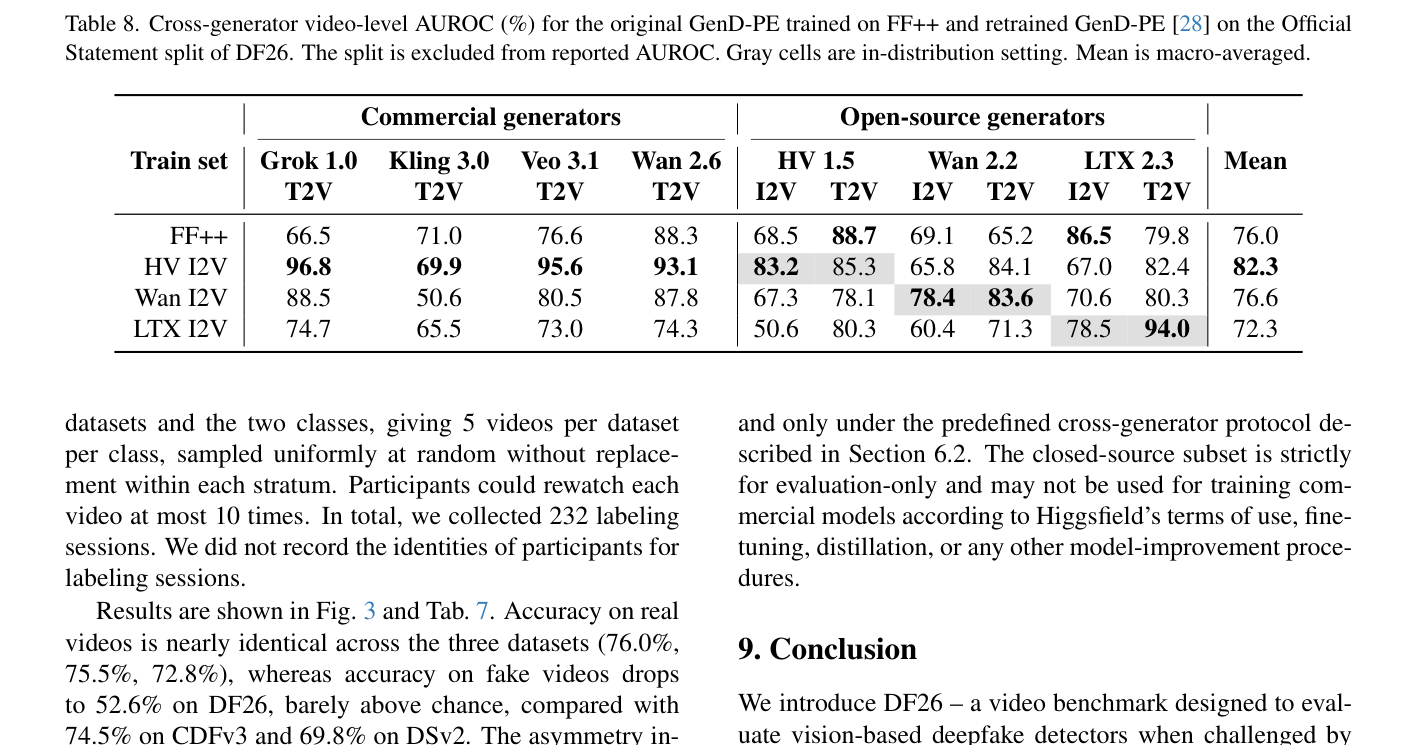
该表对比原始GenD-PE和重新训练GenD-PE在DF26各生成器上的AUROC。观察重新训练后在商业生成器上的性能提升,可证实检测器可通过针对性训练适应现代生成器,为检测器设计提供方向。
实验如何设计?
- 在DF26上评估九个SOTA检测器(帧级和时序级),对比CDFv3基准,检测器均在FF++数据集上训练。
- 按生成器来源(开源/商业)、生成模式(T2V/I2V)和语义场景进行分层分析,揭示检测器性能差异的结构性原因。
- 在DF26的Official Statement I2V子集上重新训练GenD-PE,评估跨生成器泛化能力,验证检测器对现代生成器的适应性。
- 开展人类研究,比较DF26、CDFv3和DSv2上人类对真实/伪造视频的识别准确率,量化DF26的感知难度。
关键结果与论文证据
- SOTA检测器在DF26上性能大幅下降,GenD-PE最高AUROC为69.7,而在CDFv3上为89.9,证实现代生成视频对现有检测体系构成严峻挑战(第6页)。
- DFD-FCG在DF26上AUROC降至48.2,CDFv3上为94.3,部分检测器性能接近随机猜测,暴露现有检测体系在分布偏移下的严重失效(第6页)。
- 人类在DF26 fake视频上的准确率为52.6%,CDFv3为74.5%,DSv2为69.8%,证实DF26的感知难度显著高于现有基准(第7页)。
- PwTF-DVD在Wan 2.2 T2V上AUROC为92.9,但在HunyuanVideo 1.5上接近随机,揭示检测器性能对生成器来源的强依赖性(第6页)。
- 重新训练GenD-PE后,在商业生成器(Grok, Veo, Wan 2.6)上AUROC至少为93.1,证实检测器可通过针对性训练适应现代生成器(第8页)。
- 开源与商业生成器之间存在一致的性能差距,时序检测器在开源生成器上表现显著优于商业生成器,揭示生成器来源对检测难度的结构性影响(第4、7页)。
阅读时需要注意
- 数据集规模较小(2691个视频),相对于大规模基准有限,可能影响检测器性能评估的统计显著性。
- 仅关注视觉模态,未评估音频真实性、唇形同步或音视频一致性,无法全面反映AI生成视频的多模态特征。
- 商业生成器仅评估T2V模式,且受平台限制未包含Official Statement场景,可能低估商业生成器在特定场景下的检测难度。
- 人类研究参与者主要为技术大学学生,可能不代表一般公众的感知能力,限制研究结论的外部效度。
关联工作
- FaceForensics++作为传统面部操纵基准,用于训练检测器,但无法评估现代全场景生成模型的鲁棒性(第1页)。
- CDFv3(CelebDF++)作为近期面部替换/说话人脸基准,用于对比,证实DF26在检测难度上的显著提升(第3页)。
- DeepSpeak v2作为音视频deepfake基准,用于人类研究对比,揭示DF26在视觉模态上的独特挑战(第3页)。
- ViF-Bench作为开放域AI生成视频基准,缺乏公开演讲聚焦,DF26通过受控场景设计弥补这一缺口(第3页)。
- GenD-PE作为SOTA帧级检测器,在DF26上表现最佳,但性能仍大幅下降,证实现有检测体系的局限性(第6页)。
- PwTF-DVD作为SOTA时序检测器,在DF26上表现不稳定,揭示时序检测器对生成器来源的强依赖性(第6页)。