UniH3:统一层级同质性与异质性以实现全合一医学图像复原
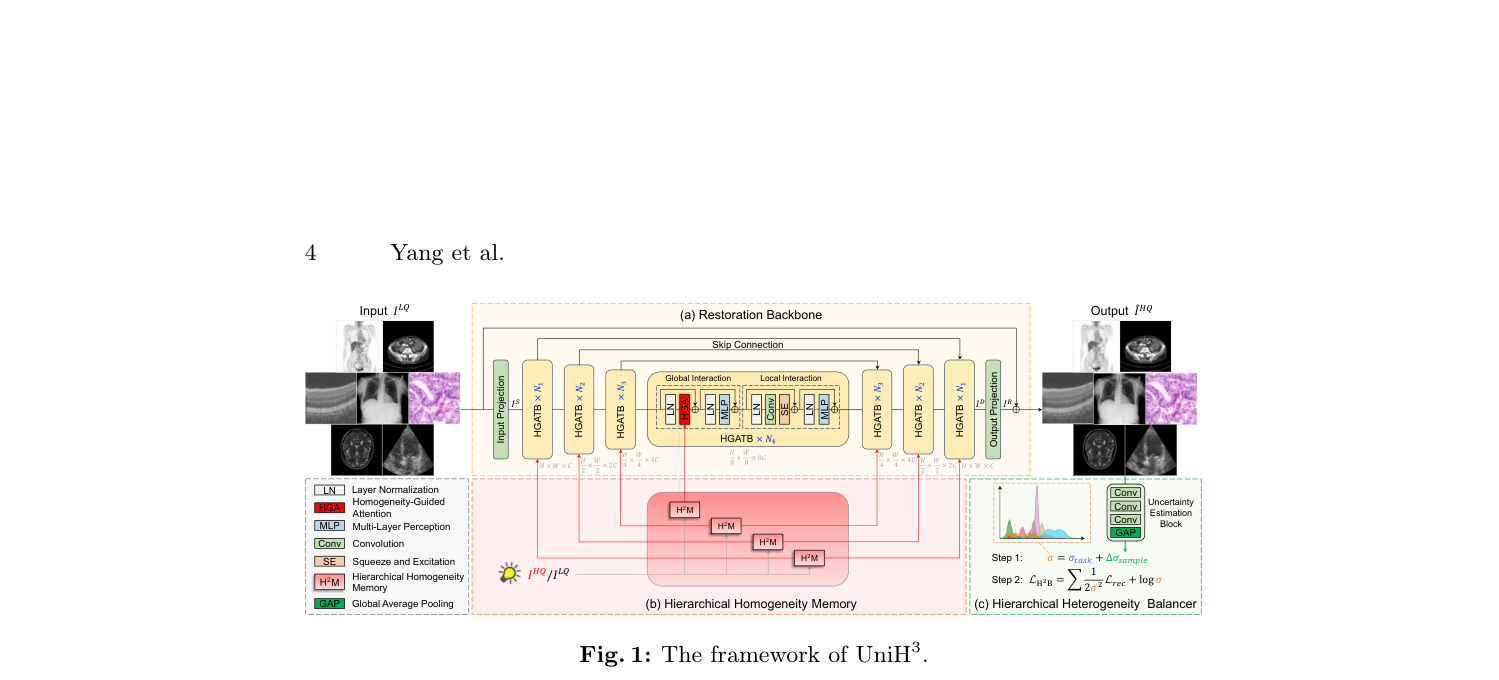
本文提出 UniH3 框架,通过层级同质性记忆(H2M)和层级异质性平衡器(H2B)同时建模医学图像中的层级同质性与异质性,在 2D 和 3D 基准上实现了全合一及单任务医学图像复原的 SOTA 性能。
本文提出 UniH3 框架,通过层级同质性记忆(H2M)和层级异质性平衡器(H2B)同时建模医学图像中的层级同质性与异质性,在 2D 和 3D 基准上实现了全合一及单任务医学图像复原的 SOTA 性能。
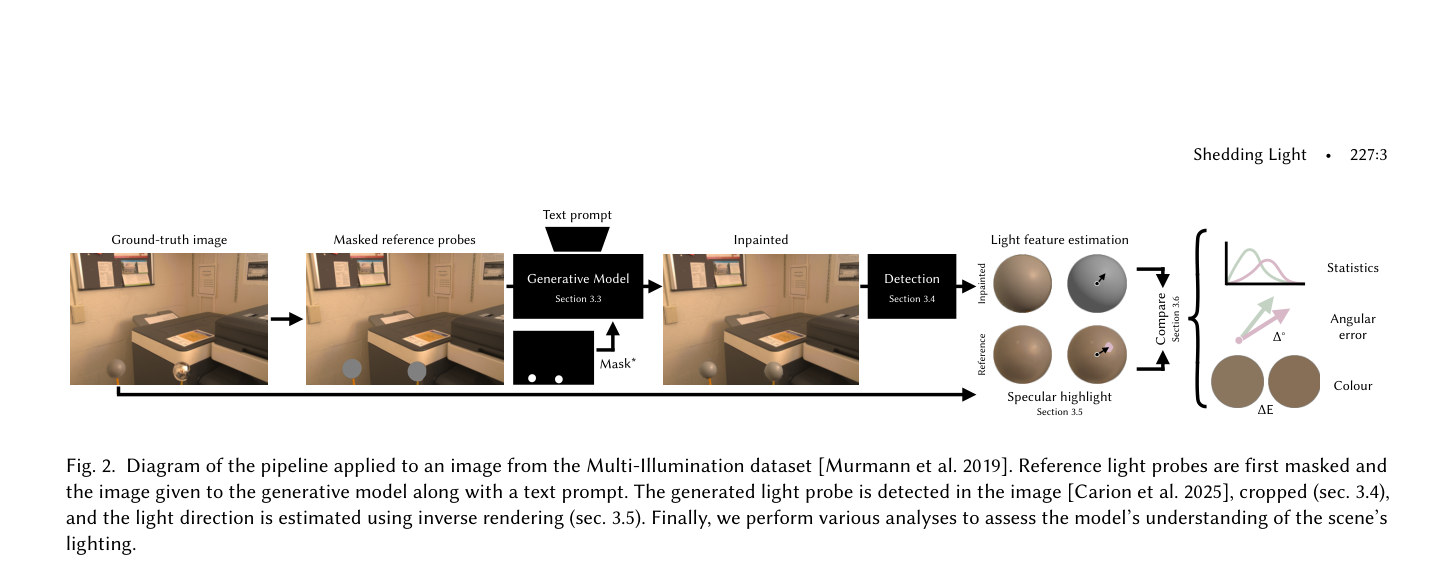
本文提出了一种基于 inpainting 和物理渲染逆问题的基准测试方法,通过让生成模型在真实场景中插入“光探针”(diffuse spheres),定量评估了 16 个 SOTA 生成模型对场景光照方向、颜色及空间变化的物理准确性。
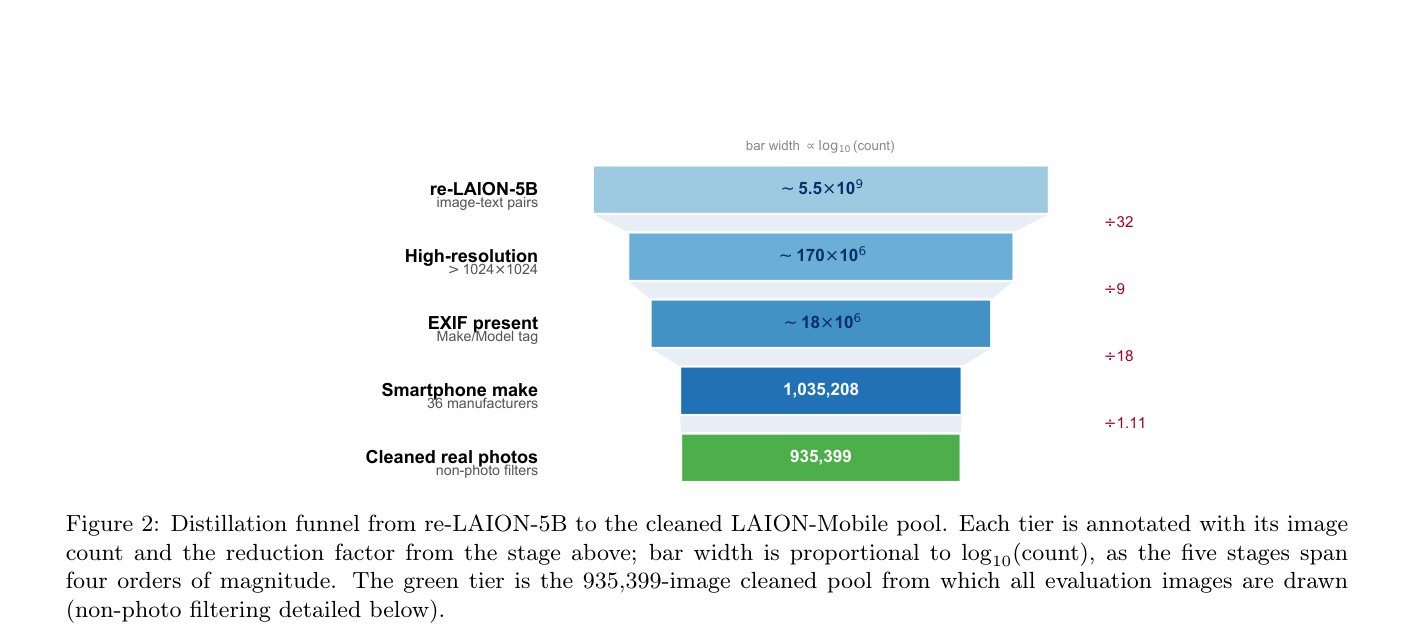
本文构建了包含约100万张智能手机照片的 LAION-Mobile 数据集,审计了12个 SOTA Deepfake 检测器,发现它们在现代 AI 生成内容上性能大幅下降,且在真实手机照片上产生高达 91% 的误报率,证实了计算摄影对检测器构成的挑战。
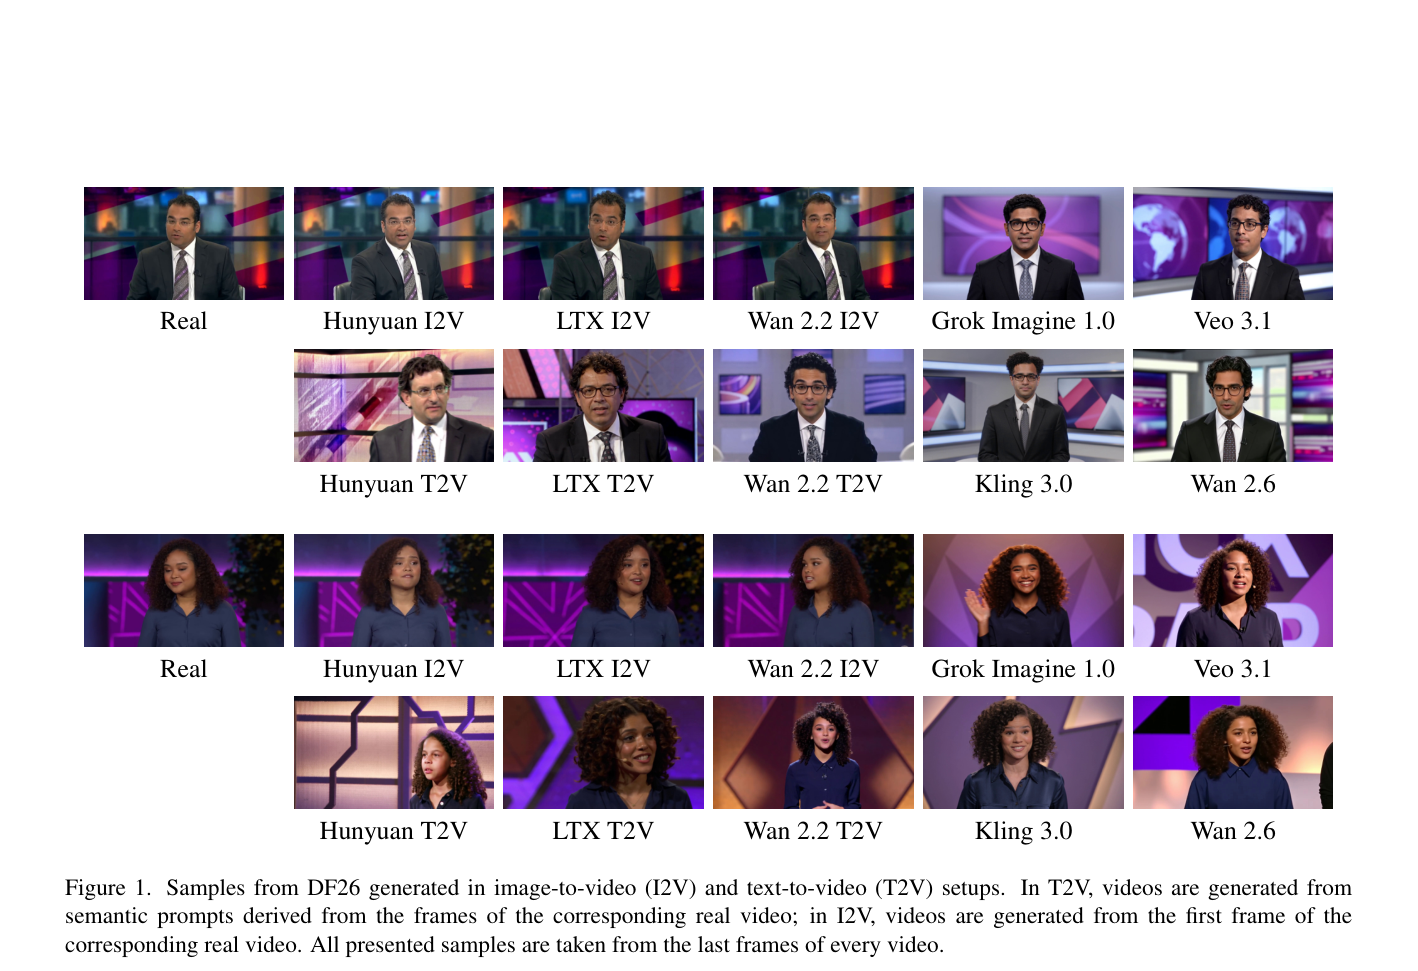
本文提出 DF26 基准,包含由最新 T2V/I2V 模型生成的单人公开演讲视频,显示当前 SOTA 检测器与人类在识别这些 AI 生成视频时性能接近随机猜测。
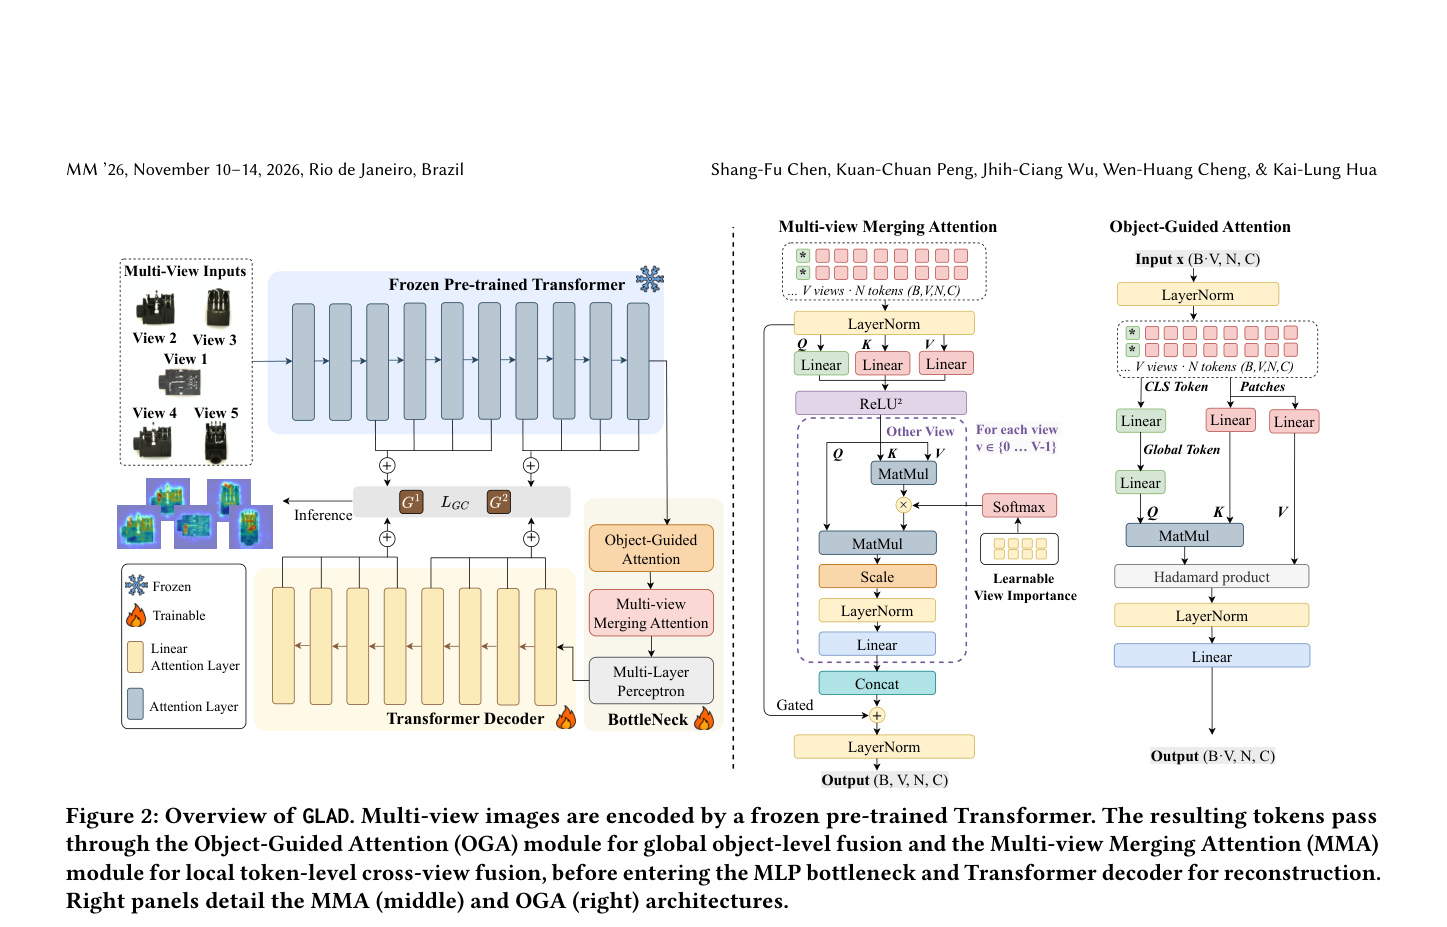
GLAD 提出信息受限的全局-局部多视角融合框架,通过 OGA 和 MMA 模块防止跨视角信息泄漏导致的重建差距坍缩,在多视角异常检测上取得 SOTA 性能。
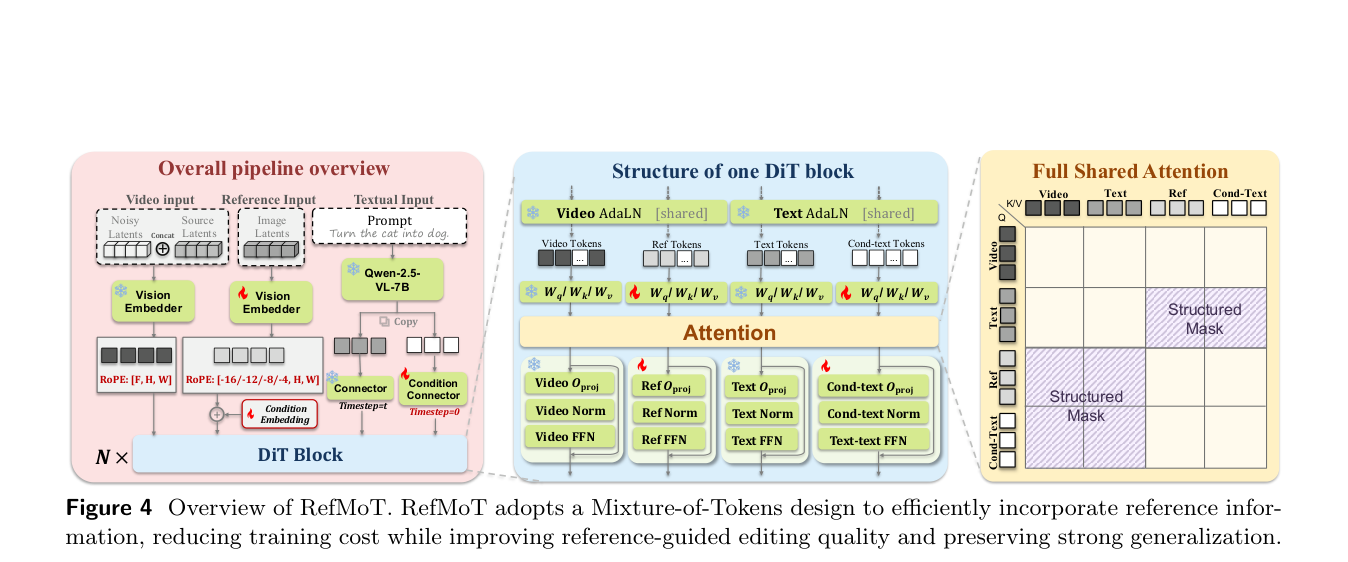
提出包含5M视频对和1M图像对的可靠参考引导编辑数据集RefVideo-6M,并基于此训练RefMoT模型,在指令式和参考式视频编辑上取得SOTA性能。
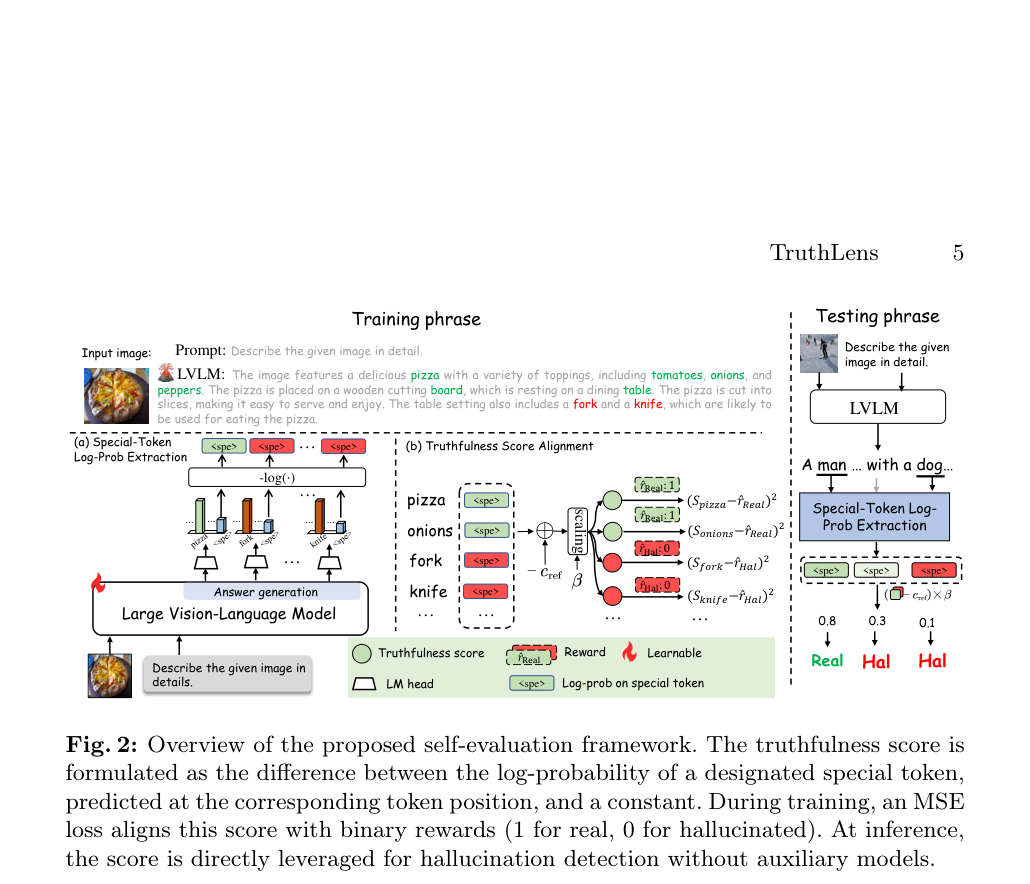
TruthLens微调LVLM的LM head,通过一个特殊token的对数概率来暴露每个目标token的真实性信号,无需辅助模型即可实现SOTA的幻觉检测。