快速导读:本文提出GP-Refiner,利用高斯过程回归(GPR)校正扩散模型特征缓存中的累积误差,并通过后验方差实现自适应重计算,在保持生成质量的同时显著提升推理速度。
扩散 Transformer(DiT)的推理成本高昂,特征缓存技术通过复用或预测中间层特征来加速推理,但长间隔跳过会导致误差累积,严重损害生成质量。现有方法如 TaylorSeer 和 HiCache 缺乏有效的在线校正机制,因为加速推理中无法获得无偏的监督标签。
本文提出 GP-Refiner,利用高斯过程回归(GPR)校正缓存特征中的累积误差。核心洞察是缓存残差近似服从零均值高斯分布,使得全计算步特征可视为含噪观测。GP-Refiner 通过监控 GPR 后验方差,在不确定性过高时触发自适应重计算,实现了速度与质量的动态平衡。
英文题目:Accelerating Diffusion Transformers with Gaussian Process Rectified Feature Cache
论文出处:arXiv 每日论文精选 · arXiv:2609.05981
原始论文:PDF / 论文页面
这篇论文解决什么问题?
DiT 模型在生成高质量图像时需要进行多步去噪,每一步都涉及完整的 Transformer 前向传播,计算开销巨大。特征缓存方法旨在跳过部分步骤,利用之前计算的特征或预测器来填充缺失步骤,从而减少函数评估次数(NFE)。
然而,简单的缓存或线性预测(如 TaylorSeer 的一阶泰勒展开)在跳过步数增加时,预测误差会非线性累积。这种累积误差会导致生成图像出现伪影、结构扭曲或细节丢失。
直接训练一个回归模型来校正预测误差面临“无偏标签缺失”问题。在加速推理过程中,模型只能访问基于已漂移状态计算的特征,这些特征本身包含误差,无法作为无偏的监督信号来训练校正器。
现有工作如 SpeCa 和 DiCache 尝试通过验证信号或探测信号来触发重计算,但缺乏对误差分布的统计建模,难以精确量化不确定性。
核心创新
- 揭示了缓存特征残差的零均值高斯分布特性,解决了加速推理中无偏标签缺失的问题
- 提出GP-Refiner,利用GPR进行即插即用的特征偏差校正,几乎无额外计算开销
- 引入基于后验方差的自适应重计算策略,动态平衡推理速度与生成质量
方法概览
GP-Refiner框架包含两个核心部分:1. 统计观察表明缓存特征与参考特征的残差近似服从零均值高斯分布,因此将全计算步特征视为参考特征的含噪观测;2. 利用GPR对基线预测特征进行校正,并监控后验方差,当不确定性超过阈值时触发全计算重校准,实现速度与质量的动态平衡。
- 统计观察:作者首先对缓存特征与参考全计算特征的残差进行统计分析,发现其直方图近似高斯分布,且 Q-Q 图显示经验分位数与标准正态线高度吻合(R² ≈ 0.97–0.99)。
- 高斯过程建模:基于上述观察,GP-Refiner 将全计算步的特征视为参考特征的含噪观测,利用高斯过程回归(GPR)对基线预测特征进行校正。GPR 不仅提供点估计,还提供后验方差,用于量化预测的不确定性。
- 自适应重计算策略:GP-Refiner 监控 GPR 的后验方差。当方差超过预设阈值时,表明当前预测不可靠,系统触发全计算重校准,更新观测集并重置 GPR 模型。
- 即插即用设计:GP-Refiner 作为后处理模块,可以无缝集成到现有缓存方法(如 TaylorSeer、HiCache、ClusCa)中,无需修改基线模型的训练过程。
- FIFO 观测窗口:为了控制 GPR 的计算复杂度,GP-Refiner 使用固定大小的 FIFO 窗口存储最近的观测数据,确保在线校正的效率。
逐图理解论文
失败直觉
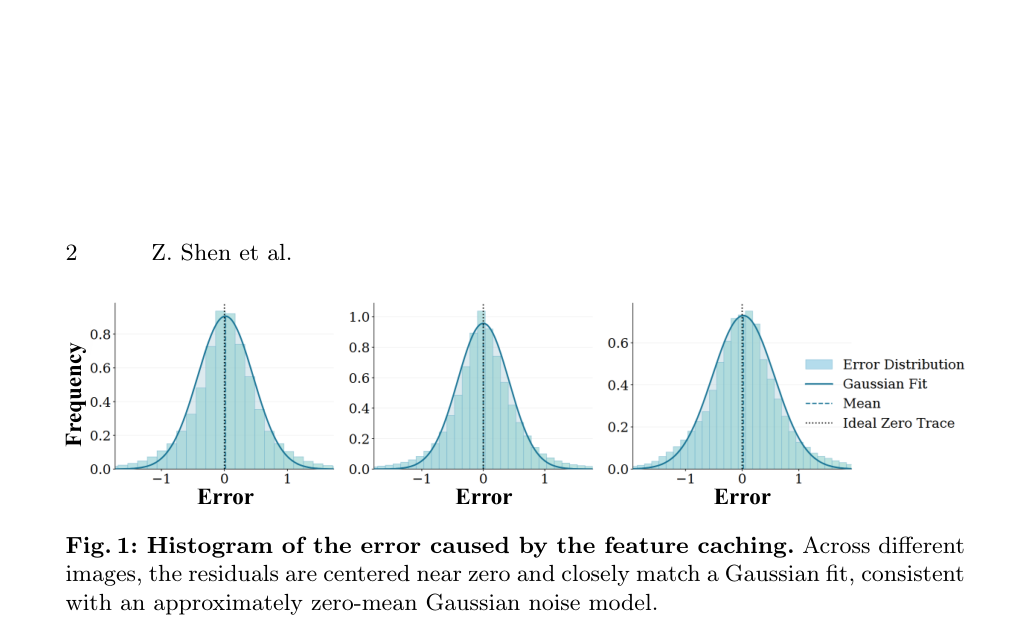
该图展示了缓存误差的直方图,直观呈现了残差近似零均值高斯分布的特性。这是 GP-Refiner 方法的核心统计假设,解释了为何可以使用 GPR 进行校正。
统计洞察
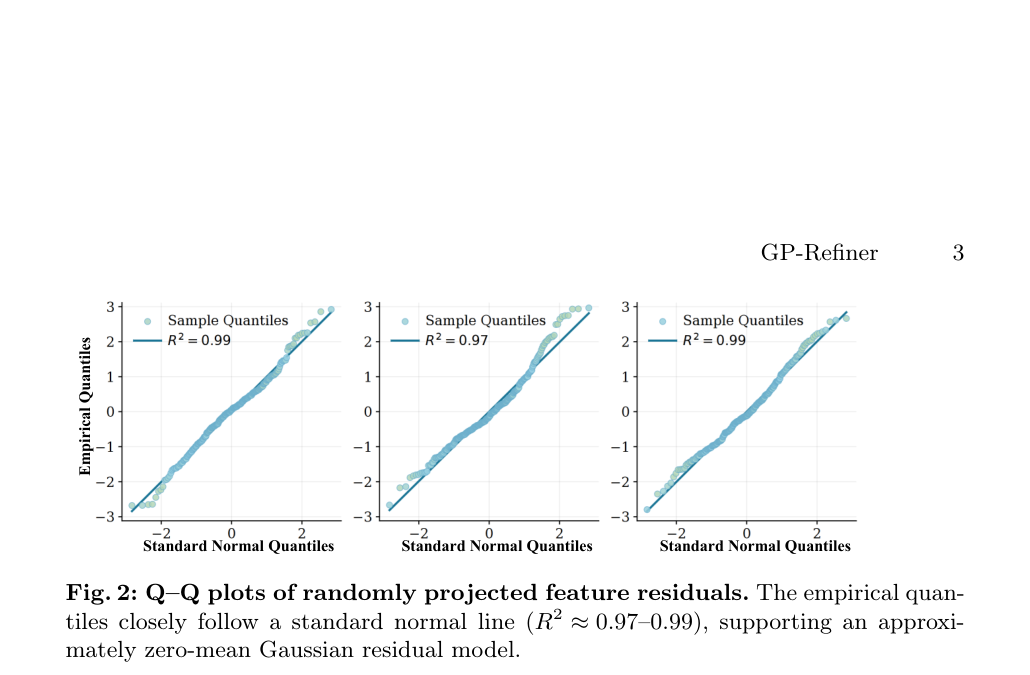
Q-Q 图进一步验证了高斯假设,经验分位数与标准正态线高度吻合。这为 GPR 的有效性提供了更强的统计证据。
方法贡献
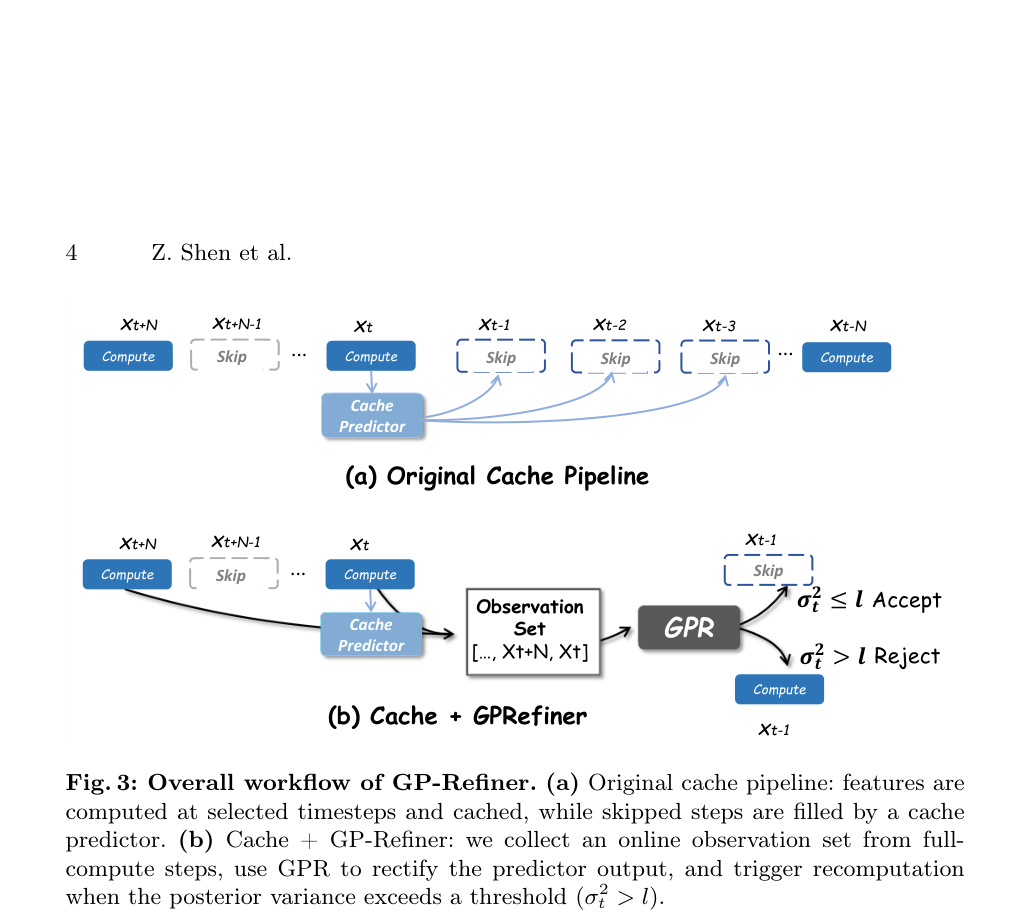
该图展示了 GP-Refiner 的整体工作流程,包括原始缓存管道和加入 GP-Refiner 后的校正与自适应重计算机制。清晰展示了方法的即插即用特性和动态调度逻辑。
实验验证
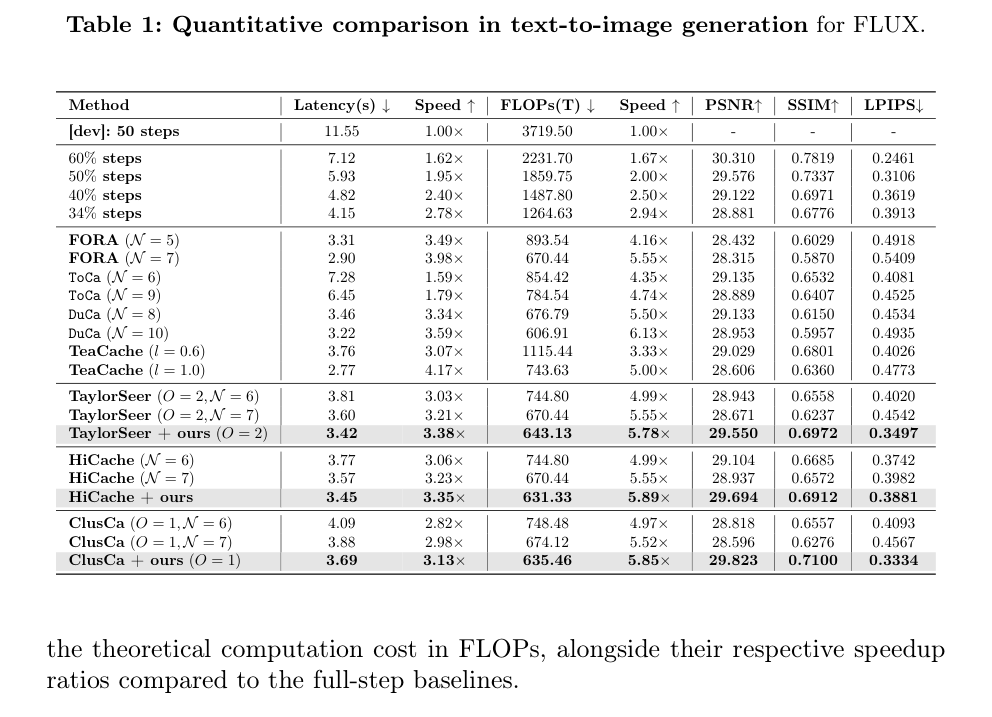
该表列出了 FLUX 模型上的定量对比结果,展示了 GP-Refiner 与不同基线结合后的 PSNR、LPIPS 和加速比。是评估方法有效性的核心证据。
结论与局限
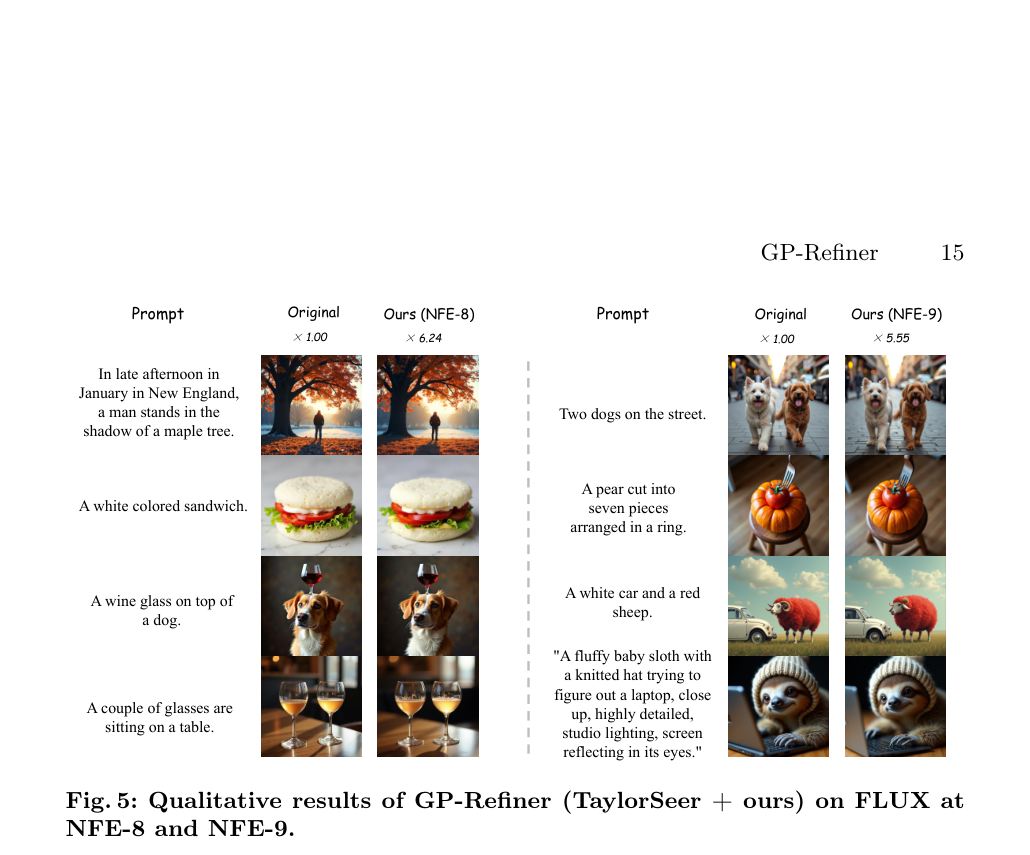
该图展示了 TaylorSeer + GP-Refiner 在 FLUX 上的定性结果,分别在 NFE-8 和 NFE-9 下生成。展示了高加速比下的生成质量。
实验如何设计?
- 模型与数据集:实验在 FLUX.1-dev 和 Qwen-Image 两个主流 DiT 模型上进行,使用 DrawBench 的 200 个提示词进行评估。
- 基线方法:对比了 TaylorSeer、HiCache、ClusCa 等代表性缓存方法,并测试了 GP-Refiner 与这些基线结合的效果。
- 评估指标:使用 PSNR、SSIM、LPIPS 评估生成质量,使用延迟和 FLOPs 加速比评估推理效率。
- 消融实验:分别验证 GPR 校正和动态调度机制的贡献,分析不同阈值对性能的影响。
关键结果与论文证据
- 在 FLUX 上,TaylorSeer + GP-Refiner 达到 PSNR 29.550,LPIPS 0.3497,FLOPs 加速比 5.78x(第12页)。
- ClusCa + GP-Refiner 在 FLUX 上取得最佳 PSNR 29.823,LPIPS 0.3334(第12页)。
- 在 Qwen-Image 上,TaylorSeer + GP-Refiner 达到 PSNR 29.48,LPIPS 0.29,FLOPs 加速比 6.19x(第13页)。
- 消融实验显示,在 N=7 时,加入 GPR 校正后 PSNR 从 28.671 提升至 29.266(第13页)。
- 动态调度机制使 NFE 分布保持稳定,大部分图像在 8-9 次函数评估内完成生成(第14页)。
- 视觉对比显示,GP-Refiner 显著减少了高加速比下的伪影和结构失真(第14-15页)。
阅读时需要注意
- 高斯残差假设在极端加速比或特定模型架构下可能不成立,需进一步验证其普适性。
- 主要实验集中在 Text-to-Image 任务,未涉及 Video 生成等其他 DiT 应用场景。
- GPR 的计算复杂度随观测集大小增加,虽然使用了 FIFO 窗口限制,但在极高步数或长序列场景下的扩展性未详细讨论。
- 阈值 l 的选择对性能有影响,实际应用中可能需要针对特定模型微调。
关联工作
- TaylorSeer:基线预测方法,GP-Refiner 与其结合显著提升质量。
- HiCache:基于 Hermite 多项式的基线预测方法,GP-Refiner 与其结合有效。
- ClusCa:基于聚类的缓存方法,GP-Refiner 与其结合达到最佳 PSNR。
- SpeCa:推测式缓存,通过验证信号触发重计算,GP-Refiner 提供不确定性量化作为替代。
- DiCache:在线对齐缓存,利用探测信号自适应调度,GP-Refiner 利用 GPR 后验方差实现类似功能。