快速导读:本文提出了vCT和vCCT两种反事实评估指标,通过移除图像中的特定对象来测试VLM的解释是否忠实于其预测变化,发现Predict-then-Explain (PE) 策略比Chain-of-Thought (CoT) 更忠实于视觉证据。
视觉语言模型(VLM)生成的解释往往看似合理,但未必忠实于其内部决策机制。本文提出vCT和vCCT两种反事实评估指标,通过移除图像中的特定对象,测试VLM的解释是否忠实于其预测变化。
研究发现,Predict-then-Explain(PE)策略比Chain-of-Thought(CoT)更忠实于视觉证据。该工作为VLM可解释性提供了量化基准,揭示了现有CoT方法在视觉任务中的潜在缺陷。
英文题目:Counterfactual Tests for Measuring Chain-of-Thought Faithfulness in Visual Language Models
论文出处:arXiv 每日论文精选 · arXiv:2609.06704
原始论文:PDF / 论文页面
这篇论文解决什么问题?
在NLP领域,Counterfactual Test(CT)和Correlational Counterfactual Test(CCT)已被用于评估文本解释的忠实性。然而,将这些方法扩展到视觉输入具有挑战性,因为视觉反事实需要受控的对象级操作,且需区分语义变化与图像编辑产生的重建伪影。
现有VLM解释往往看似合理(plausible)但未必忠实(faithful)于模型内部的决策机制。缺乏一种能够量化VLM解释与视觉证据之间因果关联的自动化评估方法,特别是当视觉输入发生微小变化时,解释是否反映了导致预测变化的关键因素。
视觉反事实测试的核心难点在于如何生成“最小编辑”的反事实图像,同时避免引入无关的重建伪影。如果编辑过程本身改变了图像的语义结构,那么预测变化可能源于伪影而非被移除的对象,导致评估结果失真。
核心创新
- 提出了vCT和vCCT指标,将NLP中的CT/CCT框架适配到视觉语言模型,通过对象移除干预来评估解释忠实性。
- 构建了Counter-SNLI-VE和Counter-A-OKVQA两个配对反事实数据集,包含数千个最小编辑的图像对,并提供了开源代码和数据。
- 引入了No-op reconstruction控制实验,以区分由语义对象移除引起的预测变化与由扩散模型重建伪影引起的变化。
方法概览
作者构建了一个三阶段对象移除流水线(使用Qwen2.5-VL-7B进行对象选择,Qwen-Image-Edit进行扩散模型修复,以及质量过滤),生成了Counter-SNLI-VE和Counter-A-OKVQA数据集。评估流程包括:1) 对原始和编辑后的图像分别进行PE或CoT提示;2) 提取答案概率分布并计算Total Variation Distance (TVD);3) 使用LLM判断解释中是否提及被移除的对象;4) 计算vCT(二元一致性)和vCCT(相关性)指标。
- 对象移除流水线:使用Qwen2.5-VL-7B进行对象选择,Qwen-Image-Edit进行扩散模型修复,并通过质量过滤确保编辑的最小性和语义一致性。
- 数据集构建:生成Counter-SNLI-VE和Counter-A-OKVQA两个配对反事实数据集,包含数千个最小编辑的图像对,支持自动化评估。
- 评估流程:对原始和编辑后的图像分别进行PE或CoT提示,提取答案概率分布并计算Total Variation Distance(TVD)。
- 指标定义:vCT(二元一致性)检查预测翻转时解释是否提及被移除对象;vCCT(相关性)衡量解释提及与概率偏移幅度的相关性。
- No-op重建控制:使用相同编辑器但不移除对象,以隔离重建伪影的影响,确保预测变化归因于语义对象移除。
- 变化提及检测:使用LLM判断解释中是否提及被移除的对象,并通过人工审计验证检测准确性。
逐图理解论文
直觉失效
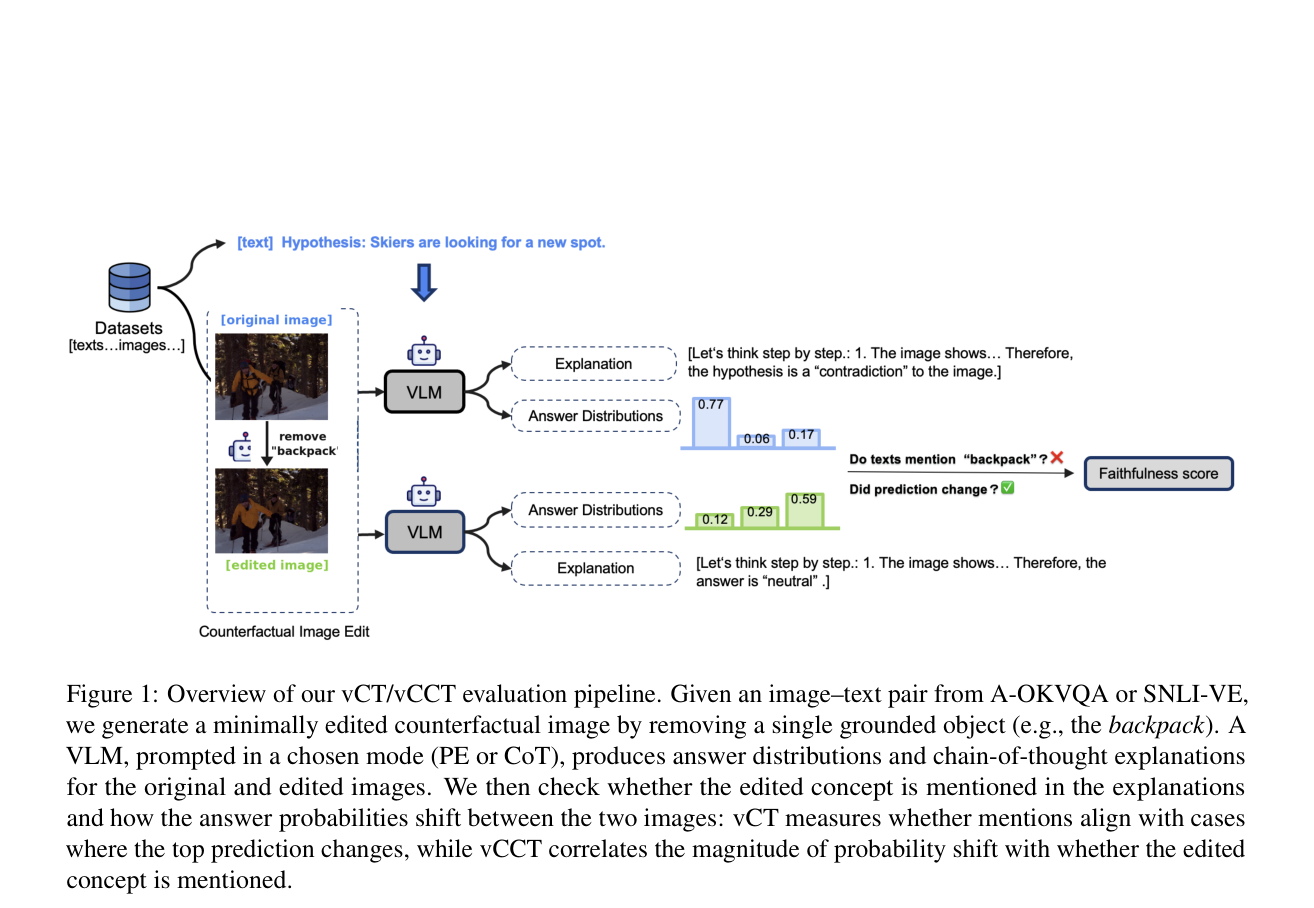
该图展示了vCT/vCCT评估流水线的整体架构。需关注对象移除、VLM提示、概率提取和指标计算四个阶段,理解反事实图像如何生成以及解释如何与预测变化关联。
核心发现
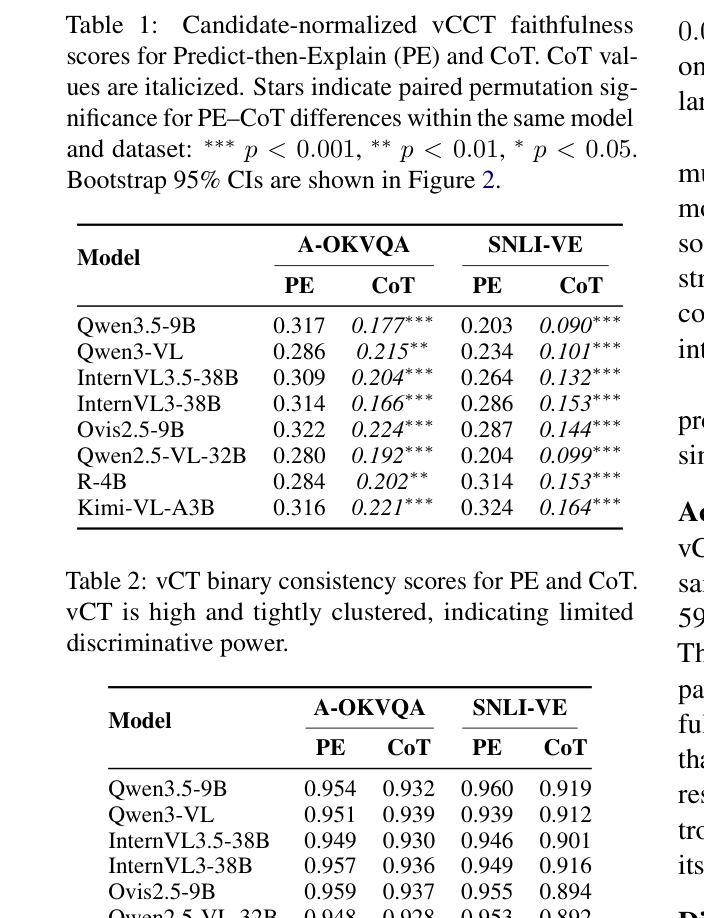
该表报告了PE和CoT在A-OKVQA和SNLI-VE上的vCCT分数。需关注PE与CoT的差异及显著性标记,理解PE策略在解释忠实性上的优势。
意义与局限
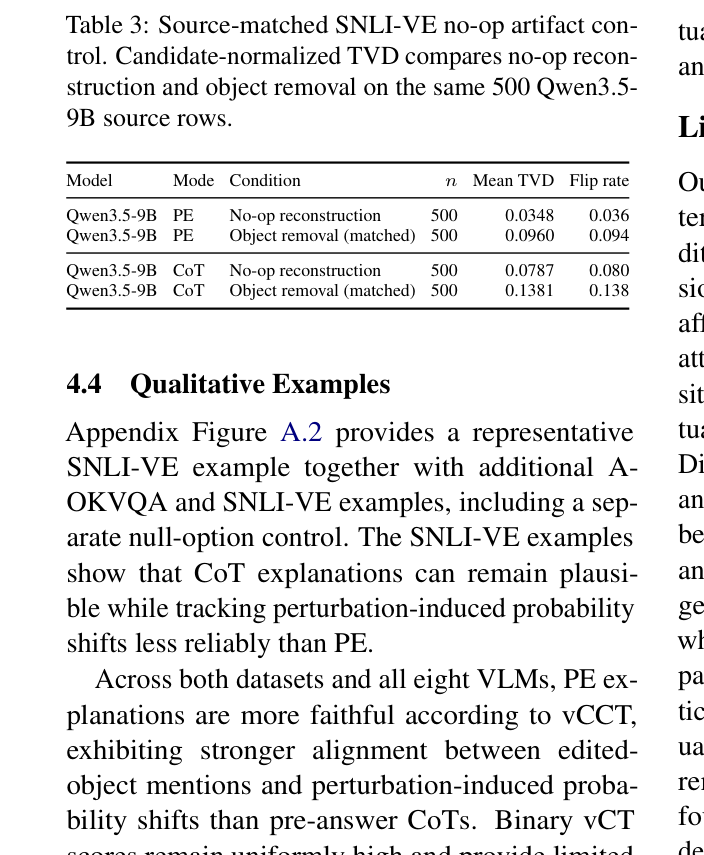
该表比较了No-op重建与对象移除的TVD差异。需关注No-op与对象移除的显著差异,理解该控制实验如何隔离重建伪影的影响。
实验如何设计?
- 数据集:在A-OKVQA和SNLI-VE数据集上进行评估,覆盖视觉问答和视觉自然语言推理任务。
- 模型:对8个开源VLM(如Qwen3.5-9B, InternVL3-38B, Ovis2.5-9B等)进行对比评估。
- 提示策略:对比Predict-then-Explain(PE)和Chain-of-Thought(CoT)两种提示策略。
- 人工审计:对141个样本进行人工审计,验证反事实编辑和变化提及检测的准确性。
- 控制实验:在500个SNLI-VE样本上进行No-op重建与对象移除的对比实验,验证干预的有效性。
关键结果与论文证据
- vCCT结果:在A-OKVQA上,PE的平均vCCT为0.303,CoT为0.200;在SNLI-VE上,PE为0.264,CoT为0.129。PE策略的解释与概率偏移的相关性显著高于CoT(p < 0.001)。
- vCT结果:在A-OKVQA上,PE的平均vCT为0.951,CoT为0.930;在SNLI-VE上,PE为0.949,CoT为0.895。vCT值普遍较高且聚集,区分度有限。
- No-op控制:Qwen3.5-9B在PE策略下,No-op重建与对象移除的TVD差异为0.0612(p < 0.001),表明对象移除引起的预测变化显著大于重建伪影。
- 人工审计:编辑/描述正确率为87.9%,变化提及检测正确率为92.2%,验证了自动化流水线的可靠性。
- 模型差异:不同VLM在vCCT上表现差异显著,但PE策略在所有模型上均优于CoT,表明该发现具有普遍性。
阅读时需要注意
- vCT指标在预测翻转较少时容易饱和,区分度有限,因此主要依赖vCCT进行区分。
- 概率提取基于自回归序列似然归一化,未进行token长度归一化,可能引入校准偏差。
- 自动化流水线存在误差,人工审计显示约12%的编辑或描述错误,且CM检测器基于模型判断,可能继承偏见。
- 目前仅评估了对象移除和初步的颜色变化干预,未涵盖空间关系、动作等更复杂的视觉概念。
关联工作
- Counterfactual Test (CT) (Atanasova et al., 2023):本文方法的基础,将其从文本扩展到视觉领域。
- Correlational Counterfactual Test (CCT) (Siegel et al., 2024):本文vCCT指标的理论基础,通过相关性增强CT的细粒度评估能力。
- EDCT (Ding et al., 2025):类似的VLM反事实测试方法,但本文方法规模更大且引入了vCCT相关性指标。
- Bias Articulation Tests (Chen et al., 2025):另一种评估CoT忠实性的范式,测试模型是否提及已知偏见,与本文的输入干预测试互补。