快速导读:AnimalLift 提出了一种基于共享拓扑和 UV 对齐规范空间的框架,能够从单张图像前馈重建包含显式毛发几何、UV 纹理和可动画网格的 3D 动物资产,并支持下游动画、编辑和物理模拟。
AnimalLift 针对单张图像到 3D 动物重建中缺乏共享拓扑、规范对应关系和可编辑表面参数化的问题,提出了一种基于 UV 对齐规范空间的统一框架。该方法通过前馈网络从单张图像直接预测包含显式毛发几何、UV 纹理和可动画网格的 3D 动物资产,解决了现有隐式场或松散结构表示难以直接用于绑定、动画和标准图形管线的痛点。
与依赖参数化模型或神经渲染的方法不同,AnimalLift 将输入图像提升到一个具有一致拓扑和 UV 参数化的规范空间,使得重建结果天然兼容下游的 rigging、动画和物理模拟。通过程序化生成的合成数据提供对齐监督,该方法在合成和真实数据集上均展现出对几何、纹理和毛发的高保真重建能力,并在专家用户研究中验证了其生产可用性。
英文题目:AnimalLift: Reconstructing Animatable 3D Animals from a Single Image by Learning Canonical Shape, Texture, and Fur Maps
论文出处:arXiv 每日论文精选 · arXiv:2609.09513
原始论文:PDF / 论文页面
这篇论文解决什么问题?
在计算机图形学中,创建高质量可动画动物资产传统上需要大量手动建模、纹理绘制、毛发梳理和绑定工作,成本极高。近期基于神经渲染和生成模型的方法(如 NeRF, DreamFusion, Zero-1-to-3)虽能生成视觉逼真的资产,但输出通常缺乏一致拓扑和密集对应,导致其难以在 Blender 或 Maya 等 DCC 软件中直接复用和编辑。
参数化动物模型(如 SMAL, BITE)提供了结构先验,支持动画,但其低维形式难以捕捉高频细节和复杂的毛发外观。同时,现有的毛发重建方法(如 NeuralFur)多依赖多视图输入,且缺乏与规范表面表示的紧密集成,无法直接支持基于 strand 的物理模拟和精细编辑。
因此,核心研究缺口在于:如何从单张图像前馈重建一个同时具备共享拓扑、UV 对齐纹理、显式毛发几何,且能直接接入生产级 DCC 管线的 3D 动物资产。AnimalLift 正是针对这一缺口,提出了将几何、纹理和毛发统一在规范空间中进行联合建模的解决方案。
核心创新
- 提出了一种 UV 对齐的规范表示,联合建模动物几何、纹理和显式毛发,支持动画兼容的空间结构。
- 设计了统一的 feed-forward 框架,从单张图像重建包含显式毛发的可动画 3D 动物资产。
- 引入了程序化数据生成管线,提供跨不同动物物种和外观的几何、纹理和毛发对齐监督。
方法概览
方法核心是将输入图像提升到一个共享的规范空间(canonical space),该空间具有一致的拓扑和 UV 参数化。架构包含一个部分冻结的 DINOv2 ViT-S/14 编码器,以及三个专用头:顶点偏移头(预测规范网格)、毛发图头(预测 UV 对齐的毛发 strand 几何和密度)和纹理流匹配网络(预测 UV 纹理)。训练数据通过程序化生成管线合成,确保几何、纹理和毛发在规范空间中对齐。
- 共享拓扑与 UV 参数化:方法基于 SMAL 等参数化模型,定义了一个具有固定拓扑和 UV 布局的规范空间,确保不同个体间的顶点、纹理和毛发根点具有严格的对应关系。
- DINOv2 编码器与分支预测:采用部分冻结的 DINOv2 ViT-S/14 作为图像编码器,提取全局和局部特征。随后通过三个专用头分别预测顶点偏移(规范网格)、UV 纹理图和 UV 对齐毛发图。
- UV 对齐毛发图表示:毛发被表示为表面根相对的 3D 偏移 strand 几何,并存储在 UV 纹理空间中。这种表示不仅支持渲染,还直接兼容基于 strand 的物理模拟和 grooming 编辑。
- Flow Matching 纹理合成:纹理预测采用 Flow Matching 生成模型,相较于直接回归,能合成更清晰、高频细节更丰富的 UV 纹理,但增加了推理时的 Euler steps 开销。
- 程序化数据生成管线:通过合成管线生成大量具有对齐几何、纹理和毛发的动物样本,为网络提供跨物种、跨外观的密集监督信号,解决了真实 3D 动物数据稀缺的问题。
- 全局颜色编码器:引入独立的全局颜色编码器,与 DINOv2 特征结合,以更好地捕捉整体色调和光照一致性,提升纹理的真实感。
逐图理解论文
现有方法的痛点
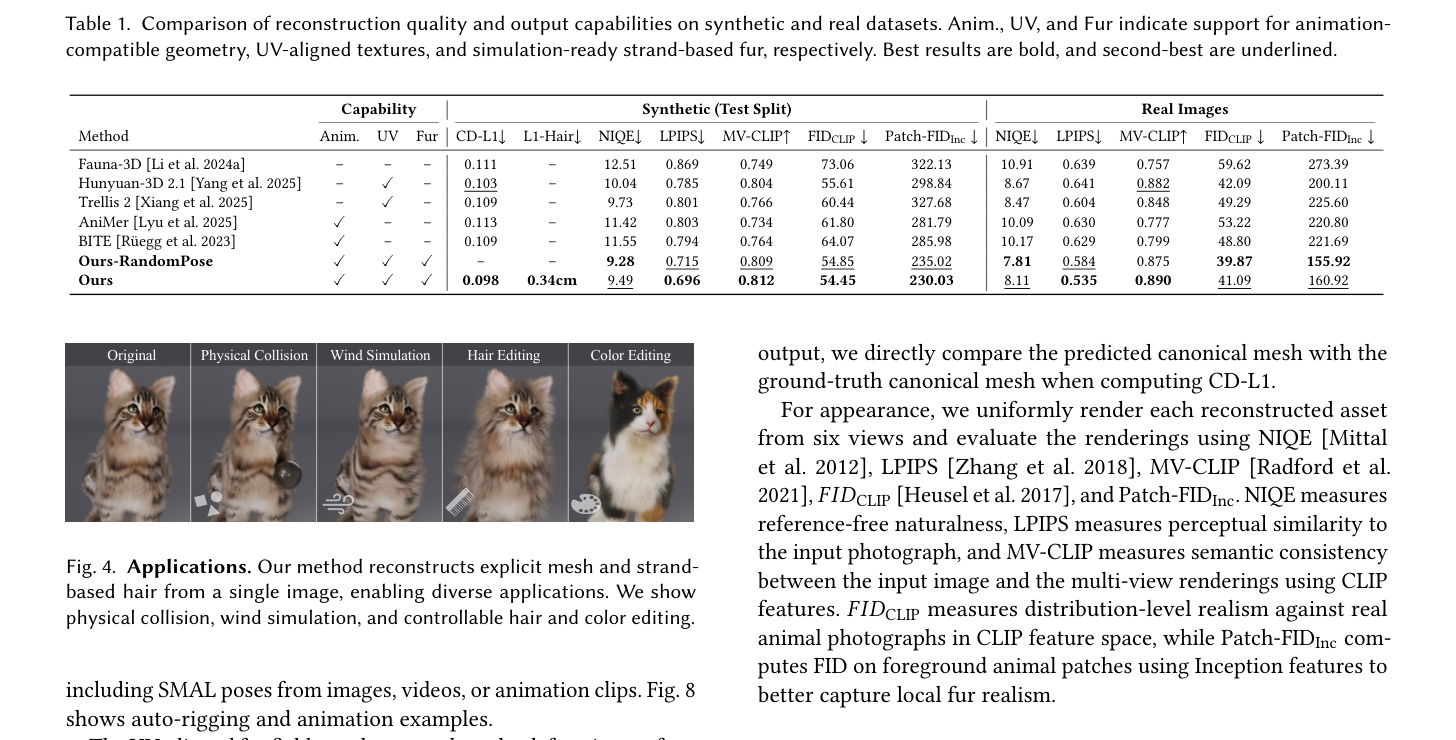
定量比较表。重点对比 AnimalLift 与基线在 Anim., UV, Fur 三个能力维度的支持情况,以及 CD-L1, L1-Hair, Patch-FIDInc 等核心指标。注意 AnimalLift 是唯一同时支持动画兼容几何、UV 纹理和 simulation-ready 毛发的方法。
核心区分与缺口
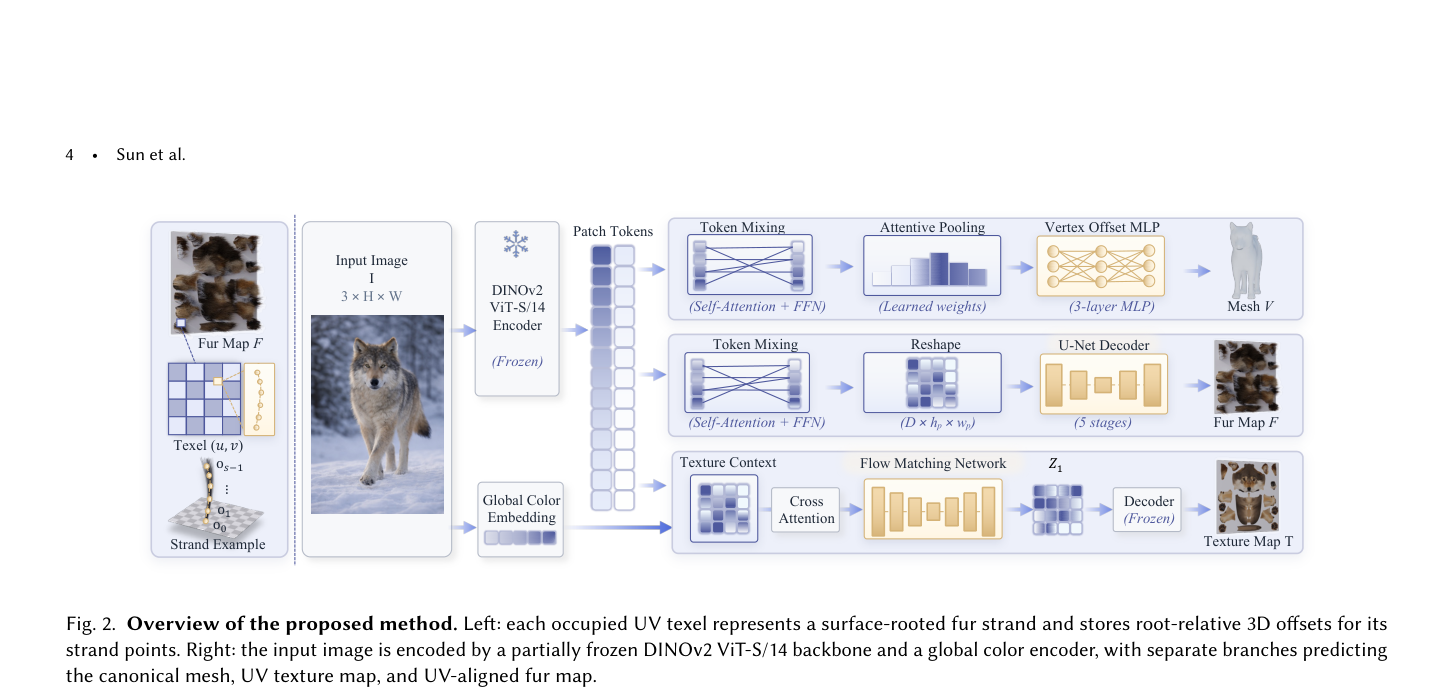
方法架构总览。左侧展示了 UV 对齐毛发图的具体表示,每个 texel 存储 surface-rooted fur strand 的 3D 偏移;右侧展示了 DINOv2 编码器及三个预测分支。需关注毛发图与 UV 纹理的空间对应关系,这是支持后续编辑和模拟的关键。
方法贡献与验证
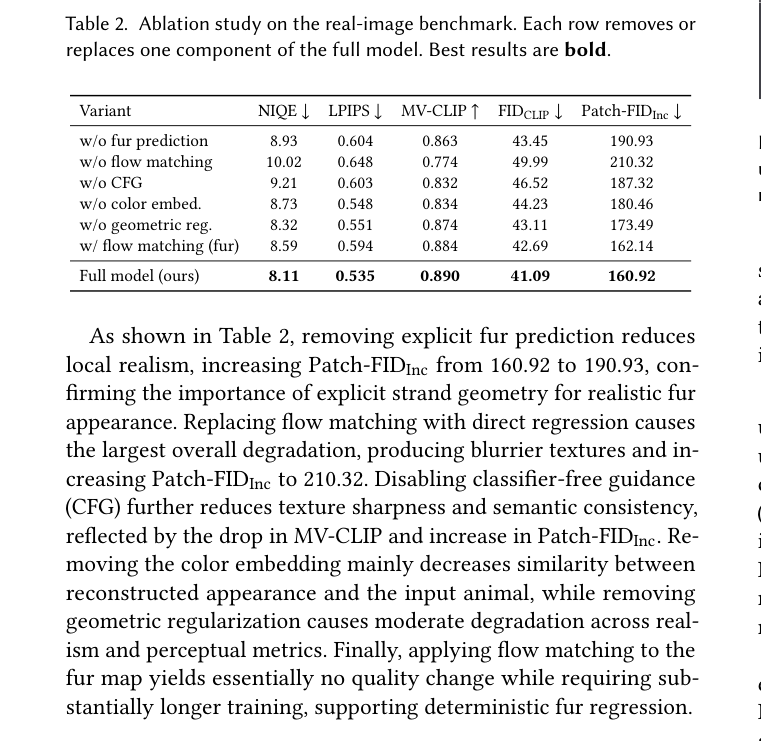
消融实验表。逐行移除毛发预测、Flow Matching、CFG 等组件,观察 Patch-FIDInc 等指标的变化。重点看移除毛发预测和 Flow Matching 后的性能下降幅度,以验证各模块对整体质量的贡献。
实验如何设计?
- 数据集:在合成数据集以及真实数据集 Oxford-IIIT Pet 和 Animals with Attributes 2 上进行评估,涵盖多种动物物种和姿态。
- 基线方法:与 Fauna-3D, Hunyuan-3D 2.1, Trellis 2, AniMer, BITE 等主流单图到 3D 或参数化重建方法进行定量和定性比较。
- 评估指标:使用 CD-L1 评估几何误差,L1-Hair 评估毛发几何误差,NIQE, LPIPS, MV-CLIP, FIDCLIP 和 Patch-FIDInc 评估纹理和毛发的视觉真实感。
- 鲁棒性测试:测试模型在严重输入损坏(亮度、JPEG、噪声、运动模糊)以及不同视角和姿态变化下的稳定性。
- 专家用户研究:邀请专业 3D 艺术家评估资产的生产可用性、清理工作量(静态渲染和行走动画准备)以及可达到的最高质量等级。
关键结果与论文证据
- 在合成数据集上,AnimalLift 取得了 CD-L1 0.098 和 L1-Hair 0.34cm 的几何与毛发误差,显著优于基线方法,证明了规范空间对齐的有效性(Page 6)。
- 在真实图像上,方法在 NIQE (8.11), LPIPS (0.535), MV-CLIP (0.890) 等指标上表现优异,Patch-FIDInc 达到 160.92,表明其生成的毛发和纹理具有极高的局部真实感(Page 6)。
- 消融实验显示,移除毛发预测或 Flow Matching 会导致 Patch-FIDInc 显著上升至 190.93 和 210.32,证实了显式毛发表示和生成式纹理合成对整体质量的关键贡献(Page 8)。
- 在严重输入损坏下,模型的平均 NIQE 为 8.772,LPIPS 为 0.5627,MV-CLIP 为 0.878,表现出对噪声、模糊和光照变化的强鲁棒性(Page 8)。
- 专家用户研究表明,AnimalLift 生成的资产在静态渲染清理上平均耗时 1.7 小时,行走动画准备耗时 1.5 小时,远低于 Hunyuan-3D 2.1 的 3.8 小时和 18.2 小时,大幅降低了生产管线中的手动干预成本(Page 9)。
阅读时需要注意
- 共享拓扑假设限制了跨物种形态差异的捕捉,目前主要适用于四足动物家族,对吻部、耳朵等极端形态变化的适应性有限。
- 重建的是干净的规范毛发,无法表达湿润、脏污或结块等瞬态状态,可能导致生成的个体比真实照片更均匀。
- 单张图像输入存在固有歧义,遮挡区域依赖类别先验补全,可能丢失特定实例的精细身份线索(如疤痕、断毛)。
- 纹理合成使用 Flow Matching 增加了推理步骤,且显式 strand 毛发的存储和计算开销高于隐式表示,在大规模部署时需权衡效率。
关联工作
- SMAL [Zuffi et al. 2017] 提供了基础拓扑和骨架对应关系,是 AnimalLift 规范空间构建的基石。
- BITE [Rüegg et al. 2023] 是基于 SMAL 的可动画几何重建基线,但缺乏纹理和毛发,AnimalLift 在其基础上实现了完整的资产生成。
- Hunyuan-3D 2.1 [Yang et al. 2025] 是通用图像到 3D 方法,支持 UV 但无显式毛发,AnimalLift 在毛发表示和动画兼容性上实现了超越。
- NeuralFur [Sklyarova et al. 2026] 从多视图重建 strand-based 毛发,但缺乏规范表面表示,AnimalLift 将其与单图前馈和 UV 对齐结合,实现了生产级集成。
- DINOv2 [Oquab et al. 2023] 作为共享图像编码器骨干,为 AnimalLift 提供了强大的视觉特征提取能力。