快速导读:本文提出 DUET-DINO,一种通过跨视角注意力机制联合建模侧视和腕视相机观测的潜在世界模型,实现了全 7-DoF 末端执行器动作的零样本目标条件规划,并在多种操作任务中显著优于单视角基线。
DUET-DINO 针对现有潜在世界模型在细粒度动作预测上的不足,提出了一种同时跨视角的世界建模方法。通过联合训练侧视和腕视预测器,该模型能够更准确地捕捉旋转和夹爪动作引起的视觉变化,从而支持全 7-DoF 末端执行器的零样本规划。
与依赖单一外部相机的传统方法不同,DUET-DINO 利用跨视角注意力机制,使每个视角的潜在表示能够查询另一个视角的互补信息。这种设计不仅提升了预测的准确性,还增强了模型在复杂操作任务中的泛化能力,为机器人操作提供了新的技术路径。
英文题目:DUET-DINO: Simultaneous Cross-View World Modeling for Latent Planning in Robot Manipulation
论文出处:arXiv 每日论文精选 · arXiv:2609.10506
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有的动作条件潜在世界模型,如 V-JEPA 2-AC,在预测细粒度空间和平移动作时表现不佳。这些模型通常依赖单一外部相机,难以捕捉由旋转和夹爪动作引起的细微视觉变化,导致其在角度抓取、多目标提升等复杂任务中失败。
潜在世界模型虽然避免了像素重建,计算效率更高,但其单视角局限性在需要精确控制的任务中尤为明显。例如,在角度抓取任务中,单视角模型往往无法准确预测夹爪的旋转状态,导致抓取失败。因此,如何整合多视角信息以提升细粒度动作预测能力,成为当前研究的关键挑战。
此外,现有模型在规划阶段通常仅优化位置信息,忽略了旋转和夹爪状态,限制了其在 7-DoF 空间中的应用。DUET-DINO 通过联合优化双视角潜在滚动轨迹,解决了这一瓶颈,为全 7-DoF 规划提供了可行的解决方案。
核心创新
- 提出 DUET-DINO,一种同时跨视角潜在世界模型,通过跨视角条件化联合训练侧视和腕视预测器,利用互补信息提升规划性能。
- 将潜在世界模型规划扩展到全 7-DoF 末端执行器空间,通过联合优化双视角潜在滚动轨迹实现。
- 发现并验证了预训练潜在表示对动作条件预测的影响:V-JEPA 2 低估腕视视觉变化,而 DINOv3 更好地捕捉细粒度运动。
- 在 RoboLab 模拟器中引入了空间多样化、角度密集和多目标操作任务,以暴露潜在世界模型在 7-DoF 预测上的瓶颈。
方法概览
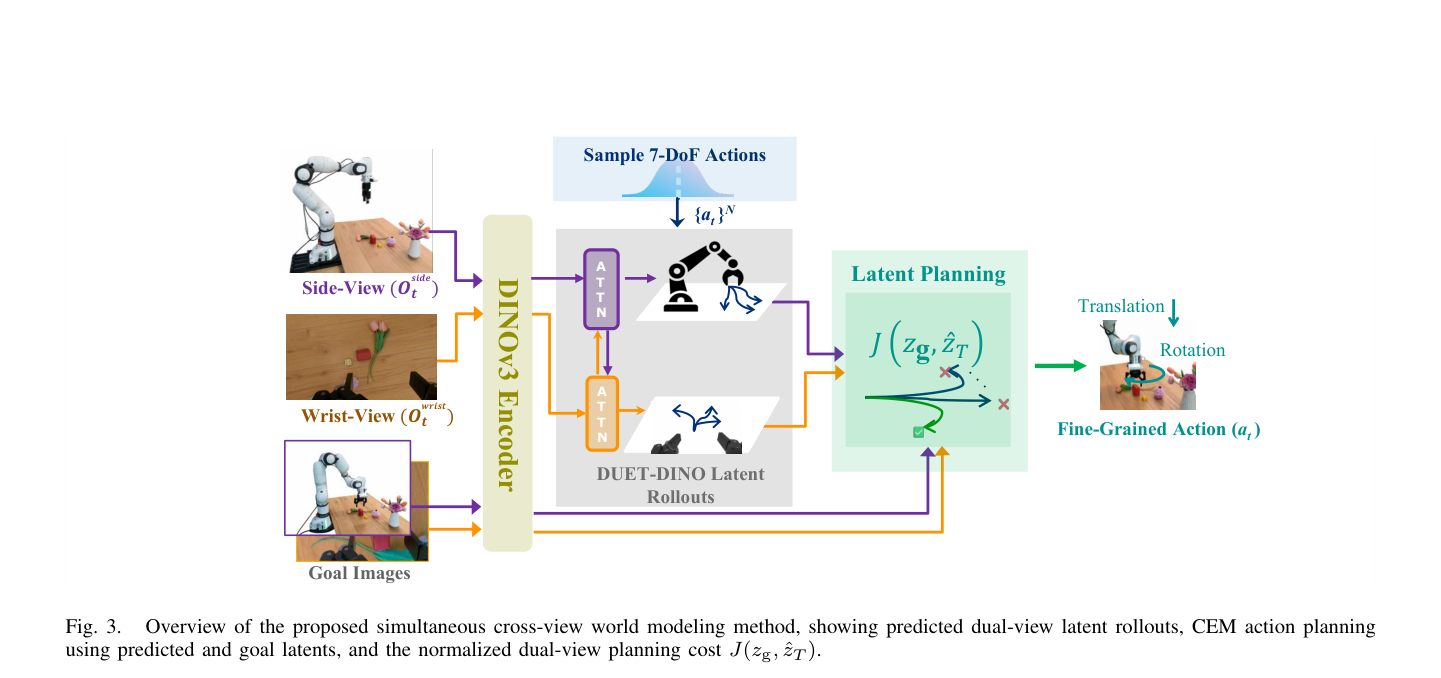
DUET-DINO 使用冻结的 DINOv3 编码器将侧视和腕视图像映射到潜在空间。通过可学习的跨注意力块,每个视角的潜在表示查询另一个视角的互补信息。随后,视角特定的预测头基于动作和末端执行器状态预测未来潜在表示。训练采用教师强制损失和自回归滚动损失。规划阶段使用 CEM 算法,通过最小化双视角归一化目标成本来优化全 7-DoF 动作序列。
- 使用冻结的 DINOv3 编码器将侧视和腕视图像映射到潜在空间,确保特征提取的稳定性和高效性。
- 引入可学习的跨注意力块,使每个视角的潜在表示能够查询另一个视角的互补信息,增强特征表达能力。
- 设计视角特定的预测头,基于动作和末端执行器状态预测未来潜在表示,实现细粒度动作条件预测。
- 采用教师强制损失和自回归滚动损失进行训练,确保模型在单步预测和多步滚动预测中均表现稳定。
- 在规划阶段使用 CEM 算法,通过最小化双视角归一化目标成本来优化全 7-DoF 动作序列,提升规划精度。
- 引入空间多样化、角度密集和多目标操作任务,以暴露潜在世界模型在 7-DoF 预测上的瓶颈,验证方法的有效性。
逐图理解论文
失败案例
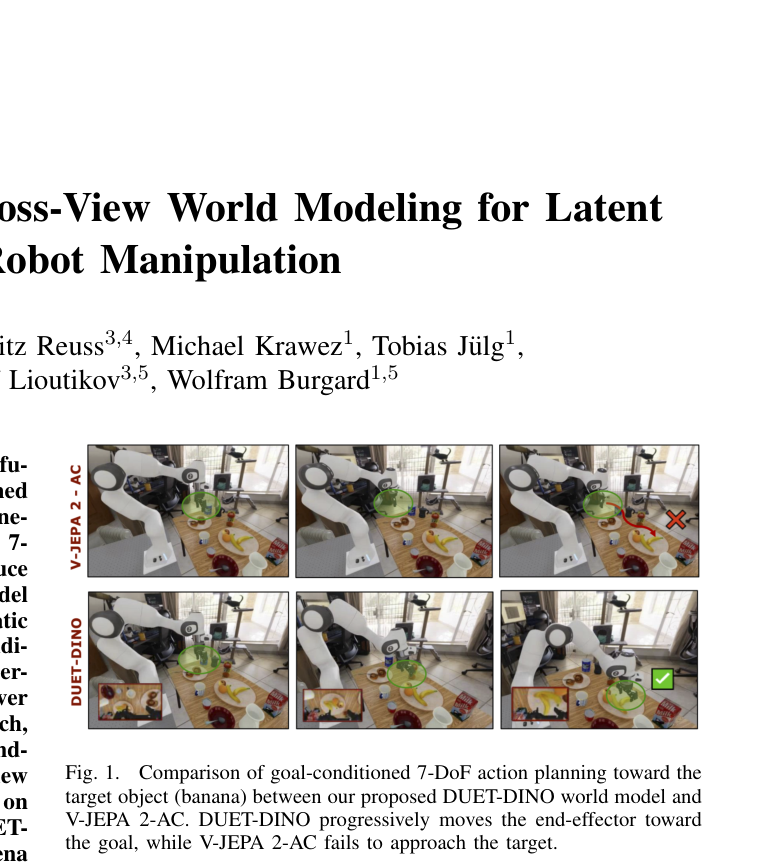
该图对比了 DUET-DINO 和 V-JEPA 2-AC 在目标条件 7-DoF 动作规划中的表现。DUET-DINO 逐步将末端执行器移向目标,而 V-JEPA 2-AC 未能接近目标,直观展示了跨视角建模的优势。
研究缺口
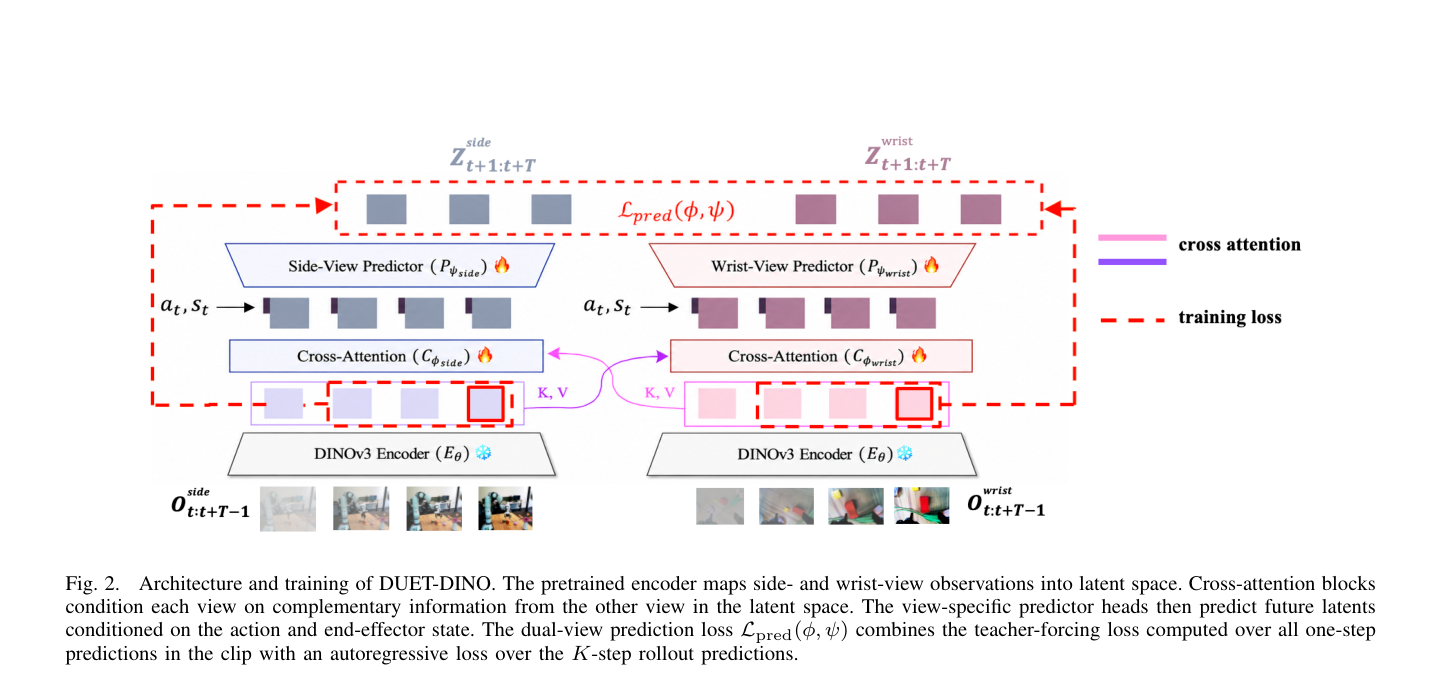
该图展示了 DUET-DINO 的架构和训练过程。预训练编码器将侧视和腕视观测映射到潜在空间,跨注意力块条件化每个视角,视角特定预测头预测未来潜在表示,双视角预测损失结合教师强制损失和自回归损失。
关键发现
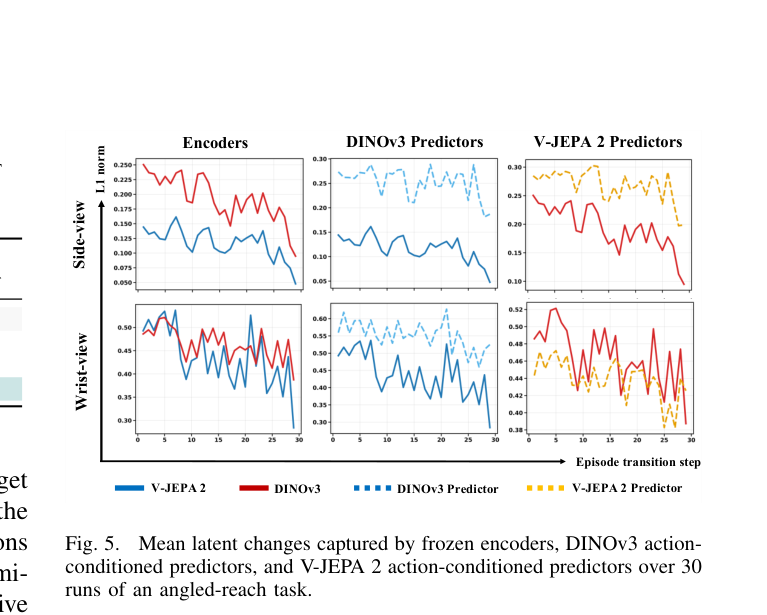
该图展示了冻结编码器、DINOv3 动作条件预测器和 V-JEPA 2 动作条件预测器在角度抓取任务中捕获的平均潜在变化,验证了 DINOv3 在捕捉细粒度运动上的优势。
实验如何设计?
- 在 RoboLab 模拟器中评估了 Reach、Angled-Reach 和 Lift 任务,对比了单视角、独立双视角和 DUET 双视角模型。
- 在真实 DROID 机器人硬件上进行了 Angled-Reach 任务评估,测试了模型在真实环境中的泛化能力。
- 进行了消融实验,验证了跨注意力块的重要性,并分析了不同预训练编码器对预测性能的影响。
- 评估了模型在视觉分布偏移和相机姿态扰动下的鲁棒性,确保其在复杂环境中的可靠性。
关键结果与论文证据
- DUET-DINO 在 Reach 任务中取得了 92% 的成功率,显著优于单视角基线(第 5 页)。
- 在 Angled-Reach 任务中,DUET-DINO 的成功率为 72.5%,而单视角模型仅为 45%(第 6 页)。
- 在 Lift 任务中,DUET-DINO 的成功率为 60.0%,展示了其在多目标提升任务中的优势(第 7 页)。
- 消融实验表明,移除跨注意力块后,模型在 Angled-Reach 任务中的成功率下降了 15%(第 7 页)。
- DINOv3 编码器在捕捉细粒度运动上优于 V-JEPA 2,导致 DUET-DINO 在角度预测上更准确(第 7 页)。
阅读时需要注意
- CEM 规划计算成本高,每次规划步骤需要 15-17 秒,限制了实时控制能力。
- 硬件实验中的成功率低于模拟环境,部分原因是为了安全减少了 CEM 迭代次数和候选动作数量。
- 模型主要依赖 DINOv3 编码器,虽然性能更好,但计算资源需求较高。
关联工作
- V-JEPA 2-AC 是主要基线,单视角潜在世界模型,本文指出其在细粒度动作预测上的不足。
- DINO-WM 基于 DINOv2 的潜在世界模型,证明了冻结编码器特征可用于零样本规划,本文使用 DINOv3 作为编码器。
- DINOv3 是本文使用的预训练视觉编码器,相比 V-JEPA 2 更好地捕捉细粒度动作条件动态。
- RoboLab 是本文用于评估的高保真模拟器,提供了多样化的背景和任务设置。
- DROID 是大规模机器人操作数据集,本文用于训练世界模型。