快速导读:本文提出 OmniKVQuant,一种针对多模态大语言模型(Omni-LLM)的免训练 KV 缓存量化框架,通过局部时间范围自适应和模态感知值旋转,在 2-bit 精度下显著优于 TurboQuant。
Omni-LLM 同时处理音频、视频和文本,KV 缓存内存开销巨大。现有量化方法如 TurboQuant 基于文本 LLM 设计,未考虑多模态特性,导致量化误差大。
本文提出 OmniKVQuant,一种免训练 KV 缓存量化框架。通过局部时间范围自适应和模态感知值旋转,在 2-bit 精度下显著优于 TurboQuant,并融合 Triton 解码内核提升效率。
英文题目:OmniKVQuant: KV Cache Quantization for Omni-LLMs
论文出处:arXiv 每日论文精选 · arXiv:2609.11582
原始论文:PDF / 论文页面
这篇论文解决什么问题?
Omni-LLM 的 KV 缓存包含音频、视频和文本,分布特性复杂。TurboQuant 使用随机 Hadamard 旋转和固定码本,但多模态场景下键的局部方差显著低于高斯分布,且不同模态的值占据特征空间不同区域。
具体表现为:1) 键分布存在局部时间漂移,固定量化范围无法适应;2) 值几何结构具有模态异质性,共享旋转矩阵无法有效捕捉不同模态的特征分布。
核心创新
- 首次提出针对 Omni-LLM 的 KV 缓存量化方法,识别并解决了键的时间漂移和值的模态异质性问题。
- 引入局部时间范围自适应机制,动态调整键的量化范围以匹配局部统计特性。
- 设计模态感知的值旋转策略,为不同模态定制旋转基,提升量化精度。
- 开发融合 Triton 解码内核,优化低比特 KV 缓存的注意力计算效率。
方法概览
OmniKVQuant 包含两个核心模块:1) Temporal Range Adaptation:对键向量在短窗口(如 32 token)内进行 min-max 缩放,以适配局部时间漂移,同时保持固定码本不变;2) Modality-aware Value Rotation:为每种模态(文本、音频、视频)单独校准旋转矩阵,基于注意力贡献加权计算协方差矩阵并进行特征分解,以匹配各模态的值几何结构。此外,提供融合 Triton 解码内核,在注意力计算中直接解包 2-bit 缓存,避免重建密集 FP16 缓存。
- Temporal Range Adaptation:对键向量在短窗口(如 32 token)内进行 min-max 缩放,适配局部时间漂移,保持固定码本不变
- Modality-aware Value Rotation:为每种模态单独校准旋转矩阵,基于注意力贡献加权计算协方差矩阵并进行特征分解
- 融合 Triton 解码内核:在注意力计算中直接解包 2-bit 缓存,避免重建密集 FP16 缓存
- 免训练设计:无需额外训练,直接应用于现有 Omni-LLM 模型
- 模态感知校准:使用 VGGSound 数据集进行值旋转校准,匹配各模态的值几何结构
- 局部统计特性:动态调整量化范围,匹配局部时间窗口的统计特性
- 特征空间匹配:通过模态特定旋转基,提升不同模态值的量化精度
- 解码效率优化:融合内核减少内存访问,提升低比特 KV 缓存的注意力计算效率
逐图理解论文
模态分布差异
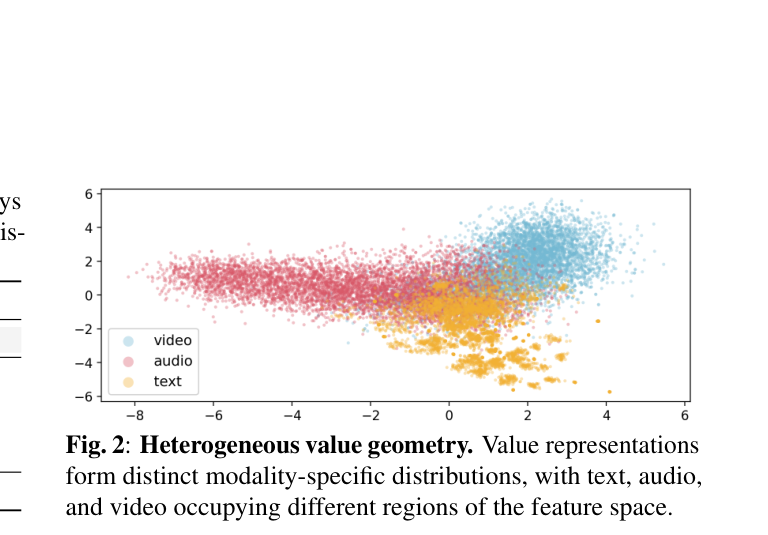
该图以二维散点图展示视频、音频、文本三种模态在特征空间中的分布,三类数据点明显分离并各自聚集。观察该图可以理解 Omni-LLM 的多模态值分布几何高度异质,统一旋转难以同时适配所有模态,这正是本文提出模态感知值旋转的动机。
研究空白
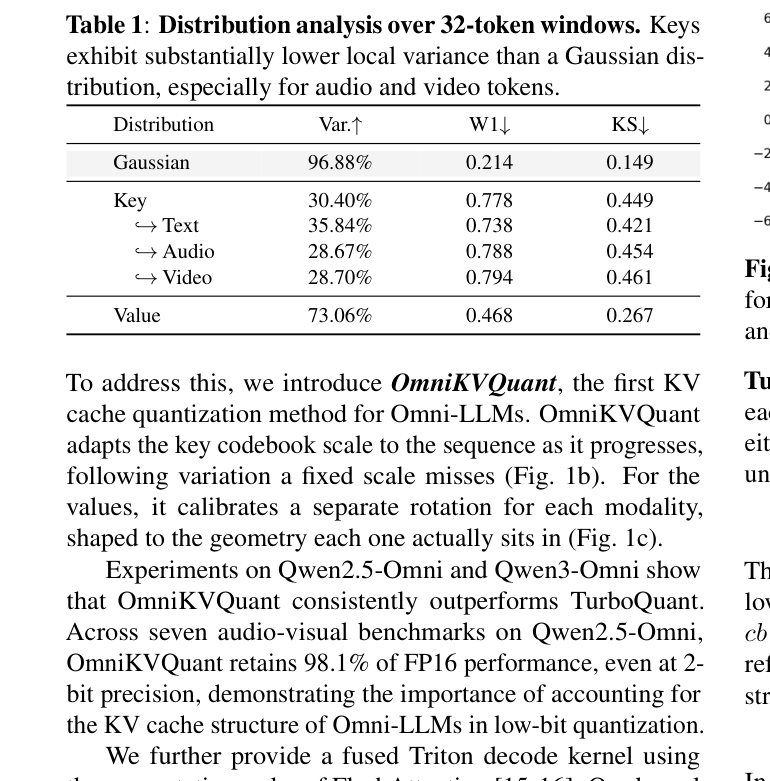
现有方法未考虑 Omni-LLM 中音频、视频和文本混合缓存的特性。具体表现为:键分布存在局部时间漂移,固定量化范围无法适应;值几何结构具有模态异质性,共享旋转矩阵无法有效捕捉不同模态的特征分布。
核心贡献
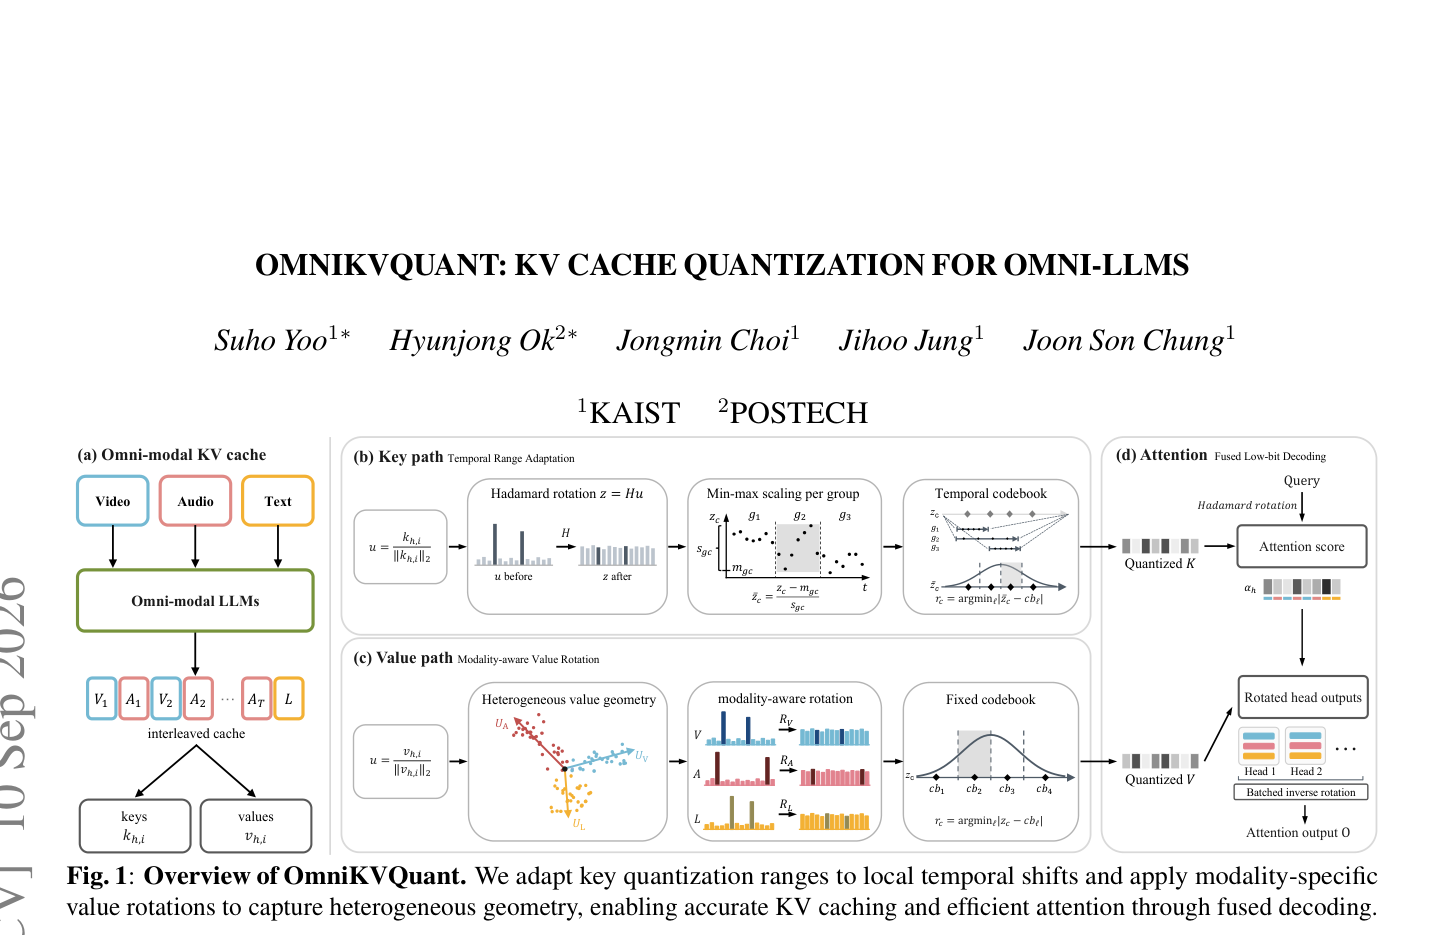
该图展示了 OmniKVQuant 的整体架构。重点观察局部时间自适应和模态感知旋转模块如何协同工作,以及融合解码内核如何优化注意力计算。
旋转策略对比
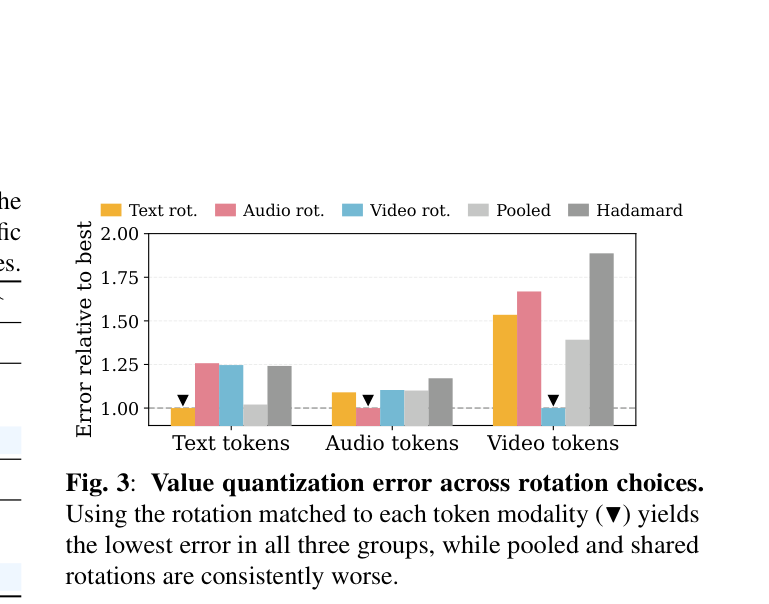
该图展示了不同旋转选择下的值量化误差。重点比较模态匹配旋转、池化旋转和共享旋转的效果,理解模态感知旋转的优势。
核心结论
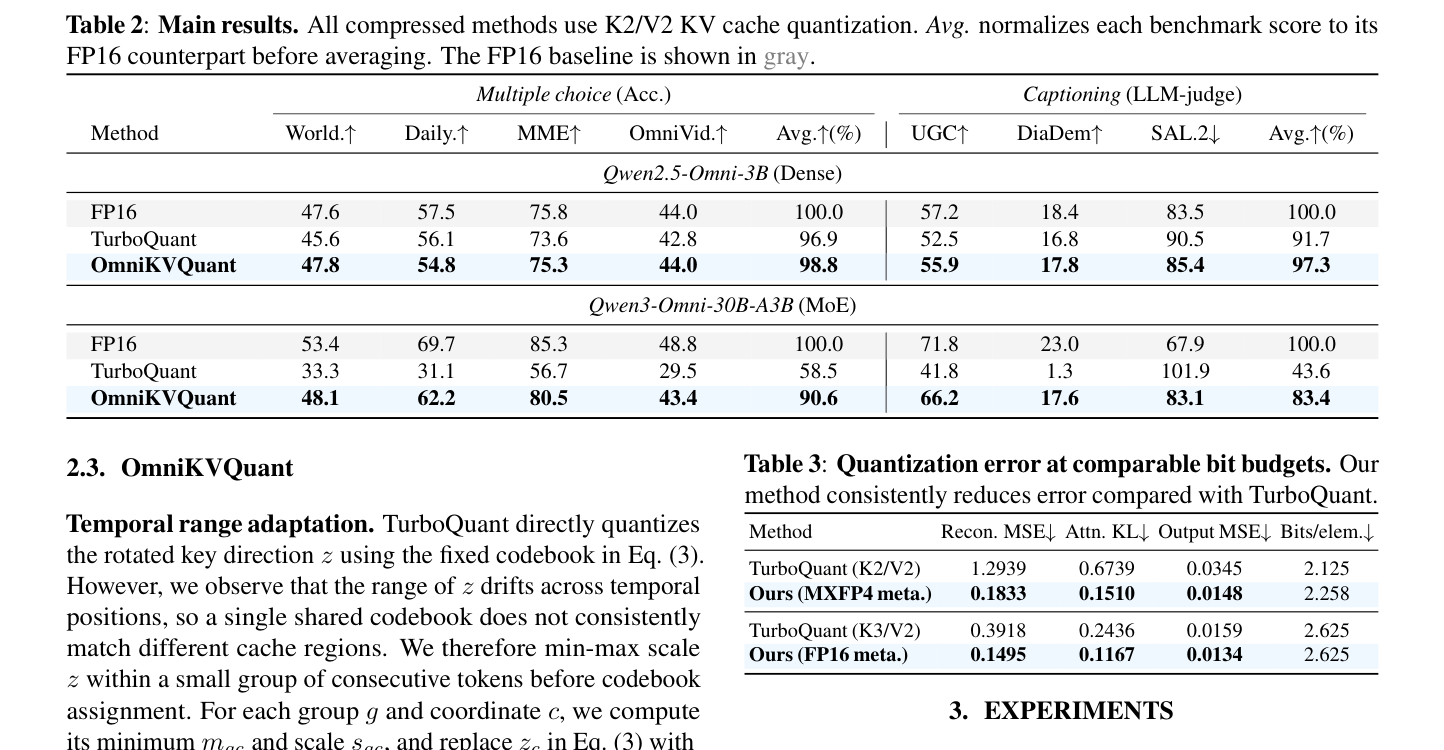
该表展示了主要实验结果。重点比较 OmniKVQuant 和 TurboQuant 在 2-bit 量化下的性能差异,以及不同基准测试上的表现。
实验如何设计?
- 模型:Qwen2.5-Omni-3B 和 Qwen3-Omni-30B-A3B
- 基准测试:WorldSense, DailyOmni, Video-MME, OmniVideoBench, UGC-VideoCap, DiaDem, video-SALMONN2
- 对比基线:FP16 和 TurboQuant(K2/V2 量化)
- 量化精度:2-bit 和 4-bit
- 评估指标:Multiple-choice 和 Captioning 任务性能
- 分析实验:量化误差对比、组件消融、不同比特宽度性能测试
关键结果与论文证据
- Qwen2.5-Omni-3B: OmniKVQuant 在 Multiple-choice 任务上保留 98.8% FP16 性能,Captioning 任务上保留 97.3%,显著优于 TurboQuant (96.9% / 91.7%)
- Qwen3-Omni-30B-A3B: OmniKVQuant 在 Multiple-choice 任务上保留 90.6% FP16 性能,Captioning 任务上保留 83.4%,而 TurboQuant 仅保留 58.5% / 43.6%
- 量化误差对比 (WorldSense, K2/V2): OmniKVQuant 的 Recon. MSE 为 0.1833,Attn. KL 为 0.1510,Output MSE 为 0.0148,均低于 TurboQuant (1.2939 / 0.6739 / 0.0345)
- 消融实验显示,局部键范围自适应带来最大提升,模态感知值旋转进一步改善性能
- 不同比特宽度下,OmniKVQuant 从 2-bit 到 4-bit 均一致优于 TurboQuant
- 模态感知旋转在三种模态组中均产生最低量化误差
- 局部时间自适应对键量化误差的降低效果显著
- 融合 Triton 内核在保持精度的同时提升解码效率
阅读时需要注意
- 实验主要基于 Qwen 系列 Omni-LLM,未验证其他架构模型的泛化性
- 值旋转校准需要 VGGSound 数据集,可能引入额外计算开销或数据依赖
- 评估样本长度限制在一分钟以内,未测试超长序列场景
- 局部时间范围自适应需要存储 min-max 元数据,可能增加少量内存开销
- 模态感知旋转需要预先校准,若新模态或分布偏移较大,可能需要重新校准
关联工作
- TurboQuant:基线方法,使用随机 Hadamard 旋转和固定码本进行 KV 量化,但未考虑多模态特性
- MASQuant:针对多模态 LLM 的量化方法,但主要关注权重和激活值,而非 KV 缓存
- FlashAttention:提供高效注意力计算范式,本文融合内核借鉴其计算顺序以优化解码效率