快速导读:DRT 把多模态推理改成视觉证据与符号演绎分离的稠密轨迹,再用 Trace-Grounded GRPO 在短预算里压幻觉。
多模态大模型一旦学会链式思维,输出就会迅速变长:先复述题目、再自我打气、再猜图上没有的前提。哈尔滨工业大学与字节跳动 FIS 的 DRT(Dense Reasoning Trace)认为,根因不是“想得不够久”,而是推理仍被锁在自然语言表达空间。语言脚手架会稀释关键结论,模型也更容易盯着自己刚生成的句子,而不是图像证据。项目与代码宣称在 https://github.com/HIT-leaderone/DRT。
DRT 把推理重写成三段标签:<visual> 只收物体属性、空间关系和数量等证据;<think> 先抛 [Priors] 再做符号化状态转移;<answer> 给短结论。训练分两阶段。Dense Trace Initialization 把 Vision-R1-Cold 中 Mulberry 子集的长轨迹改写成稠密格式并监督微调 Qwen3-VL-8B-Instruct。随后用三视角核对构造 DRT-RL 数据,做 Trace-Grounded GRPO。作者相对该基座的官方提示报告 5.5× token 效率,宏平均准确率高 1.3 点;对比的是 Qwen-Standard,不是更长也更准的 Qwen-Thinking。
英文题目:DRT: Dense Reasoning Trace for Efficient and Grounded Multimodal Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2609.21675
原始论文:PDF / 论文页面
这篇论文解决什么问题?
链式思维在文本推理上很有效,迁到多模态后出现两类病变。一是信息稀释:为了把话说顺,模型生成大量对解题无贡献的填充。二是视觉脱锚:轨迹越长越自指,幻觉被自己的文本放大。Figure 1(A) 的三棱柱表面积就是例子:Qwen3-VL 把图上棱柱高 16 cm 误当成三角形高,用近五千 token 算出错误的 960;DRT-RL 用一百多个 token 得到 608。
已有加速工作大多仍在同一语言空间里打补丁。训练免费的做法包括显著视觉 token 选择、早停、短提示;训练类做法包括自适应跳 token、预算估计和路径选择。CoD 把每步压成草稿,ThinkLess 用结束标签截断,VisionThink 压缩视觉输入。DRT 认为这些都没有改表达空间,准确率-效率曲线就被卡住。
因此需要同时成立的两件事:中间状态必须短且可核对;视觉观察不能和逻辑猜测写在同一段散文里。
核心创新
- 把推理从自然语言 CoT 改成带符号连接的稠密轨迹,并把观察与演绎拆开。
- Dense Trace Initialization:把长 CoT 改写成 DRT 格式再 SFT,让模型先学会短轨迹。
- Trace-Grounded GRPO:用核对过的逐步轨迹做过程监督,在紧 token 预算里压幻觉、加深有效步。
方法概览
DRT 把输出拆成 <visual> 证据集、<think> 带 [Priors] 的符号状态转移、<answer> 结论。Dense Trace Initialization:从 Vision-R1-Cold 的 Mulberry 子集改写约二十万条多模态样本,用 GPT-5.1 做分解-压缩后 SFT。Trace-Grounded RL:三视角核对(答案对、中间逻辑一致、视觉忠实)筛 DRT-RL 数据,再做 Trace-Grounded GRPO,奖励含格式、逐步过程分、探索步奖励。训练先 SFT 再 RL。
- 表示:<visual> 汇总对象属性、空间关系、计数与时间线索,作为后续演绎的锚。<think> 以 [Priors] 注入公式或常识,再用箭头连接的高信息状态转移,而不是完整句子。<answer> 只给最终结果。
- Dense Trace Initialization:从约二十万条多模态指令改写 DRT-SFT。流水线是分解成视觉、演绎、答案三块,丢掉 Verbose,再压成符号轨迹。教师是 GPT-5.1。SFT 峰值学习率 6.0e-6,最多两千步,约第八百步早停。
- DRT-RL 数据:教师采样多条轨迹,再由 GPT-5.1 做严格核对,只留最终答案正确、中间逻辑自洽、视觉忠实的轨迹,作为逐步参照。
- Trace-Grounded GRPO:策略与参照都从 DRT-SFT 初始化。格式奖励检查三段标签是否齐全。主奖励按逐步是否匹配参照给分,幻觉与错配扣分。探索步奖励鼓励非平凡有效步,避免过早收敛到很短但空的链。过程评判另用 Qwen3-235B-A22B-Instruct。
- RL 学习率 1.0e-6、batch 512、二百步。作者强调:只做提示版 DRT 仍比训练后的短轨迹长数倍,说明格式要靠训练内化。
逐图理解论文
失败直觉
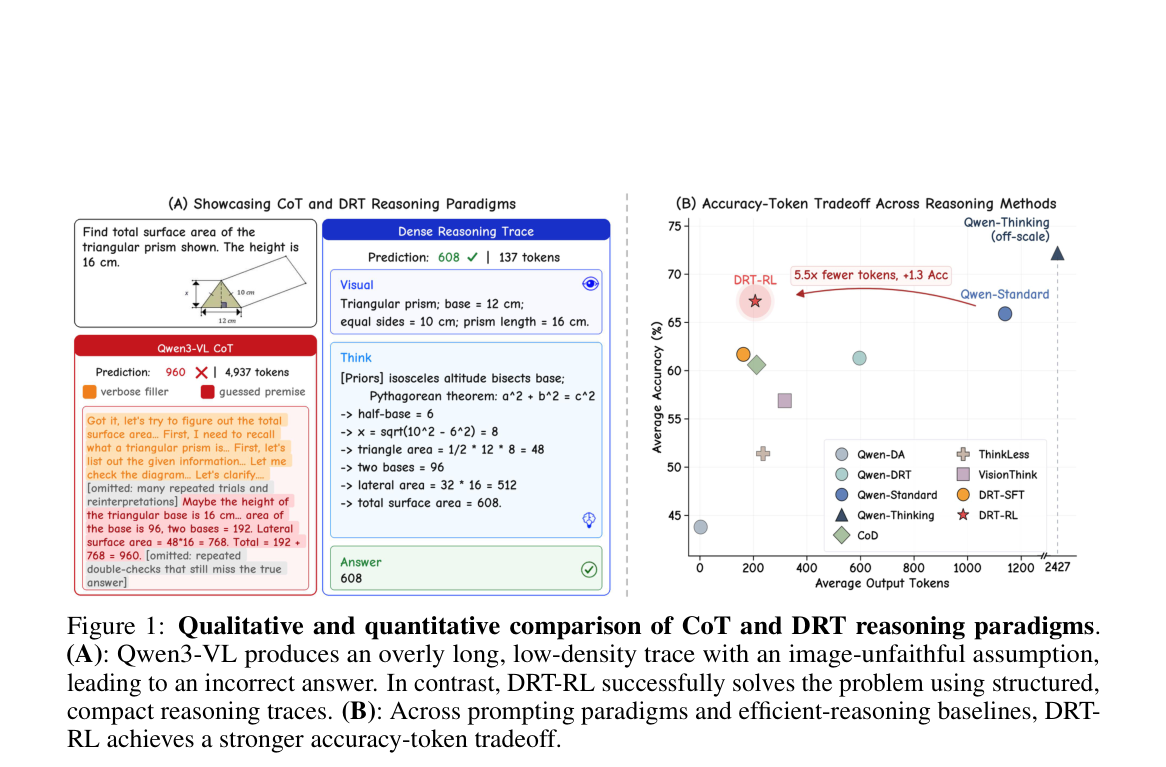
左栏同一道三棱柱表面积:红框 CoT 把 16 cm 误当三角形高,预测 960;蓝框 DRT 在 Visual 里记下底 12、腰 10、棱长 16,Think 用勾股得到高 8,答案 608。右栏散点请只读从 Qwen-Standard 指向 DRT-RL 的 5.5x fewer tokens, +1.3 Acc,不要把轴外的 Qwen-Thinking 三角当成该倍数的分母。单题 608 不能代替表一宏平均。
方法贡献
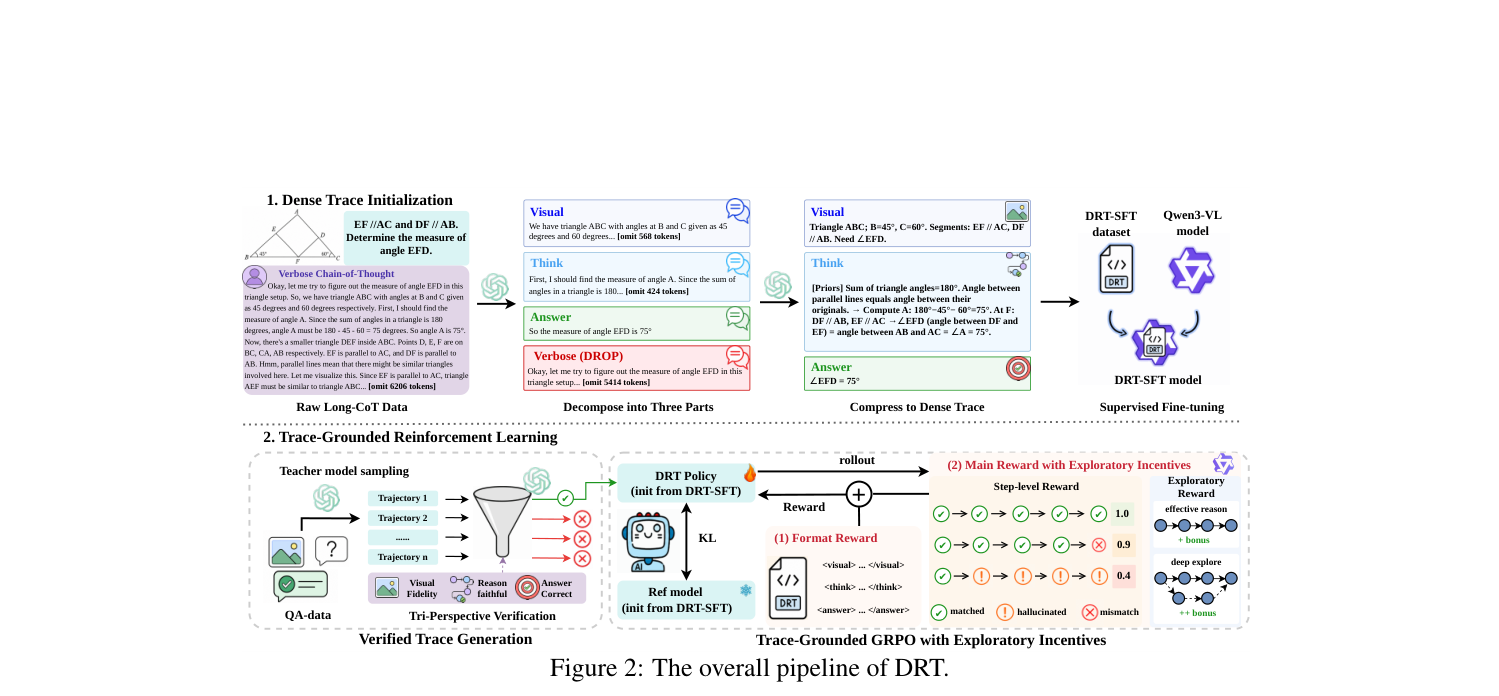
上半是 Dense Trace Initialization:长 CoT 先拆成 Visual/Think/Answer,Verbose 被 DROP,再压成 [Priors] 短链,SFT 到 DRT-SFT。下半是 Trace-Grounded RL:漏斗做视觉忠实、逻辑忠实、答案正确三核对,再对策略做格式奖励与逐步奖励,探索步给 bonus。这张是方案图。上半例题求 ∠EFD,与图一不是同一题。
关键机制
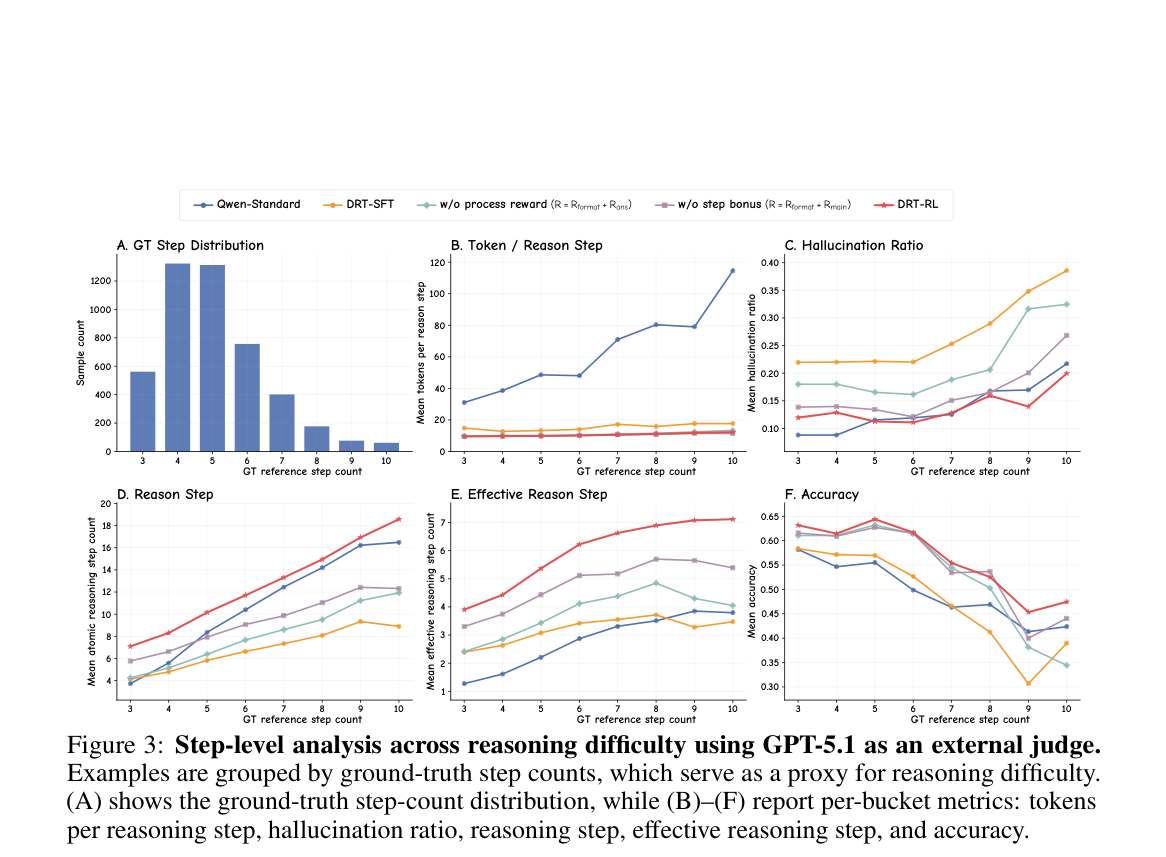
六张分桶图,横轴是参考轨迹步数。先看 (B) 蓝线每步 token 飙升而 DRT 平坦,再看 (C)(E)(F):SFT 幻觉高、有效步少;红线 DRT-RL 有效步和准确率更好。评判是 GPT-5.1,不要把某一桶的点读成表一的 67.2。
实验如何设计?
- 基准:MathVista、MathVerse、LogicVista 看视觉数理逻辑;GSM8K 看纯文本有没有被写坏;Video-Holmes 看出分布视频。指标是准确率、平均输出 token、QPS 与延迟。
- 提示对照都在 Qwen3-VL-8B-Instruct 上:直接答、官方提示、只改 DRT 提示、以及 Thinking。效率对照含 CoD、ThinkLess(作者实现里最大输出三百 token)、VisionThink 官方权重。
- Table 2 消融 SFT 初始化、RL 数据是否含文本、答案级奖励对逐步奖励与步奖励。Figure 3 在四千六百余条带参考步的子集上,用 GPT-5.1 按步数分桶。Figure 4 是 MathVerse 几何行为案例。
关键结果与论文证据
- Table 1(第 7 页):DRT-RL 宏平均 Acc 67.2、Tokens 206.9、QPS 6.91、延迟 11.62;Qwen-Standard 为 65.9 / 1139.8 / 1.49 / 57.34。这就是正文和 Figure 1(B) 所写的 5.5× token 效率与 +1.3 准确率,分母是官方提示而不是 Thinking。
- Qwen-Thinking 宏平均 72.2 / 2427.2,准确率更高、轨迹更长,不能写成 DRT 全面超过同系列上界。MathVerse 上 Thinking 74.2,DRT-RL 64.3,差距更明显。Video-Holmes 上 DRT-RL 43.7,仅略高于 Standard 的 39.6。
- DRT-SFT 已把宏平均 token 降到 162.6,但准确率 61.7 低于 Standard。Qwen-DRT 只提示不训练,token 仍有 596.0。CoD 60.6/211.8,ThinkLess 51.4/235.9,VisionThink 56.9/317.1,短但更不准。
- Table 2(第 8 页):VisionR1-cold 初始化即使加上全套奖励,token 仍约 626;DRT-SFT 加答案级奖励会掉到 64.5 分。完整逐步奖励加步奖励才到 67.2/206.9。纯图 RL 在 LogicVista 上更弱。
- Figure 3:Qwen-Standard 每步 token 随难度陡升;DRT 各变体每步长度平坦。SFT 单独抬幻觉、砍有效步;去过程奖励无法修;逐步奖励降幻觉,步奖励把有效步和难例准确率拉回来。Figure 4:同一道几何题上,长 CoT、压缩草稿、预算截断和错误切线前提都猜 C 或放弃,DRT-RL 重读 Q 与直线 L 的关系后得到 s²=8、选项 B。
阅读时需要注意
- 附录 F 写明:当前 DRT 是顺序链,没有图状分支或依赖感知探索。
- 相对 Qwen-Thinking 仍以准确率换长度;OOD 视频提升有限。
- 数据改写与逐步评判依赖很大的教师和奖励模型,复现贵。
- ThinkLess 预算与 VisionThink 权重和本文训法不完全同条件。预印本未评审。
关联工作
- DeepSeek-R1 展示结果奖励可以诱导长推理;DRT 把监督改到逐步贴参照轨迹。
- CoD、ThinkLess、VisionThink 代表仍在语言或输入侧省 token 的路线,是 Table 1 的效率对照。
- Vision-R1-cold 的 Mulberry 子集提供可改写的长轨迹。Qwen3-VL 是基座与官方提示对照。