快速导读:GAE 把冻结几何基础模型的多层特征重参数化成一个紧凑隐变量,使标准条件流能从同一状态解出彩色视图以及深度、射线和点图。
逼真的单帧并不保证它们来自同一个持久场景。几何基础模型已经能从少量真实视图读出深度、相机和统一坐标系下的点图,视频生成器却经常交出几何漂移、轨迹偏离指定路径的画面。香港科技大学、腾讯 ARC Lab、香港大学与德州大学奥斯汀分校的论文 GAE 把问题追到生成器所演化的隐空间:像素 VAE 保存外观,表示自编码器组织语义,但深度、相机和跨视角关系都不是这个状态里可直接读取的量。
GAE 不把几何当成外观码旁边的额外输出,而是把冻结几何基础模型 DA3 的多层特征重参数化成一个紧凑、可流匹配的隐变量。该隐变量既能被冻结的 DPT 头读成深度、射线和点图,也能被另一个学习到的头解成 RGB。标准 DiT 条件流只演化目标视角的这个状态,参考帧、度量相机射线和文本作为控制。受控比较里,换上 GAE 后 RealEstate10K 与 DL3DV 的 FVD 相对最强竞争隐空间下降 12.7% 和 23.1%,RealEstate10K 上的相机轨迹误差大约减半。
英文题目:GAE: Learning a Geometry-Native Latent Space for 3D-Consistent World Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.24981
原始论文:PDF / 论文页面
这篇论文解决什么问题?
世界模型若要作为可交互的场景基础,生成帧必须描述一个持续存在的三维场景,而不是一串各自合理的图像。感知模型已经能把多视图收成一致几何;生成模型却仍在“写”这个几何上失败。作者把原因放在表示而不是只放在网络容量:隐状态决定哪些结构可以直接交给生成器,哪些必须从外观里推断(第2页)。
现有几何感知生成大多仍以外观为主状态。新视角合成重建辐射场或高斯,相机可控视频用轨迹条件或位置编码,也有工作同时输出深度或法线,或把视频特征对齐到几何、用几何奖励做后训练。这些设计里,几何是控制、模态、辅助表示或损失。GAE 要求被演化的唯一状态来自几何基础模型(第3页)。
直接拿几何基础特征来生成也不顺。DA3 的解码依赖多层特征:浅层保留细节和跨视角对应,深层提供解码头需要的互补输入,但诊断显示更深层并不更有语义或空间结构。单层虽有 3072 通道,有效秩只有大约 11,条件数从 10^8 量级到 10^16 量级,大部分通道近乎不起作用。选一层会丢掉信息,级联生成整棵层级又要多个耦合的生成状态。GLD 属于后者。作者用 DA3 把这个感知—生成错配做成可检验的案例(第2–3页)。
核心创新
- 用单一紧凑欧氏隐变量重参数化几何基础模型的全部特征层级,而不是级联生成高维骨干特征。
- 冻结原几何头迫使压缩后的状态仍可解码深度、射线和点图,并用独立 RGB 头把外观放进同一隐变量。
- 在编解码阶段用词元对齐和关系结构损失整理传输平滑与空间/跨视角结构,再交给标准条件流。
方法概览
第一阶段在冻结 DA3 编码器与冻结 DPT 头之间学习瓶颈:四层特征按通道归一化后拼接,压成 64 或 128 通道、保留斑块网格的隐变量,再重建完整层级。冻结 DPT 读深度、射线和点图,另学一个 RGB 头从同一隐变量解码外观。词元损失对齐 C-RADIO,结构损失匹配 DINOv2 的成对相似度。第二阶段冻结编解码器,只对标准化后验均值做条件流匹配;干净参考隐变量、度量普吕克射线和文本是控制,不进入待积分状态。
- 两阶段。第一阶段训练编解码器,把冻结骨干的多层特征变成一个同时可解 RGB 和几何的隐变量;第二阶段冻结该编解码器,在标准化隐空间里训练条件流。式 (1) 里 E 是冻结 DA3 编码器,P 融合四层特征,Enc 与 Dec 压缩并重建,流模型只把噪声推到目标视角的标准化后验均值(第4–5页,Fig.2)。
- 融合是固定算子:每层用训练集的逐通道均值和标准差归一化,再把斑块还原成网格并沿通道拼接。编码器输出后验均值和方差,训练时抽样,流匹配和推理只用后验均值。压缩只发生在通道上,Cz 取 64 或 128,空间网格保持 DA3 的斑块布局。编码器和解码器是带空间自注意力的轻量卷积金字塔。小的 KL 项正则化瓶颈,但不把模型推进强正则的生成式 VAE 区间(第5页)。
- 几何与外观是同一状态的两个读出。解码器重建四层归一化特征并做逆分割、反归一化;冻结 DPT 头从这棵层级读出深度、射线和点图。RGB 头直接从紧凑隐变量渲染外观。几何头保持冻结,是为了阻止它迁就压缩丢掉的信息:几何重建必须仍能被原来的 DA3 头读懂。几何监督是把冻结头用在原始特征上得到的伪标签,不是外部真值(第5页)。
- 重建不能决定隐空间是否好生成。Table 1 显示,只做融合和重建可以改善条件数,但传输平滑和语义邻域仍弱。位置级的 L_tok 把投影后的后验词元对齐到冻结 C-RADIO,能降低 ρ 并提高 LNC,却因逐位置独立而把 LDS 和 SRSS 打崩。L_struct 在原始后验空间匹配冻结 DINOv2 的成对相似度,不要求通道维一致,从而补回邻域几何。总表示损失为 λ_repa(L_tok+λ_μ L_struct),系数 0.25 与 8.0。教师和投影头在编解码训练后丢弃,再按通道做标准化(第6页)。
- 流匹配使用线性路径,网络按 RAEv2 的干净隐变量预测再换成式 (13) 的速度。一个变换器同时建模全部目标视角,使跨视角交互发生在紧凑几何状态里。参考视图只用已观测帧做上下文编码,干净隐变量作为 t=0 的条件词元,与噪声状态一起注意力,但在解码头前移除。全部输出槽,包括落在参考相机上的槽,仍是待积分变量。这样避免把参考槽夹在 ODE 里,训练和测试也不会因为集合编码不一致而错位(第7页)。
- 相机条件是度量普吕克射线,嵌入查询/键自注意力;冻结语言模型特征走交叉注意力。文本、参考和相机独立丢弃,使同一套权重支持纯文本、相机控制和参考条件生成。推理时从 t=1 积到 0,反标准化后用式 (2) 同时解出 RGB 和几何,不再级联层级,也不另跑一个几何估计器(第7页)。
逐图理解论文
失败直觉
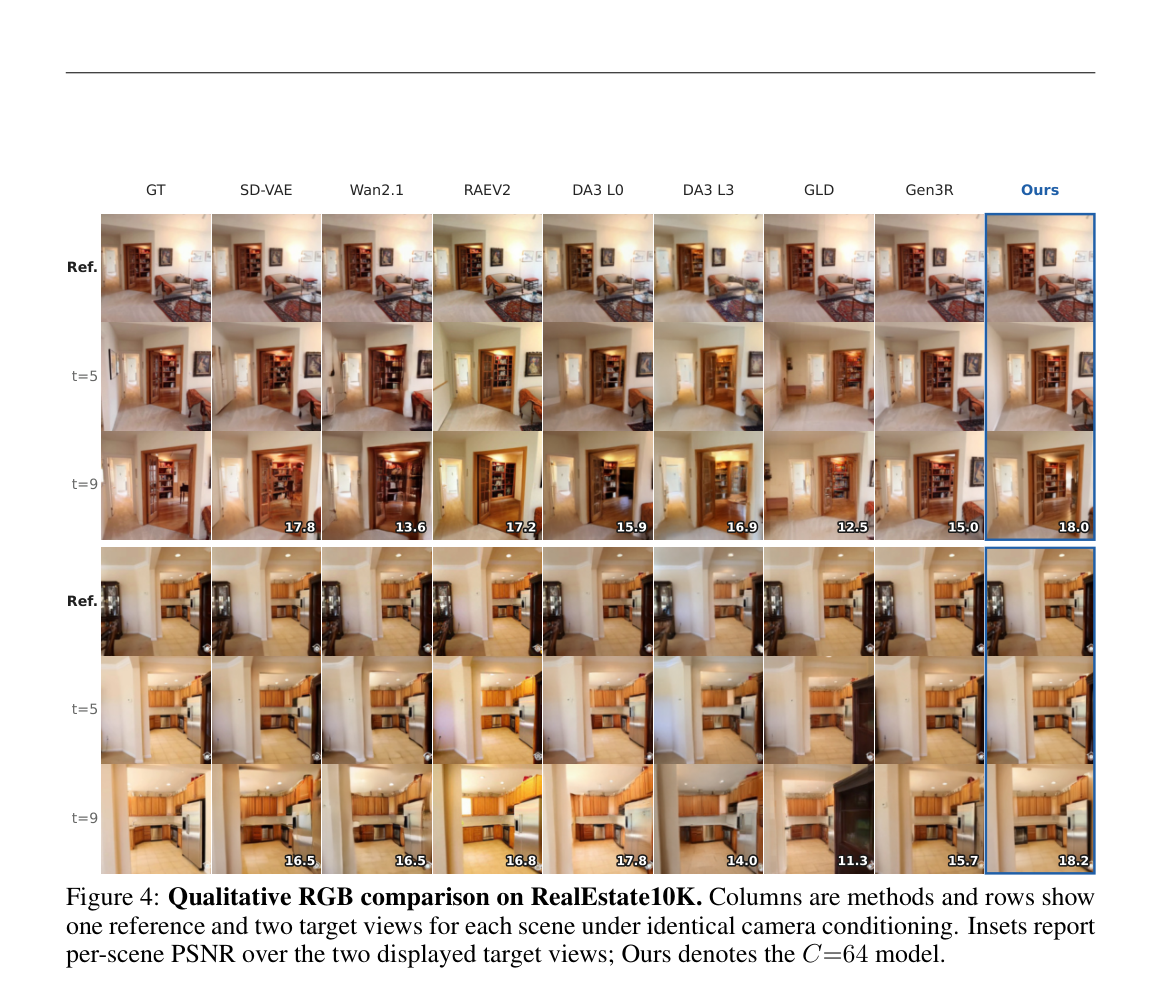
第10页的 RealEstate10K 定性 RGB 对比。列从 GT、SD-VAE、Wan2.1、RAEV2、DA3 L0、DA3 L3、GLD、Gen3R 到蓝框 Ours。两个场景各有 Ref、t=5、t=9 三行,分别是书房走廊和厨房。t=9 上的数字是两张目标视图的场景 PSNR:Ours 为 18.0 和 18.2。用它看相机离开参考帧后物体和门窗是否还像真值。这些插图不是 Table 5 的数据集平均,Ours 指 C=64。
方法贡献
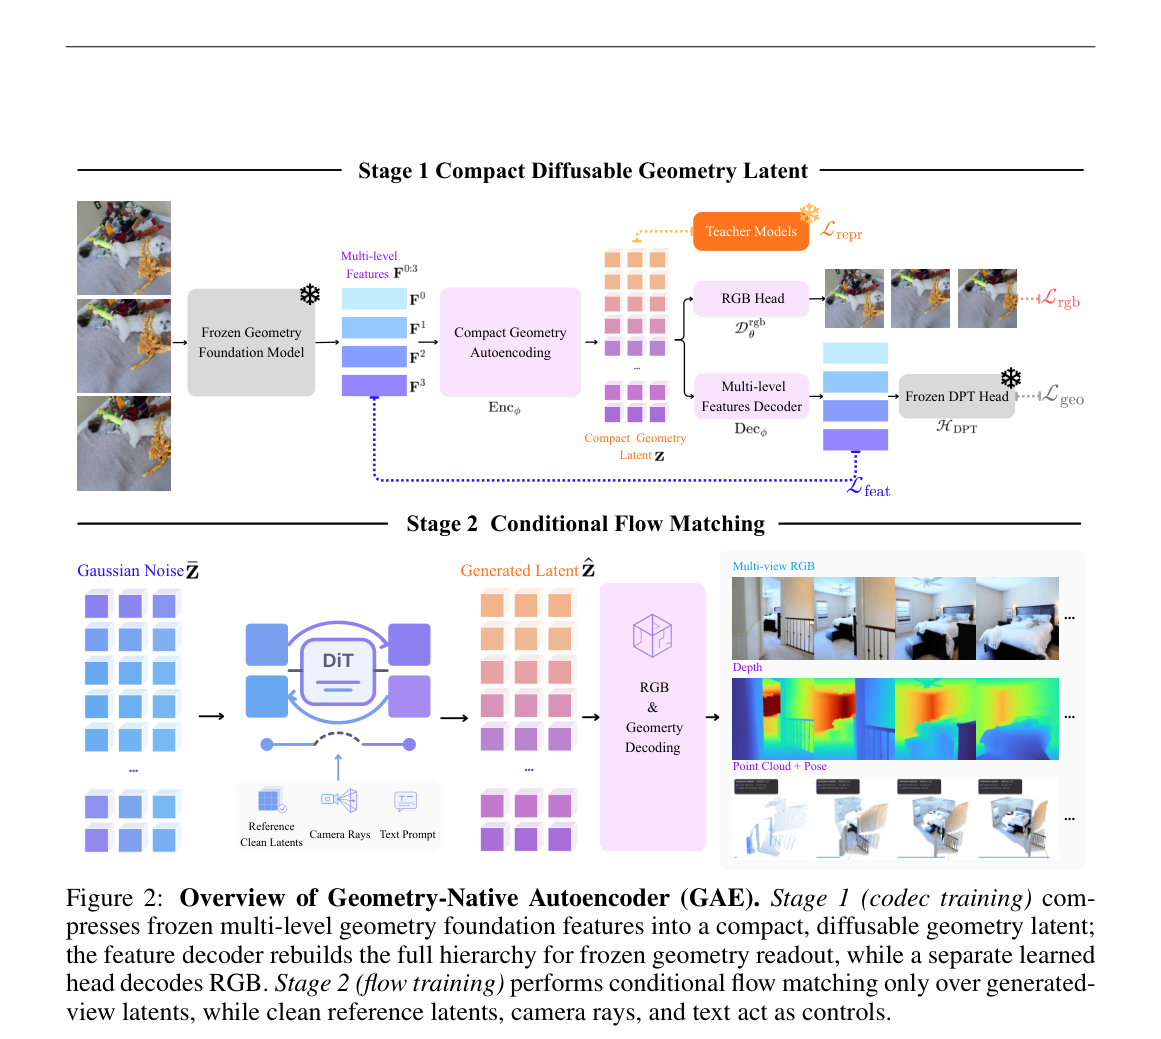
这是方法总图,应作为特色架构图。上半 Stage 1 从多视图进入冻结几何基础模型,得到 F0 到 F3,经紧凑几何自编码变成隐变量 z;一支走 RGB 头,一支经多层特征解码器进入冻结 DPT 头,教师模型用表示损失约束隐变量。下半 Stage 2 从高斯噪声经过 DiT,条件是参考干净隐变量、相机射线和文本,生成隐变量再同时解出多视图 RGB、深度以及点云加位姿。阅读时先分清两个阶段,再看几何头是冻结的、参考帧不在待生成状态里。
实验观察
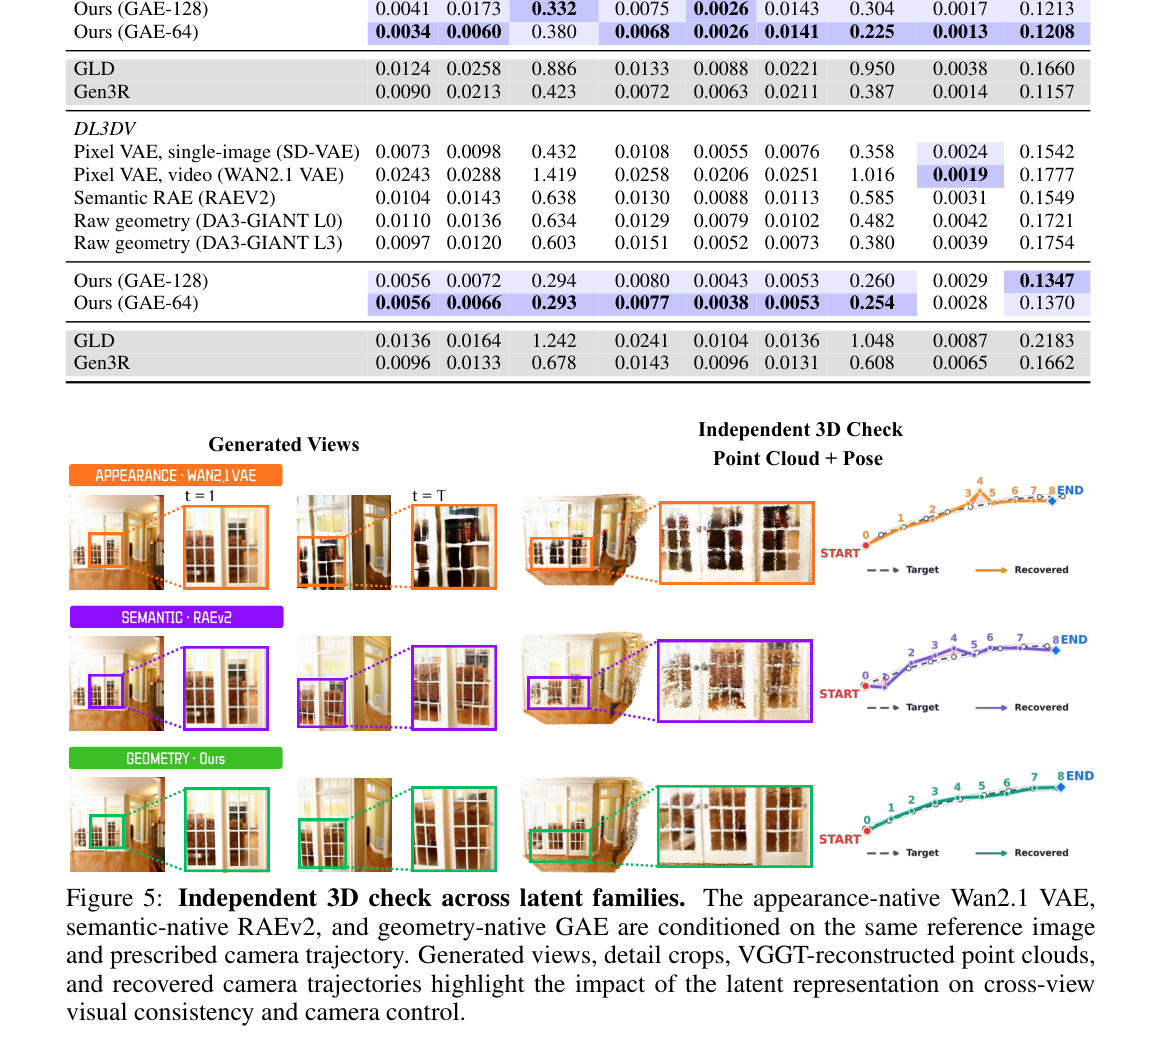
这张 PNG 上半是 Table 6 的底栏,下半才是 Fig.5。图内三行用同一参考和指定轨迹比较外观型 Wan2.1 VAE、语义型 RAEv2 和几何型 GAE。每行左侧是生成视图和窗框裁剪,右侧是 VGGT 点云以及从 START 到 END 的目标虚线与恢复轨迹。GAE 一行的窗框更一致,绿色恢复轨迹也更贴虚线;上两行的点云更碎、轨迹更偏离。上半表格的表头可能被裁掉,读数字时应回到 Table 6,而不是凭裁切猜列名。
意义与边界
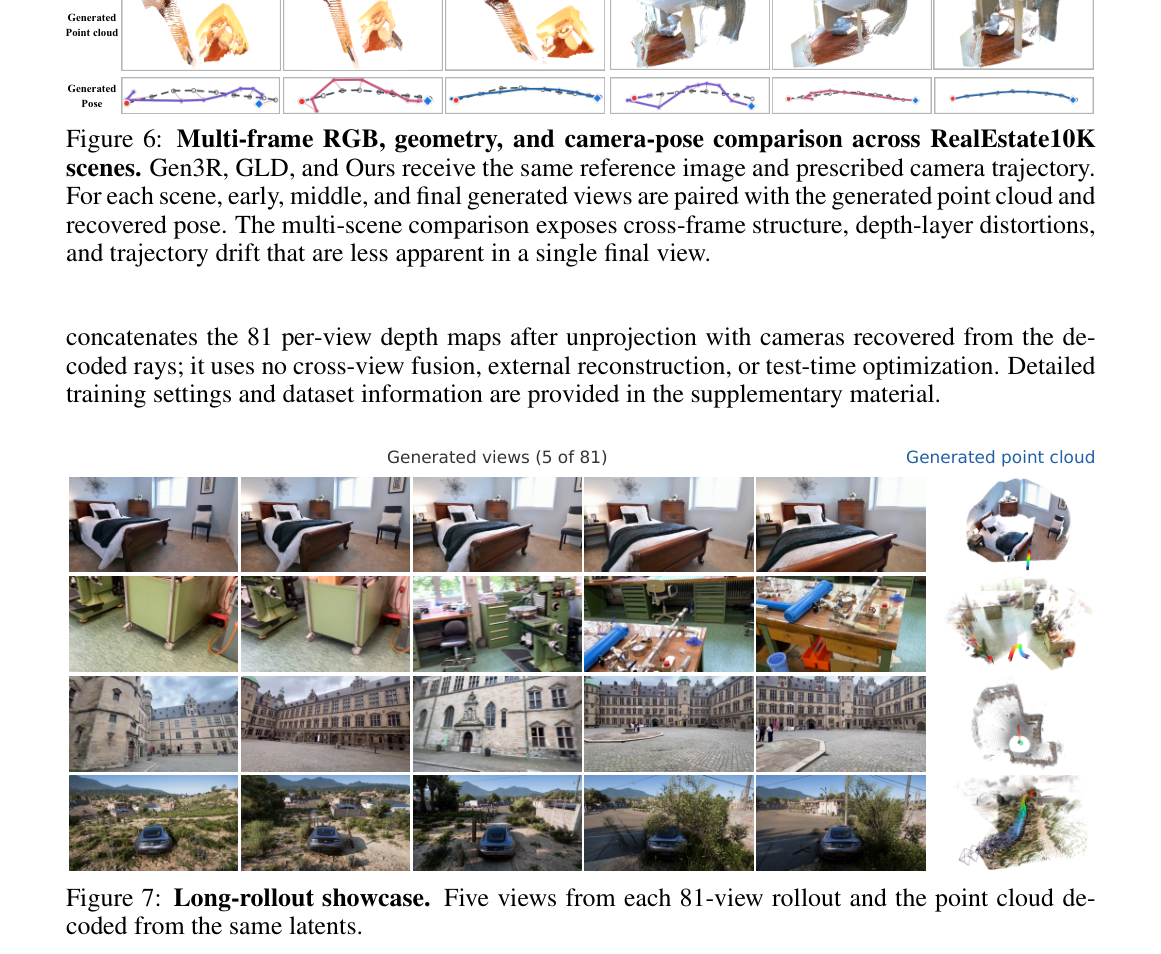
PNG 上方先露出 Fig.6 的点云和轨迹底栏,以及“81 张深度直接拼接、不做跨视角融合”的正文,下面才是 Fig.7。图题写明 Generated views (5 of 81)。四行分别是卧室、杂乱工作间、石砌庭院和带蓝色轿车的乡路,每行五张彩色视图,右侧是从同一批隐变量解出的点云。用它理解长滚出能同时交出画面和几何,但点云是逐帧反投影的拼接,而且这个模型不在九视角受控排名里。
实验如何设计?
- 受控隐空间包括 SD-VAE、Wan2.1 视频 VAE、官方 RAEv2(冻结 DINOv3-L)、原始 DA3-GIANT 的 L0 与 L3,以及 GAE-64、GAE-128。每个变体都放进同一类流模型,使用相同的相机条件、训练预算和采样协议(第7页)。
- 数据是 RealEstate10K 与 DL3DV 的共享留出池,各 64 个场景,每场景九个 252×252 视图、一个参考视图。定量推理统一 50 步 Euler、CFG 为 2。帧间隔在 RealEstate10K 为 10,在 DL3DV 为 1。附录给出约 0.93B 参数的 DDT 式骨干、Qwen3-0.6B 文本特征和 10 万步优化日程(第7、19页)。
- 外观用 FID/FVD 和成对 LPIPS、PSNR、SSIM。三维一致性用与骨干无关的 VGGT 恢复 ATE、相对平移和旋转、重投影误差,并用 MEt3R;DA3-GIANT 只作为与骨干重叠的交叉检验。直接解码的深度和点图对照 Pi3 在真实目标帧上的估计,相机对照数据集轨迹(第9–12页)。
- 蓝色单元格标受控变体的前两名,灰行的 GLD 与 Gen3R 是完整系统,不参与排名。第 4.3.4 节的最终模型用更大数据、更高分辨率和 81 帧,只做定性,不进入比较。消融在 RealEstate10K 上分开考察表示损失、参考条件、位姿尺度和文生图联合训练(第7、12–13页)。
关键结果与论文证据
- 没有一种基线在所有轴上都强。像素 VAE 条件好但结构弱,RAEv2 语义邻域强却没有原生几何读出,原始 DA3 几何原生但高维且病态。L0 的跨视角对应更强,L3 降低了 ρ,却牺牲空间和跨视角结构。GAE 把状态收到 64 或 128 通道,并在几何原生表示里取得传输、条件和结构的最好综合(第8页,Table 2、Fig.3)。
- RGB 重建上,GAE-128 单视图 PSNR 28.76、LPIPS 0.036、rFID 5.4,多视图 PSNR 34.78、LPIPS 0.014、rFVD 4.3。正文称它以 24 倍更少的通道匹配或略超原始 L0;L3 丢掉更多可重建外观。GAE-64 略低,单视图 PSNR 27.30、多视图 32.37(第8页,Table 3)。
- 编码再解码真实帧后,两个 GAE 变体在两个数据集的深度、点图和位姿上都优于只传播 L0 的原始基线。RealEstate10K 上 GAE-64 的 AbsRel 0.090、Chamfer 0.386、ATE 0.007,原始 L0 为 0.178、0.635、0.068。像素码和 RAEv2 因没有原生几何读出而未列入该表(第9页,Table 4)。
- 相机条件外观生成中,GAE-64 在两个数据集上综合最强:FVD 相对最佳非 GAE 受控隐空间在 RealEstate10K 降 12.7%(225.7 对 258.6),在 DL3DV 降 23.1%(287.0 对 373.2),并领先 LPIPS、PSNR 和 SSIM。GAE-128 的 RealEstate10K FID 最好,为 25.6。Fig.4 在相同参考图和轨迹下,Ours(C=64)两个场景的插图 PSNR 为 18.0 和 18.2,高于同图 GLD 的 12.5 和 11.3(第9–10页,Table 5)。
- 独立三维检查里,两个 GAE 占据受控 VGGT 结果的前两名。GAE-64 把 RealEstate10K ATE 降到 0.0034,相对 SD-VAE 的 0.0072 减少 52.8%,DL3DV 上减少 23.3% 到 0.0056。受控 MEt3R 最好成绩是 RealEstate10K 的 0.1208(GAE-64)和 DL3DV 的 0.1347(GAE-128)。外观提升没有换来更差的相机控制(第10–11页,Table 6、Fig.5)。
- 从采样隐变量直接解码几何时,DL3DV 上 GAE-64 在受控几何原生方法的六项指标中领先;RealEstate10K 上它的深度和位姿最好(AbsRel 0.134、ATE 0.010),GAE-128 的 Chamfer 和点图误差更低。这些增益不把 DA3-GIANT 当作评价器(第11–12页,Table 7)。Table 8 进一步表明 L_repr、干净参考词元、度量射线和文生图联合训练分别改善外观、参考—目标点云间隙和尺度敏感位姿(第13页)。
阅读时需要注意
- 受控结论绑定在九视角、252 分辨率和 64 个场景上。更长的 81 视角滚出使用单独训练的时空编解码器和更杂的数据混合,作者明确把它排除在排名之外,因此不能把展示图的视觉完整度当成同一协议下的定量胜出(第7、11、19页)。
- 几何重建优化的是 DA3 伪标签。生成几何的深度和点图参照 Pi3,而 Pi3 本身是估计。轨迹误差依赖 VGGT 或数据集相机,不同检查回答的不是同一个“真值几何”问题(第5、10页)。
- 与外部系统比时要看灰行规则。Gen3R 在 RealEstate10K 的 MEt3R 为 0.1157,数值上低于 GAE-64 的 0.1208;GLD 的外观和轨迹在该协议下明显更差。排名句子不能省略“受控”这个限定(第11页)。
- 点云展示没有跨视角融合。Fig.7 的点云是逐帧深度反投影的拼接,空洞和层错可能来自拼接方式。文生图只被当作能力检查。论文也没有给出动态场景、大光照变化或回环一致性的专门实验(第12–13页)。
关联工作
- 从 VAE、VQ 到潜扩散,视觉生成长期把感知压缩和生成建模分开,紧凑连续码成为标准状态。RAE 改用冻结预训练表征,后续工作把它扩展到文生图和多层特征。潜空间可扩散性研究表明,重建好并不等于生成好。这些工作围绕外观或语义组织状态;GAE 要求状态还能被几何基础模型原生读取(第3页)。
- 场景新视角、相机可控视频和联合输出深度的扩散模型,把几何加到以外观为主的生成上。GAE 的差别是:唯一演化的隐变量来自几何骨干的重参数化,RGB 只是该状态的一个读出(第3页)。
- 把几何基础模型直接当作生成状态的近亲是 GLD 的层级级联,以及在 VGGT 四层乘积流形上的黎曼流匹配。两者保留原生几何读出,但生成的是高维骨干特征。GAE 学习一个紧凑欧氏坐标,用标准流模型演化,再把层级重建出来交给冻结头(第3页)。