快速导读:VideoGen-Agent 用教师轨迹监督微调和多任务 GRPO,训练一个共享策略去调度检索、仿真、生成与校验工具,并可用更强生成器替换后端。
文生视频的清晰度已经接近实拍,却仍经常不能满足提示里的专业知识、指定身份、物理关系或事件顺序。扩散模型可以处理复杂运镜和光照,但预训练知识覆盖不到新出现的实体,也会把熟悉的招式画错、让人物身份中途漂移、让碰撞违反基本力学,或漏掉按顺序排列的阶段。普林斯顿、斯坦福等机构的 VideoGen-Agent 不把这些失败只交给一个更大的单次生成器,而是训练一个多模态智能体,在多轮交互里调用外部工具。
智能体面对六类任务:流程知识、单实体身份、多实体身份、物理仿真、组合场景和多镜头。补充工具负责检索文字、检索参考图或用代码仿真运动;生成工具负责文本、图像、参考图和运动条件;校验工具用检测和深度估计决定要不要重生成。训练先在教师轨迹上做监督微调,再在另一批提示上用 GRPO 做多任务强化学习。在留出的 VABench 上,同一套 Toolset 1 把基础文生视频从 56.5 提到 75.6;换成更强生成工具后,策略不再训练,总分到 86.1。
英文题目:VideoGen-Agent: Reinforcing Video Generation Agents
论文出处:arXiv 每日论文精选 · arXiv:2609.24997
原始论文:PDF / 论文页面
这篇论文解决什么问题?
单模型视频生成的失败是分类型的。流程知识要求画出“白鹤亮翅”这类有标准肢体进程的动作;身份任务要求地标、角色或名人在整个片段里保持外观;物理任务给出初速、质量和碰撞关系;组合场景要求多个主体按空间关系互动;多镜头要求若干阶段按时间出现。这些要求超出了“再把提示写具体一点”能稳定解决的范围(第2页)。
工具增强已经分别用于检索、仿真和测试时改写,但系统往往为一种目标设计一条流程。跨任务学习工具使用,要求策略自己判断该拿视觉参考还是该跑仿真,还要根据检测或深度的返回值决定下一步。这就是作者采用多任务智能体强化学习的原因(第2页)。
Fig.1 给出的循环是:给定用户提示,策略在推理、动作、观测之间选择工具,工具输出进入历史,直到返回成片。本文不使用那张总览图做配图,训练流程以 Fig.2 为准。默认工作流只是共享策略的引导,真正的参数和是否重生成仍由提示和观测决定(第3–4页)。
核心创新
- 一个共享多模态策略用多任务智能体强化学习,在六类视频任务上协调补充、生成和校验工具。
- 混合奖励同时评价调用格式、工具返回值是否被用对,以及成片是否符合该类标准,并用任务优势归一化平衡类别。
- 工具接口保持不变,因此生成器可以在评测时升级,策略不必重训;同时发布 600 条提示的 VABench。
方法概览
策略在多轮推理—动作—观测循环里选择工具和参数。补充工具做文本/图像检索或代码仿真,生成工具覆盖文生视频、图像/参考条件和运动条件,校验工具用检测和深度估计决定是否重生成;多镜头用末帧衔接分段生成。24K 提示中 16K 教师轨迹做监督微调,8K 提示上从 SFT 策略出发用 GRPO 采样新轨迹。奖励是格式、类别 VLM 质量和工具使用的加权和,先做组内相对优势,再按任务归一化。Toolset 1 用于训练,Toolset 2 只升级生成工具。
- 六类默认流程写在 Table 1。流程知识是文本检索再文生视频。单实体身份是图像检索后接参考图或单图条件。多实体身份按主体个数多次检索再做多参考生成。物理仿真是代码仿真再接运动条件生成。组合场景是文生视频之后做检测和深度估计,必要时再生成。多镜头是先文生视频,再反复抽取末帧并做图像条件生成,段数由提示里的阶段数决定(第6页)。
- 数据没有现成的公开对齐集。Claude Opus 4.7 按类批量写提示,并少量改写公开例子。非目标因素被故意简化:流程和物理用简单主体,身份任务用简单动作,组合场景和多镜头用规范物体,以便评测集中在相应能力上。每条多镜头提示含两到四个有序阶段。每条提示随机选 Gemini 3.1 Pro 或 Claude Opus 4.7 当教师,使用与学生相同的工具接口,记录推理、调用、观测和最终视频。共 24K 条,16K 教师轨迹做 SFT,其余 8K 条提示留给 RL 重新采样(第5页)。
- SFT 用下一词预测,系统提示与教师相同。失败动作的跨度不计入损失,但连同错误观测留在上下文里,后面的恢复动作仍提供监督。得到的策略 π_θ0 作为强化学习的初始点和 KL 参照(第5页)。
- RL 使用 GRPO。每条提示由旧策略采样 n 条轨迹,只有智能体自己发出的词元进入目标,工具返回词元被掩掉。外部工具错误以文本观测返回,最终因此失败的轨迹不参与优化。奖励是 0.1 的格式项、0.5 的类别 VLM 质量和 0.4 的工具使用项。格式检查输出和调用是否合法;VLM 按类别量规看成片;工具项检查是否选了对的工具、是否真的使用了返回值,而不是只统计调用次数(第6页)。
- 优势分两步。先在同一提示的 n 条轨迹里做组内标准化,再按 AgentRL 的做法,用全局批次里该任务的均值和方差把词元优势拉到可比尺度,统计跨数据并行汇总。策略损失是截断重要性比乘上这个优势,加上指向 SFT 参照的 KL。实现时基座是 Qwen3-VL-8B-Instruct,SFT 学习率 5×10^-5、两个 epoch,八张 H200;RL 一个 epoch,每批 8 条提示、每条 6 条轨迹,ε 低 0.2、高 0.28,β_KL 为 10^-3,另有八张 GPU 负责生成和校验服务(第6–7页)。
- Toolset 1 贯穿训练。Toolset 2 只替换生成工具,补充和校验不变,评测时不继续训练策略。这样可以把“学会用工具”和“后端生成器变强”分开。算法 1 还规定:若已生成全部阶段且校验分数达到阈值就可以停止;若过早输出答案但阶段不全,观测会要求先补段(第4、7页)。
逐图理解论文
失败直觉
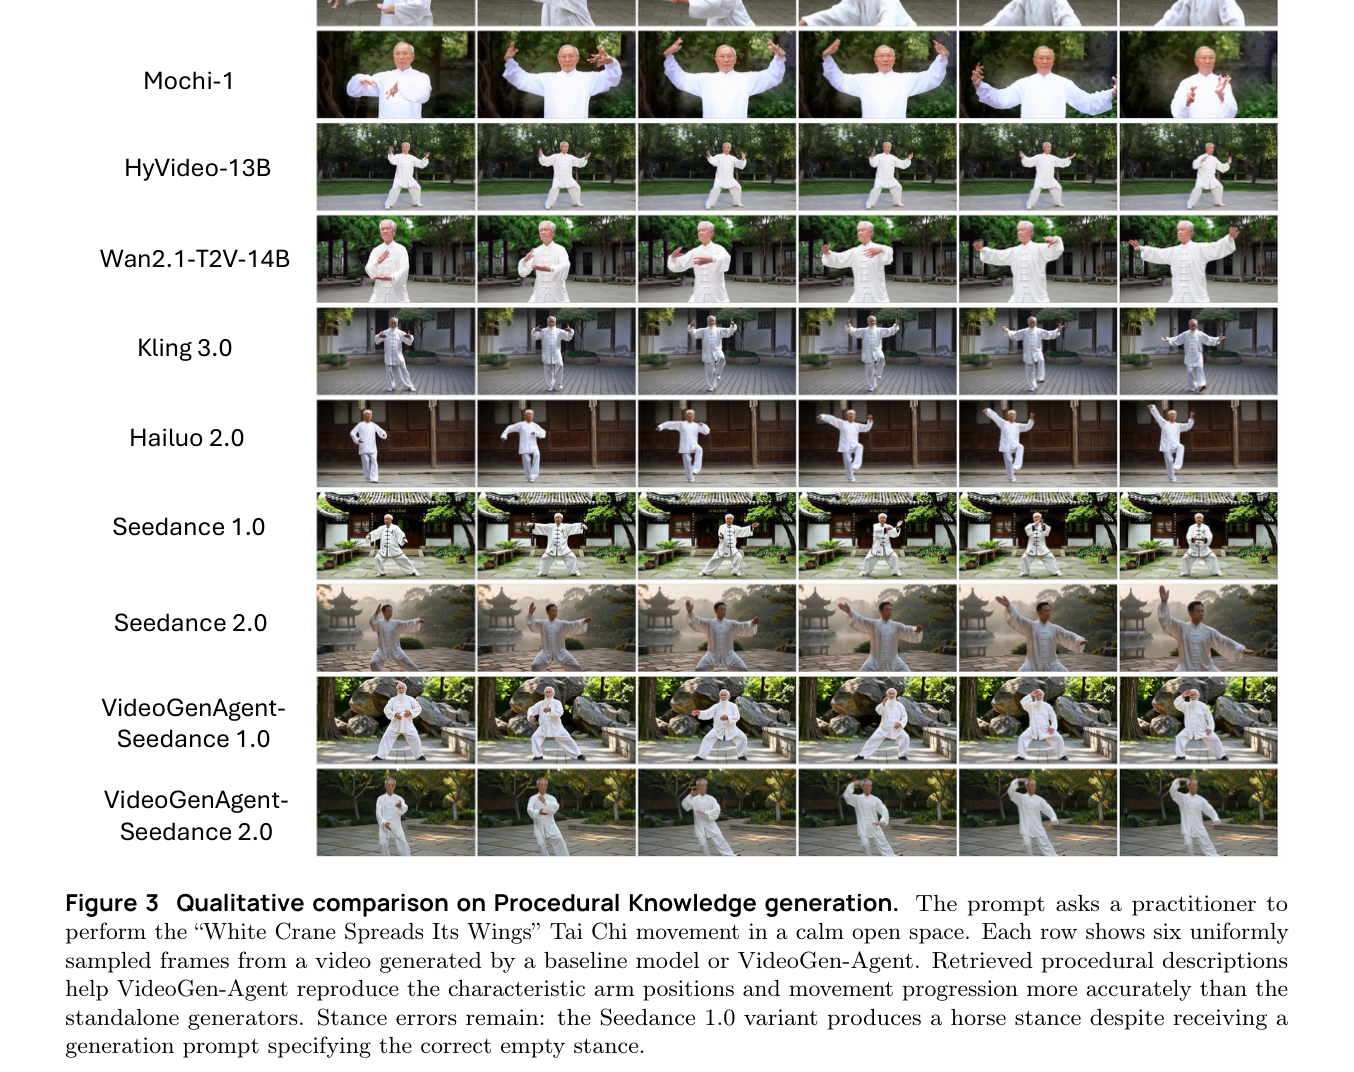
第29页流程知识对比,提示是在开阔场地打太极拳“白鹤亮翅”。每行六帧,模型依次为 Mochi-1、HyVideo-13B、Wan2.1-T2V-14B、Kling 3.0、Hailuo 2.0、Seedance 1.0、Seedance 2.0,以及 VideoGenAgent 的 Seedance 1.0 与 2.0 变体。白衣人物的手臂开合在后两行更接近招式进程。图注明确说 Seedance 1.0 变体仍把虚步做成马步,所以不能把这两行理解成动作已经完全正确。六帧也不足以判断重心移动的全过程。
方法贡献
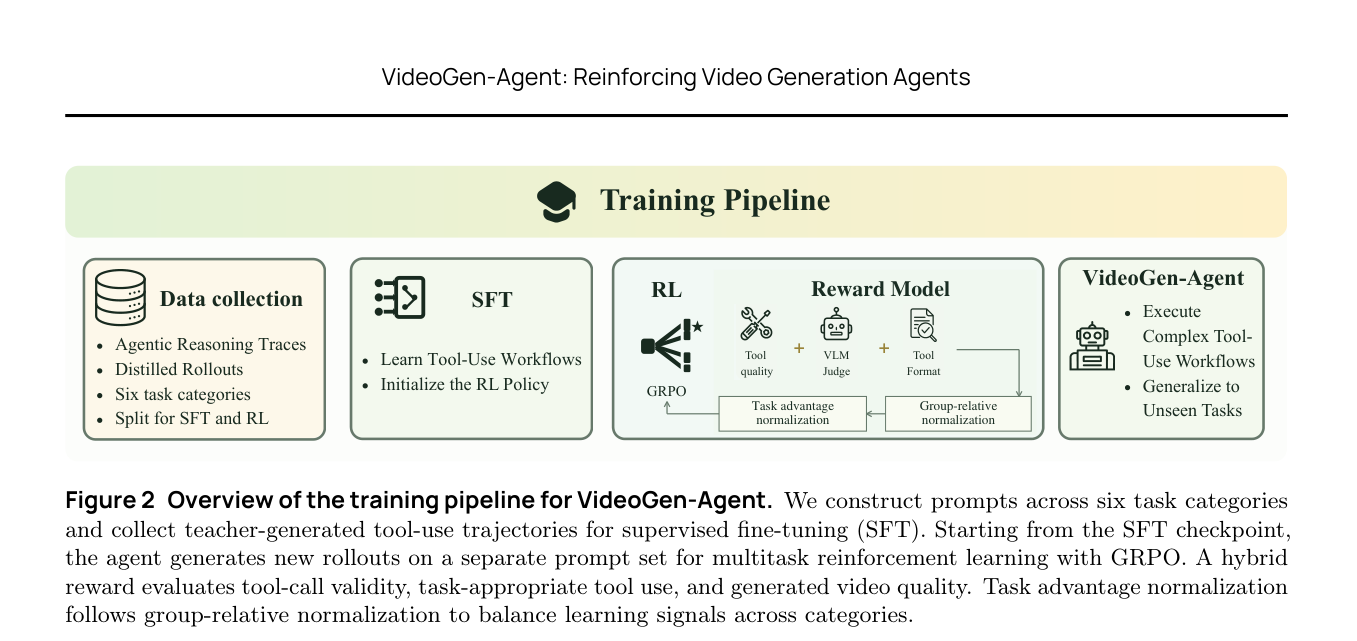
第5页的训练流程图,应作为特色架构图。顶部是论文标题,绿色横幅写 Training Pipeline。从左到右四块:Data collection 收集六类的智能体轨迹并划分 SFT 与 RL;SFT 学习工具流程并初始化 RL 策略;RL 用 GRPO,奖励由工具质量、VLM 评判和工具格式组成,下面还有任务优势归一化与组内相对归一化;最右侧 VideoGen-Agent 执行复杂工具流程并泛化到未见任务。用它区分“先模仿教师”和“再在新提示上采样优化”,不要把它当成单次视频去噪网络。
实验观察
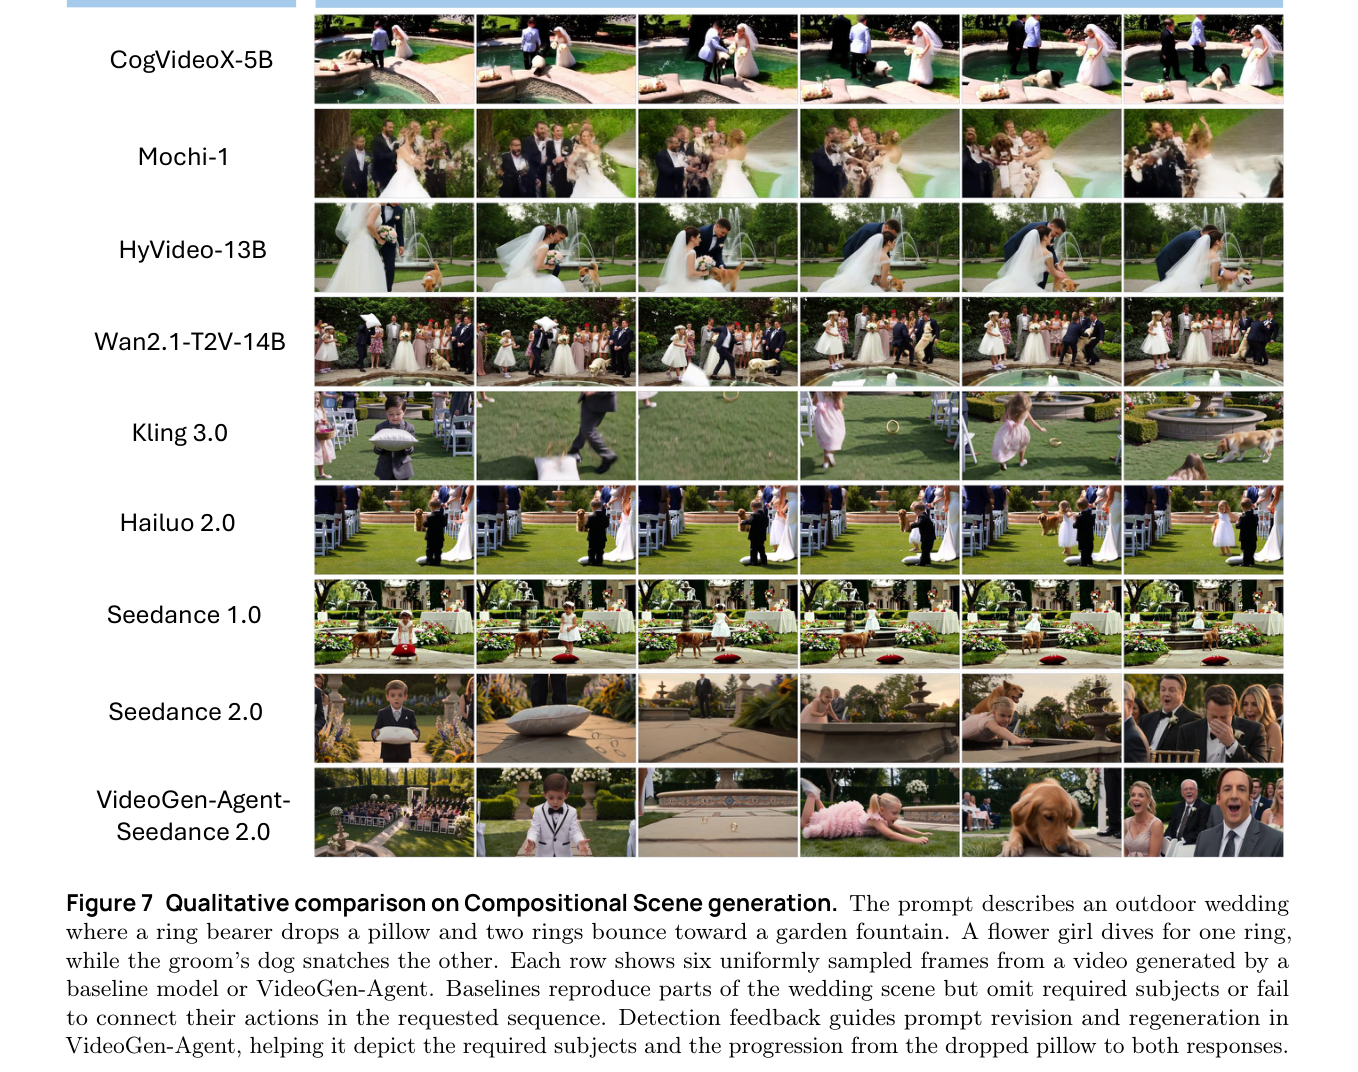
第33页组合场景。提示是户外婚礼:戒童弄掉戒指枕,两枚戒指弹向喷泉,花童扑向一枚,新郎的狗叼走另一枚。各行六帧。基线多半只有新人、草地或喷泉的一部分,Kling 一行还出现缺主体的空镜。最后一行 VideoGen-Agent-Seedance 2.0 能依次看到持枕男孩、掉在草地上的枕头、扑出的粉色花童、金色狗和惊讶的男士。图注把这归因于检测反馈改写提示并重生成。它说明主体被补进了画面,并不等于每个空间关系都有定量误差。
实验如何设计?
- VABench 有 600 条留出提示,每类 100 条,经人工检查是否适合视觉表现、难度是否落在该类。评判使用 Gemini 3.1 Pro 和训练时同一套奖励提示与权重,单条分数归一化到 0–100,报告类内均值和不加权总均(第7页)。
- 单模型基线以单次生成为准,包括 CogVideoX-5B、Mochi-1、HunyuanVideo-13B、Wan2.1-T2V-14B、Hailuo 2.0、Kling 3.0、Seedance 1.0 Pro Fast 和 Seedance 2.0 Fast。智能体用两套工具集分别评测(第7–8页)。
- 消融固定 Toolset 1:原始 Seedance 1.0、Qwen3-VL 改写提示、带系统提示的零样本工具使用、SFT、去掉 VLM 奖励、去掉工具奖励、六个单任务 RL,以及完整多任务 RL(第9页,Table 3)。
- 人工实验从 VABench 随机抽 100 对,比较 Toolset 2 与 Seedance 2.0,四名评分者。附录另用三名评分者检查评判模型与人类多数意见是否一致,样本规模在附录中为 600(第9、28页)。定性图每行均匀取六帧(第29–34页)。
关键结果与论文证据
- Table 2 中,开源单模型总分从 HunyuanVideo 的 29.8 到 Wan2.1 的 50.0。闭源单模型里 Seedance 2.0 最高,为 73.2,Kling 3.0 为 65.2,Hailuo 2.0 为 63.8,Seedance 1.0 为 56.5。VideoGen-Agent Toolset 1 为 75.6,Toolset 2 为 86.1(第8页)。
- Toolset 1 相对 Seedance 1.0 提高 19.1,相对 Seedance 2.0 提高 2.4,但多实体身份 65.3 对 69.0、组合场景 83.1 对 87.8 仍然落后。Toolset 2 六类都是该列最高,多实体从 65.3 升到 86.7,是更换生成器后抬升最大的一类。相对 Seedance 2.0,流程知识、多实体和多镜头分别高 14.1、17.7 和 25.7,组合场景只高 2.9,因为单模型在该类已经有 87.8(第8页)。
- 训练阶段的贡献需要看工具集不变的消融。改写提示只到 57.3,零样本工具使用到 59.5,作者指出零样本策略经常不能正确调用工具。SFT 到 69.2,RL 再增加 6.4 到 75.6,六类都有提升。去掉 VLM 奖励降到 73.3,去掉工具奖励降到 71.2,工具项的跌幅更大(第9页)。
- 单任务 RL 总分 76.3,比多任务高 0.7,在流程知识、多实体和组合场景上更高;多任务在其余三类更好。一个策略覆盖六类,总体代价很小(第9页)。
- 人工偏好支持 Toolset 2:四名评分者在 100 对上的总体偏好率是 84.3%,优势主要来自流程知识和多镜头。附录称 Gemini 3.1 Pro 与人类多数意见在 600 条上一致率为 92.0%,说明量规和人的排序大体同向,但不是像素真值(第9、28页)。
- 定性案例和工具流程对得上。Fig.3 的太极只有两个智能体变体更接近白鹤亮翅的手臂进程,但 Seedance 1.0 变体仍做成马步。Fig.6 用代码仿真的光流驱动 Wan-VACE 做运动条件生成。Fig.7 用检测反馈改提示并重生成,最后一行同时出现花童、戒指枕、扑救的女孩和狗。Fig.8 把落水管分成溢出、支架开裂和下摆三段,用上一段末帧接续(第8–9、29–34页)。
阅读时需要注意
- 第10页的局限写得很直接:生成工具的质量和延迟、校验反馈能看见的错误类型,以及训练只覆盖六类任务,都会限制当前系统。作者把后续方向放在同策略蒸馏、更强的视频理解和更容易部署的生成器上。
- 校验工具是检测和深度,能发现“没有球”或空间关系异常,却很难判定招式规格和连续物理量。Fig.3 的图注已经承认,即使生成提示写了虚步,Seedance 1.0 变体仍可能输出马步。这是生成器限制,不是策略已经解决的问题。
- 分数不可跨定义比较。75.6 是固定 Toolset 1 的策略成绩,86.1 混入了更强生成器。84.3% 是 100 对上的人类偏好,92.0% 是评判一致性。Toolset 1 也没有在每一类上超过 Seedance 2.0。
- 教师和部分评测模型来自同一代闭源模型,提示又由 Claude 批量生成。策略可能学到教师的工具习惯,评判也可能偏好同类轨迹。论文给出了人类一致性,但没有独立的像素级或物理仿真误差表作为主结果。
- 未见任务组合和机器人动作到视频只是探索性实验:中途加入 π0.5 与 Ctrl-World,以及“指定角色做专业动作”这类训练时没见过的组合。它们说明接口可以扩展,不能当成 VABench 上的主数字(第9页)。
关联工作
- 视频生成侧,扩散模型和自回归视觉序列都提高了画面质量,但特定实体、物理交互和有序事件仍然困难。场景分解、编辑流水线以及用仿真或力作为控制的物理引导方法,说明专用流程可以补上提示单独做不到的约束。本文把这些流程收成一个要学习的共享策略(第10页)。
- 可验证奖励的强化学习先用于多步推理,再扩展到检索、网页和代码工具。那些设定主要评价答案或动作是否完成。视频生成还必须评价画面,所以奖励里同时有工具项和类别 VLM 项(第10页)。
- 视觉生成智能体里,研究然后生成的图像路线以及 Gen-Searcher 的 SFT+GRPO 是最近的图像侧对应物。VISTA 则在视频上做测试时批评和改写。VideoGen-Agent 的差别是六类任务、训练期工具轨迹,以及生成器可替换(第10页)。