快速导读:上科院、港理工等提出 AV-GRPO:用模态锚定 rollout、轨迹锁定冻结塔与模态自适应目标,把纠缠的多模态奖励拆成条件单模态子问题,并配 5DAV 数据集;在 LTX-2.3 上 LoRA/全参后训练均优于基线与 GDPO。
联合音视频生成已经能从一条文本提示同时出画面与声轨,但仍常出现某一模态糊、对不上文案、或两边事件不同步。上海人工智能实验室、香港理工大学、新加坡国立大学、南洋理工大学与浙江大学的 Zhiyu Xu、Weilong Yan、Yufei Shi、Shiyang Li、Yihao Liu、Kin-Man Lam、Yuewen Cao 提出 AV-GRPO(arXiv:2609.29816,预印本):把 Flow-GRPO 式在线扩散强化学习改造成模态锚定框架,并发布五维解耦训练集 5DAV。
核心思路不是把整对音视频当成一个策略输出硬加多奖励,而是交替做音频锚定的视频更新与视频锚定的音频更新:组内共享锚模态完整轨迹,只采样目标模态;锚塔冻结、轨迹锁定,信用只落到目标塔。作者在 LTX-2.3 22B 上报告 LoRA 与全参后训练均优于基座与 GDPO。代码与数据入口为 github.com/zhiyuxu03/AV-GRPO;本解读未复现。
英文题目:AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.29816
原始论文:PDF / 论文页面
这篇论文解决什么问题?
双流联合模型用共享时间步在各自潜空间里并行去噪,塔间靠交叉注意力交换信息。预训练提升覆盖面,却不直接把感知伪影、文本错位、事件错配推到训练目标前列。
朴素联合 GRPO 有三难:质量、对齐、同步奖励可能选不同候选;同步分还依赖对侧样本难度,组内优势可能混进“对侧更好采”的假信号;双塔同更显存高,且共享优势会把单侧改进误算到另一侧。两侧预训练能力、潜空间尺度与学习速度也不对称,共用噪声与损失易偏科。
因此需要把耦合多模态偏好学习,改写成一组对侧条件固定的单模态子问题,并在数据侧提供可控难度与类别覆盖。
核心创新
- 模态锚定 rollout:固定对侧轨迹,把同步比较条件控住,并把耦合偏好拆成条件单模态子问题。
- 轨迹锁定 + 冻结塔:信用只落到目标塔,并降低双塔同更的显存与优化冲突。
- 5DAV 五维解耦数据与模态自适应超参:按同步难度、指令粒度等可控采样,并配合每隔四步的交替更新。
方法概览
AV-GRPO 交替做音频锚定的视频学习与视频锚定的音频学习:组内共享一条完整锚模态轨迹,只对目标模态采 G 条候选;锚状态全程锁定且锚塔冻结,只更新目标塔;奖励组合、噪声强度与损失权重按模态解耦。视频侧用 VideoAlign、CLIP、DeSync,音频侧用 Audiobox Aesthetics、CLAP、DeSync,组内再标准化得优势。配套 5DAV:五维正交分解得 288 类×20=5760 提示。在八张 A800 上对 LTX-2.3 22B 做 LoRA 与全参后训练,主评 JavisBench 与 VABench。
- Fig.1 给出训练总览。给定联合文本提示,先做联合音视频采样得到成对样本;Phase A 共享一条音频轨迹,冻结音频塔、更新视频塔,用组内视频候选的视频奖励与音视频奖励做 Video Tower Update;Phase B 对称地锚定视频、更新音频塔;底部标明每隔 N 步交替。
- 方法上沿用 Flow-GRPO:把确定性流 ODE 换成同边缘分布的 SDE,使每步转移概率可算,从而对最终样本奖励做组相对优势更新。AV-GRPO 只把该更新施加在目标塔参数上,锚模态状态全程锁死。
- 奖励:视频塔用 VideoAlign、CLIP、负 DeSync;音频塔用美学分、CLAP、负 DeSync;参照 GDPO 先标准化再求和,组内再标准化得优势。音频侧另有 CLAP 护栏:组均 CLAP 过低时只用对齐优势,避免质量/同步涨分掩盖提示失真。
- 5DAV 沿语义层次 W、声源类型 H、同步难度 D、时间复杂度 T、指令粒度 C 正交划分,3×4×4×2×3=288 类,每类 20 条共 5760。训练时可按维调整采样比例。默认先更视频塔,每四步切换;八卡 A800 上可对 22B 做全参后训练。
逐图理解论文
AV-GRPO 机制
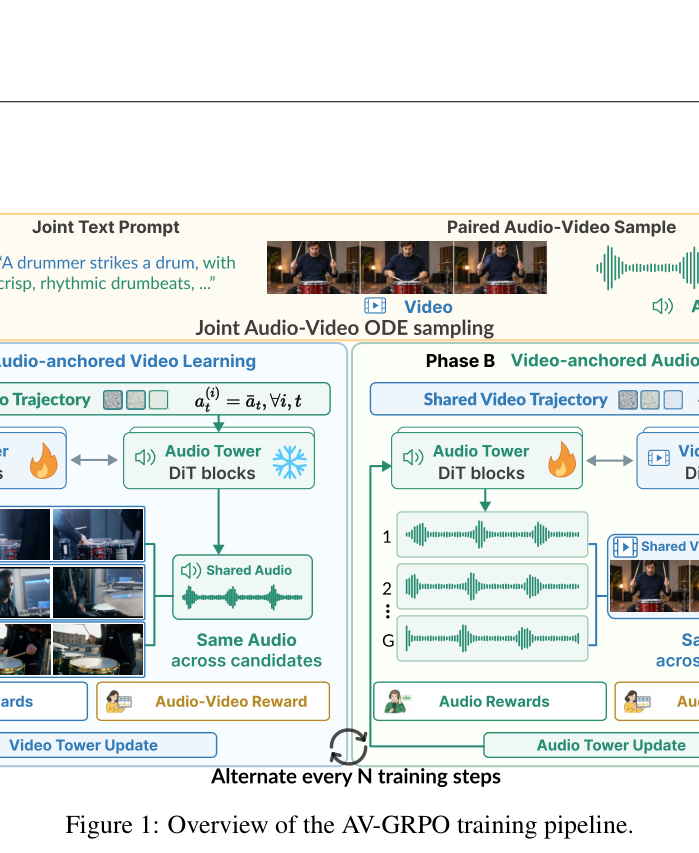
训练管线总图。上:联合提示经联合 ODE 采样得到鼓手画面与音频波形。左 Phase A:共享音频轨迹,音频塔雪花冻结、视频塔火焰更新,G 个视频候选对同一音频算奖励后更新视频塔。右 Phase B 对称。底:每 N 步交替。适合做特色图。
主表结果
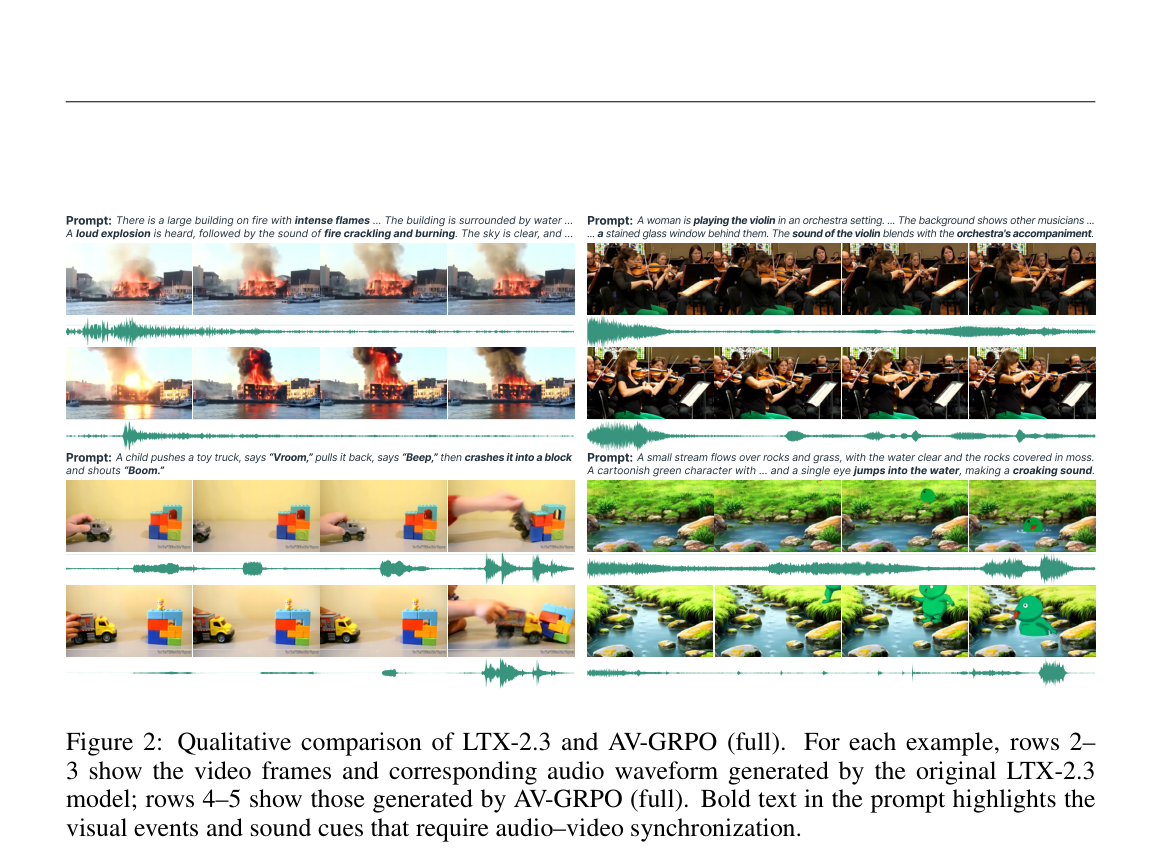
四组定性对比。每组上两行 LTX-2.3、下两行 AV-GRPO(full),帧与波形并排;提示里加粗事件与声音线索。可见爆炸首帧尖峰、玩具车三段发声、入水瞬间峰值等同步改善。不要用 p008-03 正文残片。
定性与消融
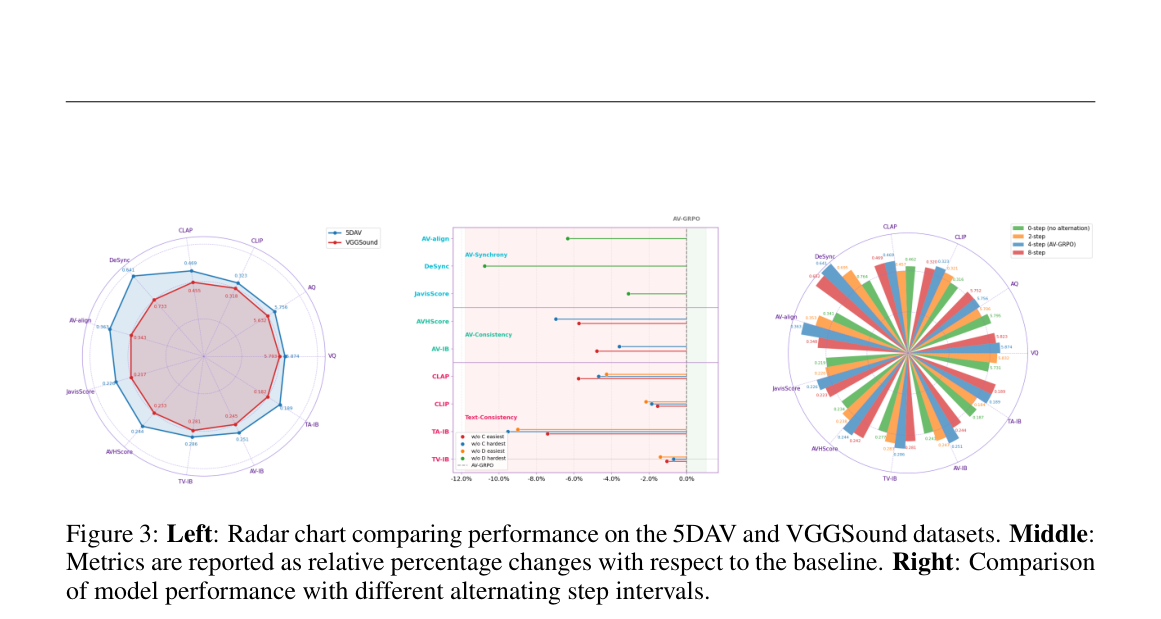
左:5DAV vs VGGSound 雷达;中:去掉 C/D 最易/最难后的相对百分比变化,多落在负侧;右:交替 0/2/4/8 步的径向对比,默认 4 步综合更稳。
实验如何设计?
- 基座 LTX-2.3 生成 544×960、97 帧、24 FPS、15 步去噪。对照含基座、GDPO、AV-GRPO LoRA/full。
- JavisBench 报告 VQ/AQ、TV/TA-IB、CLIP/CLAP、AV-IB/AVH、JavisScore、DeSync、AV-align 等。VABench 含 Speech Q&N、Audio Aes、对齐、Lip Sync、DeSync 以及 MLLM 侧 Alignment/Artistry 等。
- 消融在 JavisBench-mini:5DAV 对 VGGSound;去掉 C/D 最易或最难子集;交替间隔 0/2/4/8(Fig.3)。Fig.2 给定性波形—画面对照。
关键结果与论文证据
- Table 1:AV-GRPO(full) 相对 LTX-2.3 把 AQ 提到 5.798、CLAP 到 0.468、AV-IB 到 0.247、JavisScore 到 0.222,DeSync 降到 0.607;相对 GDPO 的跨模态项也全面更好。LoRA 在 CLIP 0.330 与 DeSync 0.554 上更强。
- Table 2:full 模型 Audio Aes 3.631、Lip Sync 1.646、DeSync 0.542,均优于 GDPO 与基座。作者也诚实标出 LoRA VQ 与个别视觉真实感略低于基座的例外。
- Fig.2:爆炸尖峰、玩具车 Vroom/Beep/Boom 分段、入水瞬间等,AV-GRPO 波形与加粗事件更对齐。Fig.3:5DAV 雷达整体优于 VGGSound;去掉难度维子集多为负向相对变化;四步交替综合最好。
阅读时需要注意
- 结果依赖所选奖励模型与 LTX-2.3 双塔结构,换栈不保证同样增益。
- 视觉质量并非所有设置都提升,后训练可能牺牲部分单模态观感换同步与对齐。
- 数据消融主要在 mini 设定;全量基准上的数据消融细节有限。
- 预印本;开源代码便于核查,但不等于本次解读完成复现。
关联工作
- FoleyCrafter、MMAudio 等非对称视频到音频路线强在单模态先验,难做双向共生成。
- JavisDiT、UniVerse-1、LTX-2 等强调统一架构与预训练;AV-GRPO 补的是奖励后训练与信用分配。
- DDPO/DPOK/Flow-GRPO/DiffusionNFT 给出扩散/流 RL 骨架;GDPO 处理多目标标准化,AV-GRPO 进一步处理跨模态锚定。