快速导读:InsightMap 把顶视图地图同时当作显式空间记忆与动作后预测目标,在共享多模态骨干上联合学习导航与场景推理。
语言引导的具身任务要求机器人把当前局部观测接到此前到访过的空间上下文:既要知道“我在哪看过什么”,也要理解“这一步动作会如何改写我对环境的表征”。如果训练只监督动作标签,策略未必学会预测动作后的空间状态变化。
InsightMap(arXiv:2609.37187 ,曼彻斯特大学)把顶视图地图同时用作显式空间记忆与动作条件预测目标:历史视角与地图位置标签对齐,共享多模态骨干联合学习动作预测与 post-action 地图生成;同一空间接口还覆盖问答与三维定位。对齐 RGB-D 管线提供约 800K 训练例。
英文题目:InsightMap: Structured Spatial Modeling for Embodied Multimodal Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2609.37187
原始论文:PDF / 论文页面
这篇论文解决什么问题?
在 VLN 中,指令跟随依赖跨时间的空间一致性:当前 egocentric 视图必须与已访问地点、轨迹几何一起解读。地图能聚合空间证据,但常见做法仍主要把地图当输入条件,而不是让策略显式想象“动作之后地图长什么样”。
问答与三维定位同样要在多视点间绑定物体与空间关系。若导航与这些静态任务共享同一套“观测—地图—语言”接口,辅助空间训练有望反哺导航策略。
因此需要:可标注历史位置的地图记忆、动作条件的未来地图监督,以及能把导航转移、问答与定位样本对齐到同一表示的数据管线。
核心创新
- 地图空间接口:历史视角与标注观测位置绑定,服务导航与静态场景推理。
- 联合动作-地图训练:动作条件的 post-action 地图预测作辅助空间监督。
- 对齐 RGB-D 数据管线产出约 800K 多样本,统一多任务空间接口。
- 仿真与 Unitree Go2 真机均验证空间监督带来的导航增益。
方法概览
基于 BAGEL,InsightMap 将历史视角与地图位置标签对齐,用当前观测、顶视图地图与指令条件化共享理解-生成骨干;训练目标为动作文本,并附加动作条件的 post-action 地图生成作辅助监督。推理时只解码动作;对齐 RGB-D 管线统一支撑导航、VQA、情境推理与三维定位,共约 800K 样本。
- 空间记忆方面,步骤 t 的上下文包含指令、带位置标签的历史观测、当前观测与重建顶视图地图;地图保留位置标签、连通路与当前位姿标记,使视觉历史与轨迹几何可联合解读。
- 结构化世界想象把 post-action 地图 mt+1 与动作 at 一起作为训练目标:模型在预测“往哪走”的同时,学习动作如何改变空间表征。推理阶段只解码动作文本;地图生成仅作训练期辅助监督。
- 架构基于 BAGEL:VAE 编码 egocentric 帧,ViT 编码顶视图,文本编码指令;感知与生成模块经多模态自注意力共享,输出动作/速度标记及未来顶视图。数据上,导航约占 65%,问答与定位约占 35%,形成约 800K 语料。
逐图理解论文
地图监督缺口
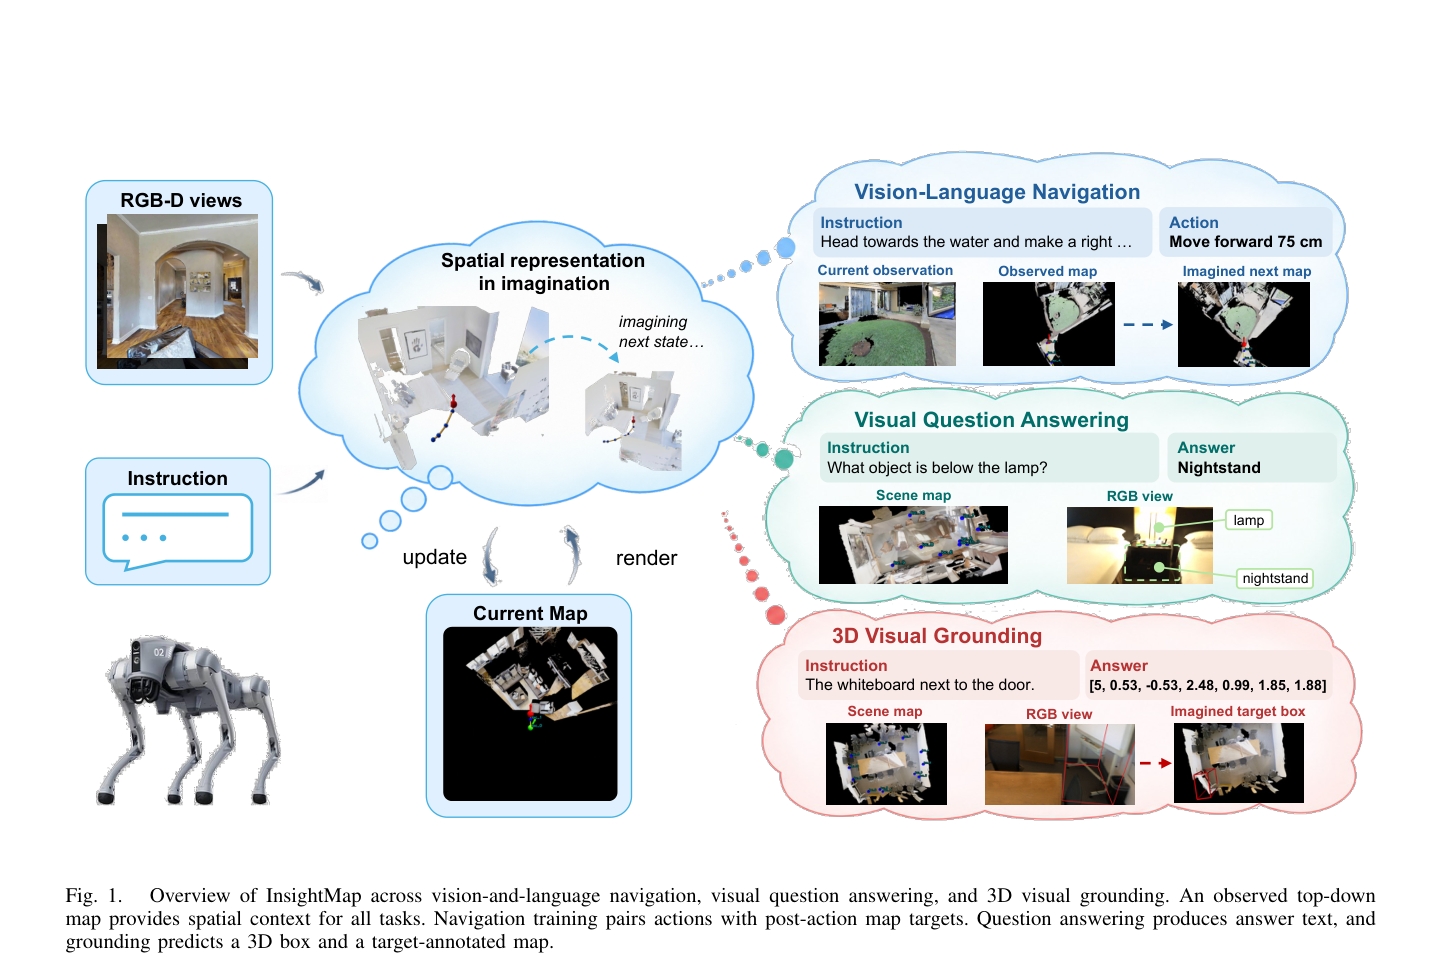
图1总览 InsightMap:RGB-D 与指令进入空间想象,更新并渲染当前顶视图地图,再分别支撑导航动作、问答文本与三维框/目标标注地图。宜作特色图。
联合动作与地图
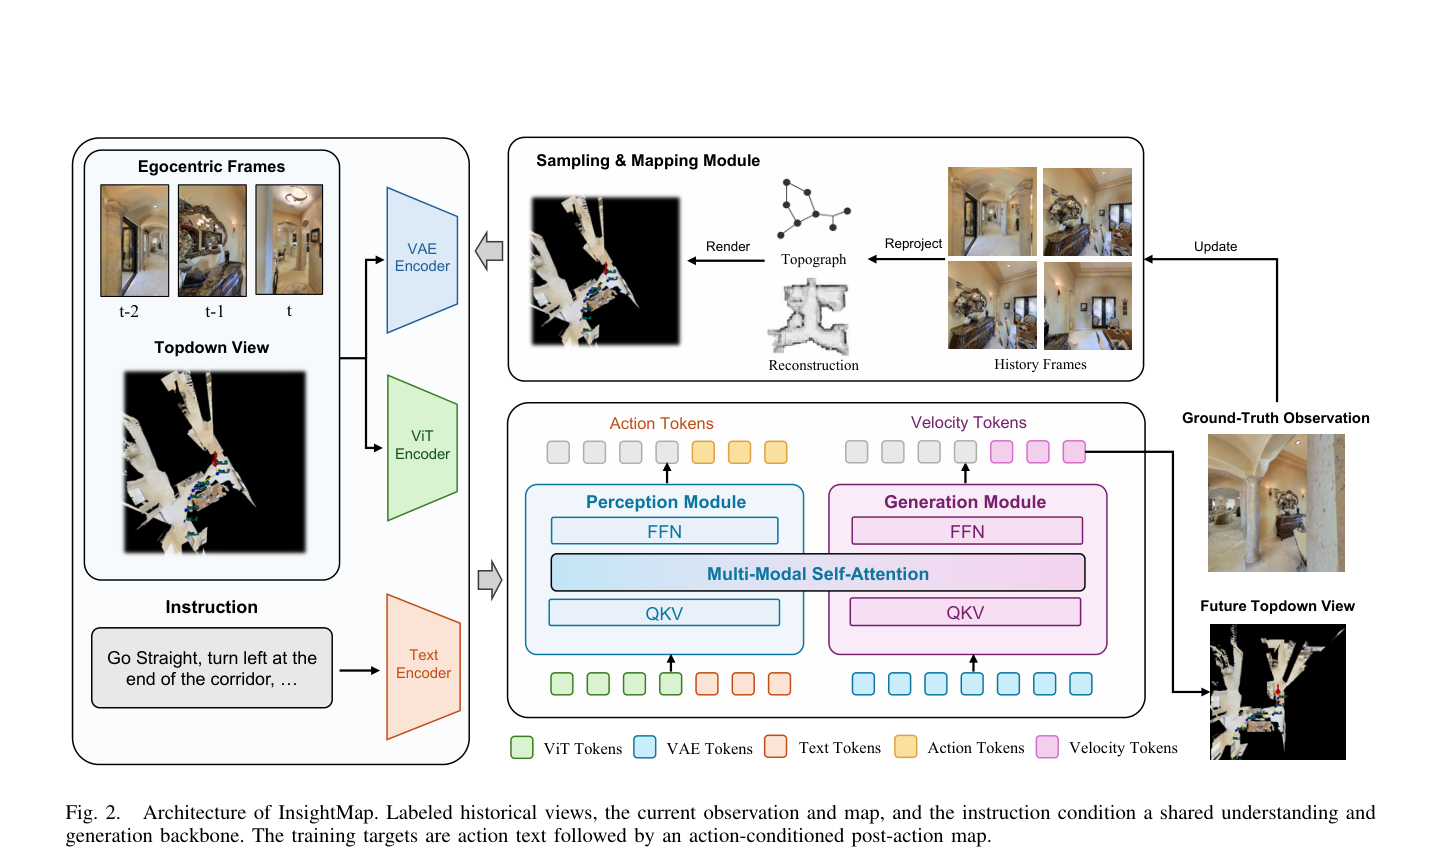
图2给出架构:历史视角、当前观测与顶视图、指令经 VAE/ViT/文本编码进入共享感知-生成骨干;训练目标为动作文本与动作条件的未来顶视图。
关键证据
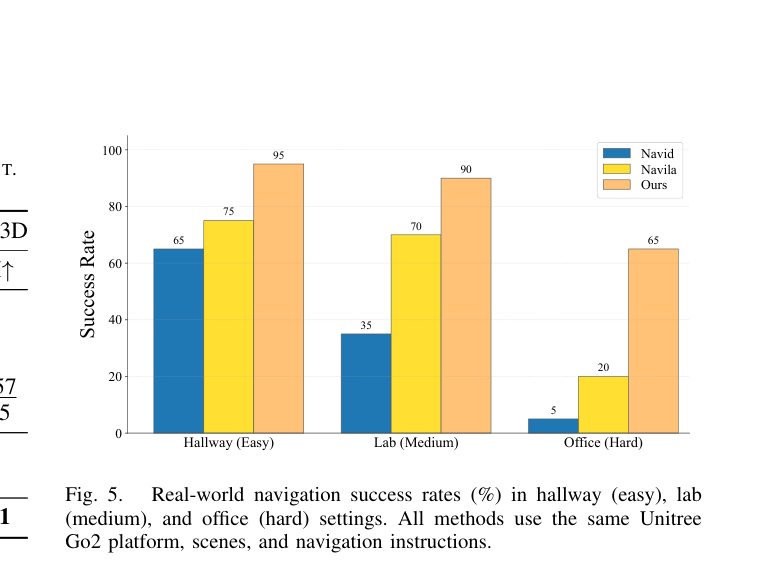
图5为 Unitree Go2 真机成功率柱状图:InsightMap 在走廊/实验室/办公室达 95%/90%/65%,相对 NaVILA 分别高出 20/20/45 个百分点,是具身迁移的直接证据。
实验如何设计?
- 仿真:Habitat 上 R2R-CE / RxR-CE validation-unseen,报告 NE、OS、SR、SPL(RxR 另含 nDTW)。
- 静态:ScanQA validation、SQA3D test、ScanRefer validation。
- 消融:地图预测监督、历史位置 ID、任务混合 vs 纯导航。
- 真机:Unitree Go2,同一场景与指令对比 NaVid、NaVILA;推理在单卡 H100 远端服务。
关键结果与论文证据
- R2R-CE 上 InsightMap 取得 SR 56.9%、OS 64.7%、SPL 50.7、NE 4.89;相对 NaVILA,SR/SPL 分别提升约 2.9 / 1.7 个百分点(页5,Table I)。
- RxR-CE 上 SR 54.9%、SPL 46.1%、nDTW 62.8,相对 NaVILA 的 SR/SPL/nDTW 增益约 5.6 / 2.1 / 4.0 个百分点(页5)。
- 地图预测监督使 R2R-CE SR +4.3、SPL +3.2;加入历史位置 ID 再抬 SR 约 2.8;全任务混合 56.9% 显著高于纯导航训练的 49.2%(页1)。
- 静态任务:ScanQA CIDEr 103.7,SQA3D EM 60.1%,ScanRefer Acc@0.5 达 53.1%(页7)。
- 真机走廊/实验室/办公室成功率 95%/90%/65%,相对 NaVILA 分别高 20/20/45 个百分点,困难办公室场景差距最大(页7,Fig.5)。
阅读时需要注意
- 地图质量依赖重建与传感器;真机设定使用 LiDAR 点云,部署条件不同于纯相机方案。
- 评测导航时不生成未来地图,辅助监督尚未等价于在线可滚动世界模型。
- 表格对照涵盖不同传感器与训练设定,跨方法绝对排序需结合协议阅读。
关联工作
- NaVILA、NaVid 代表强视觉语言导航基线。
- MapNav、GridMM 等强调地图增强的空间记忆。
- ScanQA / SQA3D / ScanRefer 则检验同一空间接口能否迁移到静态三维推理。