快速导读:PSA 用六参数条带掩码统一视频 DiT 的周期对角稀疏模式,并以单内核与离线搜索在可接受画质下加速推理。
扩散Transformer让开放域视频生成质量跃升,但也把推理拖得很慢:Wan 2.1 在H100上生成约5秒720p视频可接近半小时,全时空3D注意力往往吃掉六成以上时间。稀疏注意力是出路,可现有方法卡在灵活与效率之间——固定掩码盖不住各头各层各时间步的多样模式,运行时再算掩码又引入开销并打穿硬件友好布局。
Parameterized Stripe Attention(PSA,arXiv:2609.37001 ,阿里集团;https://arxiv.org/abs/2609.37001 )指出视频 DiT 注意力沿时空呈周期对角条带,并用六参数掩码 M(Tw,To,Ts,Sw,So,Ss) 统一表示;配套单CUDA核与训练免费离线搜索,在 HunyuanVideo 与 Wan 2.1 上相对 FlashAttention-3 分别取得约1.57×与1.37×端到端加速,画质下降可控。
英文题目:Parameterized Stripe Attention for Efficient Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.37001
原始论文:PDF / 论文页面
这篇论文解决什么问题?
第一类方法如 SVG、STA、Sparse-vDiT 依赖经验预定义模式:能做得很高效,但固定模板解释不了为何出现周期、也覆盖不了混合与多对角等占多数的头。第二类如 SVG2 把分布当近似任意,用聚类等在线决定掩码,灵活却难用TMA,并带来padding与聚类成本。
因此需要三点:对 DiT 注意力结构空间给出统一且够表达的刻画;一个能吃下多种掩码仍高利用率的硬件实现;以及不增加推理开销的逐头配置搜索。
作者从视频时空冗余与 RoPE-3D 余弦周期两方面解释条带宽度与步长来源,并在 HunyuanVideo、Wan 2.1 全头热图上归纳帧内、帧间、混合与均匀四类主模式。
核心创新
- 揭示并形式化视频 DiT 注意力的周期对角条带结构(理论+大规模实证)。
- 六参数统一表示覆盖帧内/帧间/混合/均匀模式,单高效CUDA核处理全部配置。
- 训练免费离线搜索为每头最大化稀疏度,推理无额外掩码开销。
- 在 HunyuanVideo / Wan 2.1 上相对 FA3 取得约1.57×/1.37×端到端加速且质量可接受。
方法概览
参数化掩码 M(Tw,To,Ts,Sw,So,Ss) 统一帧间/帧内宽度、偏移与步长;PSABlock 粒度重排布局,ThunderKittens 风格 producer-consumer CUDA 核达到接近 FA3 的利用率;3D-padding 支持任意分辨率;PSA-Search 在误差阈值下离线为每头最大化稀疏度(提示相对稳定,可分布式搜索)。
- 统一表示:M 用帧间宽度/偏移/步长与帧内宽度/偏移/步长六个整数控制对角条带。SVG、STA 成为特殊情形;作者称受限配置无法覆盖超过六成的头,而完整形式与全注意力热图平均余弦相似约0.9831。
- 高效内核:以 PSABlock 为最小计算粒度重排 QKV 布局,基于 ThunderKittens 实现 producer 按掩码异步预取、consumer 在块上做稠密注意力的流水线,追求 FlashAttention-3 级 MFU。分辨率不对齐时用3D-padding,文中720p场景额外开销约5%。
- 自动搜索:观察到注意力模式随时间步/层/头变化大,但对提示相对稳定,故可离线搜索。PSA-Search 在 L2 输出误差不超过阈值的候选中选最大稀疏,或反向按目标稀疏取最小误差;支持多卡并行,文中100候选约2.5小时/8×H100。
- 部署上前约20%去噪步仍走稠密FA3保质量,其后套用逐头稀疏配置,从而把内核加速兑现为端到端收益。
逐图理解论文
灵活效率两难
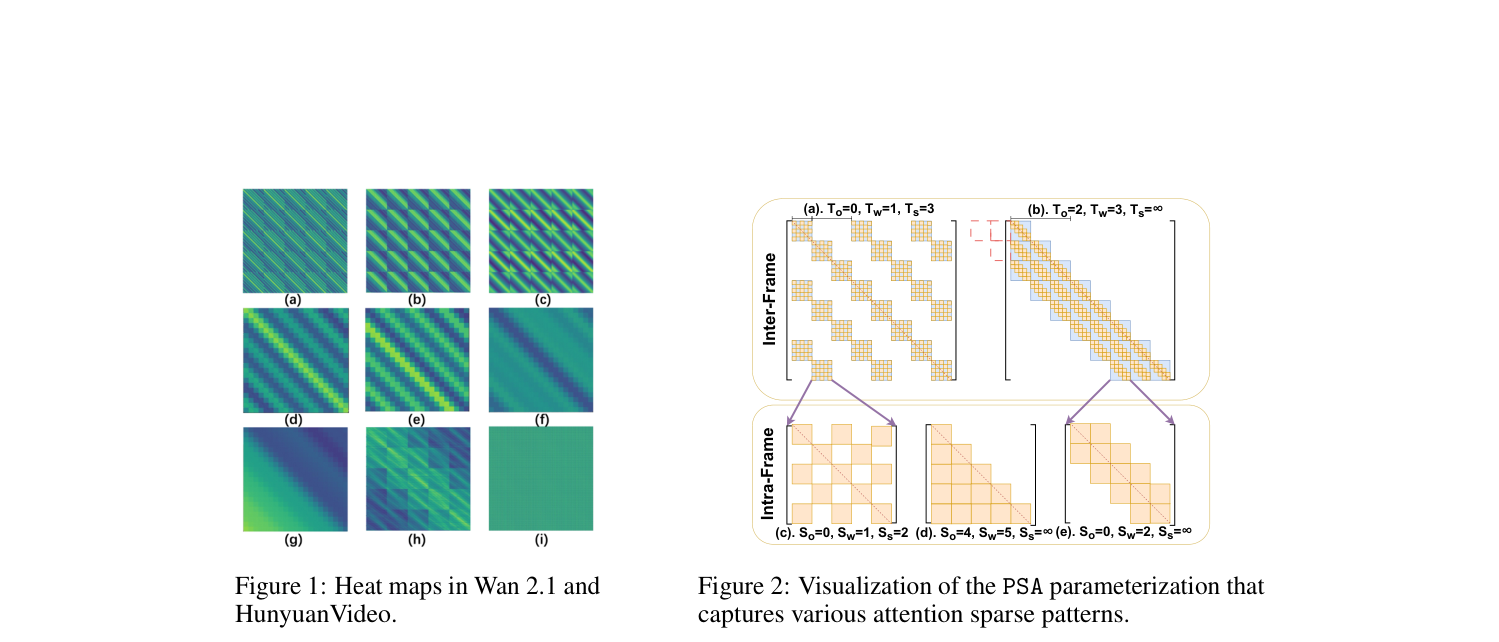
图1展示 Wan 2.1 / HunyuanVideo 注意力热图,可见细密周期对角、宽带对角、混合与近均匀等结构,是“条带规律存在”的直观证据。
内核与搜索
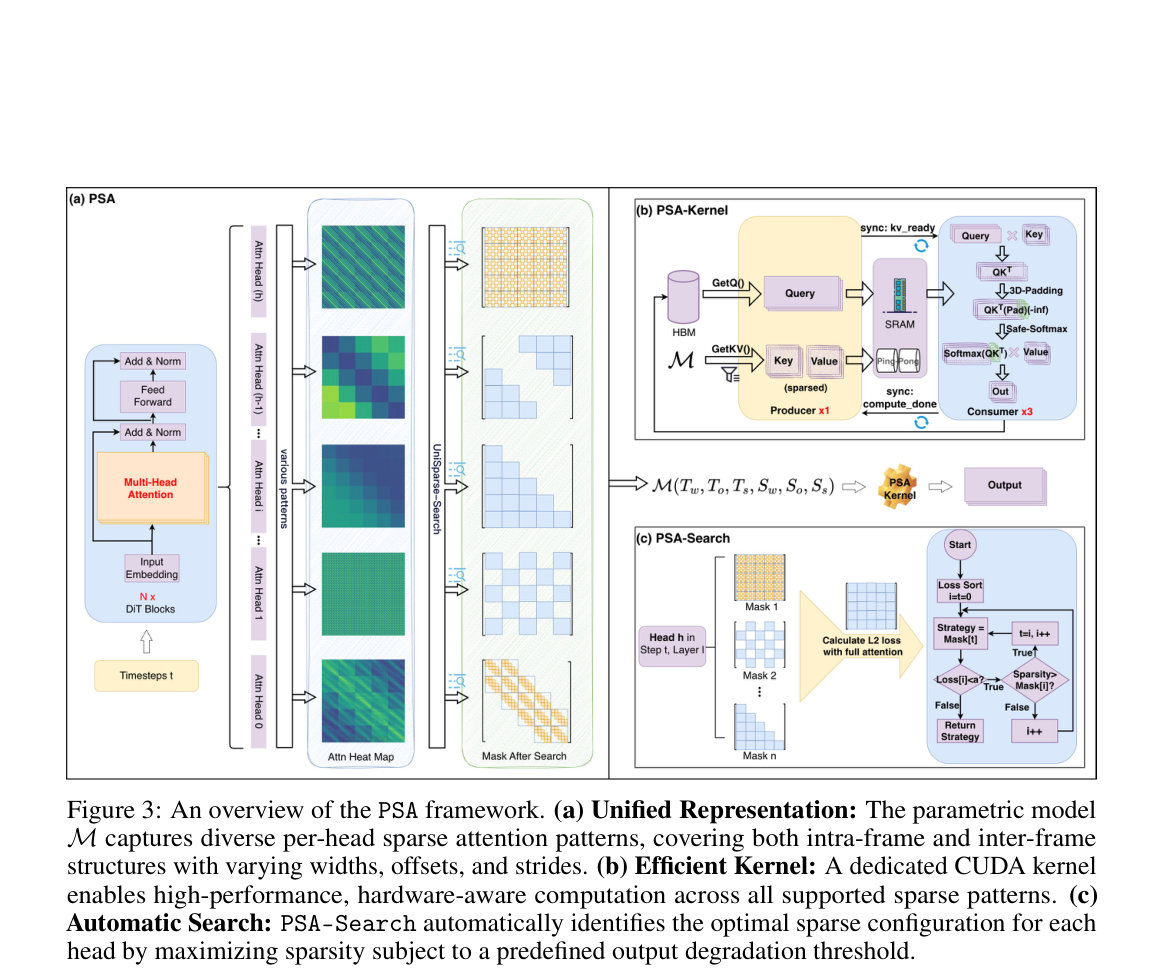
图3是PSA总览:(a) 统一参数化表示覆盖各头稀疏热图;(b) PSA-Kernel 的 producer-consumer 与参数 M 驱动计算;(c) PSA-Search 在误差阈值下最大化稀疏。宜作特色图。
Figure 2: Visualization of the PSA parameterization that captures various attention sparse patterns
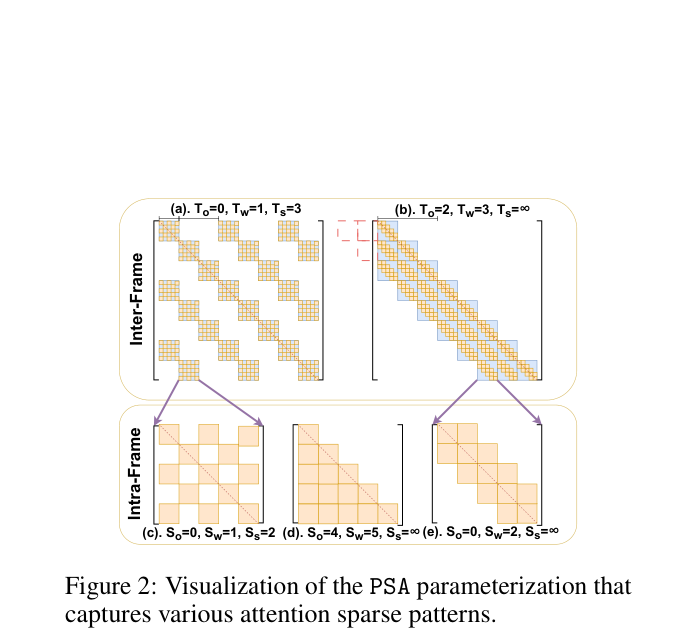
图2用 (To,Tw,Ts) 与 (So,Sw,Ss) 示例说明同一参数化如何表达步进条带、宽带窗口及帧内棋盘/三角/对角等模式,帮助读懂六参数的几何含义。
实验如何设计?
- 模型:Wan 2.1 14B(81帧,720×1280);HunyuanVideo 两档(129帧720×1280;117帧768×1280)。
- 质量:帧级 MSE/PSNR/SSIM/LPIPS,以及 VBench 的 overall consistency(OC)与 temporal style(TS)。
- 基线:FA2/FA3 稠密;SVG、SVG2;STA(因tile约束仅评768配置)。另做同掩码内核微基准、稀疏敏感度与六参数消融。
关键结果与论文证据
- 端到端:Hunyuan 768 上 PSA Spar 60.33%、703.91 s,相对 FA3 1.57×,OC 26.33、PSNR 27.20,全面优于 SVG/SVG2/STA;720 配置 1.51×且 PSNR 30.35;Wan 2.1 为1.37×、PSNR 23.48(页7,Table 1)。
- 内核:同掩码下 PSA 在 Wan 上约3.37×于FA3、MFU 53.68%;Hunyuan 768 上 MFU 61.21%,与STA接近但E2E更快(页8,Table 2)。
- 质量—稀疏:720配置上稀疏从30%到60%指标平滑下降,60%时PSNR仍约30.35;括号匹配基线稀疏的 Ours-min/max 在加速与PSNR上仍占优(页8–9)。
- 消融:固定60%稀疏时完整六参数 PSNR 30.35,显著高于仅帧间27.81、SVG-like 26.02、STA-like 26.15与仅帧内24.01,说明偏移与步长对多对角/混合模式关键(页10,Table 6)。
- 机制旁证:多模型设置下主导通道头比例很高(如 Wan 14B 约87.55%、Hunyuan 约96%),支撑 RoPE-3D 周期解释(Table 5)。
阅读时需要注意
- 若注意力结构偏离周期条带,或提示不变性不成立,离线搜索得到的掩码可能失效。
- 早期稠密步与3D-padding限制了端到端上限;换分辨率/骨干需重跑搜索。
- 论文以预印本形式给出方法与表结果,公开代码/项目页在摘要中未单列,工程落地需额外核对内核与配置发布状态。
关联工作
- SVG、STA、Sparse-vDiT 代表预定义/有限模式稀疏。
- SVG2、VMoBA 等代表运行时动态掩码。
- FlashAttention-3 与 ThunderKittens 提供高MFU稠密/内核基础设施。