快速导读:RelationVGGT 在无位姿多视图上做前馈三维空间关系分割:给定参考主体与关系文本,跨视角标出目标物体。
三维重建已经能从前馈多视图直接估几何,开词汇分割也能在三维高斯或特征场里按“椅子”“桌子”找到物体。真正缺的是关系:显示器是不是搁在这张桌上,杯子是不是在这块主体旁边。现有方法要么把场景当成孤立实体,要么像 RelationField 那样在辐射场里搜关系,但要标定相机并逐场景优化。
RelationVGGT(arXiv:2610.00970,Yonsei University 与 NVIDIA,NeurIPS 2026 poster)把任务写成前馈、无位姿的三维空间关系分割:给定多视图、参考视角上的主体掩码和一句关系查询(如 What is <mask> lying on?),在各目标视角分割满足该关系的物体,测试时不提供目标类别名。模型冻结 DINOv2 与 Pi3,用关系 Transformer 做主体条件的跨视角推理,再用文本相似度解码掩码。
英文题目:RelationVGGT: Visual Geometry Transformers for 3D Spatial Relation Segmentation
论文出处:arXiv 每日论文精选 · arXiv:2610.00970
原始论文:PDF / 论文页面
这篇论文解决什么问题?
图1左侧的室内多视图说明了设定:人指定一块主体,问它躺在什么上面,模型要在其他视角把床或沙发标出来。这比开词汇物体分割多了三件事:识别语义身份、判断有方向的空间谓词、在视角变化下保持同一实例。
LangSplat 与 OpenGaussian 把 CLIP 特征塞进三维原语,推理时只能把整句关系当文本提示,容易大片激活背景。RelationField 能分物体场和关系嵌入,但依赖位姿与数小时级的每场景优化。视频定位模型把多视图当视频,小基线时尚可,相机拉远后对应假设就破。
因此方法必须同时解决表征、推理和数据:无位姿几何与语义如何融合、主体如何条件化目标视图、以及哪来多视图一致的关系标签。
核心创新
- 把三维空间关系分割形式化为前馈、无位姿、无目标类别名的跨视角掩码任务。
- 融合 DINOv2 语义与 Pi3 几何,用主体掩码条件的关系 Transformer 做逐像素开词汇关系预测。
- 在 ScanNet++ 上用 VLM/LLM 自动生成多视图一致的关系监督,并做几何过滤与谓词改写。
- 在 Replica、LERF、ScanNet++ 上手动关系基准上对比特征场与视频定位模型,并检验主体掩码与谓词改写的稳健性。
方法概览
RelationVGGT 把先前的体搜索改成目标视图网格上的逐像素关系预测。冻结 DINOv2 提语义、Pi3 编码器提几何,通道拼接后经带 RoPE 的输入混合器得到每视图联合令牌。参考视图保留全部主体补丁并掩掉非主体区域,目标视图令牌拼成一条序列;关系 Transformer(ViT-S 配置)交替主体条件交叉注意力与全局自注意力,再由 DPT 式 mask decoder 上采样到像素对齐关系特征图,与 Jina Embeddings v3 / BERT 编码的查询做点积,sigmoid 后以固定阈值 τ=0.3 得到掩码。Pi3 点解码器另给出点图,把关系特征接到三维点。训练用多查询 sigmoid focal 与 Dice;数据来自 ScanNet++ 自动管线:实例掩码投影、SoM 提示 Qwen3-VL-8B 提成对关系、至少 3 帧一致、几何过滤接触/支撑等近距关系,再用 GPT-5.2 改写谓词。在 900 个场景上训练 200 epoch。
- 表征上,每张图走两路冻结编码器:DINOv2 给稠密语义,Pi3 编码器在任务头之前取出多视图几何令牌。两路在同一补丁网格上拼接,经线性投影加少量 Transformer(RoPE)的输入混合器,得到每视图联合令牌 Fn。
- 主体不用池化成一个向量,而是保留参考视图全部补丁、用下采样掩码把非主体位置清零,以保住空间布局。目标视图令牌拼成一条序列。关系 Transformer 按层交替:交叉注意力让每个目标补丁看主体令牌,自注意力让各视角目标补丁互相交换。L 层后经 DPT 式 mask decoder 得到像素对齐关系特征图 Rt,与查询嵌入 e(q) 做点积,sigmoid 后以 τ=0.3 二值化,不再做正负提示的 softmax。Pi3 点解码器另出点图与置信度,把关系特征接到三维。
- 训练把同一目标掩码对应的多种合法谓词(standing on / on / supported by)各自做 sigmoid focal,再加 Dice。标注管线在 ScanNet++ 实例点上投影掩码,SoM 标记可见物体后问 Qwen3-VL-8B;同一物体对至少 3 帧同意才保留,再按三维框与质心距离丢掉“远处还接触”的几何错误;GPT-5.2 把通过的三元组改写成 hanging on / mounted on 等同义查询。900 个场景、4×H200、batch 7、AdamW 1e-4、200 epoch,输出分辨率 512×388。
逐图理解论文
前馈关系架构
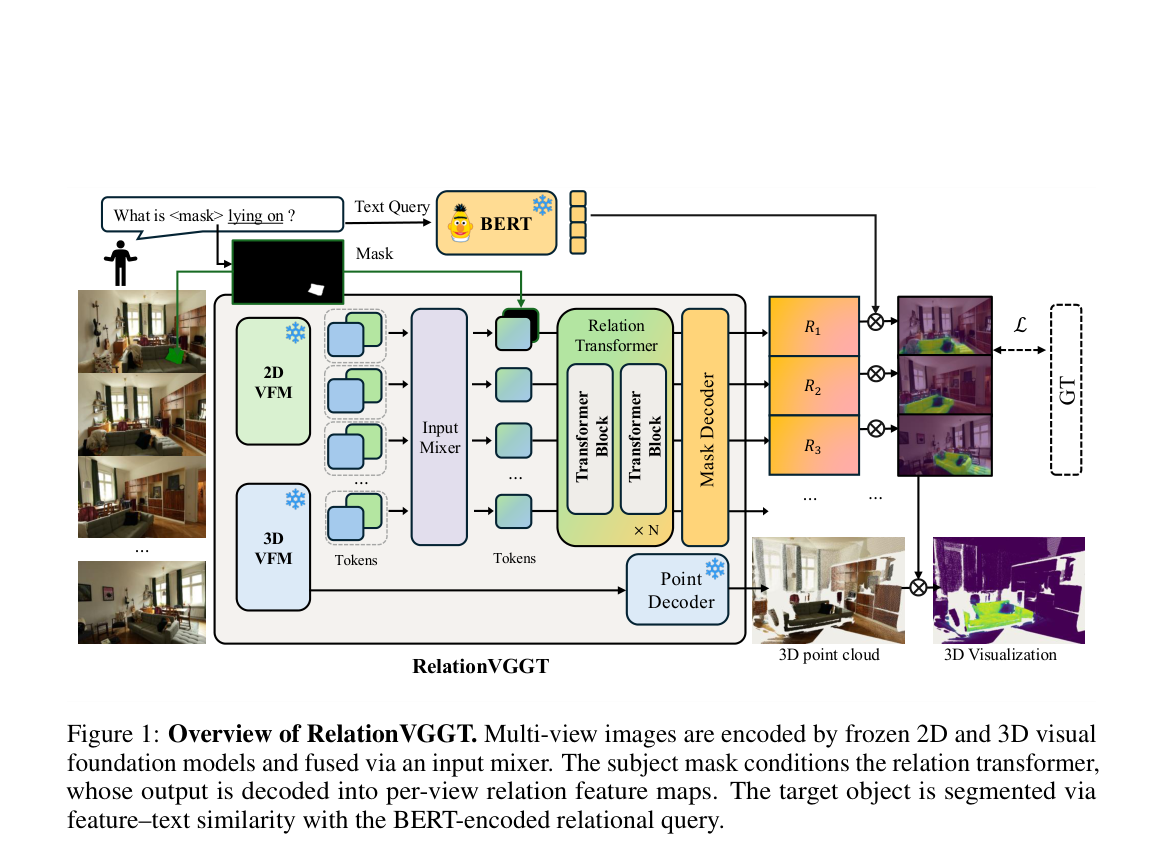
图1是方法总览,宜作特色图。左侧多张室内图与绿色主体掩码组成查询 What is <mask> lying on?,文本进带雪花标记的 BERT。中间冻结 2D VFM 与 3D VFM 出令牌,经 Input Mixer 融合后送入绿色 Relation Transformer(多层 Transformer Block),橙色 Mask Decoder 输出各视图关系特征图 R1、R2、R3,与文本向量相乘得到叠在目标视图上的掩码,右侧虚线框接 GT 损失。下方 Point Decoder 另出点云与三维可视化,把关系接到几何。
自动标注
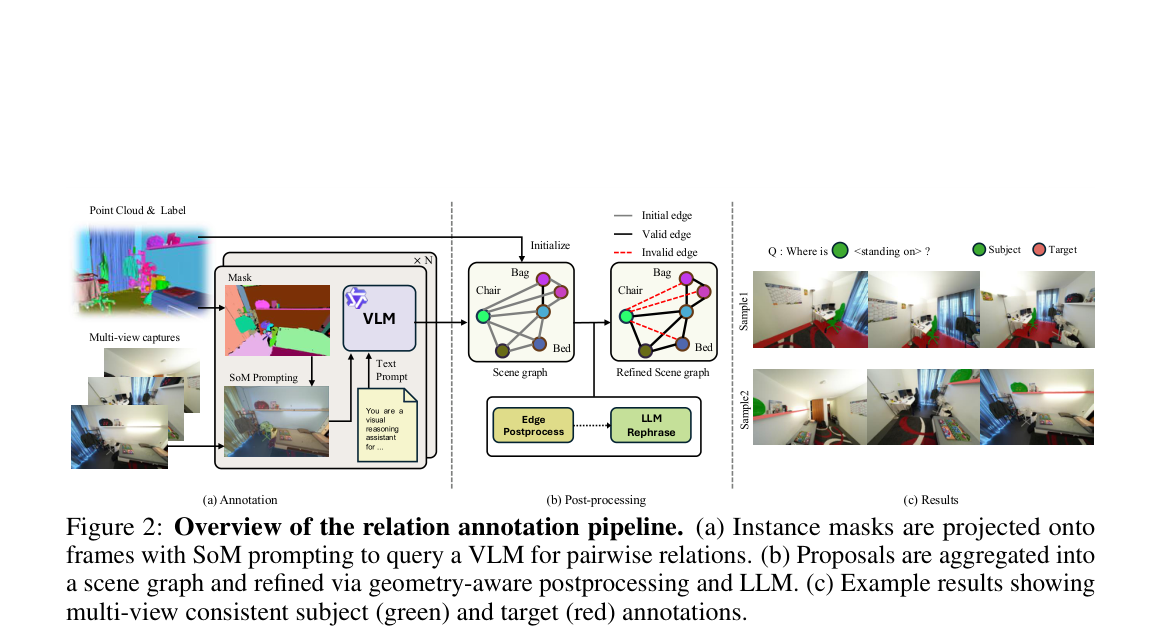
图2是自动标注管线。(a) 彩色点云与实例标签投影到多视图,SoM 在 RGB 上标物体后问 VLM;(b) 提案聚成 Bag/Chair/Bed 场景图,灰边为初始、黑边有效、红虚线无效,再经几何边后处理与 LLM 改写;(c) 两列样例用绿圈主体、红圈目标,问 Where is <standing on>?,跨视图颜色一致。
关键证据
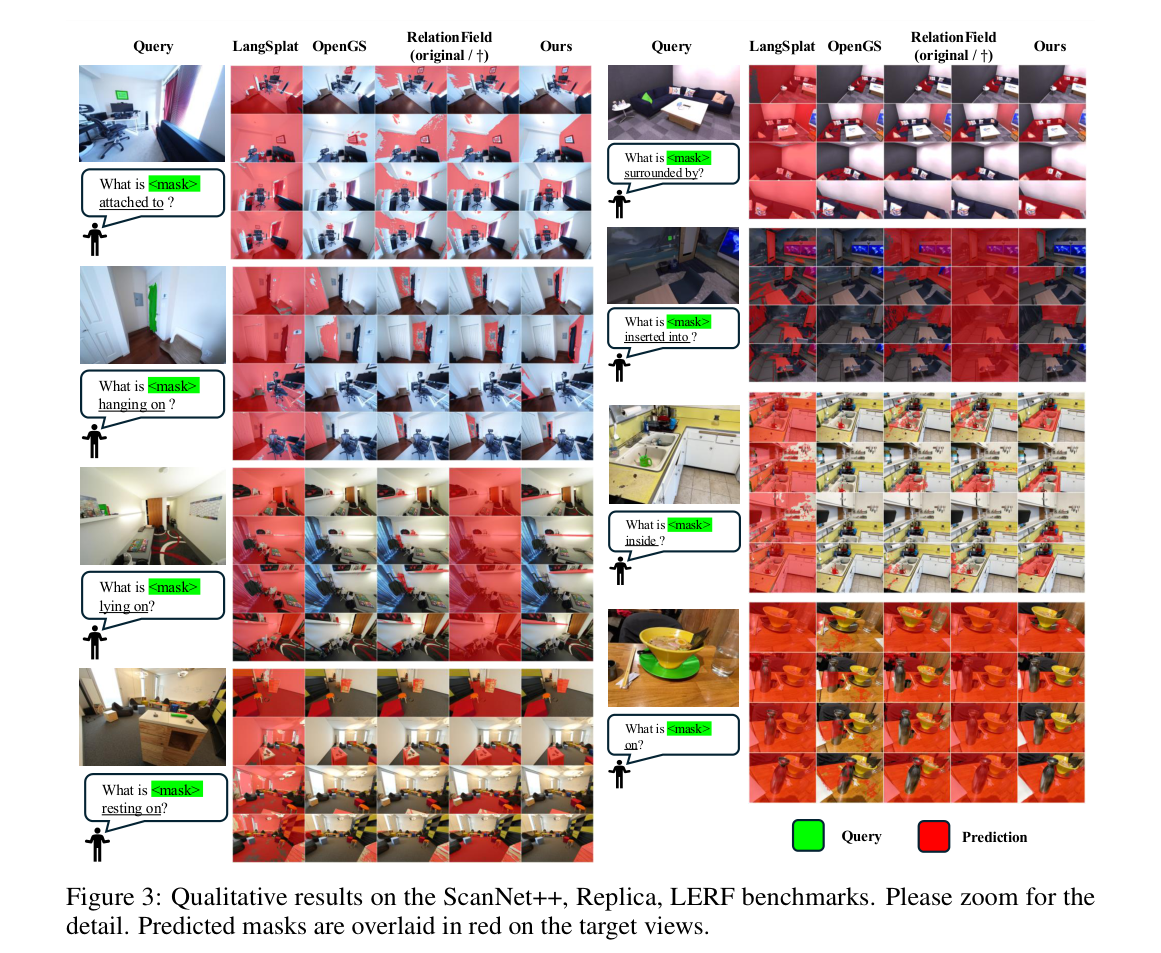
图3在 ScanNet++、Replica、LERF 上做定性对比。左列查询包括 attached to、hanging on、lying on、resting on,右列 surrounded by、inserted into、inside、on。列顺序为 Query、LangSplat、OpenGS、RelationField(original/†)、Ours。绿框是主体,红叠加是预测。对照列常见整墙整桌被染红,最右列更贴显示器、挂钩、床、桌面等目标。
结论与局限
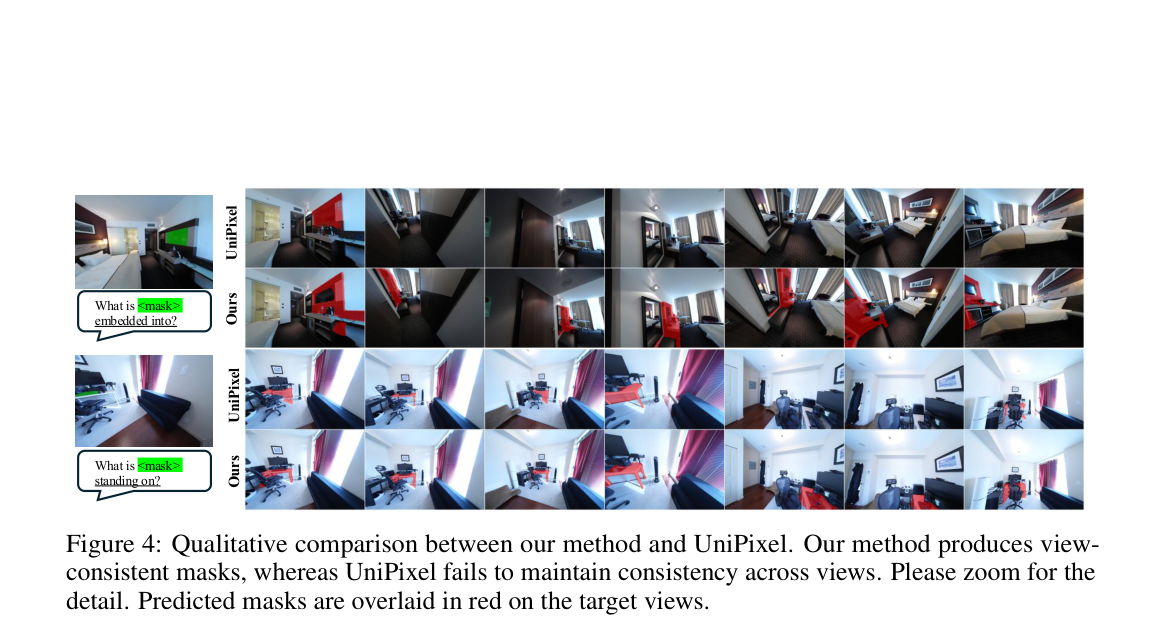
图4对比 UniPixel 与本文的跨视角一致性。上行查询 embedded into,主体是嵌进墙里的屏幕;下行 standing on。每行上方 UniPixel、下方 Ours,向右展开多张目标视图。UniPixel 的红区在部分视角跑到门、窗帘或相邻家具,本文更稳定地跟住同一目标。
实验如何设计?
- 评测在 Replica、LERF、ScanNet++ 上手工标注关系查询,共 119 条、28 个谓词;ScanNet++ 含 RelationField 原 26 条加 14 条新标。主指标 mIoU,辅以 IoU>0.25 的 mAcc。
- 特征场对照为 LangSplat、OpenGaussian、RelationField 与去掉目标检索的 RelationField†,它们都要位姿和逐场景优化。视频对照为 VideoLISA、SA2VA、UniPixel,输入同样给主体区域和关系句、不给目标类名,并按相机基线三等分。
- 消融在 ScanNet++ 40 条、τ=0.3 上进行。稳健性实验用同一检查点,把 GT 主体换成 SAM2 或自动定位,或把谓词换成同义、罕见、训练未见的说法。
关键结果与论文证据
- Table 1 上宏平均 mIoU/mAcc 为 0.382/0.549,高于 RelationField 的 0.303/0.480。Replica 与 ScanNet++ 提升明显(0.446 与 0.445),这两处轨迹覆盖整间屋子而非盯着单个物体。LERF 桌面小物体挤在一起,所有方法都低,本文 0.254,略低于 RelationField 的 0.276,但好于不检索目标的 RelationField†(0.232),且测试时仍不使用目标类名(页7–8)。
- Table 2 显示视频模型随基线变大而掉点:UniPixel 小基线 mIoU 0.423 略高于本文 0.417,大基线则是 0.354 对 0.366,mAcc 0.475 对 0.575。作者把稳定性归因于三维基础模型提供场景结构,而不是帧间时序对应。图4 里 UniPixel 跨视角红掩码漂移,本文更贴同一目标(页8–9)。
- 图3 中 LangSplat 与 OpenGS 红区大片溢到墙和地面,RelationField 更集中但仍毛边,RelationField† 几乎整景激活;本文在 attached to、hanging on、lying on、resting on 以及 surrounded by、inserted into、inside、on 等查询上边界更贴目标。消融表明去掉 Pi3 或 DINOv2 都会掉,pointmap 坐标代替 Pi3 特征也不如学习到的几何令牌;多查询损失优于单标签;去掉几何边过滤会把不合理接触写进监督(Table 3)。
- 主体不必像素级精确:SAM2 单击掩码 IoU 0.871,关系 mIoU 仍 0.383。自动定位里 Qwen3-VL+SAM2 还能保住大部分,GroundingDINO+SAM2 掉到 0.322,作者认为主要是参考视图里 58% 存在同类多实例,而不是边界不准。谓词同义几乎不掉,未见词干约掉 0.031 mIoU(Table 4–5)。附录还给出 L40S 上约 26 ms 的前馈推理,对比 RelationField 数分钟查询加数小时优化。
阅读时需要注意
- 数据管线绑在带实例标签的室内数据集上,野外和无标注场景还不能直接复制。
- VLM 提取关系偏保守、词表窄,即便有 LLM 改写,标注噪声与召回仍受 SoM 策略限制。
- 任务只覆盖物体间空间关系,没有功能关系,也没有同时预测场景图节点。
- LERF 杂乱桌面仍是短板;平均指标不能掩盖这一分裂上的困难。
关联工作
- 开词汇三维理解(LangSplat、OpenGaussian)解决“这是什么物体”,前馈几何(VGGT、Pi3)解决“场景长什么样”,RelationVGGT 把二者接到“相对这块主体,满足某关系的是哪一块”。
- 三维场景图通常先实例再分类固定谓词;本文 relation-first,与节点预测互补,作者也提到未来可接全景分支。
- 视频 grounding 强在语言对齐,弱在大基线三维一致性,Table 2 把这条分界画得很清楚。