快速导读:GenCOPE 只在合成数据上训练,用二维/三维语义一致性与跨模态融合,把类别级 9DoF 位姿直接泛化到真实抓取。
类别级位姿估计的卖点,是同一类里没见过的瓶子、杯子也能给出平移、旋转和尺度。可一旦换新类,现有方法往往还要再采真实标注。合成渲染能廉价提供准确位姿,却把模型推到另一道墙上:合成物体和真实物体最刺眼的差别是纹理,细粒度外观特征会把编码器锁在域特异线索里。
GenCOPE(arXiv:2610.01758,NeurIPS 2026,新加坡科技设计大学 IMPL Lab / 湖南大学 / 特伦托大学)只在 CAMERA25 上训练,推理时直接上真实 RGB-D。它假定类内部件结构比纹理更稳:二维上瓶子有盖、颈、容器,三维上是细颈圆柱、过渡锥和粗底圆柱。训练用这些语义去约束轻量全局特征,再用二维-三维交叉融合回归 9DoF。项目见https://paperreview99.github.io/GenCOPE/。
英文题目:GenCOPE: Syn2Real Generalized Category-Level Object Pose Estimation for Robotic Picking
论文出处:arXiv 每日论文精选 · arXiv:2610.01758
原始论文:PDF / 论文页面
这篇论文解决什么问题?
图1左侧绿圈是干净的合成瓶罐笔电,右侧橙圈是真实对应物,中间写 Huge Texture Gap。若特征提取器像常规识别网络那样追纹理,合成训练出的位姿器到真实桌面上就会漂。作者要的是类内未知物体上的 Syn2Real:训练不见真实标签,部署也不做测试时适应。
全监督 COPE 用真实标注或 CAD 形状先验换准度;省标注方法用无标真实数据、测试时适应或扩散 canonical map。它们很少把“合成与真实共享什么”写成训练约束。GenCOPE 的判断是:共享的是二维部件与三维几何原语,不是外观统计。
同时还要能上机器人:6 GB 显存、单帧 RGB-D、实时帧率。所以方法刻意不用稠密局部纹理对应,全程只走全局特征。
核心创新
- 提出只训合成、直接部署真实的 Syn2Real 广义 COPE,专为机器人抓取。
- 用 LLM 部件描述加 CLIP 文本,在二维和三维编码器上施加类内语义一致性约束。
- 2D-3D cross transformer 与解耦解码器做端到端 9DoF 回归,且只使用全局特征以保持轻量。
方法概览
输入为单张 RGB-D:Mask R-CNN 得到物体 RGB 与 1024 点点云。训练时用 Gemini-3 按模板生成每类十条二维/三维语义描述,随机抽一条,经冻结 CLIP 文本编码器得到 Ftext;ResNet18 与 PointNet 的全局特征 FC-2D/FC-3D 用 InfoNCE 式损失与同类文本对齐。再经成对堆叠的 2D-3D cross transformer(自注意力后交叉注意力,外内对称残差)融合,拼接后由三个 MLP 分别回归 t、R、s。总损失为两项语义损失加位姿 L2。推理去掉文本支路,一次前向输出 9DoF。全程只用全局特征。
- 预处理与多数 COPE 相同:Mask R-CNN 分割物体 RGB,深度反投影并采样 1024 点。RGB 裁到 192×192。随后图像走 ResNet18,点云走 PointNet,都只取全局特征。
- 语义约束只用在训练。Gemini-3 按模板生成“All cls. consist of [n] features: …”,每类十条描述随机抽一条,降低单次生成不确定。瓶子的二维描述是 cap、neck、base container,三维是 small neck cylinder、transition cone、large bottom cylinder。冻结 CLIP 文本编码器给出 512 维 Ftext。
- 对每个样本,把视觉全局特征与同类文本特征做温度 τ=0.07 的对比学习,batch 内同类为正、其余为负,二维和三维各有一项损失。这样编码器被推去对齐部件语义,而不是合成纹理。消融显示只提供类名文本或改成余弦损失都会掉点,说明有效的是结构化部件描述。
- 融合阶段把 FC-2D 与 FC-3D 送进成对堆叠的 2D-3D cross transformer:每块先自注意力、再交叉注意力(本模态 Q,对模态 K/V),并由外向内做对称残差,把浅层与深层语义加在一起。最外层拼接成 Fout,三个 MLP 分别回归 t、R、s。总损失是两项语义损失加三位姿 L2。
- 推理时语义文本支路整段卸掉,不需要类别文本,也不做额外优化,单次前向给出 9DoF。LLM 与 CLIP 都不进入部署图。
逐图理解论文
失败直觉
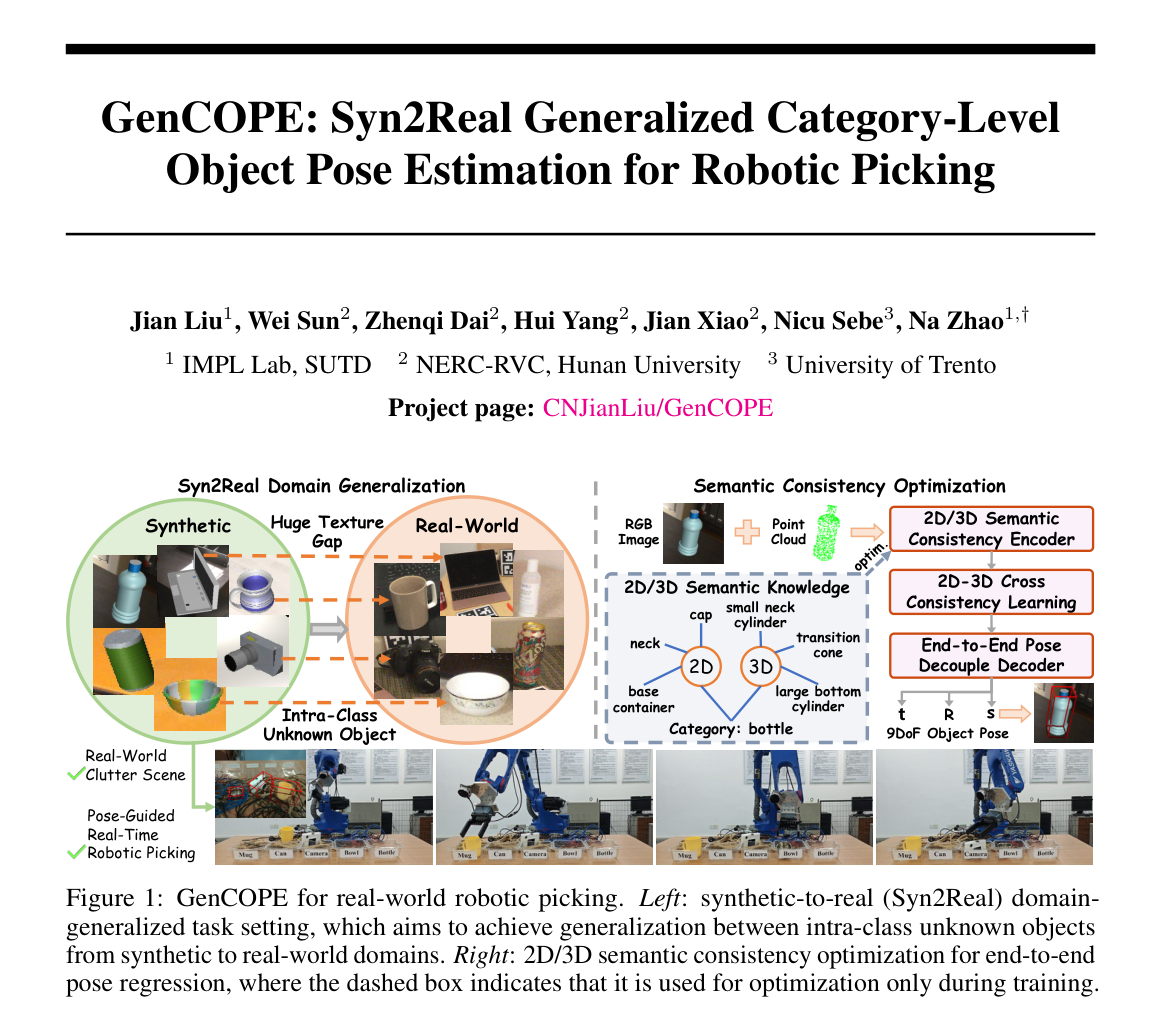
图1左侧用绿橙两圈画合成到真实的纹理鸿沟,底部是杂乱桌面上的抓取序列。右侧虚线框给出训练期模块:2D/3D 语义编码器、交叉一致性、解耦解码器;瓶子图把 cap/neck/base 与三维圆柱-锥-圆柱对齐。虚线表示这些语义约束不进入推理。
方法贡献
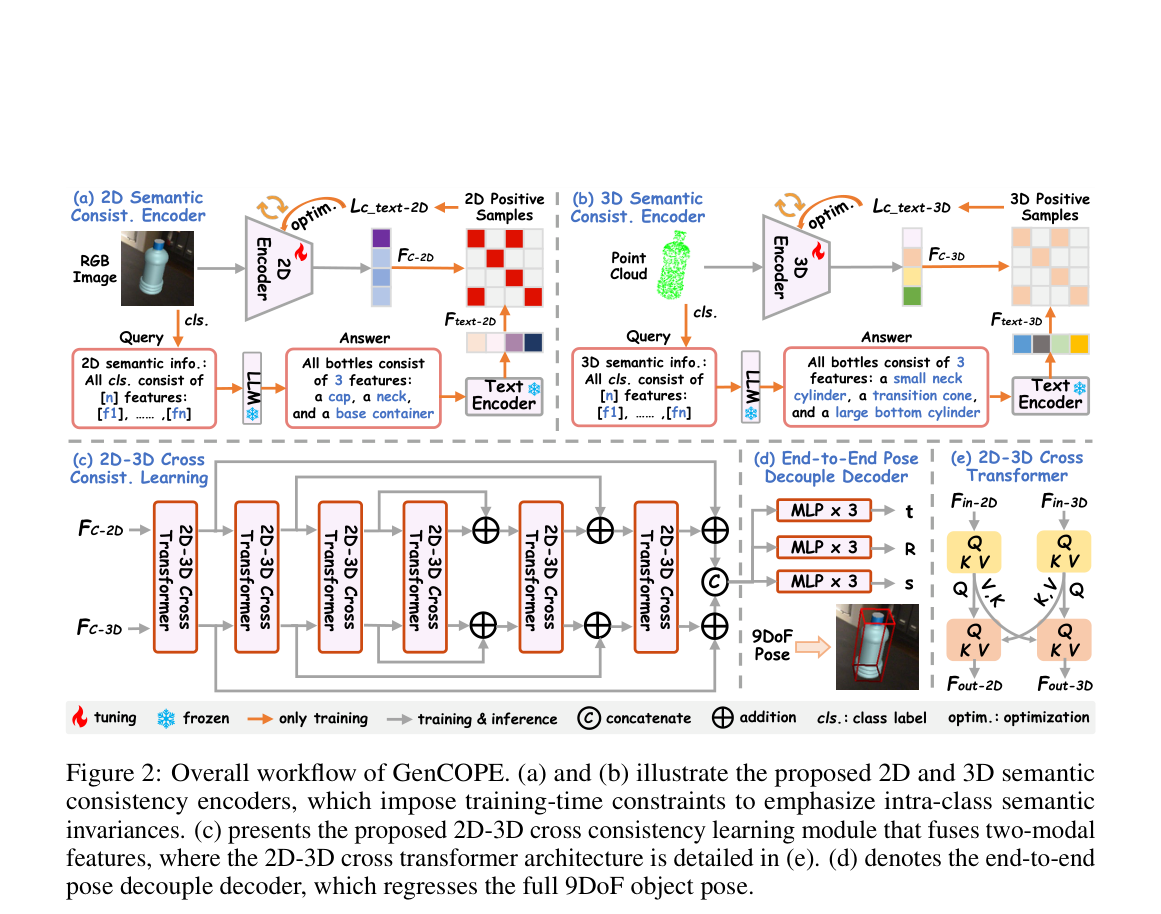
图2是架构总览,宜作特色图。(a)(b) 显示可训练视觉编码器被冻结 CLIP 文本拉向部件描述;(c) 六块交叉 Transformer 做对称残差后拼接;(d) 三个 MLP 分别出 t、R、s;(e) 画出自注意力后交叉注意力。读图时注意雪花图标:LLM 与文本编码器只在训练出现。
关键证据
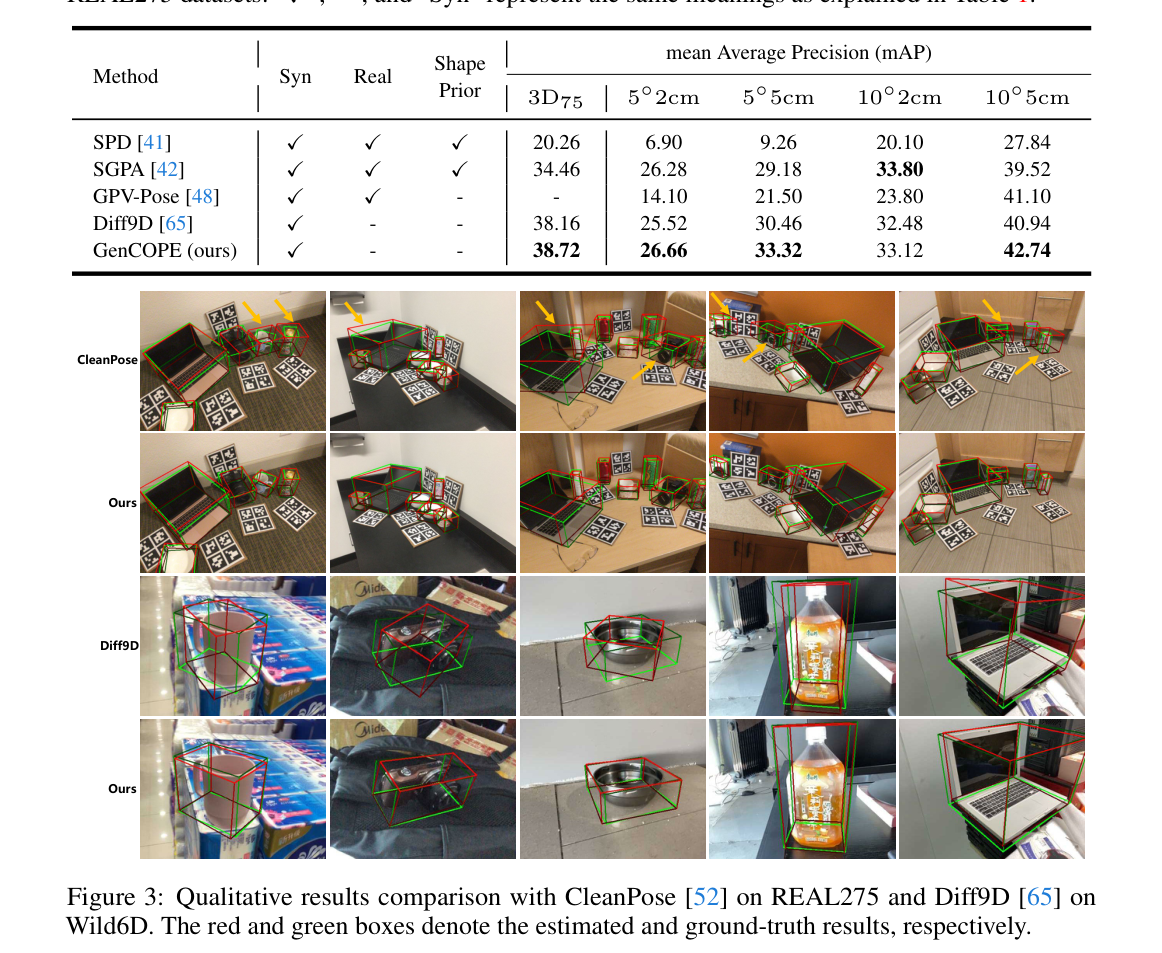
该资产上半是 Wild6D 的表2,下半是定性网格。红框是估计、绿框是真值。上两行对比 CleanPose 在 REAL275 的朝向误差,下两行对比 Diff9D 在野外背景中的歪框。表中 10°2cm 一项 SGPA 更高,讲结果时不要说全面第一。
结论与局限
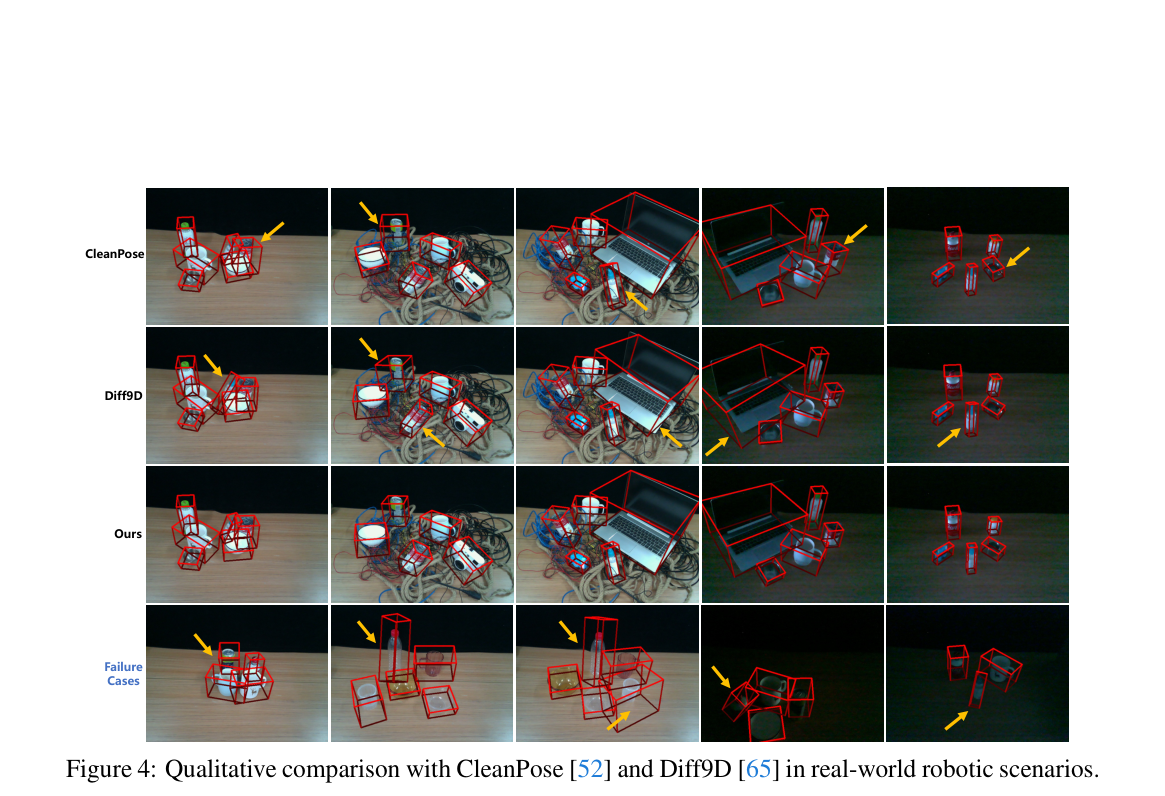
图4把同一真实桌面分给 CleanPose、Diff9D 与 Ours,黄箭头标对照的错向;最下一行 Failure Cases 给出遮挡瓶、透明物和暗光漂框。没有绿框真值,适合讲部署与局限,而不是报分数。
实验如何设计?
- 训练只用合成 CAMERA25(约 250K 图、1085 实例)。真实测试为 REAL275 与 Wild6D,外加自采集抓取桌面。公开实验在 RTX 3090 24 GB;机器人实验在 GTX 1660 6 GB 加 RealSense L515。
- 为公平,对照凡有 CAMERA25 官方权重就直接评;否则用官方代码只在 CAMERA25 上重训。REAL275 还分两种分割:ImageNet 预训练 Mask R-CNN,以及只在 CAMERA25 上训练的 Mask R-CNN,避免真实分割标签泄漏。
- 指标为 CATRE 口径的 IoU3D@75 与 5°2cm 等到 10°5cm。效率在同一计算平台报推理显存和 FPS。消融在 REAL275 上拆语义编码器与交叉融合。
关键结果与论文证据
- REAL275、CAMERA 分割下,GenCOPE 取得 3D75 44.5、5°2cm 38.1、5°5cm 49.9、10°2cm 56.4、10°5cm 74.4,超过同样只训合成的 Diff9D 与 CleanPose,也不使用形状先验或无标真实数据(页7)。
- ImageNet 分割协议下同样全面领先,5°2cm 39.7、10°5cm 71.6。Wild6D 上 3D75 38.72、5°2cm 26.66、5°5cm 33.32、10°5cm 42.74 为表中最优;10°2cm 33.12 略低于用了真实数据与形状先验的 SGPA(33.80)(页7–8)。
- 效率:推理显存 2.89 GB、40.68 FPS,对照 CleanPose 10.04 GB/24.33 FPS、Diff9D 9.60 GB/17.20 FPS。作者把轻量归因为 ResNet18/PointNet、全局特征和紧凑解耦头(页8–9)。
- 图3里 CleanPose 在 REAL275 笔记本和罐上出现黄箭头标出的旋转/尺度偏差,Diff9D 在 Wild6D 圆柱和锅上红框歪出绿框;Ours 红绿更重合。图4真实桌面上对照在线缆堆和低光里朝向不稳,失败行则集中在遮挡、透明和极暗(页8–9)。
- 消融:去掉二维语义约束后 5°2cm 从 38.1 降到 34.0,去掉三维降到 36.5;类名文本或余弦损失也会全面下降。换成 Qwen2.5-VL-7B 或 GPT-4 生成描述仍接近原结果。去掉交叉融合后 5°2cm 降到 34.9(页10)。
阅读时需要注意
- 当前损失不考虑强对称物体的等价旋转,评测协议也未做对称感知修正。
- 严重遮挡、透明物体深度残缺和极低光照仍会失败,与合成训练域差距大。
- 系统依赖实例分割质量;Wild6D 的 10°2cm 也尚未全面超过所有带真实监督的先验方法。
关联工作
- NOCS 把 COPE 写成归一化坐标回归;后续形状先验方法用 CAD 库换类内形状变化,代价是人工建库。
- CleanPose 代表全监督 RGB-D 路线,Diff9D 与 DiffusionNOCS 代表扩散式 Syn2Real。GenCOPE 不走生成式 canonical map,而走语义一致性加轻量回归。
- UDA/TTA 方法仍要在真实域适应;本文把适应换成训练期文本约束,推理保持单次前向。