快速导读:SMI 用微调 MLLM 以聚类、簇内稀疏、动作检索和可靠性过滤四步管理世界模型的空间长时记忆。
长视频世界模型要按用户动作和历史观察预测下一帧,记忆越积越长、场景越走越复杂时,存什么、取什么、哪些新观察够可靠,都会一起恶化。压缩往往丢掉细粒度空间证据;只按几何或语义检索,又会在遮挡、相似外观、错误位姿上选错历史。Spatial Memory Intelligence(SMI,arXiv:2610.02521,港中深 / 阿里 / 南大 / 滴滴 Voyager 等)主张:把理解模型系统性地接到世界模型的空间记忆管理上,而不是只让生成器自己隐式记。项目页 https://spatial-memory-intelligence.github.io/
SMI 把管理拆成四个原子操作:空间聚类、簇内稀疏化、动作感知检索、可靠性过滤。理解模型用 Qwen3.5-4B,并在约一千条真实推理轨迹上做操作导向微调。HY1.5-8B 与 Wan2.2-5B 两条 WorldPlay 骨干上,相对 FoV 基线与 FramePack、Deep Forcing、MoC、VMem、MemFlow,稀疏率可到约 83.68%,同时抬高空间一致性与生成稳定性。预印本,未同行评审;作者称将公开数据与权重。
英文题目:Spatial Memory Intelligence: Endowing World Models with Understanding-Driven Long-Term Memory
论文出处:arXiv 每日论文精选 · arXiv:2610.02521
原始论文:PDF / 论文页面
这篇论文解决什么问题?
视频世界模型把新生成观察不断追加进历史,再作为未来预测的上下文。这会同时碰到三件事:全存太冗余、回访旧区域时要对上语义与几何、错误观察一旦入库会在自回归里放大。图1左侧把现有路线画成两类失败:压缩可能把关键空间证据压没;几何检索在遮挡下取到看不见的内容,语义检索则把别处的相似外观当成同一地点。
相关工作里,压缩(FramePack、部分 Deep Forcing 用法)把历史收成有界表示;稀疏计算只降注意力成本,不管长期该留什么;几何检索(VMem 等)依赖相机/重叠,对遮挡、动态、语义变化和几何误差敏感;语义检索(MemFlow 等)难区分不同地点的相似内容。SMI 认为缺的是能同时组织、稀疏、检索并判断可靠性的统一记忆管理器。
核心创新
- 首次把理解模型系统用于长视频世界模型的空间记忆管理,并定义四个原子操作。
- 用空间聚类先整理乱序回访历史,再在簇内稀疏,避免全局删掉关键区域。
- 为四类操作构造多模态决策监督,微调 Qwen3.5-4B 统一执行。
- 在写入端加入可靠性过滤,减少漂移块被后续复用。
方法概览
SMI 在生成步维护 M_k。可靠性过滤决定新块是否入库;空间聚类按相机短名单加 MLLM 匹配把块归入已有簇或开新簇;簇达阈值后簇内稀疏删除无新结构的中间项;动作感知检索先几何 Top-K 再由 MLLM 结合近期上下文与当前动作选择至多 P_r 条历史。四个操作均有操作导向监督,Qwen3.5-4B 做 SFT。
- 形式化上,动作条件世界模型逐步生成 x_k,条件是被选中的历史子集与当前动作 a_k。SMI 在每步维护记忆库 M_k。新块 C_k 先经可靠性过滤决定是否入库;入库存完再聚类、必要时簇内稀疏;生成下一步时再按动作检索。
- 空间聚类针对“时间近不等于空间近”。用户动作会让相机乱序回访,时间线上 Scene A/B/C 交错、同场景远距离重复。SMI 用相机位姿先短列出最近簇原型,再由 MLLM 判断新块是否匹配某一原型;匹配则归入该簇,否则开新簇。簇原型取簇内投影覆盖最大的记忆项。
- 簇内项按生成时间排序。当簇大小达到触发阈值 T_s,MLLM 比较中间项:相对邻域没有新空间结构、物体状态或遮挡关系的,可删。保留数量不预先钉死。因为只在空间一致的簇内删,不同区域的关键证据不会被全局稀疏一刀切掉。
- 动作感知检索先用当前相机与动作按空间重叠取 Top-K_g 候选,再把近期上下文、当前动作和候选一起交给 MLLM,最多返回 P_r 条、也可以返回空集。可靠性过滤则对每个新块输出 admit/discard:明显视觉漂移的块不进 M_k,避免后续当参考。四个操作都做成可学习的多模态决策,用教师模型加人工复核得到监督,再对 Qwen3.5-4B 做交叉熵 SFT。
逐图理解论文
检索失败
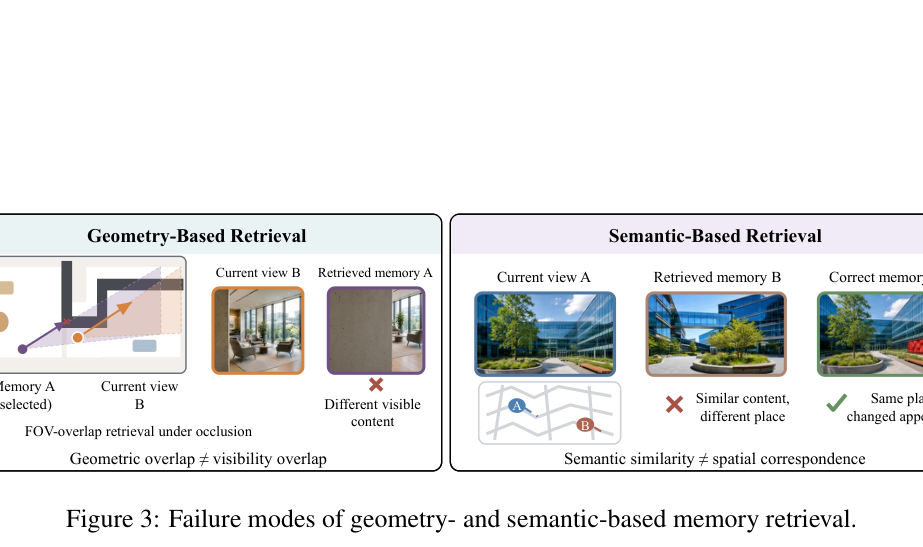
图3对照两种检索失败。左 Geometry-Based Retrieval:俯视平面里橙色当前视野 B 与紫色 Memory A 的 FOV 重叠,但 Current view B 是明亮客厅,Retrieved memory A 是混凝土墙面,标注 Different visible content,结论 Geometric overlap ≠ visibility overlap。右 Semantic-Based Retrieval:Current view A 与 Retrieved memory B 都是玻璃楼加绿地,地图上 A、B 却是不同地点,标 Similar content, different place;Correct memory A 才是同一地点的外观变化。
四个操作
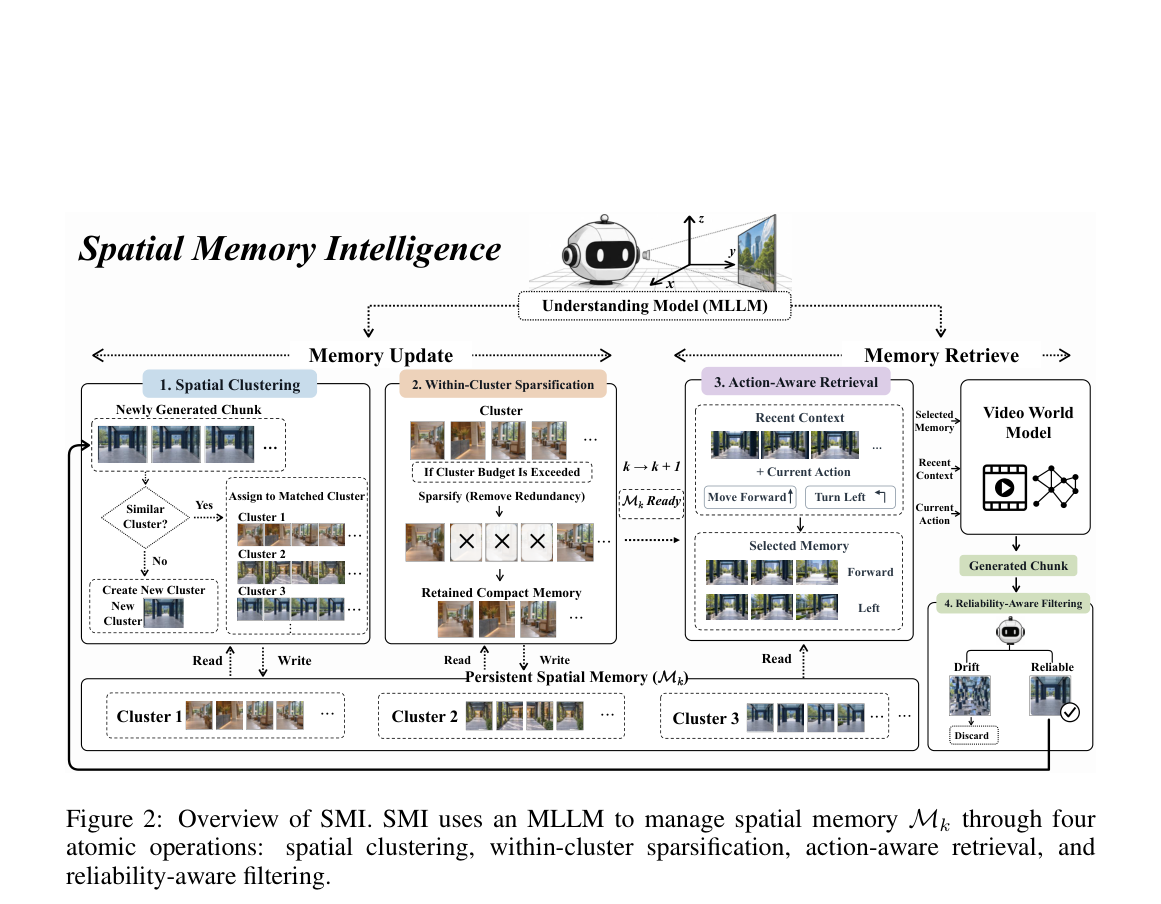
图2是方法总览,宜作特色图。顶上 Understanding Model (MLLM) 分管 Memory Update 与 Memory Retrieve。左栏 Spatial Clustering:新块问 Similar Cluster?是则写入 Cluster 1/2/3,否则 Create New Cluster。中栏 Within-Cluster Sparsification:簇预算超限则打叉去掉冗余,留下 Retained Compact Memory。底栏 Persistent Spatial Memory (M_k) 按簇存放。右栏 Action-Aware Retrieval 用 Recent Context 加 Current Action(Move Forward / Turn Left)选出 Selected Memory,交给 Video World Model 生成 Generated Chunk;Reliability-Aware Filtering 把 Drift 丢弃、Reliable 打勾写回。
Figure 1: Motivation and benefits of SMI
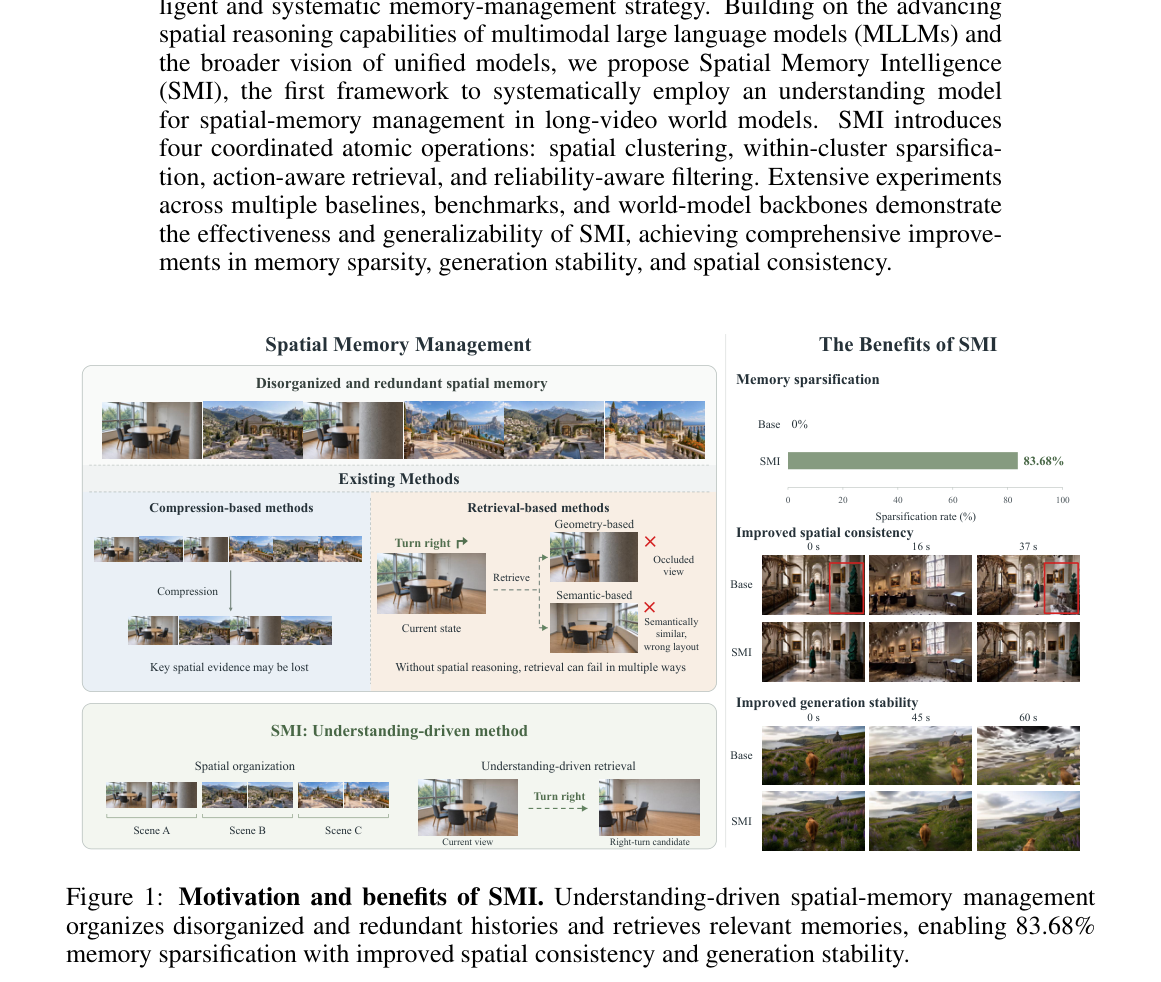
图1上半被摘要正文裁进画面,讲图时忽略那段文字。左列对比:无组织冗余记忆;压缩可能丢失关键证据;几何检索标 Occluded view,语义检索标 Semantically similar, wrong layout。绿色 SMI 行把记忆按 Scene A/B/C 组织,并用 Turn right 取到 Right-turn candidate。右列 The Benefits of SMI:稀疏条 Base 0%、SMI 83.68%;空间一致性 0s/16s/37s,Base 红框区域漂移而 SMI 更稳;生成稳定性 0s/45s/60s,Base 草地场景崩坏,SMI 仍连贯。
实验如何设计?
- 骨干是 WorldPlay-1.5 的 HY1.5-8B 与 Wan2.2-5B。Qwen3.5-4B 用 AdamW、学习率 2e-5、全局 batch 64 微调。对照除两条骨干自带的 FoV 检索外,还有 FramePack、Deep Forcing(压缩)、MoC(稀疏路由检索)、VMem(几何)、MemFlow(语义)。所有方法共用同一初始观察、动作序列、随机种子、上下文预算和生成配置。
- 协议分四块:VBench 的背景一致性、运动平滑、美学质量;三个独立 GPT-5.6-sol 盲评的相机约束场景一致性与整体视觉质量;往返相机轨迹上对应帧的 PSNR/LPIPS;用户研究(附录)。VBench 与 GPT 评测用 100 条随机一分钟 rollout,重建用另外 100 条含回访的一分钟轨迹。测试场景与训练隔离。稀疏率定义为被删记忆项占总记忆的比例,Base 为 0%;延迟相对 Base 记为倍数。
关键结果与论文证据
- HY1.5 上(Table 1),SMI 把美学质量从 Base 的 0.445389 提到 0.469357,GPT 场景一致性从 51.6053 提到 67.0200,PSNR 从 12.4785 提到 13.3093 dB,稀疏率 83.6842%,延迟约 ×1.38。FramePack 稀疏更高(94.38%)但场景一致性与 PSNR 掉到 Base 以下;VMem 一致性有提升但稀疏为 0 且更慢(×1.47)。Wan2.2 上(Table 2)稀疏 82.2073%,GPT 整体视觉质量 51.4909,高于 Base 的 37.8363,PSNR/LPIPS 也最好,不过 VBench 背景一致性低于 Base,说明收益主要在重建与评测一致性,而不是所有自动指标都领先。
- 消融(Table 3)始终保留动作感知检索。去掉可靠性过滤后美学与稀疏略降;去掉空间聚类后 PSNR 掉到 11.05、LPIPS 变差,作者解释为全局稀疏会丢掉重要空间证据。只留过滤时稀疏只剩 35.74%。无微调的 Qwen3.5-4B(Table 4)GPT 场景一致性从 67.02 掉到 42.84,PSNR 掉到 9.40,说明四个操作需要专门监督,不能指望通用 MLLM 直接会管记忆。
阅读时需要注意
- SMI 未与世界模型端到端训练,不直接提高骨干的内在生成能力,上限仍受基座画质、可控性和稳定性约束。
- 理解与生成表示不同,MLLM 控制器有额外计算,尤其在 rollout 早期、稀疏尚未省下大量存储时更明显。当前设定也未显式覆盖需要复杂长程逻辑的流式理解任务。
- HY1.5 延迟约 ×1.38;Wan2.2 上部分 VBench 项未全面超过 Base。预印本,制作时未见公开权重。
关联工作
- 视频世界模型从游戏可控模拟走到持久交互与具身仿真,长程生成同时要求稀疏历史、回访一致、抑制误差累积。
- 压缩、稀疏计算、几何/语义检索各自解决效率或取证的一面。SMI 把理解模型做成统一管理器,并强调组织先于稀疏。
- 统一理解-生成架构是作者给出的前瞻:理解不应只在生成后再解释,而应主动组织生成过程。SMI 是这条线上的记忆管理初版。