快速导读:KineWorld 把指令机器人运动变成相机对齐传输场,既作为干净条件,又按预算重加权未来 RGB 流匹配,让监督对准动作后果。
具身世界模型要在真机执行前,根据候选动作预测视觉后果。现有动作条件生成即使接入数值轨迹、隐编码或光流等运动线索,主 RGB 目标仍常对全部视觉 token 均匀平均。交互真正发生的局部往往只占画面一小块,均匀平均会把优化拉向大面积静态外观。KineWorld(arXiv:2610.06349)主张:动作条件回答“要生成什么运动”,监督分配回答“哪些预测误差更该被学习”。项目页 https://modaxiansheng.github.io/KineWorld/ 。
方法由两块构成。Kinematic Transport Lifting(KTL)从指令机器人运动构造相机对齐传输场,并把其潜表示作为干净结构条件;Transport-Aware World Diffusion(TAWD)在视频潜网格上校准该支撑,再用均匀分布与传输聚焦分布的归一化混合重加权未来 RGB 流匹配,总 token 权重保持不变。训练使用 RoboTwin 2.0 的 ALOHA–AgileX 双臂数据。作者报告单视角 EWMScore-P 68.95、多视角 TWB-Score 54.82,并强调 Table 1/3 是文献参考剖面而非共享训练评测。核心消融中,KTL 把 EWM 从 49.21 提到 65.99,再加上 TAWD 到 68.95。预印本尚未同行评审。
英文题目:KineWorld: Action-Induced Transport Fields for Embodied World Modeling
论文出处:arXiv 每日论文精选 · arXiv:2610.06349
原始论文:PDF / 论文页面
这篇论文解决什么问题?
一个 episode 含 RGB、机器人构型、语言指令与动作轨迹。双臂设定里 at∈R¹⁴,为每臂绝对 6-DoF 末端位姿目标加夹爪命令,再由本体控制器映射成构型转移。世界模型学 pθ(I1:T | I0, A, c),既要视觉真实也要动作忠实。当投影出的机器人运动只占视频一小部分时,均匀 token 平均会让这块区域只分到相应很小的总权重。
相关 WAM 用数值 token、学到的动作码,或具身掩膜、动作图像、光流、相机对齐运动学场来对齐动作与视觉。这些线索改善运动定位,但正文强调它们本身不必改变主 RGB 目标的空间加权,运动定位与监督优先级仍可能错位。KineWorld 把运动学传输同时用作生成条件与主视频目标的空间先验,并且不靠已生成的未来帧来分配监督。
核心创新
- 把视觉范围与交互重要性分开,主张用运动学引导交互关键局部的学习。
- KTL 从指令 rollout 构造相机对齐传输,并作为干净结构条件注入生成器。
- TAWD 在潜网格上把传输支撑变成归一化混合权重,重加权 RGB 流匹配且总 token 权重不变。
方法概览
KTL 用固定渲染器对指令构型做机器人-only RGB 与可见掩膜,RAFT 在相邻渲染间估计位移并限制在源机器人像素,得到相机对齐传输;方向编成色相、幅度编成饱和度后经视频 VAE 得到干净传输潜变量,与带噪未来 RGB 在 Dual-Stream DiT 里做联合自注意力。TAWD 把传输幅度裁剪后池化到潜网格得到 stop-gradient 支撑 d,再与均匀分布做预算归一化混合:wi 均值恒为 1,β=0 退回均匀流匹配,无有效传输时也回退均匀。训练用 RoboTwin 2.0 ALOHA–AgileX,K=9、δ=4;推理只用干净传输条件,不加采样步。
- 对从稠密状态索引 s 开始的训练片段,采样 K=9 个视觉关键帧、时间步长 δ=4,对应 32 步控制转移。从初始构型 qs 把指令动作经本体控制器前向得到 ¯q,再由 ΓE,C(¯q0, ¯A) 得到传输序列 U。该 rollout 只依赖初始构型、指令末端目标与控制器,不看未来 RGB。
- KTL:固定渲染器对每个采样构型生成机器人-only RGB Rj 与可见掩膜 Mj,背景纹理固定以稳定对应。相邻渲染用 RAFT 估前向位移,并用源可见机器人掩膜限制,u0=0。幅度与方向编码成 HSV 再转 RGB:零位移为白。RGB 片段与传输片段分别经因果视频 VAE;RGB 未来潜变量按流匹配加噪,传输潜变量保持干净。两路 patch 化后带流标识,在 Transformer 块内拼接做联合自注意力。TAWD 不改这套条件架构,只改训练目标;监督权重直接来自传输场 uj 而非 zu,以免编码器去迁就权重。
- TAWD:先把源掩膜后的传输幅度按 Mpx 裁到 [0,1] 得到活动图,再用与 VAE 压缩比一致的固定平均池化 Plat 对齐到潜网格,d 经 stop-gradient。未来 token 集合 V 上把 d 归一成传输分布 ρtr,无有效支撑则回退均匀。令 αβ=β/(1+β),wi 是均匀项与 ρtr 的凸组合且均值恒为 1。β=0 精确回到均匀流匹配。KineWorld 目标是加权 token 误差的期望;因均值归一,传输只重分配监督。继承的动作头在 stop-gradient 特征上训练,不向世界生成器回传梯度,以便检查点对齐对比。推理时丢掉支撑校准与损失加权,只保留干净传输条件,从 τ=1 积到 0 再解码。
逐图理解论文
均匀监督
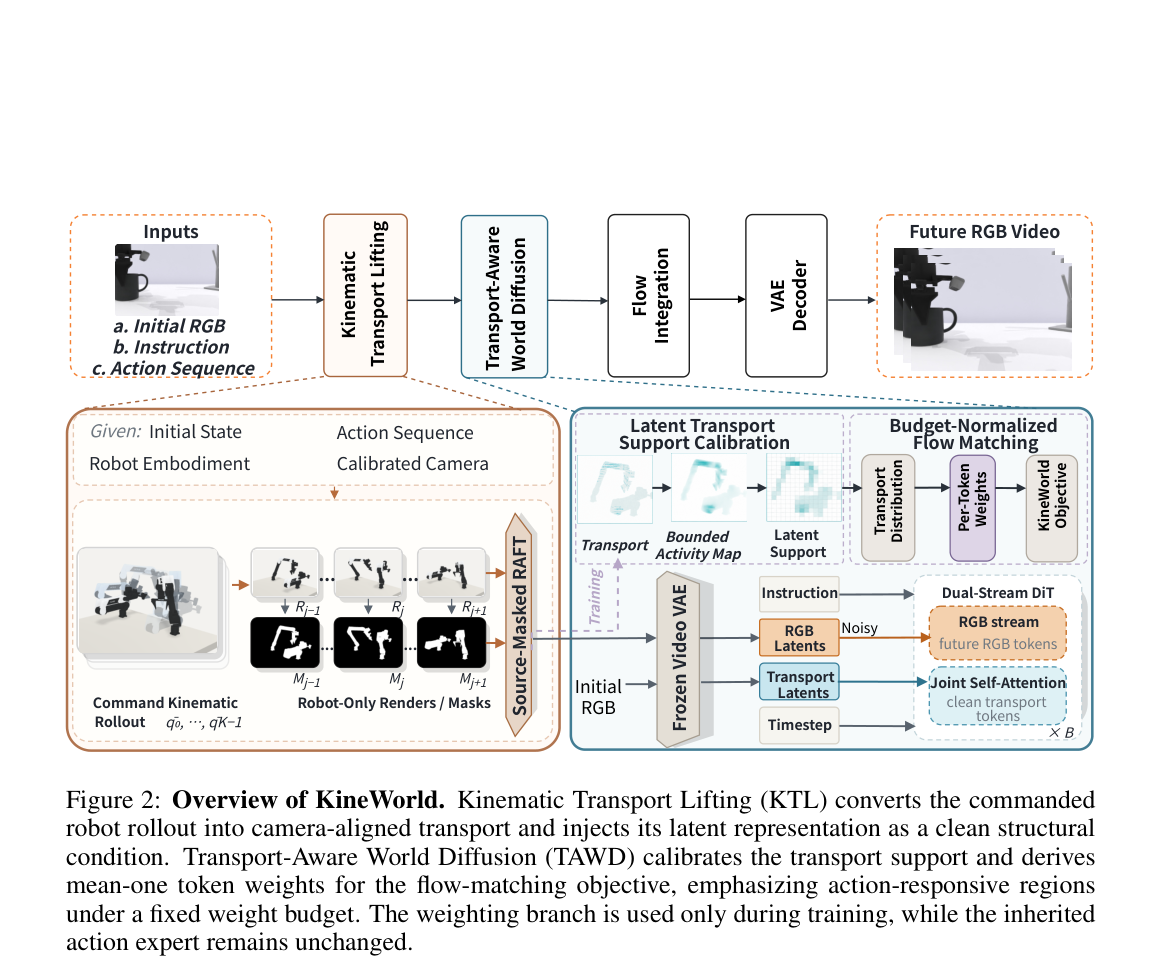
图2是 KineWorld 总览,宜作特色图。顶栏从 Inputs(a.Initial RGB 杯子、b.Instruction、c.Action Sequence)经 Kinematic Transport Lifting、Transport-Aware World Diffusion、Flow Integration、VAE Decoder 到 Future RGB Video 杯子序列。左下棕框 Given: Initial State / Action Sequence / Robot Embodiment / Calibrated Camera:指令运动学 rollout ¯q0…¯qK−1 渲染出 Rj、Mj 序列,旁标 Source-Masked RAFT。右下青框分两路:Latent Transport Support Calibration 把 Transport → Bounded Activity Map → Latent Support;Budget-Normalized Flow Matching 经 Transport Distribution、Per-Token Weights 到 KineWorld Objective。下方 Dual-Stream DiT:Frozen Video VAE 把 Initial RGB 编成 RGB Latents(未来为 Noisy)与 Transport Latents(clean),再与 Instruction、Timestep 一起做 Joint Self-Attention。图注写加权分支仅训练时使用,继承的动作专家不变。
关键证据
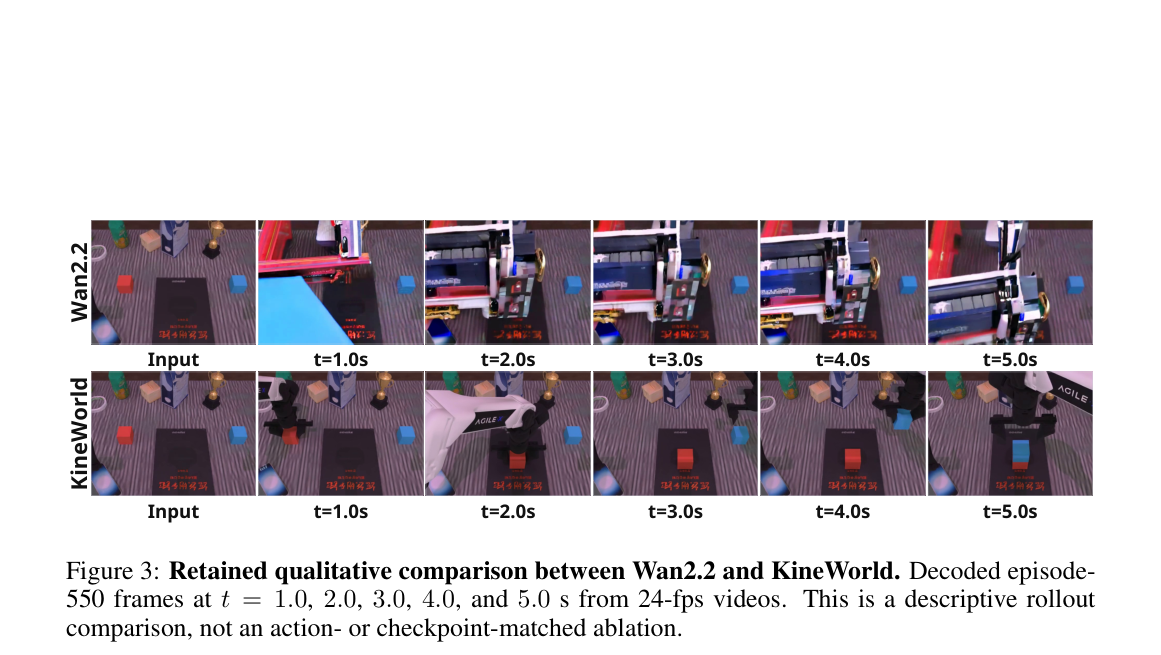
图3是 Wan2.2 与 KineWorld 在 episode 550 上的保留定性对照,24 fps 视频解码 t=1.0、2.0、3.0、4.0、5.0 s。上行 Wan2.2:Input 为俯视桌面,t=1.0s 出现大面积青/粉色块,后续帧机械结构与物体形貌紊乱。下行 KineWorld:同一类俯视输入后,黑色双臂与桌面蓝/橙/绿色块、黑色垫及红色方块更可跟踪,部分帧末端有 AGILE 字样。图注写明这是描述性 rollout 比较,不是动作或检查点对齐消融。
Figure 3 qualitatively compares Wan2
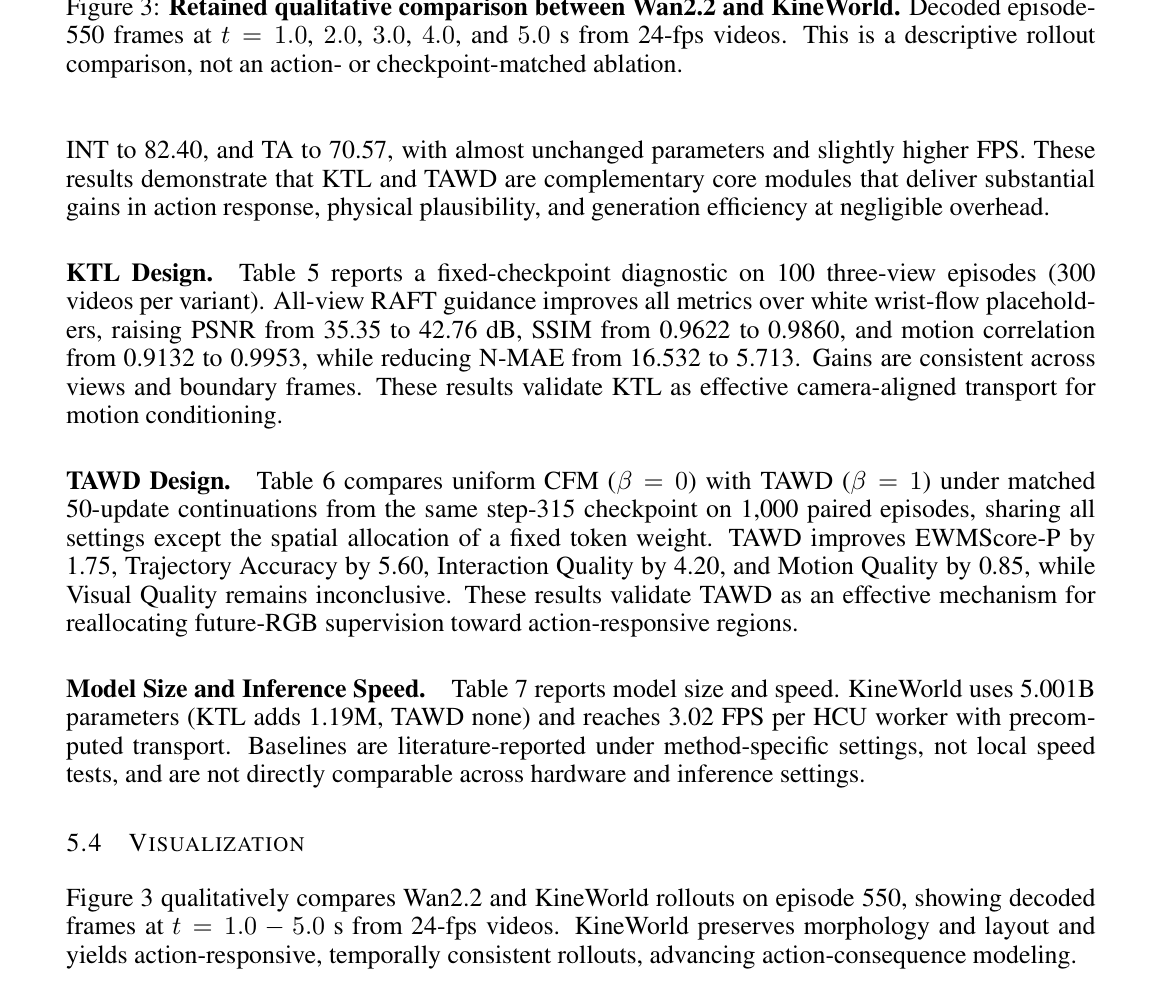
该资源是第 9 页图3 图注之后的正文裁切,不是另一张结果拼图。可见图3 完整英文图注,以及 KTL Design、TAWD Design、Model Size and Inference Speed、§5.4 Visualization。正文数字包括:INT 到 82.40、TA 到 70.57;Table 5 中 PSNR 35.35→42.76 dB、SSIM 0.9622→0.9860、运动相关 0.9132→0.9953、N-MAE 16.532→5.713;Table 6 中 TAWD 相对均匀 EWM +1.75、TA +5.60、INT +4.20、Motion +0.85;KineWorld 5.001B 参数、KTL 增加 1.19M、3.02 FPS。讲这篇图时应把它当消融段落的页面截图,不要假装成第三张可视化拼图。
实验如何设计?
- 数据为 RoboTwin 2.0 Aloha–AgileX Clean-50:1800 条开发训练、200 条验证、500 条留出,合并训练集为前两段。生成器从 Wan2.2-TI2V-5B 初始化。KTL 用 torchvision RAFT 估相机对齐传输并经视频 VAE 编码;TAWD 只重加权未来 RGB 目标、不加采样步。单视角剖面、多视角剖面与局部生成诊断分开报告,附录给出度量定义。
- Table 4 核心消融比较无 KTL/TAWD、仅 KTL、两者都开,并同时报视觉/运动/内容/物理/3D/控制、INT、轨迹精度 TA、参数量、NFE 与 FPS。Table 5 在 100 个三视角 episode(每变体 300 段视频)上比较白腕光流占位与全视角 RAFT。Table 6 从同一 step-315 检查点再训 50 次更新,只改 β,在 1000 条完整 episode 上做 20000 次配对 bootstrap。Table 7 的速度数字是预计算传输下的 HCU worker 吞吐,与文献基线的硬件设定不同,作者写明不可直接比。
- 图3 用 episode 550 在 24 fps 下解码 t=1.0 到 5.0 秒,对照 Wan2.2 与 KineWorld。图注与正文都写明这是描述性 rollout 比较,不是动作或检查点对齐的消融。
关键结果与论文证据
- Table 1 中 KineWorld 的 EWMScore-P 为 68.95,高于表内列出的 JF World 64.85、BWM 系列与 Wan2.2 的 49.21 等参考剖面;Physics 76.49、3D 98.53。作者反复说明这些合计不构成共享 RoboTwin 2.0 评测。Table 2 局部诊断相对 Wan2.2-TI2V-5B:Image Quality 61.21 对 44.42,Interaction 79.20 对 68.68,Instruction Following 85.84 对 76.00,但 Subject Consistency 从 80.90 降到 75.53。Table 3 多视角 TWB-Score 54.82,列在 BWM 65.54 与 WoVR_Plus 65.39 之后居第三;Physical and 3D Coherence 63.24、Temporal Consistency 69.90 为表内最高,Tri-View Consistency 66.36 与 Task Alignment 50.72 仍落后。
- 更可对齐的是 Table 4:基线 EWM 49.21、Physics 29.24、TA 14.15、NFE 50、FPS 2.80。只开 KTL 后 EWM 65.99、Physics 69.40、TA 62.11,NFE 降到 25。再开 TAWD 得到 EWM 68.95、Physics 76.49、INT 82.40、TA 70.57,参数 5.001B、FPS 3.02。作者据此认为两模块互补,用可忽略的开销换动作响应与物理合理性。Table 5 中全视角 RAFT 相对白腕占位:PSNR 35.35→42.76 dB,SSIM 0.9622→0.9860,运动相关 0.9132→0.9953,N-MAE 16.532→5.713,且跨视角与首末帧一致。Table 6 中 TAWD(β=1)相对均匀(β=0)EWM +1.75、TA +5.60、INT +4.20、Motion +0.85,Visual Quality 区间含零、作者称为尚无定论。
- 图3 上行 Wan2.2 在 t=1.0s 起出现大块粉青伪影,后续帧机械结构与桌面物体形貌不稳定;下行 KineWorld 更稳定地保持黑色双臂、桌面彩块与黑色垫上的红色方块,末端可见 AGILE 字样。这只支持“形貌与布局更连贯、动作响应更可读”的定性观察,不能代替 Table 4 的模块消融。
阅读时需要注意
- KineWorld 依赖标定的机器人与相机模型;传输支撑是投影机器人运动的图像估计,并不显式包含物体运动或接触。作者把标定稳健的传输估计、物体感知监督和接触感知世界建模列为后续工作。
- 图3 不是匹配消融。Table 1/3 跨系统数字来自各自论文与评测范围,只能当系统级上下文。Table 7 的 3.02 FPS 在预计算传输与特定硬件下测得,不宜与 A100/H100 文献速度混比。
- Subject Consistency 低于 Wan2.2。代码、检查点与数据清单承诺接收后公开,当前以项目页为准。预印本未同行评审。
关联工作
- IRASim、Ctrl-World、Genie Envisioner、Motus、RealWonder、CLAP 等从动作条件视频、联合视频-动作生成或跨本体动作表示推进 WAM。KineWorld 认为架构与动作接口的进步并不自动让主 RGB 目标重视交互关键变化。
- 具身掩膜、多视角动作视频、光流与相机对齐运动学场把动作对准视觉域。FlowWAM 重加权光流分支,EA-WM 用帧差引导融合。KineWorld 选择直接重加权未来 RGB 流匹配,并保留均匀项以免场景其余区域失去监督。
- 条件流匹配对未来潜变量均匀平均 token 误差。KineWorld 在不改变推理参数与去噪步数的前提下,把这块平均换成预算归一化的空间分配。