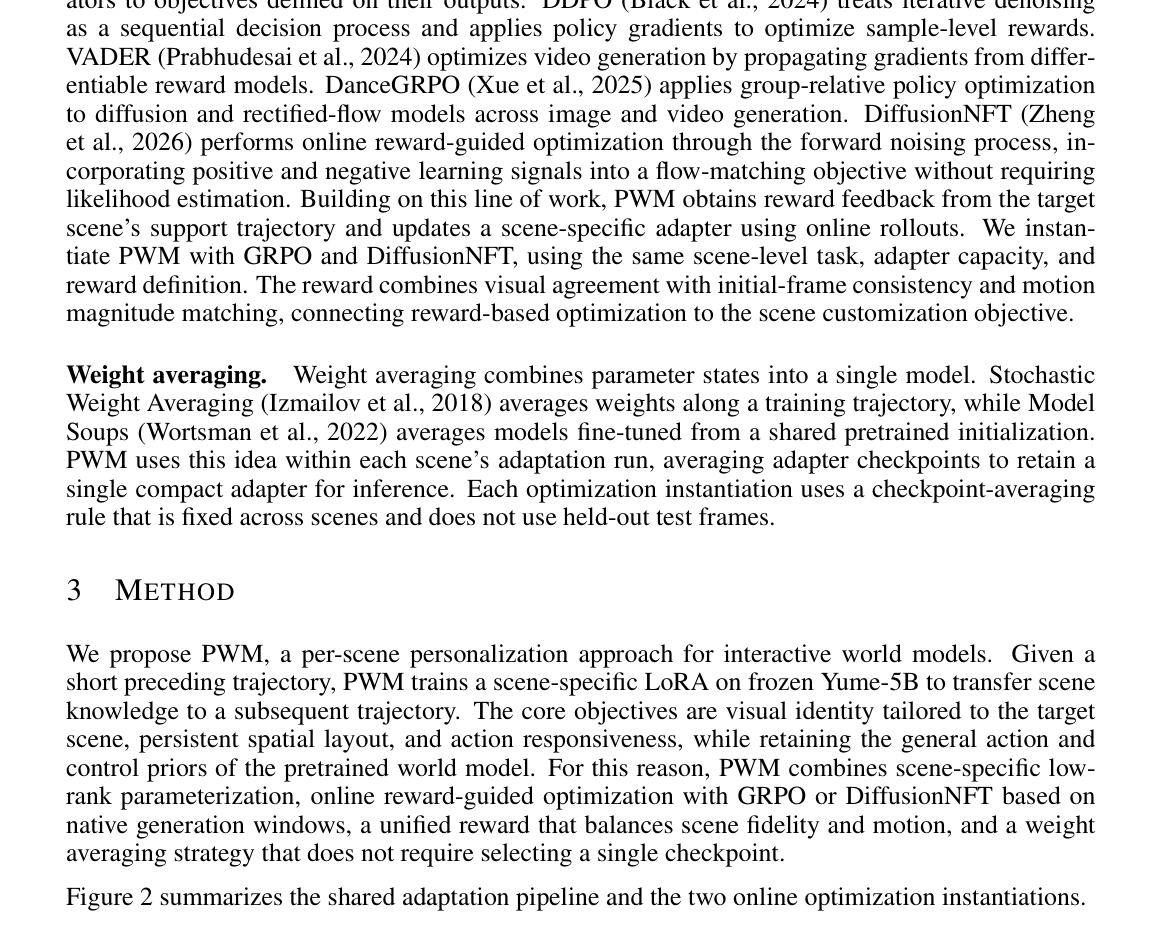
快速导读:PWM 冻结 Yume-5B,用短支持视频和在线奖励更新场景 LoRA,使动作条件续写保住该场景的视觉身份。
预训练交互世界模型已经能按动作生成可探索的环境,但用户常常只想走进自己拍下的那一处院子、商场或游戏地形。问题因此变成:怎样用很短的支持视频学会该场景的材料、光照与布局身份,同时保住骨干模型的动作条件生成质量。PWM(Personalized World Models,arXiv:2610.04920,北京大学、Northwestern University、La Trobe University)冻结 Yume-5B,只为每个场景训练一个紧凑 LoRA;支持轨迹及其控制用来给当前策略的续写打分,再用在线强化学习更新适配器。项目页 https://aigeeksgroup.github.io/PWM ,代码 https://github.com/AIGeeksGroup/PWM 。
作者把同一套适配流程分别实例化为 DanceGRPO 与 DiffusionNFT,并发布 PWM-Bench:室内、室外、游戏各 50 个第一人称定制任务,支持段 80 帧、时间上更晚且互不重叠的测试续写 145 帧。相对原生 Yume,GRPO 在 107/150 个场景改进定制分数,相对增益均值 6.39%;DiffusionNFT 为 98/150 与 5.22%。匹配监督微调在室内外均值为负,而 PWM 在三域均值都为正,无参考画质也更接近原生模型。预印本尚未同行评审。
英文题目:PWM: Personalized World Models with Online Reinforcement Learning
论文出处:arXiv 每日论文精选 · arXiv:2610.04920
原始论文:PDF / 论文页面
这篇论文解决什么问题?
交互世界模型把视觉生成先验、用户控制与自回归 rollout 接在一起,让人在生成环境里走动。个性化提出更硬的约束:对某个室内、户外地点或游戏场景,其标志性外观与内容应在生成轨迹推进时仍可辨认。支持视频提供材料、光照、风格与特征物体的观察;成功定制应加强对该环境的保真,同时不把底层生成器的帧质量毁掉。
DreamBooth 一类方法说明预训练生成器能从少量参考获得视觉身份,Tune-A-Video 把适配扩到视频。交互世界还要把身份保持到动作条件、时间上留出的续写。奖励微调(DDPO、VADER、DanceGRPO、DiffusionNFT)能直接在生成图像或视频上表达偏好;对场景定制而言,支持轨迹本身就能当参考:生成段像不像这个环境,视觉演化是否与已观察轨迹一致。PWM 把这两件事收成按场景的在线强化学习问题。
核心创新
- 在冻结交互世界模型上,用短支持轨迹学场景级 LoRA,而不是重训骨干。
- 同一套原生窗口、适配容量与统一奖励,分别实例化 GRPO 与 DiffusionNFT。
- 提出 PWM-Bench:150 个室内/室外/游戏定制任务,用时间上留出的续写评场景保真。
方法概览
每个场景从冻结 Yume-5B 学一个独立 rank-8 LoRA(2020 万参数)。80 帧支持轨迹用六个重叠的原生 29 帧窗口覆盖(起点 0/9/18/27/36/45),每窗 G=4 条在线 rollout。统一奖励为 0.50 DINO 对齐 + 0.30 LPIPS + 0.10 首帧边界一致性 + 0.10 光流幅度匹配,全部只看支持窗真值。GRPO 做组内分量归一化优势、score-on-mean、以及相对冻结骨干的均值锚(λ=0.1);DiffusionNFT 用奖励加权的正负流匹配分支。八个 epoch 适配器按元素平均后部署,不看测试帧。
- 问题形式化:场景 s 是受控轨迹,只用支持前缀适配,目标是把持久身份迁到同一场景稍后未见过的部分。骨干 θ0 全程冻结;每个场景学独立 rank-8 LoRA ∆θs(2020 万参数,α=16),策略为 πθ0+∆θs。骨干负责通用动作条件先验,适配器只存该场景知识。两种优化方法、全部 150 个任务共用同一适配容量。分辨率统一 832×480。
- 训练直接使用 Yume 原生 29 帧生成窗,六个重叠窗起点为 0、9、18、27、36、45,每窗用真实首帧初始化并条件于该窗实测控制,因此训练与部署共享时间几何。每窗采 G=4 条扩散轨迹。文中 online 明确指每一轮从最新行为策略快照采新轨迹,不是部署后持续适应。统一奖励 R=0.50 Rgt+0.30 Rlpips+0.10 Rcross+0.10 Rdyn:前两项分别是与支持窗真值续写的 DINO 对齐和 1−LPIPS,按帧聚合成 0.7 时间均值加 0.3 最小值,避免少数差帧被平均掉;Rcross 约束生成首帧与窗首帧一致;Rdyn 匹配光流幅度,防止靠抑制运动换外观分。奖励权重不按场景或域另调,评测指标与训练奖励分开。
- GRPO 实例对每个奖励分量做组内均值方差归一化再按 αm 加权,避免某一项因数值尺度主导更新;最后一步把策略似然打在随机采样状态上,把奖励打在解码条件均值上(score-on-mean)。目标还加 λ=0.1 的均值匹配锚,把适配后转移均值拉向冻结骨干。实现用四步 Euler、每组四次 PPO、学习率 10⁻⁴、SDE 温度 β=0.5,每场景八个 epoch。DiffusionNFT 实例共用骨干、LoRA、六窗和同一奖励,但用独立初始噪声;把标量奖励变成有界权重 qi,再在正负流匹配分支上做奖励加权 MSE,学习率 5×10⁻⁵,无额外基策略锚。两种实例都把八个 epoch 的 LoRA 因子按元素平均成最终适配器,该规则固定且不检查测试续写。
逐图理解论文
身份缺口
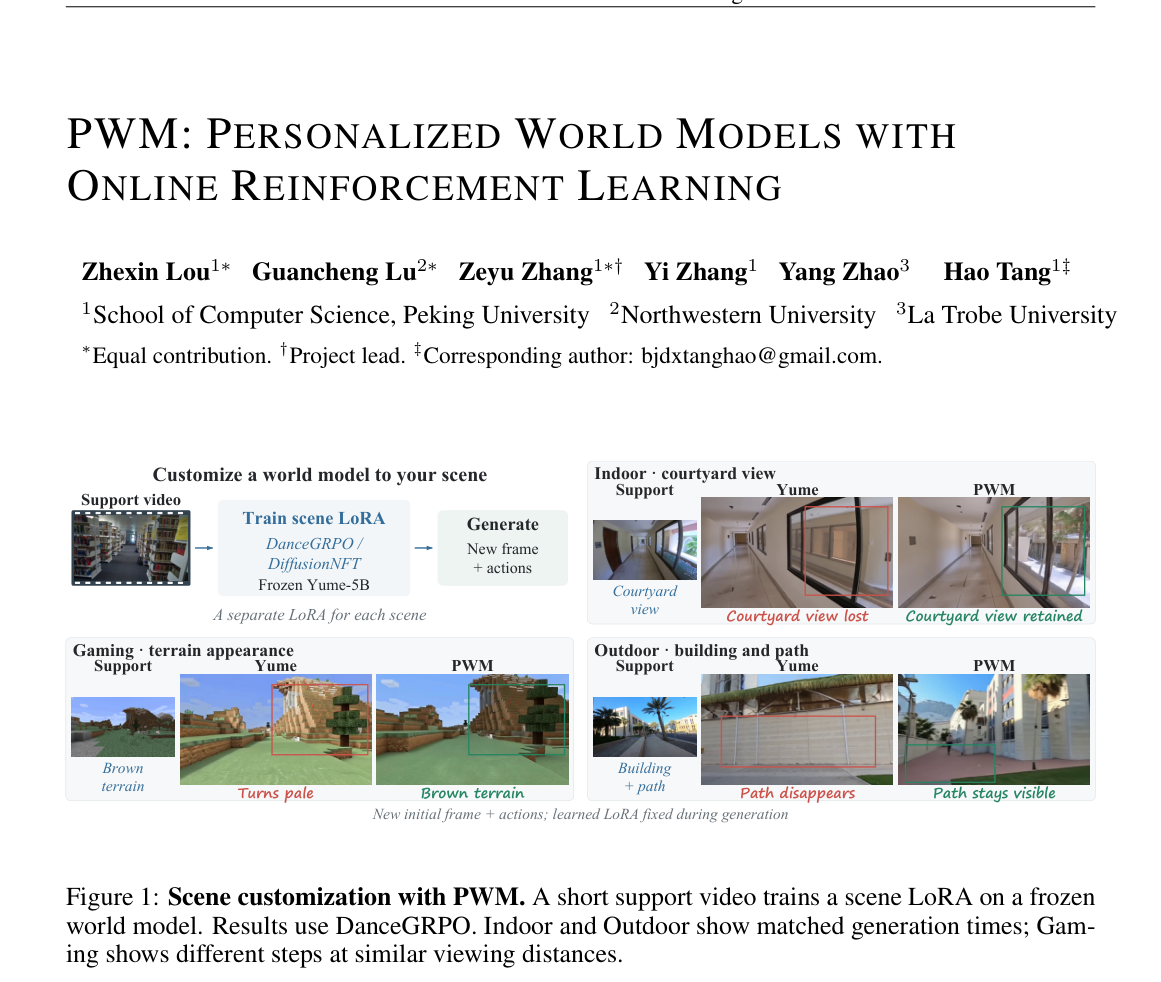
图1是 PWM 的场景定制示意,宜作特色图。上方流程:书架支持视频 → Train scene LoRA(DanceGRPO / DiffusionNFT,Frozen Yume-5B)→ Generate 新初始帧加动作;旁注 A separate LoRA for each scene。右上 Indoor · courtyard view:Support 走廊尽头有庭院,Yume 红框 Courtyard view lost,PWM 绿框 Courtyard view retained。左下 Gaming · terrain appearance:Support 标 Brown terrain,Yume Turns pale,PWM 保住棕色地形。右下 Outdoor · building and path:Support 为建筑加小路,Yume Path disappears,PWM Path stays visible。图注写室内外为对齐生成时刻,游戏为相近视距下不同步数;页内作者单位为北京大学、Northwestern、La Trobe。
评测协议
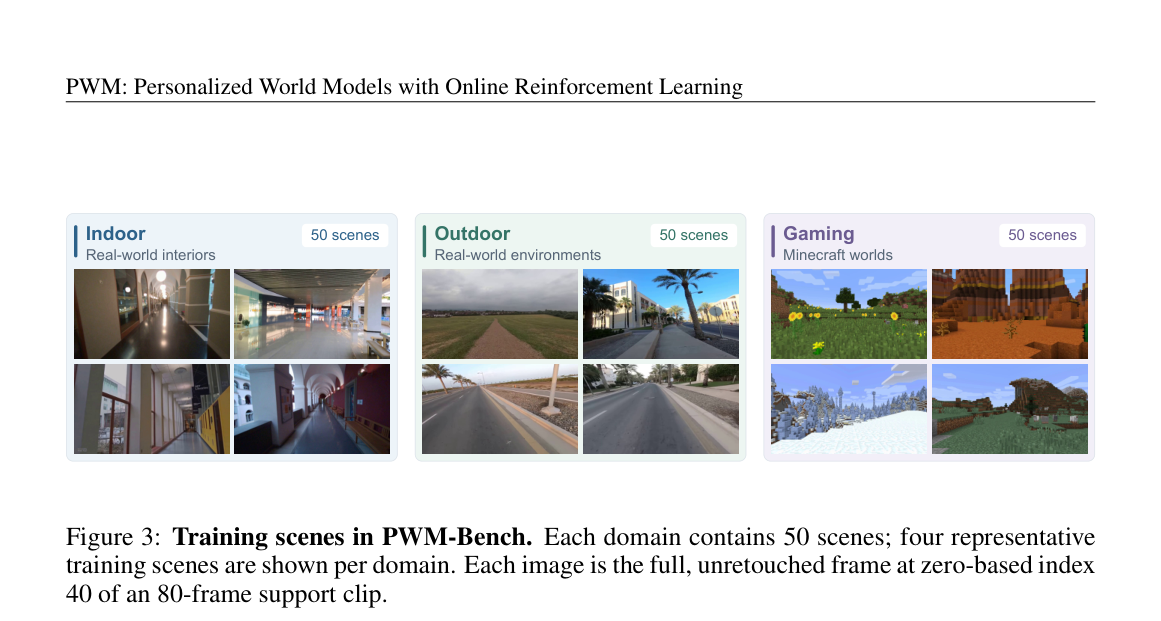
图3展示 PWM-Bench 训练场景。三列卡片均标 50 scenes:Indoor Real-world interiors 四张走廊/大厅;Outdoor Real-world environments 四张田野、林荫道与公路;Gaming Minecraft worlds 四张草地、方块山地、雪地与森林。图注写每张都是 80 帧支持片段中零基索引 40 的完整未修帧。该图只给域覆盖直觉,不含分数;任务构造与 80/145 帧划分见第 8–9 页。
关键证据
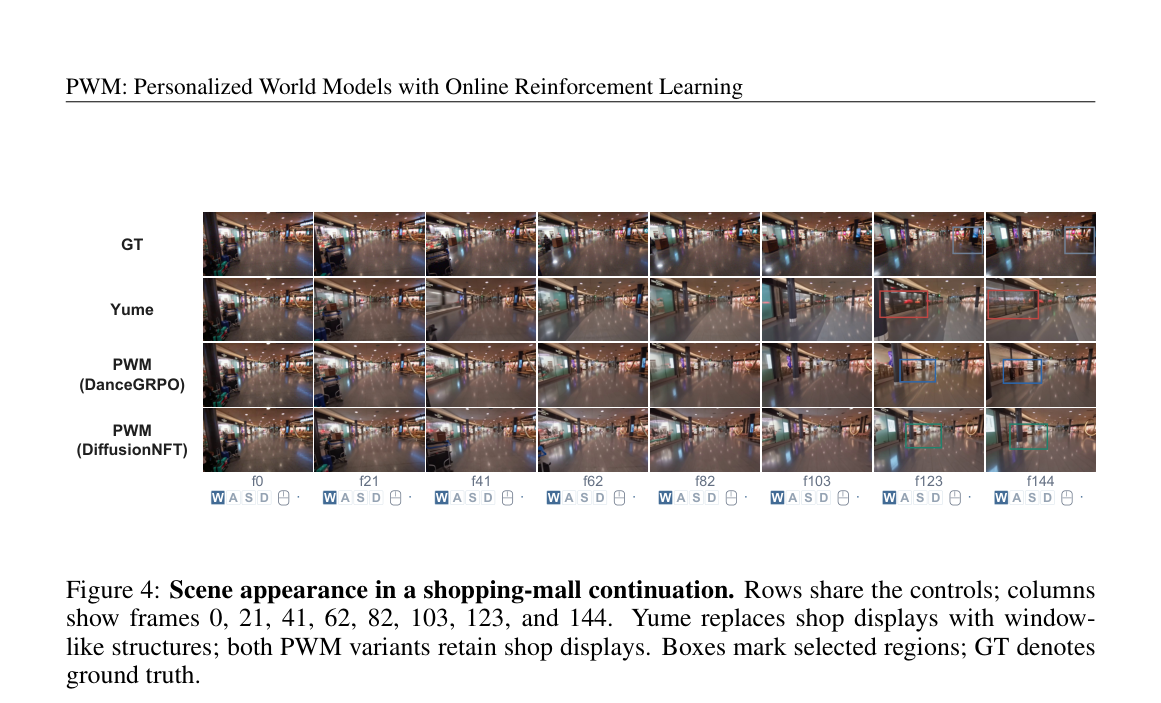
图4是商场续写的定性比较。四行 GT、Yume、PWM (DanceGRPO)、PWM (DiffusionNFT) 共享控制;八列 f0、f21、f41、f62、f82、f103、f123、f144,底栏重复 WASD。后期 Yume 红框把店铺陈列换成窗状结构;DanceGRPO 蓝框、DiffusionNFT 绿框仍可见货架与橱窗,与 GT 更接近。图注写 Yume replaces shop displays with window-like structures; both PWM variants retain shop displays。这是单场景示意,定量覆盖见 Table 2 的 150 景统计。
实验如何设计?
- PWM-Bench 共 150 个独立任务。Outdoor 50 来自 EgoVid-5M 与 YouTube,控制来自 VIO 或估计的视觉运动;Indoor 50 另含 InCrowd-VI;Gaming 50 在 MineDojo 用脚本智能体记录 Minecraft 视频与同步运动/相机控制。每题一条 80 帧支持段和一条时间上更晚、互不重叠的 145 帧测试段。控制接口跨域共享:平移 WASD、相机方向 token、三个连续运动幅度。保留任务要求相机运动连续且非退化、支持与测试身份一致、控制与视觉运动相符。
- 与原生 Yume 比较时,关闭场景适配器但共用 29 帧自回归生成、初始视觉上下文、控制、解码与 145 帧视界。匹配 SFT-LoRA 使用同一冻结骨干、LoRA 容量、支持数据、控制标注、优化预算和评测协议,用来隔离在线 GRPO 相对纯监督适配的贡献。每场景三粒配对种子 {42,123,777},先在场景内对三种子平均,再让每个场景对域与总体各贡献一次。
- 定制分数 S=Dpair+0.5 Dhall。Dpair 是生成帧与真值测试帧在 DINOv2 类别 token 上的时间对齐余弦距离平均;Dhall 是生成帧中出现测试首帧没有的人/车/动物实体类别的比例,由 zero-shot CLIP 检测。S 越低越好。方法相对原生的配对差为负表示定制改进。相对增益 gs 是相对原生分数的百分数下降,负增益计入平均。画质另报 MUSIQ-SPAQ(全部帧)、NIQE 与 BRISQUE(19 个均匀采样帧,含首尾)。
关键结果与论文证据
- Table 2:DanceGRPO 总体均值增益 6.39%、最大 75.11%,改进 107/150(71.3%);DiffusionNFT 均值 5.22%、最大 58.54%,改进 98/150(65.3%)。Indoor:GRPO 5.14%(36/50)、NFT 7.04%(34/50);Outdoor:6.11%(34/50)与 2.27%(30/50);Gaming:7.91%(37/50)与 6.35%(34/50)。GRPO 三域中位增益分别为 5.18%、5.82%、8.18%,说明好处不只来自少数极端场景。图4 商场续写里,Yume 在后期把店铺陈列换成窗状结构,两种 PWM 都保住陈列;图5 室内例子里 Yume 在蓝色设备上长出人脸,PWM 保留设备外观;图6 游戏域保住雪地覆盖。
- Table 3 匹配 SFT:Indoor 均值 −16.39%(27/50),Outdoor −14.86%(26/50),Gaming +6.08%(33/50),总体 −8.39%(86/150,57.3%)。DanceGRPO 把总体提到 +6.39% 与 107/150,NFT 为 +5.22% 与 98/150,且三域均值都高于 SFT。图7 户外例子中,Yume 靠近墙、SFT 特写建筑与棕榈,两种 PWM 保住可通行空间。作者强调 SFT 在支持窗上优化监督扩散目标,PWM 则对当前策略续写打相对奖励,学习信号来自适配模型在支持条件下实际生成的内容。
- Table 4:PWM 在三域的 MUSIQ、NIQE、BRISQUE 均值都优于 SFT,并接近原生。Indoor MUSIQ 从 SFT 的 47.26 到 DanceGRPO 的 59.06(原生 58.93);Outdoor BRISQUE 从 33.58 到 23.24(原生 22.66);Gaming NIQE 从 5.90 到 3.82(原生 3.81)。150 景中 MUSIQ 有 123 景、NIQE 有 132 景更偏向 PWM 而非 SFT。图8 显示 SFT 室内模糊重复纹理、室外网格伪影,DanceGRPO 外观更自然。定制分数与无参考画质被作者当作互补证据。
阅读时需要注意
- 适配几何固定在短支持前缀与原生 29 帧窗;结论写明后续要走向更长交互视界和更丰富的支持轨迹。检查点汤避免按验证集挑点,但也就放弃了场景级早停。
- 奖励四项权重全域固定,实体幻觉项只覆盖人、车、动物三类相对测试首帧的新出现,不能审计全部内容漂移。YouTube 控制由估计相机运动映射,误差可能进入条件。
- 文中 online 不是部署后持续学习。SFT 在室内外均值为负,说明少样本监督适配本身可能伤先验;该对比不能外推到任意监督配方。预印本未同行评审。
关联工作
- GameFactory 从游戏视频学动作控制并用域适配迁到开放场景;Yume 与 Yume-1.5 把相机控制、上下文压缩和文本交互接到连续世界探索。PWM 假设这类骨干已经能导航多样环境,问题变成如何把它特化到一条被观察过的场景。
- DreamBooth、Tune-A-Video 与 LoRA 提供少样本个性化与参数高效适配。PWM 的评测不是把主体放到新上下文,而是在同一场景的时间留出续写上、在共享初始上下文与控制下比较动作条件轨迹。
- DanceGRPO 把组相对策略优化接到扩散与整流流;DiffusionNFT 经前向加噪做奖励引导流匹配,不必估计似然。PWM 把支持轨迹当奖励参考,并比较这两种优化器在同一任务、同一适配容量上的表现。Model Soups 式平均用来交付单个紧凑适配器。