快速导读:VPP2 用带细粒度字幕的事件级视频预训练建立指令到轨迹的稳定映射,再蒸馏成单步视觉规划,并用混合 Transformer 动作专家在开放操作里泛化。
世界-动作模型希望把视频基础模型里的物理先验变成机器人动作,但开放环境里常见失败是:未来运动预测错了,动作跟着错。Video Prediction Policy 2(VPP2,arXiv:2610.10270,Robotera / 清华 / 港科广 / UC Berkeley / 上海交大)把原因归结为两点:基础视频模型并非为操作指令优化;把动作模块生硬塞进视频模型又会破坏泛化。项目页为 https://robert-gyj.github.io/video-prediction-policy-2 。
VPP2 先在大规模操作视频上做带细粒度字幕的事件级继续预训练,建立从语义描述到完整子任务轨迹的稳定映射;再后训练并蒸馏成固定视野的单步视觉规划;最后用混合 Transformer 动作专家在视频隐变量上学习隐式逆动力学。实验给出三条主结果:14B 视频模型在开放任务指令跟上超过 Cosmos3-64B 十一个百分点;真实 ALOHA 零样本平均成功率 58.5%,比最强对照高 18.5 个百分点;在 LIBERO-Pro、LIBERO-OOD 与 RoboDojo 的基准后训练中取得所评方法里最高成功率。预印本尚未同行评审。
英文题目:Video Prediction Policy 2: Predict Better, Act Better
论文出处:arXiv 每日论文精选 · arXiv:2610.10270
原始论文:PDF / 论文页面
这篇论文解决什么问题?
典型策略把一句简单指令和当前观测映射成短动作块。数据一放大,这种短时映射变成多峰、不确定,模型容易学到虚假的短程相关。图1用“把碗放进左边盒子”对比:简单字幕对应发散的短未来,细字幕加上完整事件轨迹则把分布收成一条从 Start 到 Goal 的稳定路径。
近期要求泛化的基准里,标准套件上接近满分的策略,包括部分 WAM,会在扰动配置和新型技能组合上大幅掉点。VPP2 的设计因此不是再堆一个动作头,而是先把视频预测在操作域里做对,并在学动作时尽量保住这份预测能力。
核心创新
- 用细粒度字幕与事件级视频预训练,把指令对齐到完整子任务轨迹,降低短时动作块的多峰不确定性。
- 再把视频模型后训练并蒸馏成固定视野的单步视觉规划,保留操作域泛化同时满足闭环时延。
- 用 MoT 动作专家在视频 KV 上学习隐式逆动力学,并配合 VLM 子任务规划处理长程与歧义指令。
方法概览
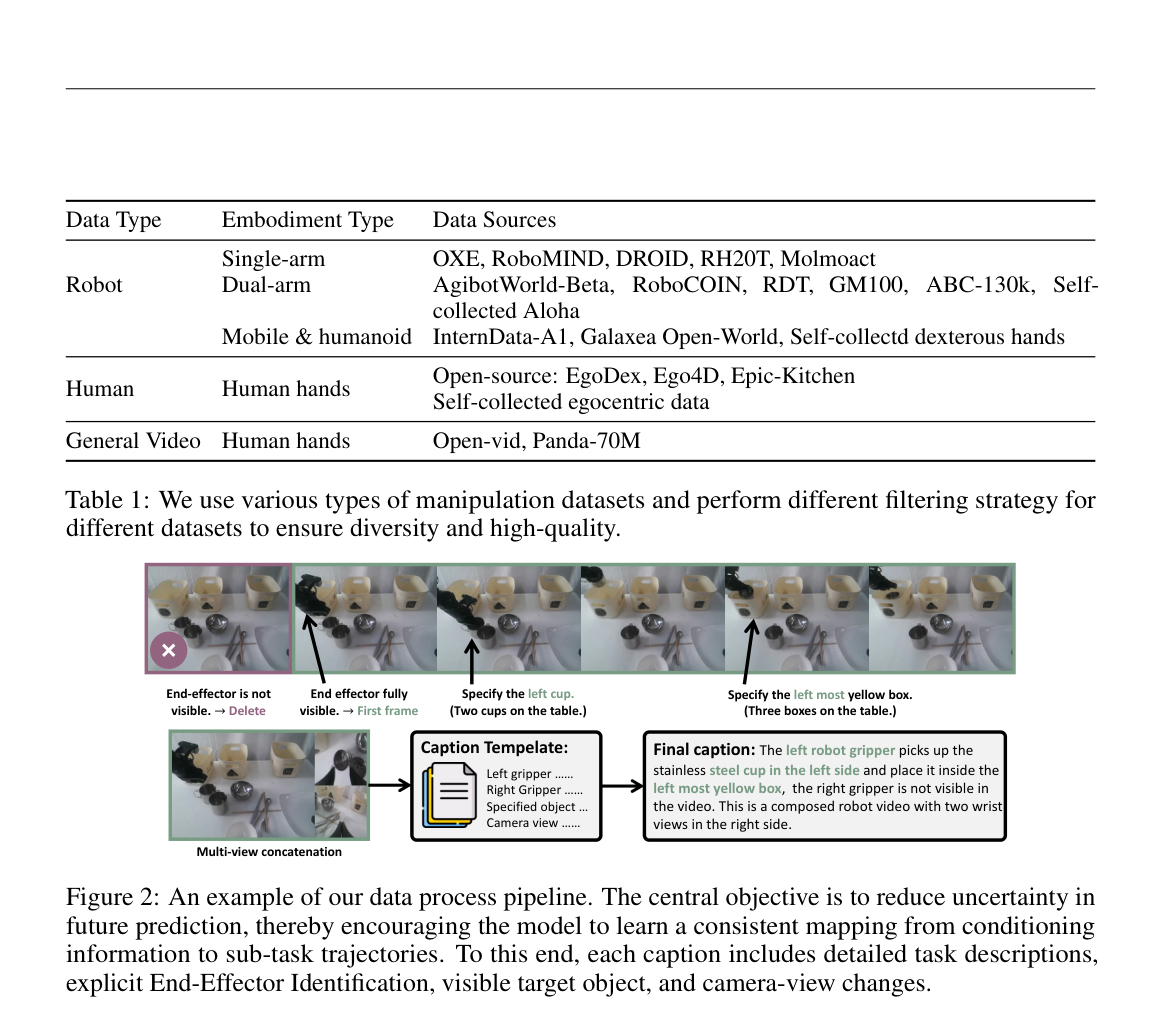
VPP2 基于 Wan2.1-I2V-14B。数据侧汇集单臂、双臂、移动与人形、人手与通用视频,过滤损坏轨迹后切成 1–12 秒语义片段,用启发式速度极小值与夹爪开合找边界,再用 VLM 微调起止。每段写详细字幕:任务过程、主动末端、无歧义目标物、相机视角与运动。多视点拼成 T 形:主视图在左,最多两个辅助视图竖叠在右,缺失用黑图填充。对占八成以上的自我中心双臂数据做工作空间对齐与末端坐标对齐。训练三阶段:Stage 1 事件级继续预训练,在完整子任务上均匀采样 49 帧、分辨率 416×240,flow matching 训练 30,000 步、batch 1024、学习率 1e-5;Stage 2 改为固定时长视频块(人手 2 秒、机器人 8 秒)并对教师流做一致性蒸馏,推理单步约 0.1 秒;Stage 3 用 0.9B 动作 DiT 的 MoT 学习隐式逆动力学,早期冻结视频骨干、只用 LoRA,动作块 2 秒、五步去噪约 0.1 秒,视频加动作总延迟约 0.22 秒。执行时可用 VLM 把开放指令拆成子任务并写成训练风格的细字幕。
- 数据覆盖单臂(OXE、DROID 等)、双臂(AgibotWorld-Beta、自采 ALOHA 等)、移动与人形,以及 EgoDex、Ego4D、Epic-Kitchen 与过滤后的 Open-vid / Panda-70M。去掉相机故障和突变轨迹后,按人手或末端速度局部极小值、夹爪开合等启发式切成 1–12 秒片段,再用 VLM 合并过碎片段、调整起止。字幕模板要求写清左右夹爪、指定物体和相机运动,例如“左侧夹爪拿起左侧不锈钢杯,放进最左侧黄盒;右侧夹爪不可见;右侧为两个腕部视角的拼接”。多视点拼成 T 形:主视图在左,两个辅助视图上下叠在右,缺失填黑。
- 自我中心双臂数据超过总量八成,但各数据集世界系与末端系不一致,视觉上相似的左移可能对应 +x 或 −y。作者做两级对齐:工作空间对齐把不同机器人的末端工作空间变换到可比范围,末端对齐统一原点与轴方向。
- Stage 1 在完整子任务上把未来均匀采成 49 帧,用 flow matching 继续预训练 Wan2.1-I2V-14B,条件是子任务指令与首帧观测,分辨率 416×240,3 万步、batch 1024、学习率 1e-5。Stage 2 改预测固定时长块——人手 2 秒、机器人 8 秒——以便和下游动作对齐;再对相邻流时间的终点预测做一致性蒸馏,一半概率把目标时间取成 1 以强调单步生成,推理时从噪声一次得到视频隐变量,正文写约 0.1 秒,第 5 页细化为 bfloat16 + torch.compile 约 0.12 秒。
- Stage 3 加入 0.9B 动作 DiT,标准 MoT 结构,注意力掩码让视频 token 互相看见、动作 token 看见视频与自身。动作专家在统一坐标的双臂数据上预训练;因它是新初始化,早期冻结视频骨干、只用 LoRA,以免动作梯度打坏视频表征。动作块 2 秒、五步去噪约 0.1 秒,每块总延迟约 0.22 秒。长程与歧义指令由 VLM 规划器拆成显式子任务,并写成接近训练模板的细字幕。
逐图理解论文
失败原因
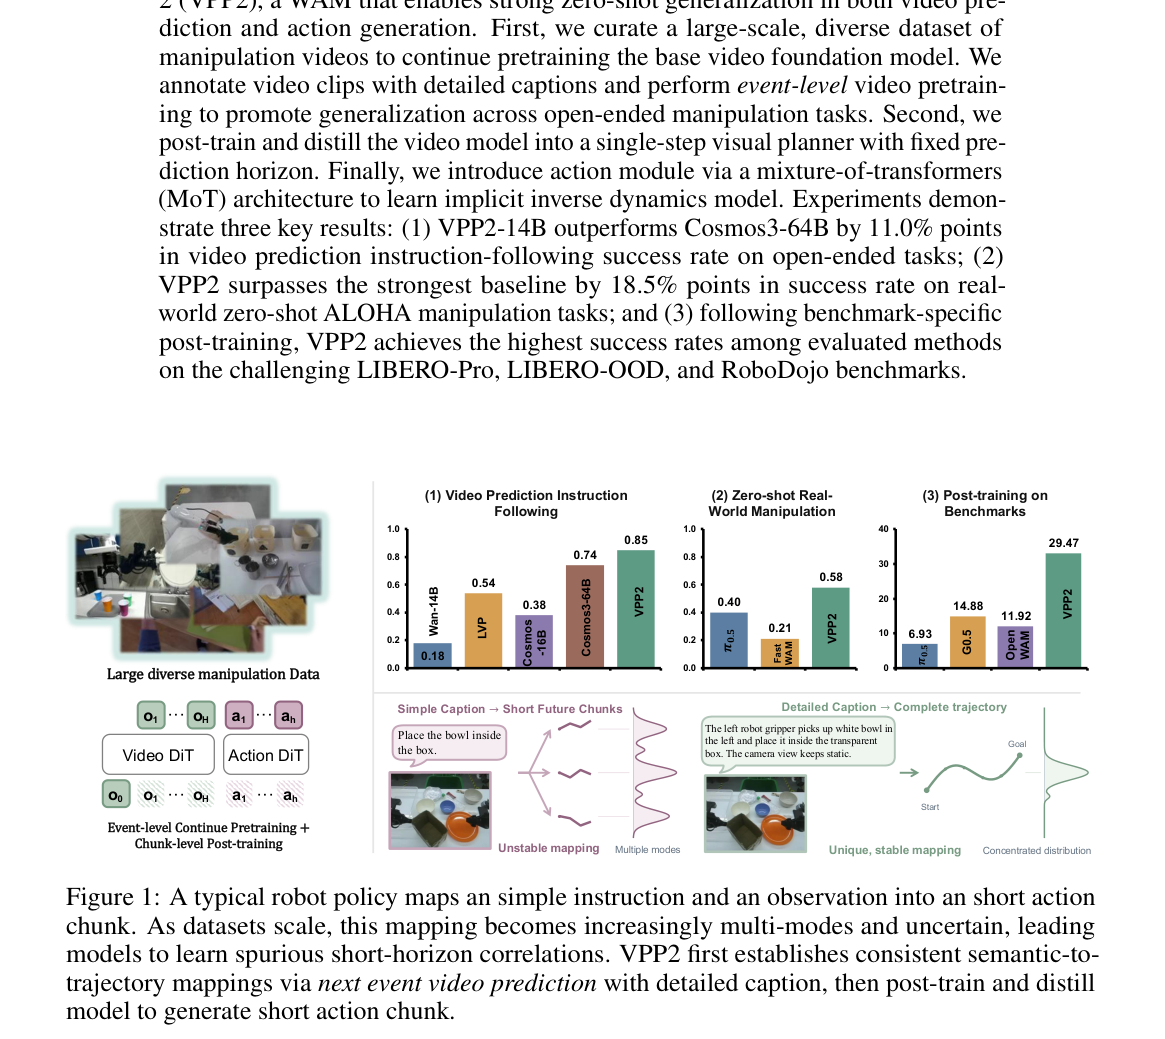
图1是首页总览,裁切上方残留摘要文字,讲图时忽略。左上是杂乱桌面的多样操作数据,下面 Video DiT 与 Action DiT 标 Event-level Continue Pretraining + Chunk-level Post-training。右侧三组柱:(1) 视频指令跟随,Wan-14B 0.18、LVP 0.54、Cosmos-16B 0.38、Cosmos-64B 0.74、VPP2 0.85;(2) 真实零样本,π0.5 0.40、Fast WAM 0.21、VPP2 0.58;(3) 基准后训练,π0.5 6.93、G0.5 14.88、Open WAM 11.92、VPP2 29.47。下部对比 Simple Caption → Short Future Chunks 的多峰不稳定映射,与 Detailed Caption → Complete trajectory 的从 Start 到 Goal 单峰路径。第三柱对应 RoboDojo 成功率,不是 LIBERO。
数据与事件预训练
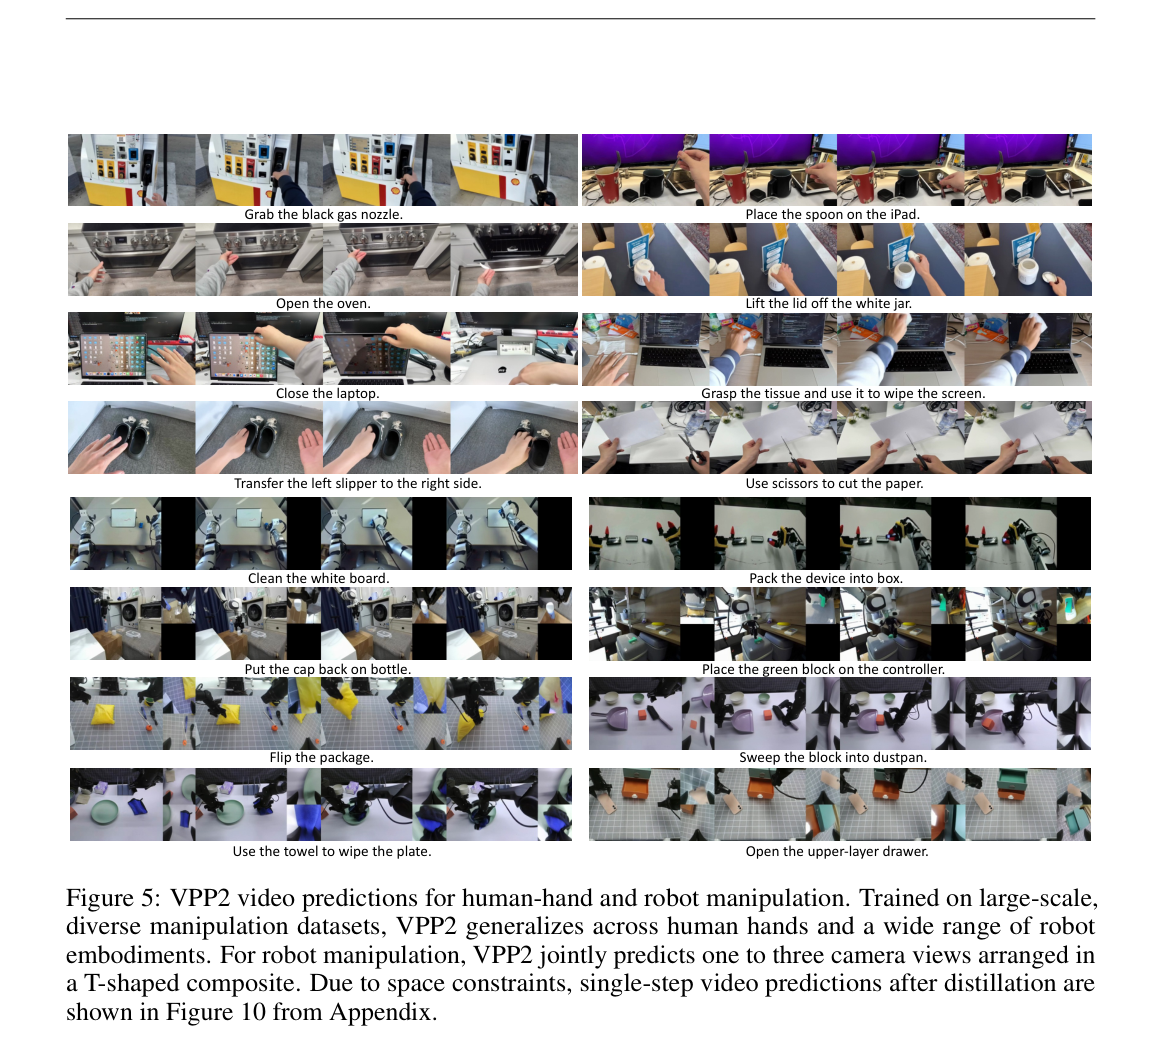
图5是预训练 VPP2 的视频预测拼图,左右两列共十六个任务。人手侧可见 Grab the black gas nozzle、Place the spoon on the iPad、Open the oven、Lift the lid off the white jar、Close the laptop、Grasp the tissue and use it to wipe the screen、Transfer the left slipper to the right side、Use scissors to cut the paper。机器人侧是 T 形多视拼接:Clean the white board、Pack the device into box、Put the cap back on bottle、Place the green block on the controller、Flip the package、Sweep the block into dustpan、Use the towel to wipe the plate、Open the upper-layer drawer。每个任务三帧从接触到完成。图注写训练覆盖二十余种本体,机器人预测把主视图放左、辅助视图叠右;蒸馏后的单步结果见附录 Figure 10,本图不是蒸馏后单步。
蒸馏与动作
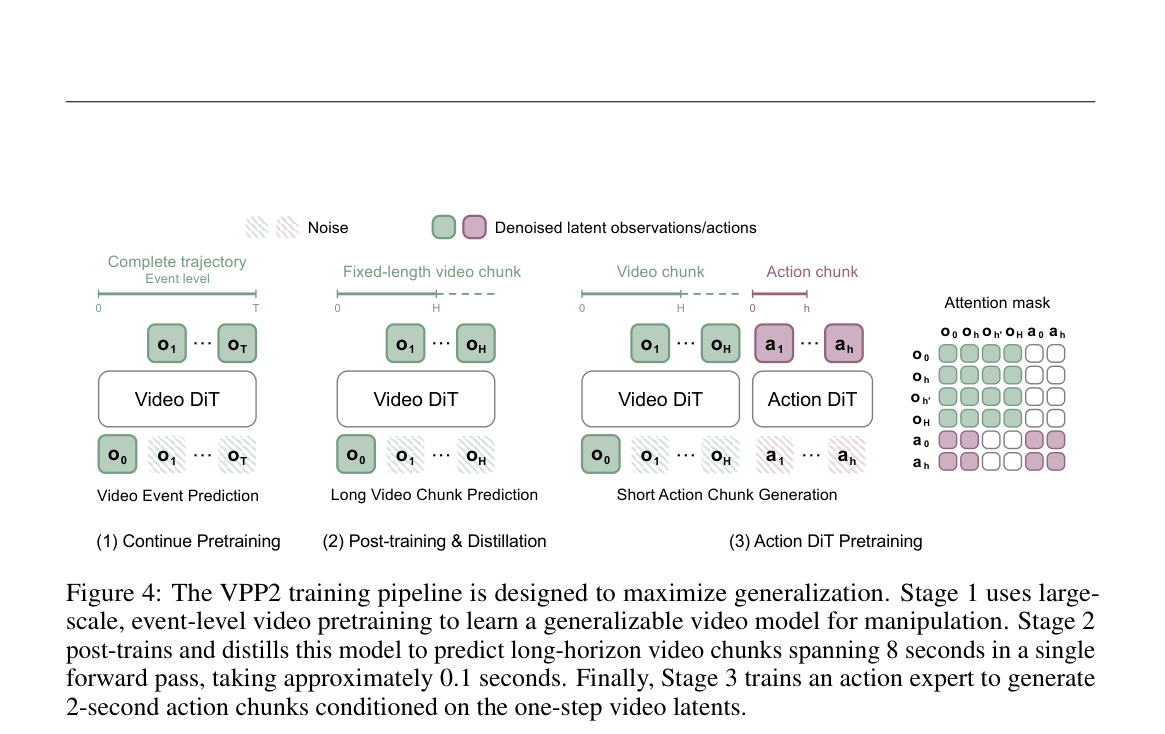
图4是三阶段训练,宜作特色图。Stage 1 Video Event Prediction:完整事件 0 到 T,条件首帧 o0,预测 o1…oT。Stage 2 Long Video Chunk Prediction:固定长度 0 到 H 的视频块,仍由 Video DiT 做,后训练并蒸馏。Stage 3 Short Action Chunk Generation:视频块旁接 Action DiT,输出 2 秒动作 a1…ah。右侧注意力掩码显示视频 token 互相可见,动作 token 看见视频与自身,动作不回写视频。图注写 Stage 2 一次前向预测约 8 秒视频、约 0.1 秒;Stage 3 在单步视频隐变量上生成 2 秒动作。绿色块是去噪后的观测/动作,斜线块是噪声。
关键证据
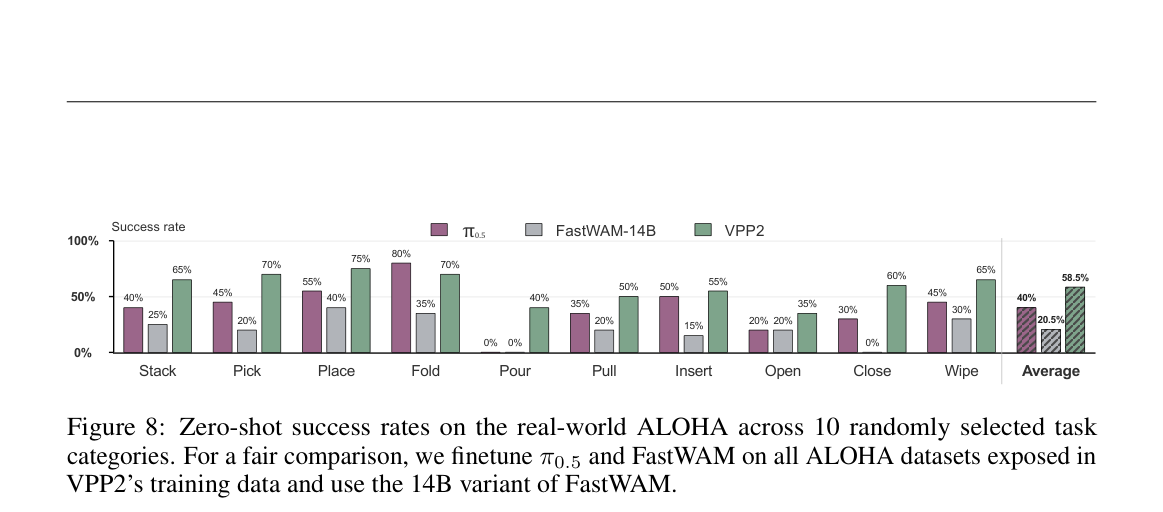
图8是真实 ALOHA 十类零样本柱状图,图例紫 π0.5、灰 FastWAM-14B、绿 VPP2。逐类约读:Stack 40/25/65,Pick 45/20/70,Place 55/40/75,Fold 80/35/70,Pour 0/0/40,Pull 35/20/50,Insert 50/15/55,Open 20/20/35,Close 30/0/60,Wipe 45/30/65;右侧 Average 40.0 / 20.5 / 58.5。VPP2 在 9 类最高,Fold 上 π0.5 更高。对照已在 VPP2 用过的 ALOHA 数据上微调,且 FastWAM 用 14B。这是真实机器人成功率,不要和 Table 2 的视频指令跟随分数混读。
实验如何设计?
- 视频质量实验从已有工作与办公室、机器人工作台随机采集 50 组人手和 50 组机器人图像-指令对,覆盖未见本体与自由指令。对照为底模 Wan-2.1-I2V-14B-480p、同样改到操作域的 LVP、Cosmos3-Nano-16B、Cosmos3-Super-Image2Video-64B,以及预测固定时长而非完整事件的消融 VPP2-Fixed-Step。GPT 评指令跟随成功率,人类评成对谁更跟指令。
- 真实零样本在训练见过的 ALOHA 上直接部署、不做按任务微调。π0.5 与 FastWAM-14B 在 VPP2 用过的全部 ALOHA 数据上微调后再比,任务含 Stack、Pick、Place、Fold、Pour、Pull、Insert、Open、Close、Wipe 十类。
- 仿真方面,所有模型只在四个标准 LIBERO suite 上训练,再评 ID、Pro 的 Position/Task 扰动,以及 OOD 的 Spatial/Object/Goal 组合。RoboDojo 仿真含 42 个双臂任务、五个能力维,对照取 2026 年 9 月官方榜。子任务规划实验在分类、语言堆叠、换块、麻将、井字棋五组各 50 次试验。
关键结果与论文证据
- Table 2 上 VPP2 人手 0.80、机器人 0.90,高于 Cosmos3-64B 的 0.70/0.78,平均约 11 个百分点;底模 Wan 在机器人上只有 0.04,LVP 0.46/0.62,固定步长消融 0.48/0.42,说明完整事件对齐比固定时长更跟得上指令。图6 人类成对比较里,VPP2 对 Wan 的机器人胜率很高,对 Cosmos3-64B 仍占优。图7 的“抓最左边瓶子放到矮杯前”“把红纸杯叠到最左黑杯上”显示大模型仍会抓错物体或放错位置。
- 图8 真实 ALOHA:VPP2 平均 58.5%,π0.5 40.0%,FastWAM-14B 20.5%,10 类里 9 类最高。Pour 上两对照为 0、VPP2 40%;Close 上 FastWAM 为 0、VPP2 60%。例外是 Fold:π0.5 80%、VPP2 70%。作者把零样本优势归因于可泛化的视频规划,而不是在这些任务上单独微调。
- Table 3:LIBERO-ID 上多数方法超过 94%,VPP2 98.8%,但 ID 高分迁不出去。Pro 总体 VPP2 45.0%,对照最高 11.0%,Task 扰动 47.8% 对 6.8%,说明它更跟给定指令而不是回放记忆轨迹。OOD 上 Cosmos-Policy、Fast-WAM、DiT4DiT 至多 10.5%,VPP2 63.9%,也高于专门打这个缺口的 Temporal Ratio 59.4%。RoboDojo 平均分 35.51、成功率 29.47%,高于 GPT-6-Astra 的 28.97/22.48%。五组任务加上 VLM 子任务规划后平均 57.6% 对 27.6%。
阅读时需要注意
- 视频实验样本是每域 50 对,指令跟随由 GPT 与人类偏好衡量,不能当成物理动态精度。真实零样本仍在训练见过的 ALOHA 本体上。LIBERO 泛化数字与 RoboDojo 数字来自基准特定后训练,图1 第三柱的 29.47 是 RoboDojo 成功率,不要和 ALOHA 的 58.5% 混读。
- Fold 一类上 π0.5 更高;RoboDojo 对照快照是 2026 年 9 月榜单。论文没有独立局限节,也未系统报告跨本体、长期记忆失败或安全约束。数据标注使用了生成式 AI,作者声明对最终数据与结论负责。预印本未同行评审。
关联工作
- 视频基础模型从潜扩散走到大规模 DiT;操作域适配如 LVP、Cosmos 强调机器人数据,但作者认为创意生成目标不等于忠实执行操作指令,提示增强和细字幕同样关键。
- 早期 WAM 先出未来再反推动作,迭代生成对闭环太慢;更新的做法把动作条件在视频特征上,或联合学视觉预测与动作,但动作学习可能牺牲视频泛化。VPP2 强调先用事件级预训练加细字幕固定指令-轨迹映射,再固定视野后训练与单步蒸馏,最后才接动作专家。
- VLA 在 LIBERO-ID 很强,在 Pro/OOD 上暴露出记忆轨迹而非跟指令的问题。Temporal Ratio 针对 OOD 组合,VPP2 仍用下一事件预测拿到更高成功率。