快速导读:在受控自车运动任务上,现成视频语言模型提示表现不稳且常有类别崩塌,而轻量 LoRA 与特征探针能恢复强运动判别,说明线索常在内部却未可靠进入语言通路。
视频语言模型越来越强,也越来越容易被当成“看懂视频时间如何演化”的通用推理器。Mind the Temporal Gap(arXiv:2610.12575,MIT CSAIL 与 University of Haifa)把问题收窄到驾驶:模型能否从视频片段可靠判断自车前进/后退、左右与加减速。作者搭建从标准提示、视觉框、少样本、思维链,到 LoRA 与中间特征探针的干预阶梯,在 CARLA 仿真为主、真实视频为辅的数据上做对照。
结果很刺眼:提示层表现高度模型与任务依赖,前进/后退常出现系统性类别崩塌;更精致的提示提升流畅度,却不保证时序正确。相反,轻量 LoRA 与简单特征探针往往能恢复很强的运动判别,说明运动线索经常已经写在视觉表征里,却没有被最终视频到语言通路稳定用上。结论因此很克制:现成 VidLLM 更像偏置驱动的帧级识别器,而不是可依赖的驾驶时序世界模型。
英文题目:Mind the Temporal Gap: Evaluating Video Models for Temporal Understanding in Driving
论文出处:arXiv 每日论文精选 · arXiv:2610.12575
原始论文:PDF / 论文页面
这篇论文解决什么问题?
若视频语言模型真能充当世界模型,它们至少应抓住场景如何随时间变化。通用基准分数在涨,但捷径研究表明单帧、打乱帧或语言先验也能解释可观表现;新的时空 grounded 基准也显示模型未必对准证据出现的时间与位置。
驾驶把这一缺口放大。安全行为依赖从演化线索推断自车动态,而自然语言接口正在进入驾驶相关推理管线。作者因此不问“能不能聊天讲视频”,而问“能不能稳健读出自车运动原语”。
核心创新
- 面向驾驶的自车运动时序评测协议,覆盖进退、左右与加减速。
- 多层干预谱系:从多种提示到 LoRA 与中间特征探针。
- 定位运动线索保存在何处、又在哪一环未能变成可靠语言判断。
方法概览
评测阶梯从训练免费提示到轻量学习:标准提示、绿色框视觉提示、少样本视觉—文本融合、思维链、思维链加视觉提示,再到 LoRA 微调,以及在视觉压缩前后提取中间特征并训练一层 CNN/线性探针。视频主要为 CARLA 第三人称自车片段,每类运动约二百条,并含较小真实驾驶对照;问题为二分类运动判别。特征探针比较压缩前高分辨率视觉 token 与压缩后送给语言模型的表征,以区分“信息丢失在压缩”与“信息在但语言侧用不上”。
- 提示层从弱到强。标准提示直接问车辆运动方向;视觉提示给静态参照物加绿框,看空间锚定是否帮助;少样本先给正反例再问查询视频;思维链显式把参照物尺寸或位置变化解释成靠近/远离与自车运动;二者还可叠加。
- 学习层有两步。LoRA 在注意力与投影中插入低秩适配器,用运动标签做轻量微调,测试架构是否具备可被激发的运动表示。特征提取则在视觉压缩/投影前后取出表征,训练一层线性或 CNN 探针,比较信息在压缩前是否可解码、压缩后是否仍在、以及提示失败是否发生在“有信息却说不对”。
- 不同模型的探针位点按结构定义:如 VideoLLaMA2 看 STC 前后,Qwen2-VL 系看 token merger 前后,InternVL 看下采样投影前后,MiniCPM-V 看 resampler 前后。
- 数据以 CARLA 第三人称自车片段为主,场景含静态参照物;每类运动约二百视频,问题为二分类。标准提示额外看较小真实集,并报告仿真—真实相关。
逐图理解论文
评测设定
该资产对应论文对 Figure 1 探测管线的结果段说明:从标准提示、视觉提示、视觉文本融合、思维链,到 LoRA 与特征提取,干预强度递增。读时应抓住训练免费提示与轻量学习探针的分界——后文几乎所有对比都沿着这条谱系展开。页面裁切偏文本,讲图时结合首页管线示意理解六级方法。
提示层失败
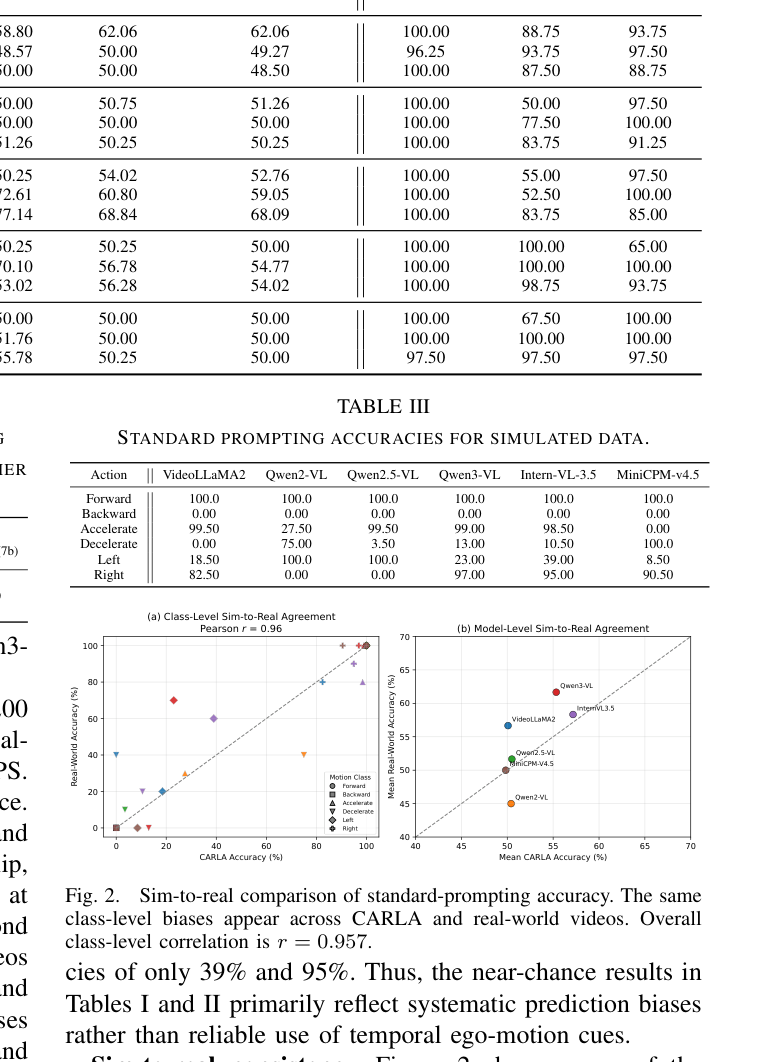
图2把标准提示准确率放到仿真—真实平面。(a)类别级点接近对角线,总体相关约零点九六,说明 Forward 强、Backward 崩等偏置会一起迁移到真实视频;(b)模型级均值同样同向排序。下方还可见各类动作在不同模型上的极端分化。适合用来否定“只是仿真太假”的简单解释。
代际趋势
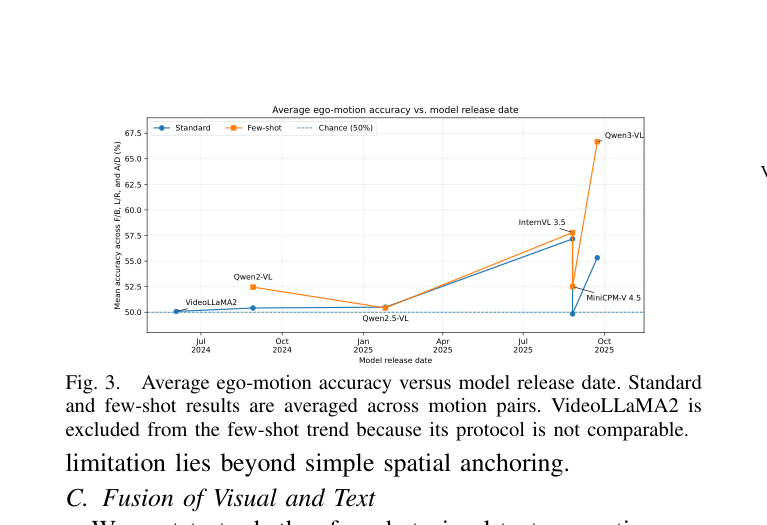
图3画平均自车运动准确率随模型发布日期的变化,并分开标准提示与少样本。机会水平在百分之五十;标准曲线只缓升,少样本在 Qwen3-VL 处抬升更明显,但仍远称不上稳健时序理解。VideoLLaMA2 因协议不可比未进少样本趋势。可用来讲“代际变强不等于提示层已经可靠”。
实验如何设计?
- 模型覆盖 VideoLLaMA2 与多代 Qwen-VL,以及 InternVL 3.5、MiniCPM-V 4.5。
- 主表报告三组运动对在标准、视觉提示、少样本、少样本+CoT、再加视觉提示、LoRA、压缩前/后特征探针上的准确率。
- 另用类别级与模型级散点看法代际趋势,以及标准提示是否随发布时间系统性变强。
关键结果与论文证据
- 标准提示下,前进/后退对所有评测模型都崩成 Forward 全对、Backward 全错;左右与加减速也常强烈偏置。真实集上同类偏置与仿真高度相关,说明不是单一仿真伪影。
- 视觉提示与思维链并不稳定救场:有时略升,有时不变甚至下降。少样本对较新模型的部分任务有明显收益,例如 Qwen3-VL 在左右与加减速上提升较大,但前进后退仍接近随机,收益无法跨运动类别一致迁移。
- LoRA 几乎把各模型拉到近完美运动判别,说明瓶颈更像监督与通路可用性,而非完全没有时序容量。不过微调后输出形态变成有监督分类,不再是开放式推理。
- 特征探针普遍远强于提示:许多设置下运动信息在压缩后仍可解码,却仍无法变成可靠自然语言答案。这支持“表征与语言推理之间存在缺口”的核心主张。代际图上,标准提示只缓升,少样本改善更大但任务依赖强。
阅读时需要注意
- 评测聚焦受控自车运动原语,不是完整驾驶决策;CARLA 与小真实集不能代表全部路况与传感器配置。
- LoRA 成功不等于提示式世界模型成功;特征可解码也不等于因果可解释。
- 作者提醒:没有显式时序 grounding 与动态感知训练前,不宜把现成 VidLLM 当可靠驾驶视频世界模型。
关联工作
- 工作位于视频基础模型与 VidLLM 快速发展、同时又被捷径基准质疑的交叉点。它不提出新生成架构,而是用驾驶自车运动做诊断。
- 与强调时空对齐的新基准相呼应,但把任务改成安全相关、可用轻量适配与探针解释失败位置的原语判别。