快速导读:ReWEIGH 是一种免训练的解码干预方法,通过聚合视觉位置的词汇排名(DMRR)并与词元特定参考比较,对有证据不足的候选词元施加有界惩罚,从而缓解 LVLM 幻觉。
大视觉语言模型在生成图像描述时,经常输出图像中并不存在的对象,这种现象被称为对象幻觉。现有缓解方法要么需要额外的模型前向传递或外部验证器,计算开销大;要么缺乏针对每个候选词元的图像支持度度量,干预不够精准。ReWEIGH 从视觉词元的隐藏状态中提取词汇排名信号,构建一个免训练的解码干预框架,在不增加额外前向传递的前提下,对证据不足的候选词元施加有界惩罚。
论文的核心论点是:视觉词元隐藏状态经输出头投影后得到的概率幅值跨位置不可比,但词汇排名具有尺度不变性,可以作为稳定的证据度量。然而,不同词元的典型排名证据水平存在系统性差异,因此需要词元特定的参考表来校准。ReWEIGH 通过 Measure–Register–Intervene 三阶段流程实现这一思想,并在多个骨干和基准上验证了其有效性。
英文题目:ReWEIGH the Evidence: Calibrating Token-Level Ordinal Visual Evidence to Mitigate Hallucinations in Large Vision-Language Models
论文出处:arXiv 每日论文精选 · arXiv:2608.19075
原始论文:PDF / 论文页面
这篇论文解决什么问题?
LVLM 幻觉的根源在于生成过程对语言先验的过度依赖。当模型在解码时遇到一个在语言上合理但图像不支持的对象时,它可能仍然赋予该词元较高的概率。现有的对比解码方法如 VCD 需要额外的视觉前向传递,OPERA 依赖注意力过信任惩罚和回溯分配,DoLa 通过层间对比提高事实性,PAI 通过注意力控制图像依赖。这些方法要么计算开销大,要么干预粒度不够精细。
ReVisiT 是最直接相关的内部表征干预方法,它选择单个视觉词元并用其概率投影细化输出,但未聚合所有视觉位置的证据。Jiang et al. 2025 的工作表明,词汇投影可以揭示视觉表征中区分接地对象与幻觉对象的信号。logit lens 技术将隐藏状态投影到词汇空间,为这类方法提供了基础。
然而,直接使用概率幅值作为证据度量存在一个根本问题:不同视觉位置的输出头投影幅值尺度差异很大,导致概率值跨位置不可比。论文通过实验展示了这一现象:即使经过尺度均衡化,排名前十的概率在视觉位置间的离散度仍然很大。这意味着需要一个尺度不变的度量来聚合跨位置的证据。
核心创新
- 提出基于词汇排名的 DMRR 聚合,对每个位置的严格递增变换不变,避免概率幅值的尺度依赖
- 识别出序数视觉证据中强烈的词元依赖成分,引入候选条件化的词元特定校准
- 设计有界、单侧、免训练的解码干预,prefill 时缓存证据,解码时仅需候选选择和有界 logit 更新
- 引入基于参考稳定性诊断的注册规则,对参考不确定的词元弃权
方法概览
ReWEIGH 采用 Measure–Register–Intervene 流程:Measure 在 prefill 阶段计算图像级 DMRR 证据并缓存;Register 在无标签图像上离线构建经可靠性过滤的词元参考表;Intervene 对证据低于参考的已注册候选词元施加有界负向 logit 惩罚。
- Measure 阶段:在 prefill 阶段,将每个视觉词元的隐藏状态通过输出头投影到词汇空间,得到每个词汇的排名。然后计算 DMRR(密集平均倒数排名),即对所有视觉位置取每个词汇的倒数排名的平均值。这个度量对每个位置的严格递增变换不变,因此避免了概率幅值的尺度依赖。
- Register 阶段:在无标签图像上离线构建词元参考表。对于每个词元,计算其在多张图像上的 DMRR 分布,并使用参考稳定性规则决定是否注册该词元。参考稳定性规则基于编辑不确定性:如果词元的参考值在不同图像子集上波动过大,则弃权不注册,避免对参考不确定的词元进行干预。
- Intervene 阶段:在解码时,对于每个候选词元,如果其图像级 DMRR 证据低于词元特定参考值,则施加有界的负向 logit 惩罚。惩罚是单侧的,只惩罚证据不足的候选,不奖励证据充足的候选。有界性确保干预不会过度改变模型的输出分布。
- 词元特定参考的必要性:论文通过方差分解实验(Figure 2)发现,DMRR 的变异性中,词元身份成分占主导地位,图像成分次之。这意味着不同词元天然具有不同的典型排名证据水平。例如,常见对象词可能因为语言先验强而排名靠前,而罕见词即使图像支持也可能排名靠后。使用全局参考会混淆这种词元依赖成分,导致校准误差大。
- 论文通过 Figure 3 和 Table 12 展示了词元特定参考相对全局参考的优势:样本外校准误差降低约 92%(LLaVA-1.5-7B)和 91%(Qwen2.5-VL-7B)。打乱参考(shuffled reference)的校准误差介于两者之间,说明词元身份信息是关键。
- 有界惩罚的设计:干预强度被限制在一个有界范围内,避免对模型输出分布造成过大扰动。论文通过消融实验(Table 3)验证了有界更新优于无界更新,单侧更新优于双向更新。无弃权(即对所有词元都注册参考)会降低性能,说明参考稳定性规则是必要的。
- 计算效率:由于 DMRR 证据在 prefill 阶段计算并缓存,解码时只需要对候选词元进行查表和 logit 更新,不需要额外的模型前向传递。论文报告平均每词元延迟增加约 1.33%(缓存证据协议),端到端含 prefill DMRR 计算为 2.40%,峰值内存增加约 0.31%。
逐图理解论文
失败案例与直觉
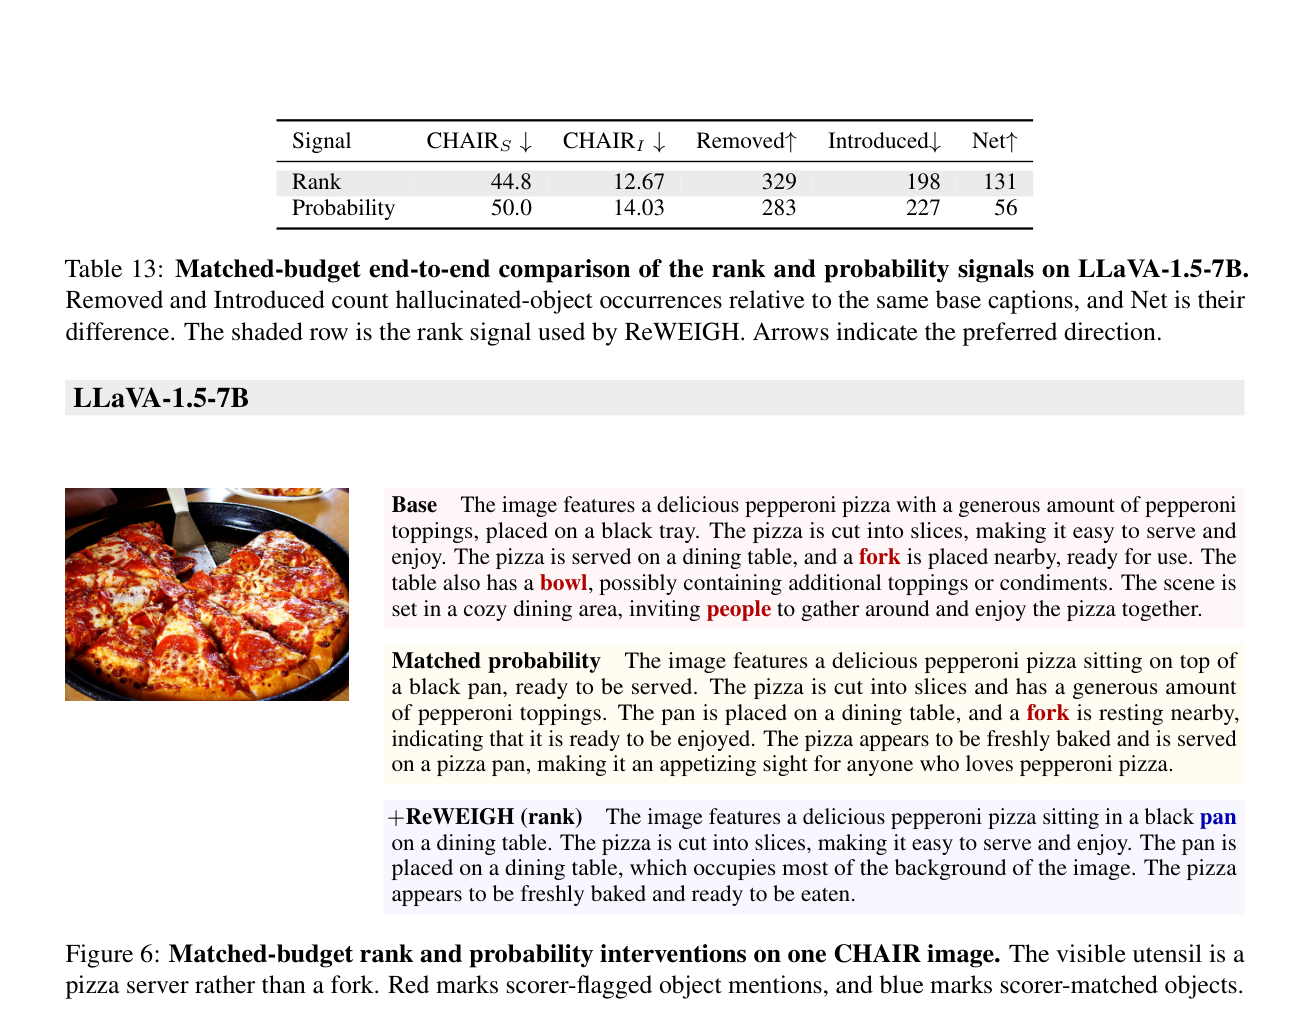
想象一个场景:模型看到一张披萨的照片,却自信地描述出叉子。叉子在语言上很合理,但图像里根本没有。问题在于,解码时模型过度依赖语言先验,而视觉证据没有被有效利用。更麻烦的是,直接从视觉词元读取的概率幅值跨位置不可比,无法直接作为证据。
核心区分:排名与词元特定校准
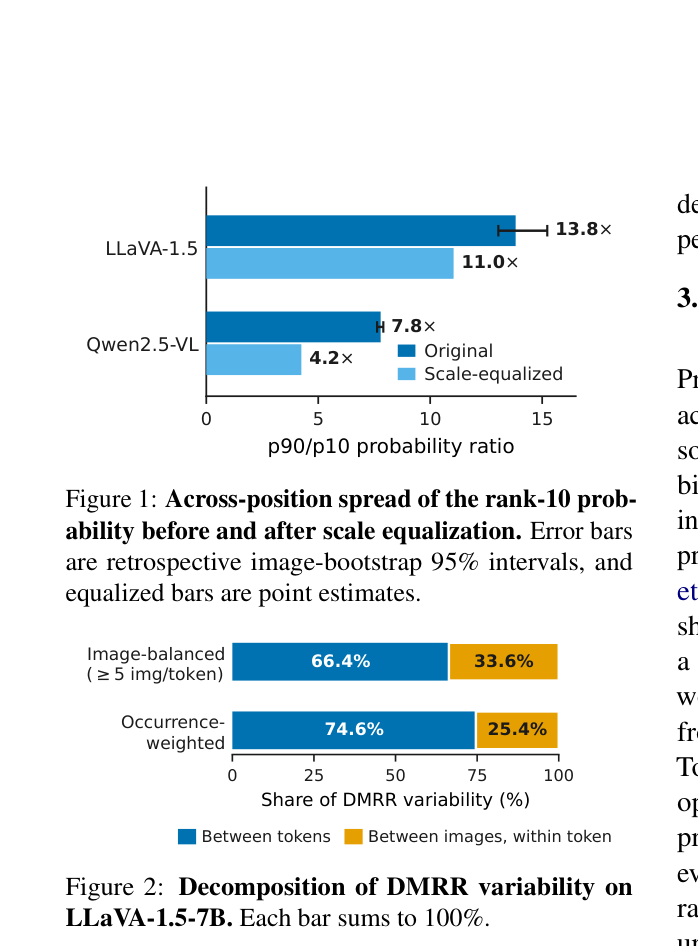
ReWEIGH 的关键洞察有两点。第一,词汇排名对每个位置的严格递增变换不变,因此比概率幅值更稳定。第二,不同词元的典型排名证据水平存在系统性差异,必须用词元特定的参考来校准,而不是一个全局阈值。
方法贡献与验证
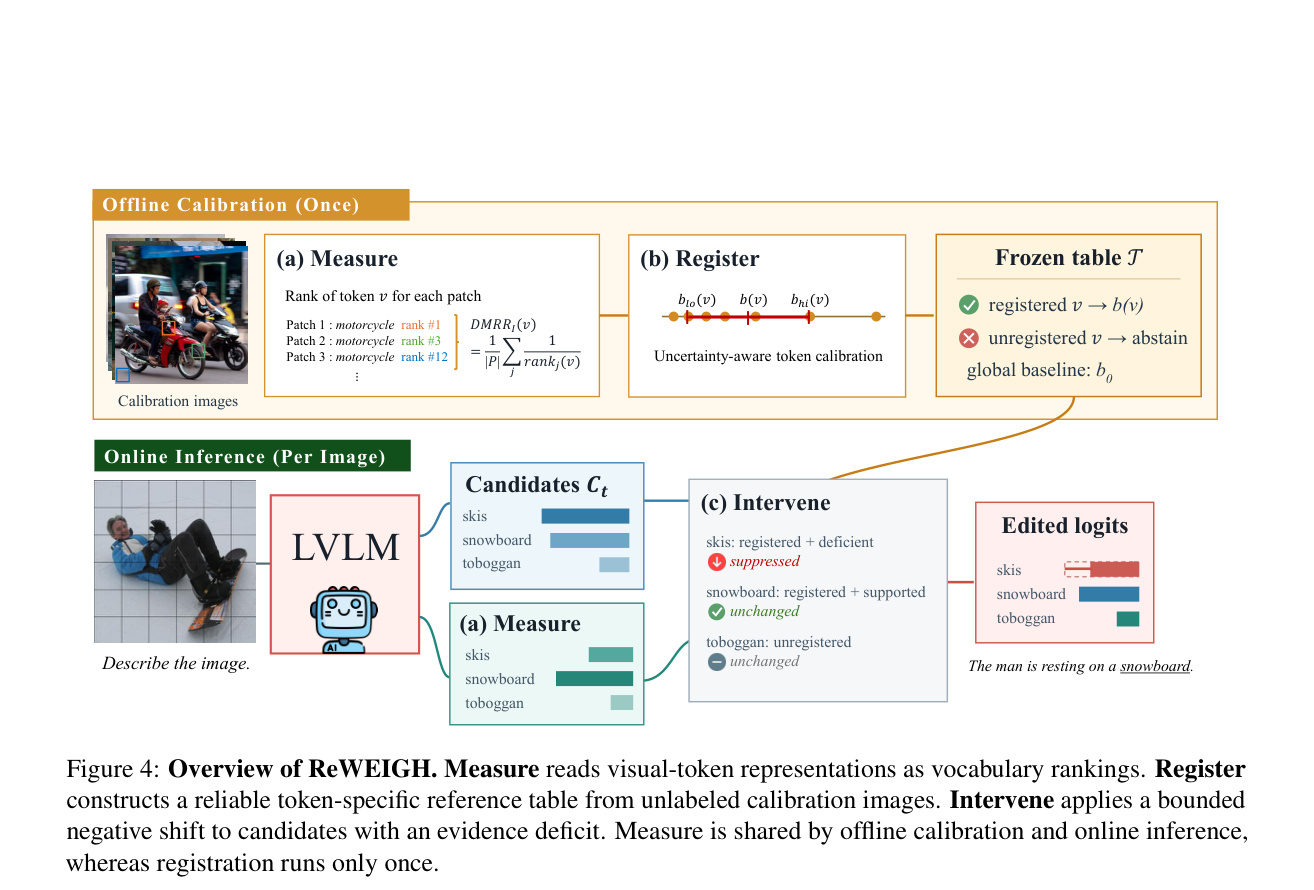
这张图展示了 ReWEIGH 的 Measure–Register–Intervene 三阶段流程。Measure 在 prefill 阶段将视觉词元表征读取为词汇排名并计算 DMRR 证据;Register 在离线阶段从无标签图像构建可靠性过滤的词元参考表;Intervene 在解码时对证据不足的候选词元施加有界负向偏移。注意 Measure 被离线校准和在线推理共享,而注册只运行一次,这解释了方法的计算效率。
消融与效率
这张表展示了 LLaVA-1.5-7B 上的组件消融结果。通过对比全局参考、打乱参考、错配证据、无弃权、双向更新和无界更新等变体,可以验证每个设计选择的必要性。特别关注无弃权和双向更新的退化,说明参考稳定性规则和单侧有界惩罚是关键。
实验如何设计?
- 在四个 7B 骨干上评估:LLaVA-1.5-7B、Qwen2.5-VL-7B、InstructBLIP-7B、LLaVA-NeXT-7B。这些骨干覆盖不同的架构家族和训练策略。
- 评估基准包括 CHAIR(对象幻觉评估,CHAIRS 为句子级幻觉率,CHAIRI 为提及级幻觉率)、AMBER(无 LLM 的多维幻觉评估)、MMHal-Bench(开放式多模态幻觉评估)和 MM-Vet(综合多模态能力评估)。
- 与五种基线方法对比:VCD、OPERA、DoLa、PAI、ReVisiT。所有方法在相同骨干和评估协议下运行。
- 组件消融实验:全局参考、打乱参考、错配证据、无弃权、双向更新、无界更新,用于验证每个设计选择。
- 校准规模扫描:从 10 到 1,000 张图像,验证参考表构建所需的最小校准数据量。
- 扩展到 11 个模型、六种架构家族、7B 到 32B 参数,验证方法的泛化性。
关键结果与论文证据
- CHAIRI 在四个 7B 骨干上降低 10.3%–21.3%(第 7 页),这是论文的核心量化结果。
- LLaVA-1.5-7B 上 CHAIRS 从 52.60 降至 44.80,CHAIRI 从 15.61 降至 12.67(第 6 页,Table 1)。
- Qwen2.5-VL-7B 上 CHAIRS 从 31.60 降至 25.40,CHAIRI 从 9.58 降至 7.54(第 6 页,Table 1)。
- InstructBLIP-7B 上 CHAIRS 从 49.60 降至 46.00,CHAIRI 从 14.03 降至 12.50(第 6 页,Table 1)。
- MMHal-Bench 分数和 MM-Vet 准确率在全部四个骨干上提升或保持(第 7 页,Table 2),说明干预不仅降低幻觉,还保持或提升开放生成质量。
- 词元特定参考相对全局参考将样本外校准误差降低 92%(LLaVA-1.5-7B)和 91%(Qwen2.5-VL-7B)(第 4 页,Figure 3),这是词元特定校准的核心证据。
- 10 张校准图像即可恢复 CHAIRS 降低量的一半,100 张匹配默认 CHAIRS(第 8 页,Figure 5),说明参考表构建的数据需求很低。
- 平均每词元延迟增加 1.33%(缓存证据协议),端到端含 prefill DMRR 计算为 2.40%,峰值内存增加 0.31%(第 8 页,Table 16),证明推理开销极小。
阅读时需要注意
- 需要访问视觉词元隐藏状态、输出归一化和词汇头,无法通过封闭 API 使用。这意味着只有开源模型才能应用 ReWEIGH。
- 每个骨干需要单独的校准表、读出层和干预强度,未验证跨骨干迁移。这增加了部署的工程成本。
- 仅从模型视觉表征获取信号,无法补充图像和骨干都不含的事实。如果模型本身缺乏某些视觉理解能力,ReWEIGH 无法弥补。
- 所有实验仅用英语,未验证多语言场景。
- 有界干预仍可能留下幻觉或用不同错误替换。干预是缓解而非根治。
关联工作
- VCD(Leng et al., 2024)通过视觉对比解码缓解幻觉,但需要额外的视觉前向传递或解码传递,计算开销大。ReWEIGH 避免了这一开销。
- OPERA(Huang et al., 2024)基于注意力过信任惩罚和回溯分配缓解幻觉,但使用五束搜索,解码成本与贪婪解码不可直接比较。
- DoLa(Chuang et al., 2024)通过层间对比解码提高事实性,但未针对视觉证据进行词元级校准。
- ReVisiT(Cho and Kim, 2026)是最直接相关的内部表征干预方法,选择单个视觉词元并用其概率投影细化输出,但未聚合所有视觉位置证据,也未进行词元特定校准。
- logit lens(nostalgebraist, 2020)是将隐藏状态投影到词汇空间的基础技术,ReWEIGH 在其基础上引入排名度量和词元特定参考。