快速导读:提出ClustRS,一种免训练的两阶段视觉token剪枝方法,通过注意力加权Huber k-means聚类选择代表性token,并用鲁棒残差收缩去噪,在极端压缩和噪声条件下显著提升VLM鲁棒性。
视觉语言模型(VLM)如LLaVA需要处理数百个视觉token,而语言模型自注意力的二次复杂度使边缘部署成本高昂。免训练token剪枝方法因轻量、易适配架构变化而受到关注,但其在真实图像噪声下的鲁棒性长期未被系统研究。本文提出ClustRS,一种免训练的两阶段方法:先用注意力加权Huber k-means++聚类选择代表性token,再以簇质心为锚点对选中token做鲁棒残差收缩去噪。
核心论点是:现有免训练剪枝方法在噪声下失效,并非因为剪枝本身,而是因为其选择准则在噪声扰动下不稳定,且被选中的token本身仍受噪声污染。ClustRS通过聚类结构约束选择过程、通过收缩去噪修复选中token,从而在极端压缩和强噪声条件下同时获得效率与鲁棒性。
英文题目:Clustering and Token Denoising for Faster and More Robust VLMs
论文出处:arXiv 每日论文精选 · arXiv:2608.19285
原始论文:PDF / 论文页面
这篇论文解决什么问题?
免训练token剪枝的代表方法FasterVLM利用[CLS] token的自注意力分数选择top-k token。本文的分析揭示了一个关键问题:该排名在噪声下极不稳定。实验显示,在σ=0.1的轻微高斯噪声下,原始top-15 token的平均排名变化高达288,重叠率仅13%。这意味着轻微的图像扰动就能彻底改变被选中的token集合,导致下游推理质量剧烈波动。
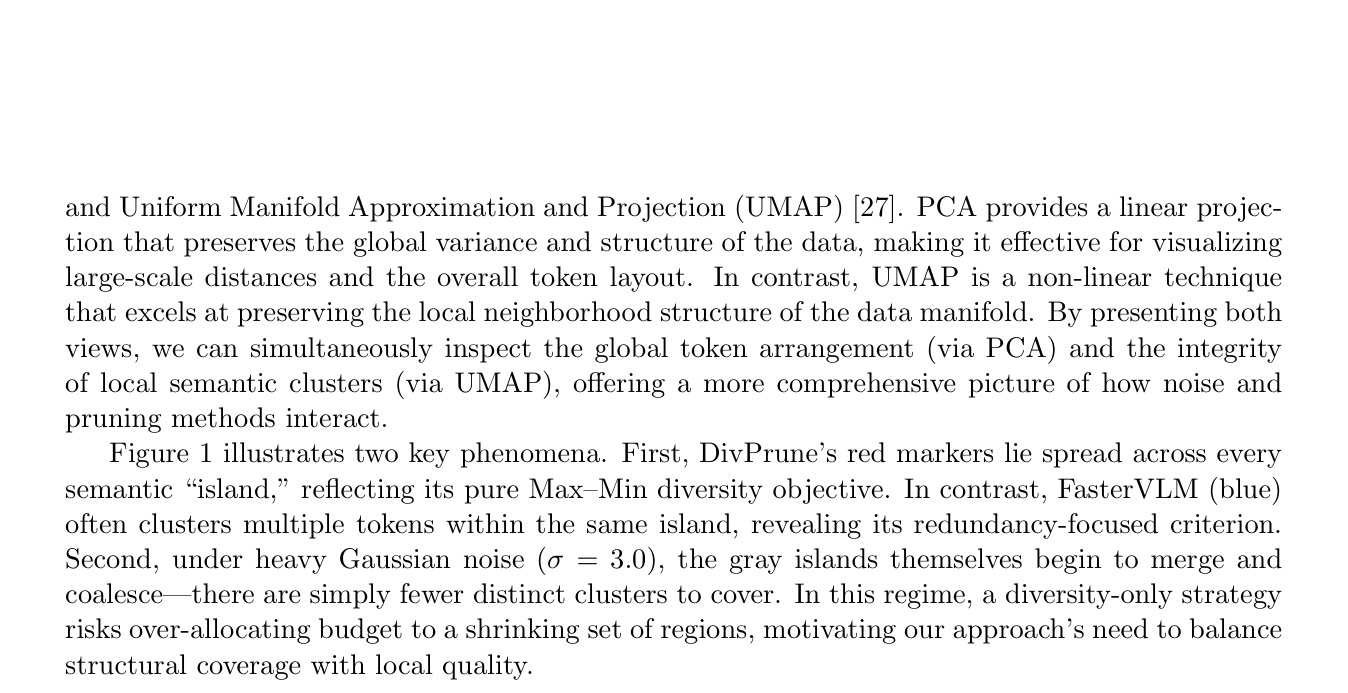
另一类方法DivPrune采用纯多样性策略,求解Max-Min Diversity Problem以覆盖不同的语义区域。然而,本文通过PCA和UMAP可视化发现,在严重高斯噪声(σ=3.0)下,原本分离的语义簇会合并成一个大的灰色区域。此时多样性策略会过度分配预算给一个正在收缩的区域集合,浪费了本应用于其他重要信息的token预算。
更深层的问题是:即使选择策略完美,被选中的token本身仍然携带噪声。现有方法只关注"选哪些token",却忽略了"选中的token是否干净"。这一盲点在严重噪声下尤为致命,因为噪声污染会直接传播到语言模型的输入。
核心创新
- 提出注意力加权Huber k-means++聚类(C+H),在投影后空间同时平衡语义多样性与token显著性,并对噪声离群点鲁棒
- 提出鲁棒残差收缩(RRS),一种单遍、免训练的token级去噪步骤,以簇质心为低方差锚点自适应收缩残差,不改变token方向统计
- 针对SigLIP骨干提出范数感知显著性修正,利用特征向量范数恢复扁平的注意力排序信号
- 首次系统研究免训练token剪枝在非对抗性图像噪声下的鲁棒性,并证明聚类+去噪可同时提升效率与噪声韧性
方法概览
ClustRS包含两个免训练组件:(1) C+H——在视觉-语言投影层之后,用注意力加权的Huber k-means++聚类,每个簇保留一个注意力最高的代表token,Huber距离抑制噪声离群点对质心的拖拽;(2) RRS——对选中token,以簇质心为锚点,用自适应收缩系数αi=δj²/(‖ri‖²+δj²)(裁剪到[0.10,0.95])做凸组合去噪,灵感来自James-Stein估计器。对SigLIP骨干,额外引入范数感知显著性si=ai+λ·max(0,‖vi‖−μ‖v‖)以恢复排序信号的动态范围。
- C+H模块在视觉-语言投影层之后运行,对投影后的token做注意力加权Huber k-means++聚类。注意力权重来自[CLS] token的自注意力分数,使聚类在语义结构上偏向重要区域。
- Huber距离是C+H的关键设计:对残差小于阈值τ的部分用平方损失,大于τ的部分用线性损失。这抑制了噪声离群点对质心的拖拽,使聚类在噪声下保持稳定。
- 每个簇只保留一个注意力最高的代表token,从而在语义多样性与token显著性之间取得平衡。这与FasterVLM的纯显著性排序和DivPrune的纯多样性策略形成对比。
- RRS以簇质心为锚点,对选中token做凸组合去噪:x̃_i = x_i + α_i(c_j − x_i),其中收缩系数α_i = δ_j²/(‖r_i‖² + δ_j²),并裁剪到[0.10, 0.95]。该公式的灵感来自James-Stein估计器——在D≥3时向中心收缩可降低总MSE。
- RRS不改变token的方向统计,只收缩残差幅度,因此不会破坏token之间的相对关系。图3的PCA可视化显示,RRS的移动是簇内的局部微调,而非全局重排。
- 针对SigLIP骨干,本文引入范数感知显著性:s_i = a_i + λ·max(0, ‖v_i‖ − μ_‖v‖)。SigLIP的注意力分布比CLIP更平坦,特征向量范数编码了显著性信息,这一修正恢复了排序信号的动态范围。
- 整个流程是单遍、免训练的:不需要梯度、不需要额外数据、不需要修改模型架构,可直接插入任何VLM的视觉编码器与语言模型之间。
逐图理解论文
失效的直觉
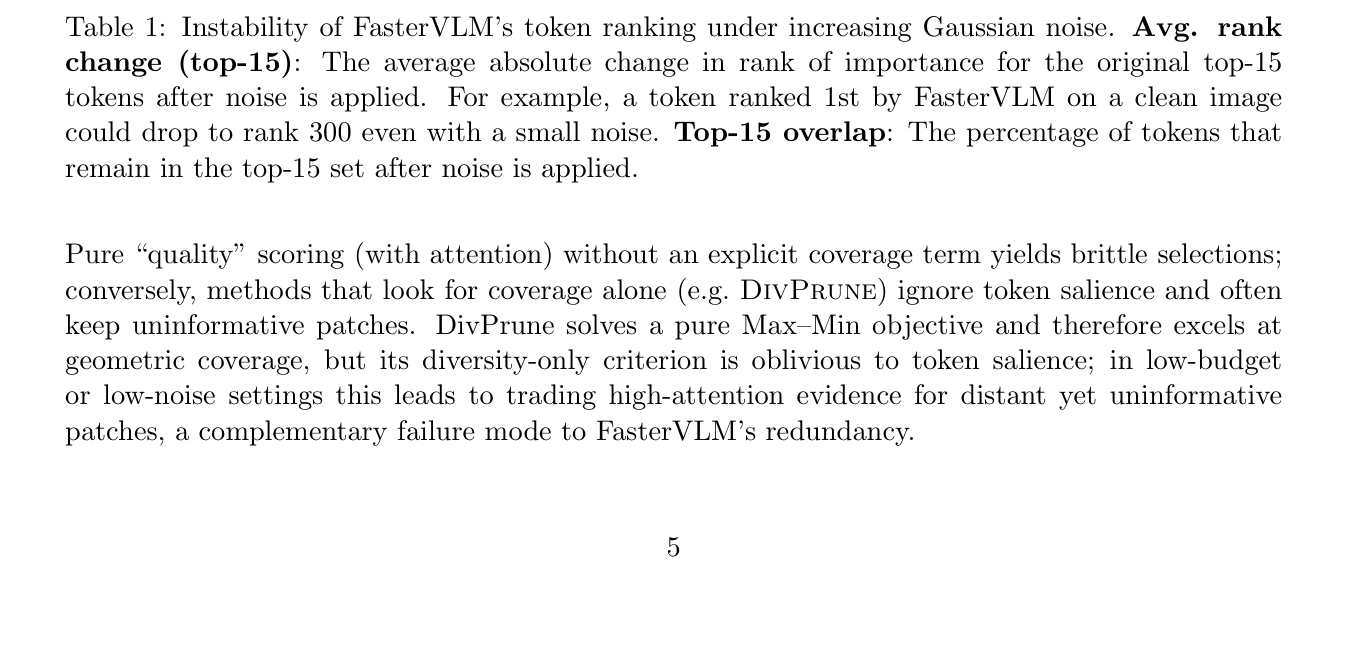
关注top-15平均排名变化和重叠率两列。σ=0.1时排名变化高达288、重叠率仅13%,直观展示了FasterVLM排名在轻微噪声下的极端不稳定性。
研究缺口
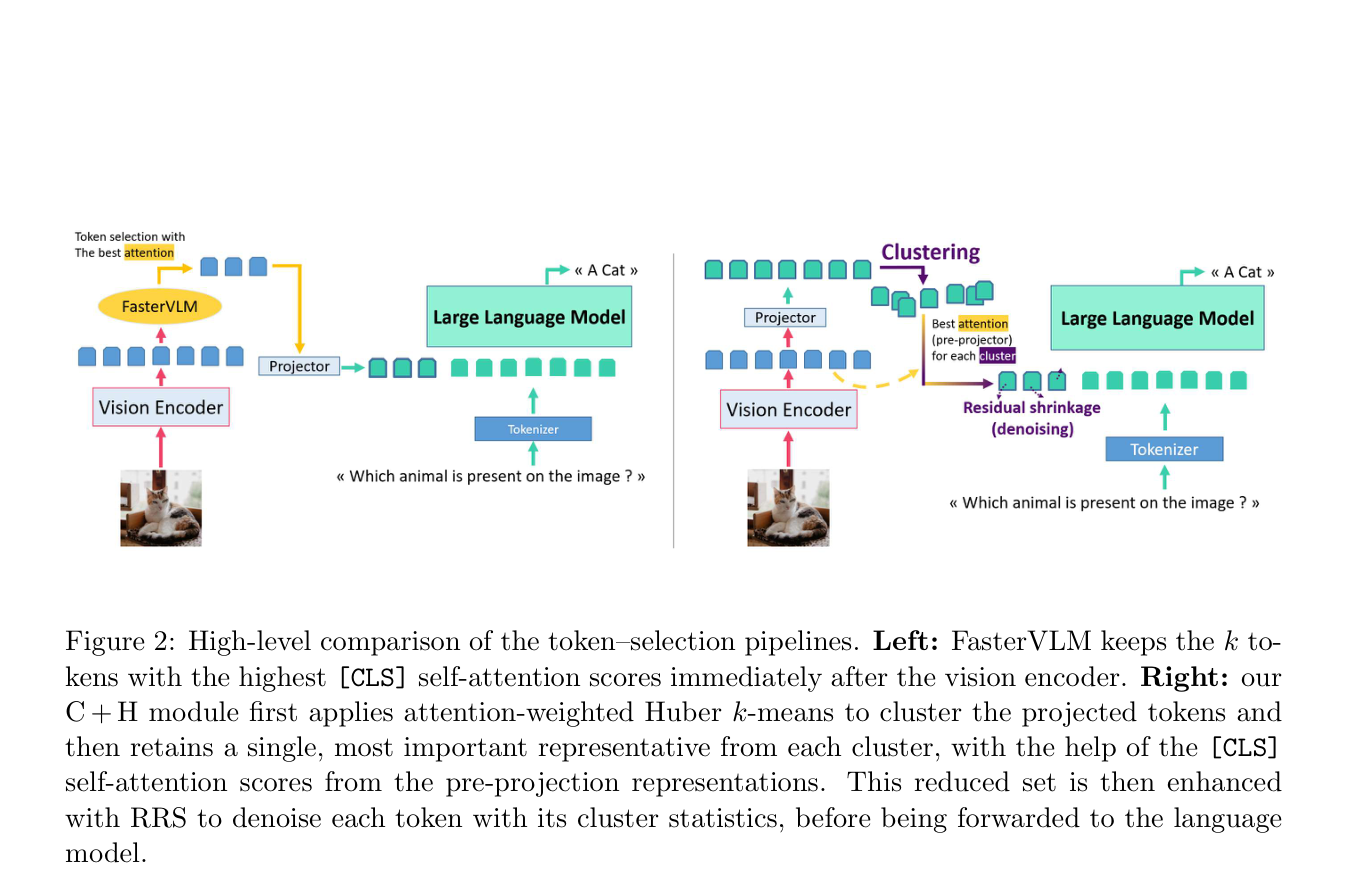
对比左右两条流水线。左侧FasterVLM直接选top-k,右侧ClustRS先聚类再选代表并做RRS去噪,清晰展示了方法的核心差异。
验证与结论
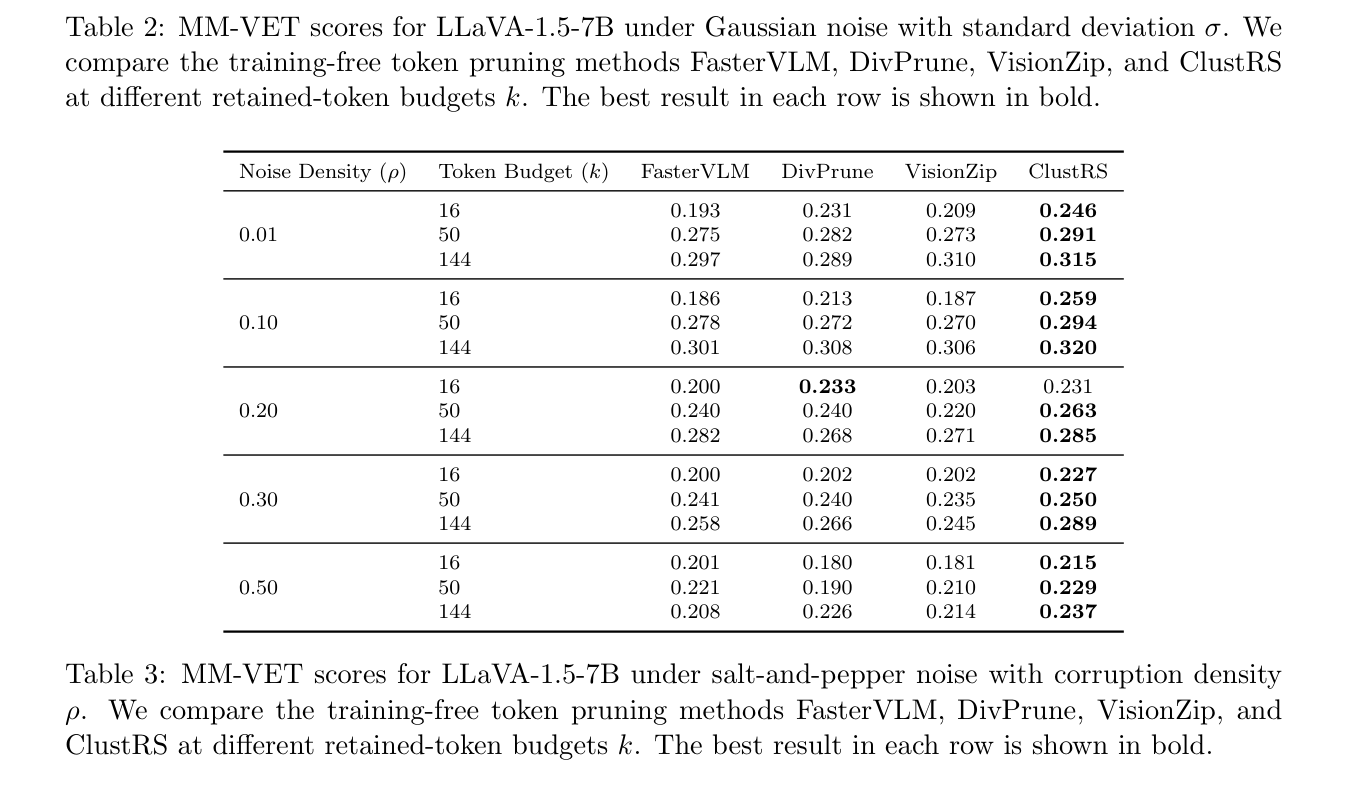
实验验证了这个思路。在MM-VET上,无论干净图像还是高斯噪声、椒盐噪声,ClustRS在极端压缩下都稳定领先三种免训练基线。消融实验进一步确认:Huber距离是鲁棒性的关键,而RRS在低token预算下带来额外增益。最有力的证据来自LLaVA-OneVision:在SigLIP骨干上,ClustRS配合范数感知显著性,在中等预算下比FasterVLM高出二十个百分点以上。结论很清晰:聚类约束选择、收缩修复token,这两步缺一不可。
意义与局限
对比不同裁剪区间的性能。无有效裁剪时性能大幅下降,说明裁剪对RRS的稳定性至关重要。
实验如何设计?
- 主实验在LLaVA-1.5-7B上进行,对MM-VET基准施加高斯噪声(σ∈{0.1, 0.5, 1.0, 2.0, 3.0})和椒盐噪声(ρ∈{0.01, 0.1, 0.2, 0.3, 0.5}),token预算k∈{16, 50, 144}。
- 对比方法为三种免训练剪枝基线:FasterVLM、DivPrune和VisionZip。
- 额外鲁棒性评估包括亮度/对比度变换、cutout遮挡、运动模糊和JPEG伪影。
- 在LLaVA-OneVision(SigLIP骨干)上验证范数感知显著性的适配效果,token预算k∈{16, 50, 180}。
- 消融实验对比标准k-means++聚类、C+H和完整ClustRS(含RRS),以分离各组件的贡献。
- 敏感性分析扫描Huber阈值τ和RRS裁剪区间,验证超参数的稳定性。
关键结果与论文证据
- 在MM-VET k=16的干净图像上,ClustRS达到0.271,显著高于FasterVLM的0.211、DivPrune的0.232和VisionZip的0.239(第17页)。
- 在MM-VET k=16、高斯噪声σ=3.0下,ClustRS为0.147,优于FasterVLM的0.132、DivPrune的0.132和VisionZip的0.133(第17页)。
- 在椒盐噪声ρ=0.5、k=16下,ClustRS为0.215,明显高于DivPrune的0.180和VisionZip的0.181(第17页)。
- 消融实验显示,RRS在k=16、σ=3.0下带来+0.037的增益(C+H的0.156提升到ClustRS的0.193),证明去噪在极端压缩下尤为关键(第21页)。
- 在LLaVA-OneVision k=50干净图像上,ClustRS达到0.347,比DivPrune的0.257和FasterVLM的0.145分别高出9.0和20.2个百分点(第24页)。
- 视觉开销在k=16时为35ms,与FasterVLM的33-34ms相当,远低于DivPrune的39-40ms(第20页)。
- Huber阈值τ在[0.5, 2]范围内性能稳定,默认值τ=1在多数设置下最优(第27页)。
- RRS裁剪区间对性能至关重要:无有效裁剪([0,1])时性能大幅下降,而[0.10, 0.95]等中等区间表现稳定(第27-28页)。
阅读时需要注意
- 特征空间聚类可能丢弃空间上不同但语义相似的token,影响细粒度定位和空间关系推理。
- RRS在严重密集高斯噪声(σ=3.0)且token预算较大(k=50, 144)时可能有害,此时C+H单独表现更好。
- 在k=144保守压缩下,ClustRS在部分高斯噪声水平上略逊于FasterVLM或DivPrune,优势不如极端压缩时一致。
- Huber阈值τ在严重高斯噪声下的最优值依赖token预算,单一阈值无法统一最优。
- ScienceQA-IMG为多选题,对细粒度视觉线索不敏感,方法优势在该基准上体现有限。
关联工作
- FasterVLM是免训练token剪枝的典型代表,利用[CLS]自注意力分数选top-k token。本文的分析揭示其排名在噪声下极不稳定,这是其鲁棒性缺陷的根源。
- DivPrune求解Max-Min Diversity Problem以最大化token多样性。本文指出其纯多样性策略在噪声导致语义簇合并时过度分配预算。
- 训练型方法如Honeybee、TokenPacker和TwigVLM通过重训练获得更好的压缩效果,但需要额外数据和计算资源。ClustRS的免训练特性使其在部署灵活性上具有优势。
- James-Stein估计器是统计估计理论中的经典结果:在D≥3时,向中心收缩可降低总MSE。这为RRS的收缩策略提供了理论动机。
- Shirnin等人对VLM进行了黑盒非对抗性噪声鲁棒性诊断分析,本文在其基础上提出了具体的缓解策略。