快速导读:提出包含5M视频对和1M图像对的可靠参考引导编辑数据集RefVideo-6M,并基于此训练RefMoT模型,在指令式和参考式视频编辑上取得SOTA性能。
RefVideo-6M是一个面向指令式视频编辑的参考引导数据集,核心主张是:现有编辑数据集依赖自动编辑模型生成目标视频,伪影被当作监督信号,模型学到的不是'编辑'而是'伪影风格'。本文通过反转源/目标视频角色,让真实拍摄视频充当编辑目标,从源头消除伪影污染。
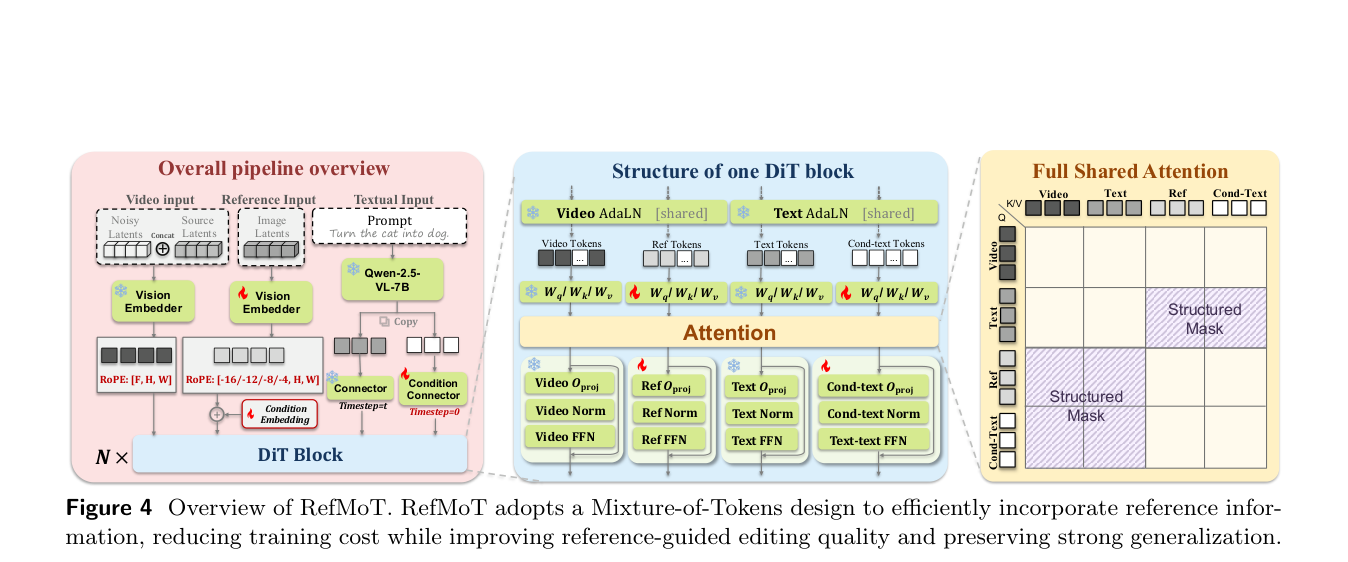
在此基础上,论文提出RefMoT(Mixture-of-Tokens)架构,以冻结主分支、仅训练参考token专用线性层的方式高效注入视觉参考,在指令式和参考式编辑评测中均取得SOTA,同时将Stage-2训练成本降低约50%。
英文题目:RefVideo-6M: A Reliable Reference-Based Dataset for Instructional Video Editing
论文出处:arXiv 每日论文精选 · arXiv:2608.26101
原始论文:PDF / 论文页面
这篇论文解决什么问题?
指令式视频编辑的早期范式依赖DDIM inversion:先反演源视频潜表示,再修改提示词重新生成。这种方法无需大规模配对数据,但对时序一致性和编辑精度控制力有限。
近两年社区转向数据驱动范式,InsV2V、InsViE、Señorita-2M、Ditto、OpenVE-3M、ReCo等数据集相继出现。它们的共同问题是:目标视频由编辑模型自动生成,模型自身的伪影(闪烁、纹理扭曲、边缘断裂)被当作ground truth。
更关键的是,这些数据集大多只提供文本指令,缺乏视觉参考。当用户想指定'换成这件衣服'或'保持这个人的身份'时,纯文本指令难以精确传达,编辑的可控性和身份保持能力受限。
本文的切入点因此清晰:监督信号不可靠与参考信息缺失,是同一问题的两个侧面。解决前者需要真实视频作为编辑目标,解决后者需要系统性地构建视觉参考。
核心创新
- 构建RefVideo-6M:5M视频对+1M图像对,12个专家、26个视频任务、6个图像任务,720p、81-129帧
- 通过反转源/目标视频角色,以真实无伪影视频作为编辑目标,提升监督可靠性
- 提供约6M视觉参考,覆盖10种参考类型(bbox、circle、mask、光照方向、风格、纹理、背景、物体、人物、服装)
- 提出RefMoT(Mixture-of-Tokens)架构:冻结主分支、仅训练参考token专用线性层,共享AdaLN保持统一特征空间,训练成本降低约50%
方法概览
从Pexels收集约1M视频,经DINO-V3去重、Qwen-VL-3-8B打标、Rex-Omni检测、SAM-2分割得到约40M掩码;使用12个编辑专家(含4个自训练专家)构建26个视频编辑任务和6个图像编辑任务;对多数任务反转源/目标视频角色,以真实无伪影视频作为编辑目标;用GPT-5.2生成指令并进行多维度质量过滤;基于HunyuanVideo1.5训练Stage-1指令编辑模型,Stage-2提出RefMoT架构,冻结主分支、仅训练参考token专用的MoT线性层,训练成本降低约50%。
- 数据来源:从Pexels收集约1M视频,经DINO-V3去重、Qwen-VL-3-8B打标、Rex-Omni检测、SAM-2分割,得到约40M掩码。
- 专家体系:使用12个编辑专家(8个开源+4个自训练)构建26个视频编辑任务和6个图像编辑任务,覆盖局部编辑、全局风格、结构控制等类别。
- 核心反转策略:对多数任务反转源/目标视频角色,让真实无伪影视频充当编辑目标。例如'添加物体'任务中,真实视频作为含物体的目标,编辑模型只需移除物体生成源视频——即使生成源视频有伪影,监督目标仍是真实的。
- 指令生成:用GPT-5.2生成编辑指令,并进行多维度质量过滤,确保指令与视觉变化对齐。
- 参考类型:提供约6M视觉参考,覆盖10种类型——bbox、circle、mask、光照方向、风格、纹理、背景、物体、人物、服装。
- Stage-1:基于HunyuanVideo1.5训练指令编辑模型,建立基础编辑能力。
- Stage-2 RefMoT:冻结主分支,仅训练参考token专用的MoT线性层,通过共享AdaLN保持统一特征空间,训练成本降低约50%。
逐图理解论文
失败案例与直觉
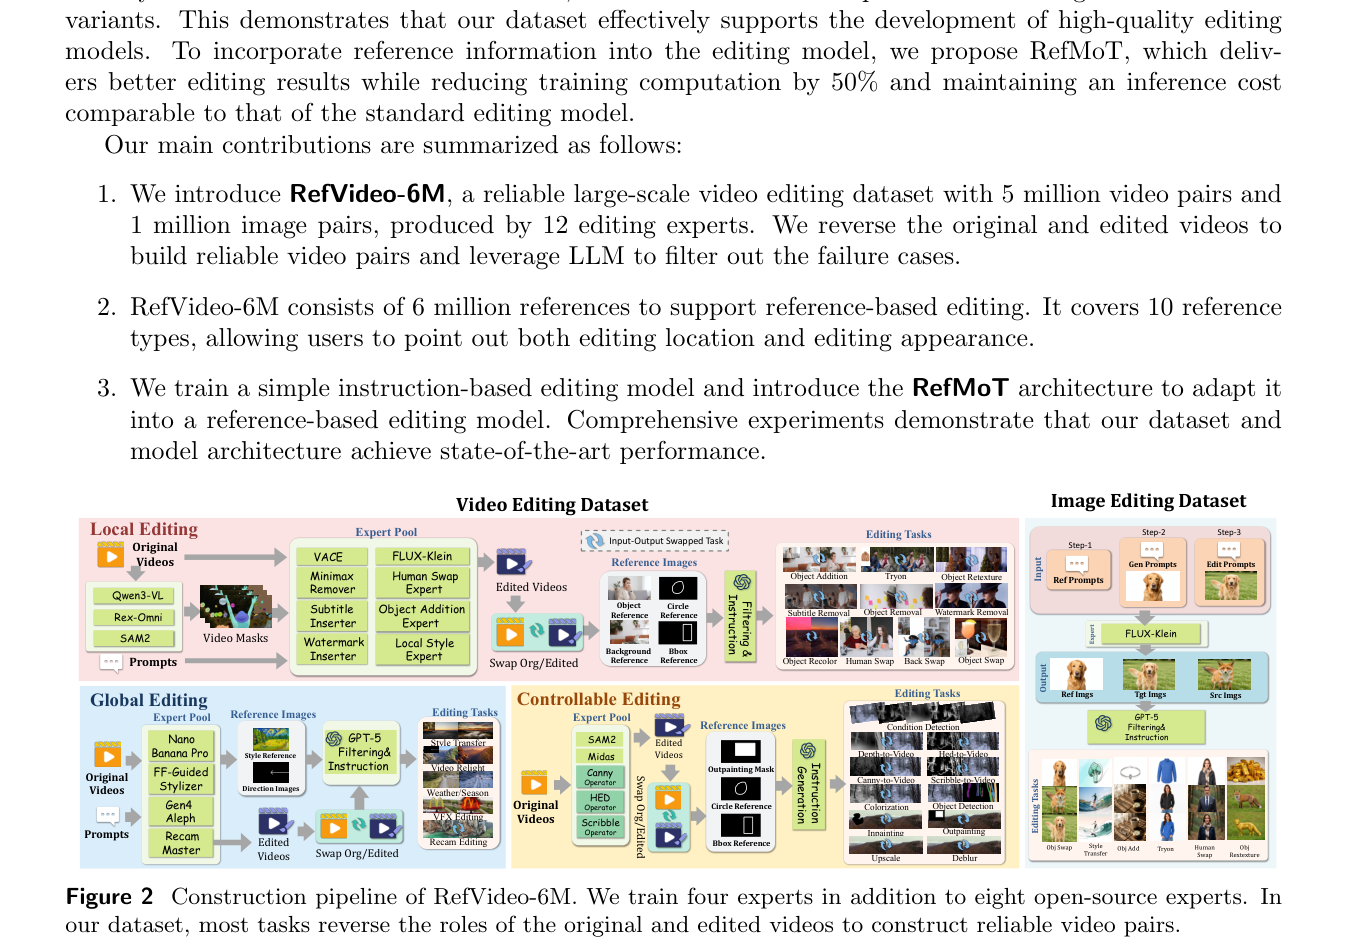
图2展示数据集构建流程,核心是'反转源/目标视频角色'策略。注意12个专家(8开源+4自训练)如何分工,以及反转策略在哪些任务上应用。
核心区分与研究缺口
表1对比OpenVE-3M、ReCo-500K、Ditto-1M、Señorita-2M、InsV2V、InsViE-1M等数据集。重点看专家数、任务数、参考类型三列,RefVideo-6M在规模和参考覆盖上明显领先。
最强结论
表4是消融结果,分数据集和架构两个维度。数据集消融证明RefVideo-6M优于所有基线数据集;架构消融证明完整RefMoT优于所有变体。
意义与局限
表3是参考式编辑评测结果,RefMoT在Overall上领先UniVideo。注意Attribute Alignment一列,RefMoT略低于UniVideo,这是参考引导的薄弱环节。
实验如何设计?
- 指令式编辑评测:与InsViE、InsV2V、VideoCoF、ICVE、ReCo、Ditto、Lucy、Señorita、Kiwi、Capybara、OmniVideo、UniVideo、VINO、Bernini等14个基线对比。
- 参考式编辑评测:与Kiwi、UniVideo、Bernini对比,评估参考引导下的编辑质量。
- 消融实验:数据集维度对比InsV2V、Señorita、InsViE、ReCo、OpenVE、Ditto;架构维度对比w/o RefMoT、不同比例RefMoT、Unfrozen Main等变体。
- 用户研究:33名用户,指令式和参考式各12题,评估编辑正确性、指令遵循、参考一致性、视觉质量四个维度。
- 评测一致性验证:在90个样本上验证LLM-as-judge与人工标注的二元标签一致性。
关键结果与论文证据
- 指令式编辑GPT-5.5 Eval Overall Score 4.22(最佳),Gemini-3-Pro Eval Overall Score 4.56(最佳,较第二名4.28提升0.28),见第7页Table 2。
- 指令式编辑CLIPScore 0.364589(最佳),Temp-Cons 0.985401(最佳),用户偏好54.7%(远超第二名7.9%),见第7页。
- 参考式编辑GPT-5.5 Eval Overall Score 4.03(较UniVideo的3.73提升0.30),Gemini-3-Pro Overall Score 4.16(较第二名3.98提升0.18),见第7页Table 3。
- 参考式编辑用户偏好52.5%(远超第二名17.9%),见第7页。
- 数据集消融:RefVideo-6M训练模型GPT-5.5 Overall 3.88(vs 最强基线数据集3.32),Gemini-3-Pro Overall 3.90(vs 3.21),见第9页Table 4。
- 架构消融:完整RefMoT GPT-5.5 Overall 4.22(vs 最强变体3.97),Gemini-3-Pro Overall 4.56(vs 4.08),见第9页。
- Stage-2训练成本降低约50%;推理约2分钟/单H100 GPU,32GB显存(指令式),46GB显存(参考式,KV-cache加速),见第9页。
- 参考式编辑的Attribute Alignment在Gemini-3-Pro评测中略低于UniVideo(3.86 vs 3.93),说明参考属性对齐仍有提升空间。
阅读时需要注意
- 参考式编辑的CLIPScore(0.354365)和Temp-Cons(0.973043)低于指令式编辑,参考引导下语义对齐和时序一致性仍有提升空间。
- 数据集来源单一(仅Pexels),场景多样性可能受限。
- 用户研究仅33人,样本量较小,统计效力有限。
- 论文arXiv编号为2608.26101,部分引用(如GPT-5.2、FLUX2-Klein-9B)为未来版本模型,需注意可用性。
关联工作
- InsV2V是早期指令式编辑模型,基于VideoP2P生成数据集,提出Long Video Sampling Correction,但目标视频含伪影。
- InsViE基于Stable Video Diffusion构建1M编辑对,采用多阶段学习策略,同样依赖自动生成目标。
- Señorita-2M有18个编辑任务、约2M视频对,但分辨率较低。
- Ditto基于VACE-14B构建,11任务、2M视频对、720p,是分辨率较高的基线。
- OpenVE-3M有8个常见编辑任务,使用Mixture-of-Experts connector,但仅2M样本开源。
- UniVideo是基于HunyuanVideo的统一理解/生成/编辑模型,是参考式编辑的主要基线。