视觉语言模型思维链忠实性反事实测试
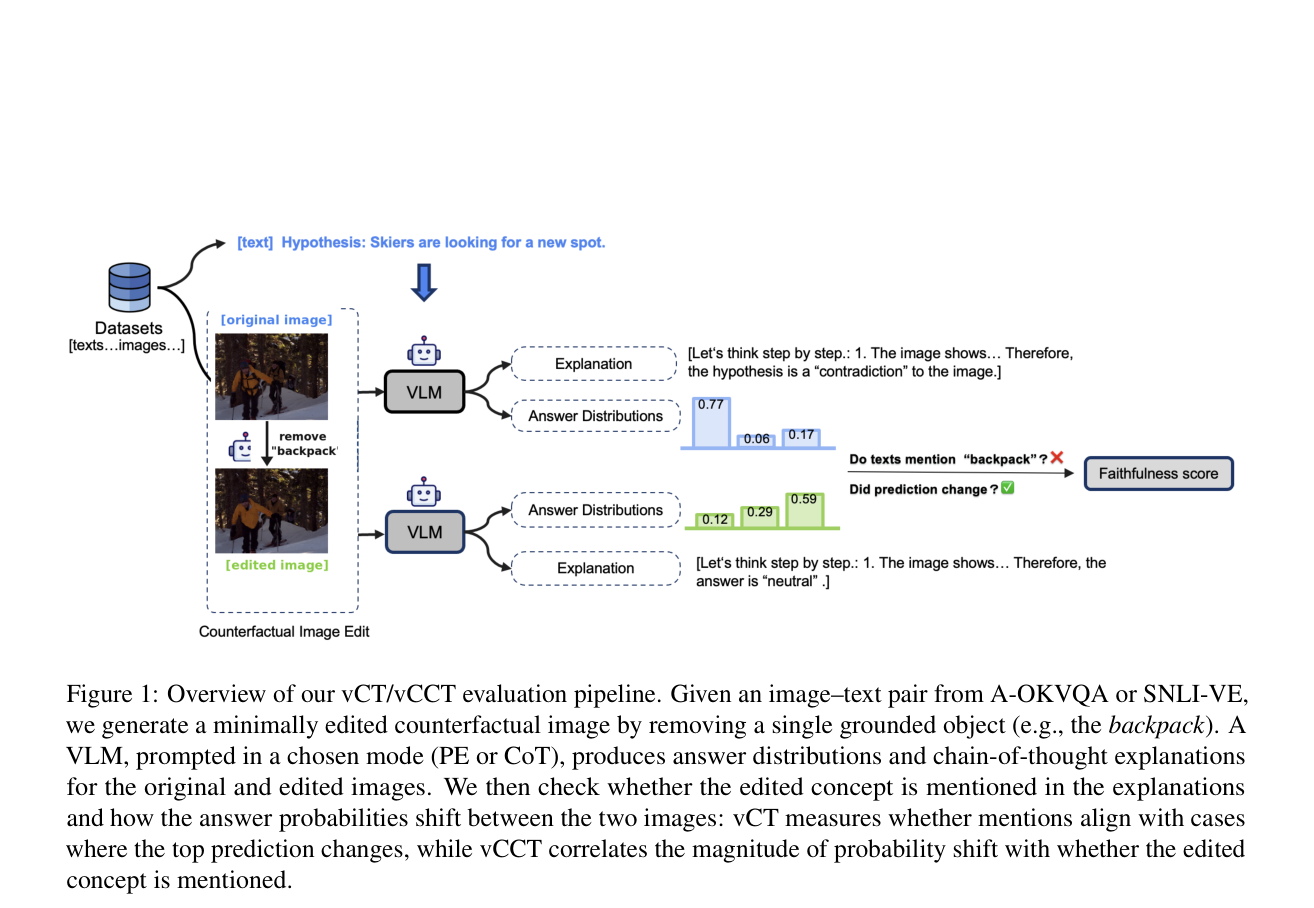
本文提出了vCT和vCCT两种反事实评估指标,通过移除图像中的特定对象来测试VLM的解释是否忠实于其预测变化,发现Predict-then-Explain (PE) 策略比Chain-of-Thought (CoT) 更忠实于视觉证据。
本文提出了vCT和vCCT两种反事实评估指标,通过移除图像中的特定对象来测试VLM的解释是否忠实于其预测变化,发现Predict-then-Explain (PE) 策略比Chain-of-Thought (CoT) 更忠实于视觉证据。
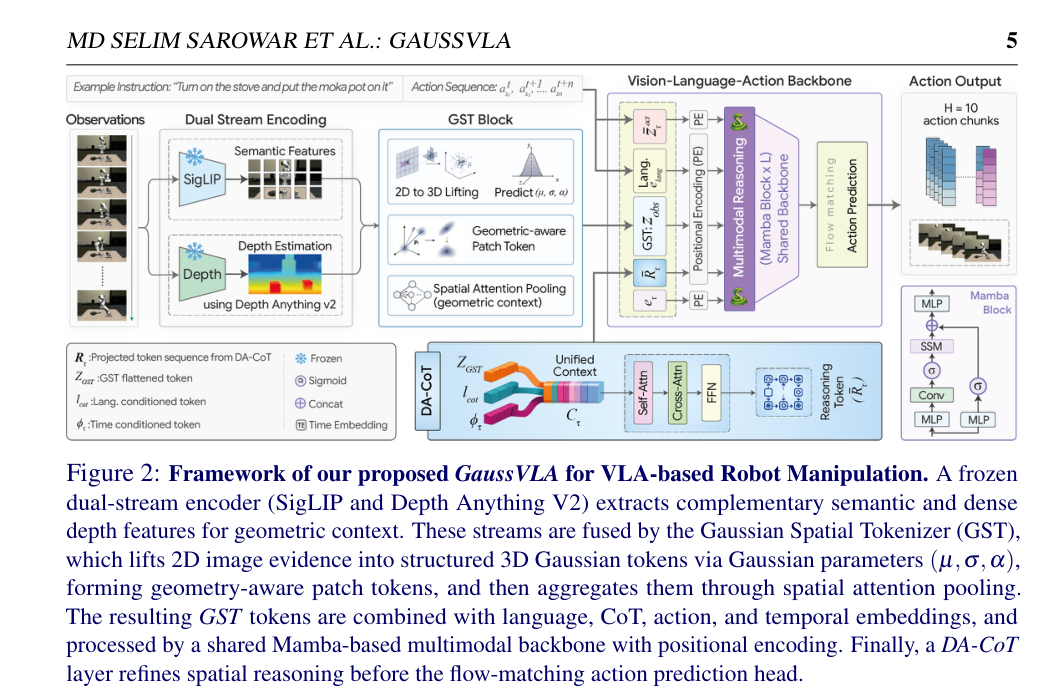
GaussVLA 提出 Gaussian Spatial Tokenizer (GST) 与 Depth-Aware Chain-of-Thought (DA-CoT),将 2D 视觉特征提升为结构化 3D 高斯 token 并进行深度感知推理,在仅 200M 参数下于 LIBERO 达到 93.5% 平均成功率。
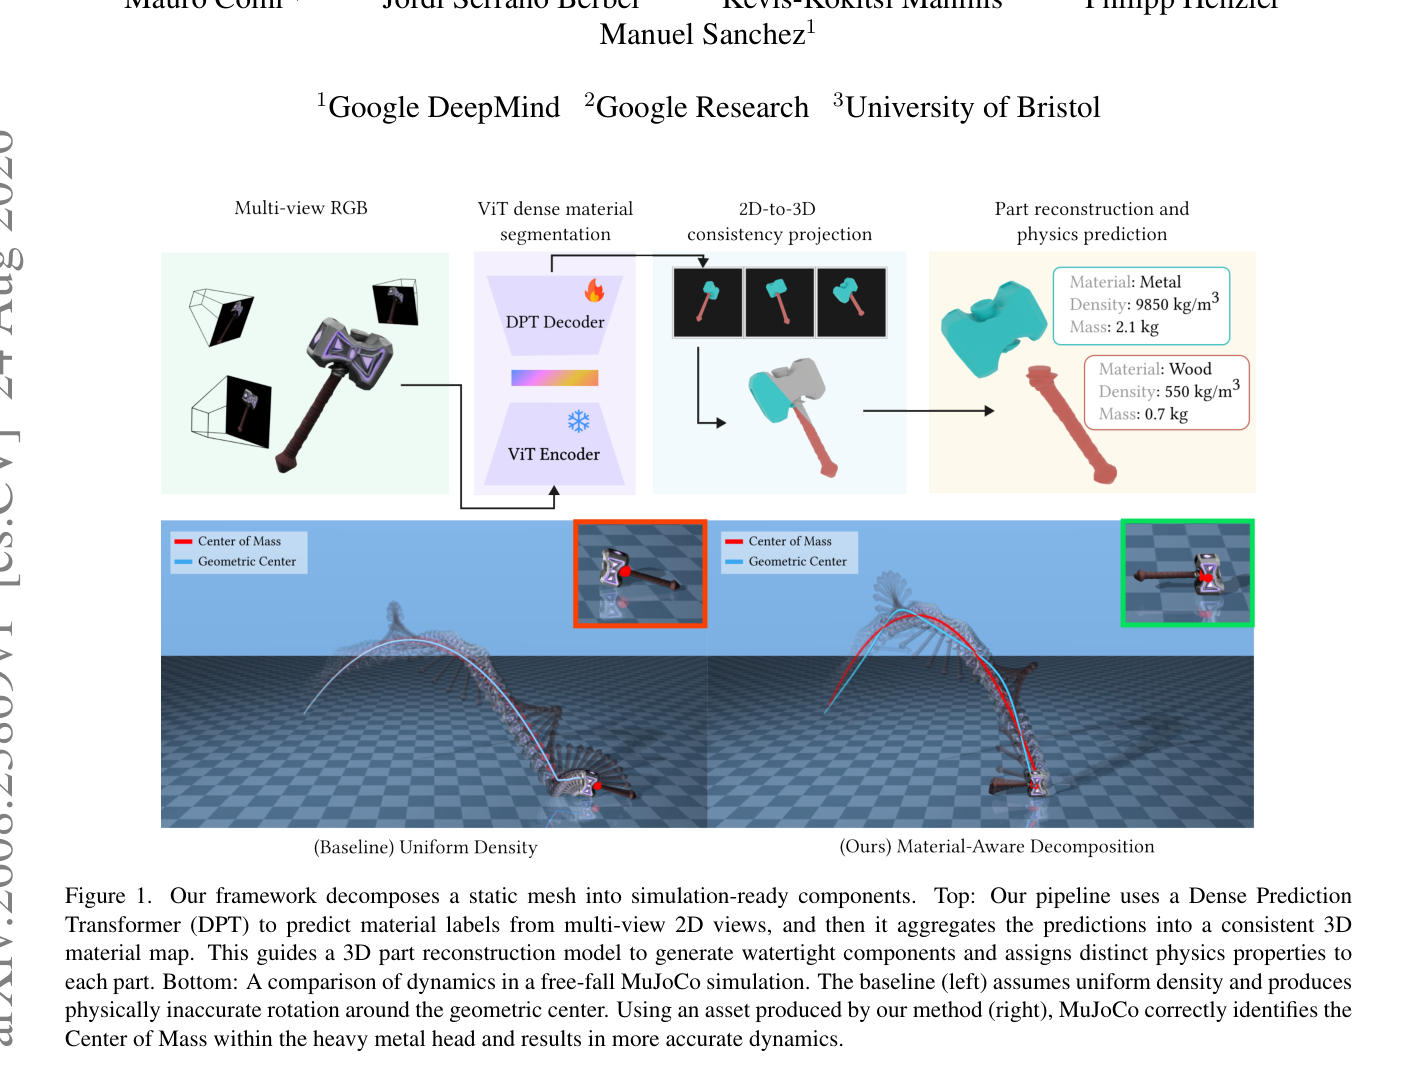
Gen2Physics提出一个统一框架,通过多视角材质分割、2D到3D一致性投影、VLM语义精炼与部件补全,将生成式3D网格自动分解为可直接用于刚体物理引擎的仿真就绪组件。