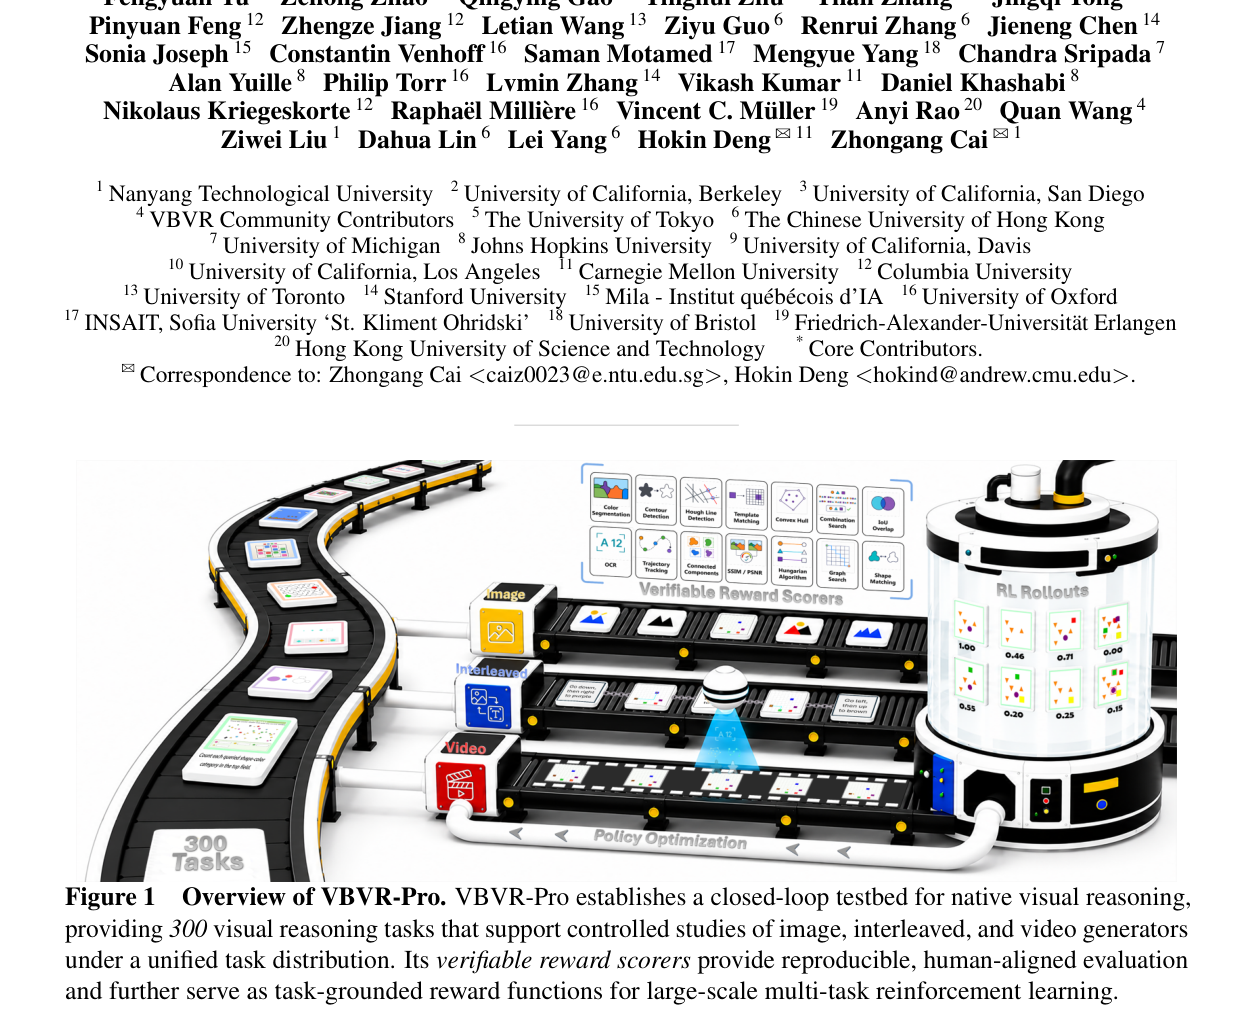
快速导读:VBVR-Pro 构建了一个包含300个程序化生成任务、可验证奖励评分器和多模态受控对比的闭环测试平台,使原生视觉推理可训练、可验证、可优化、可实验控制。
VBVR-Pro 针对原生视觉推理(Native Visual Reasoning)这一新兴方向,提出了一个闭环测试平台。所谓原生视觉推理,是指模型在推理过程中以视觉状态本身——图像或视频——作为第一类推理基底,而不是仅仅把图像当作输入、把文本当作推理媒介。这一方向的核心困难在于:训练任务稀缺、评估反馈不可靠、以及不同生成模态之间缺乏公平对比。
VBVR-Pro 的解决方案由三个组件构成:300个程序化生成任务、100个任务专用可验证奖励评分器、以及在统一任务分布下对9个开源模型的训练与强化学习实验。论文的核心论点是:只有把评估从不可复现的VLM-as-a-judge范式切换到确定性的可验证评分器,原生视觉推理才能从零散的演示变成可系统优化的研究领域。
英文题目:VBVR-Pro: A Scalable and Verifiable Suite for Native Visual Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2608.26105
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有视觉推理基准大多面向评估而非训练。它们提供测试集,但不提供可扩展的训练任务生成器,导致研究者无法在统一分布下大规模训练模型。VBVR-Pro 的前身 VBVR 提供了150个任务和可验证评估框架,但任务数量有限,且只支持视频模态。
评估方面,VLM-as-a-judge 范式存在三个系统性失败模式:感知不精确、细节遗漏、任务误解。论文在第7页的图4中展示了具体案例:三个强VLM评委对同一输出给出不同分数和不同理由。更严重的是,即使温度设为0,VLM评委在重复评估同一视频时仍有54.6%到92.8%的样本分数发生变化(第8页表2),这意味着VLM评委无法作为逐样本奖励信号用于强化学习。
模态对比方面,图像生成、视频生成、交错文本-图像生成三种范式各自发展,但从未在统一任务分布下进行受控比较。这导致研究者无法回答一个基本问题:对于原生视觉推理,哪种生成模态更有效?
这些缺口共同指向一个核心矛盾:原生视觉推理声称以视觉为推理基底,但整个领域缺乏可验证的反馈机制来检验模型是否真的在"看",而不是在"猜"。
核心创新
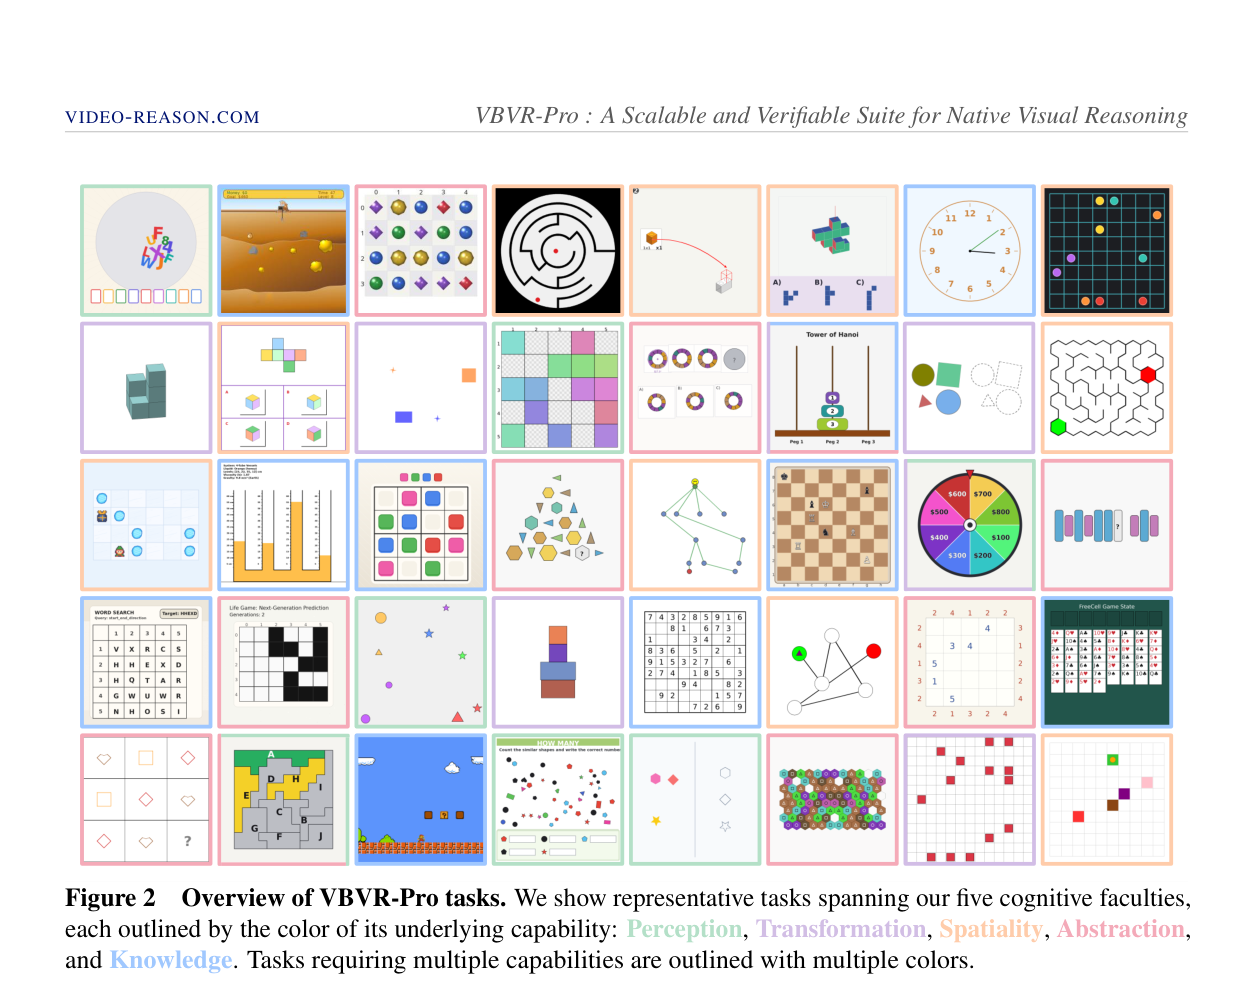
- 提出300个程序化生成任务的视觉推理任务空间,覆盖五大认知能力,支持图像/视频/交错模态的统一任务分布
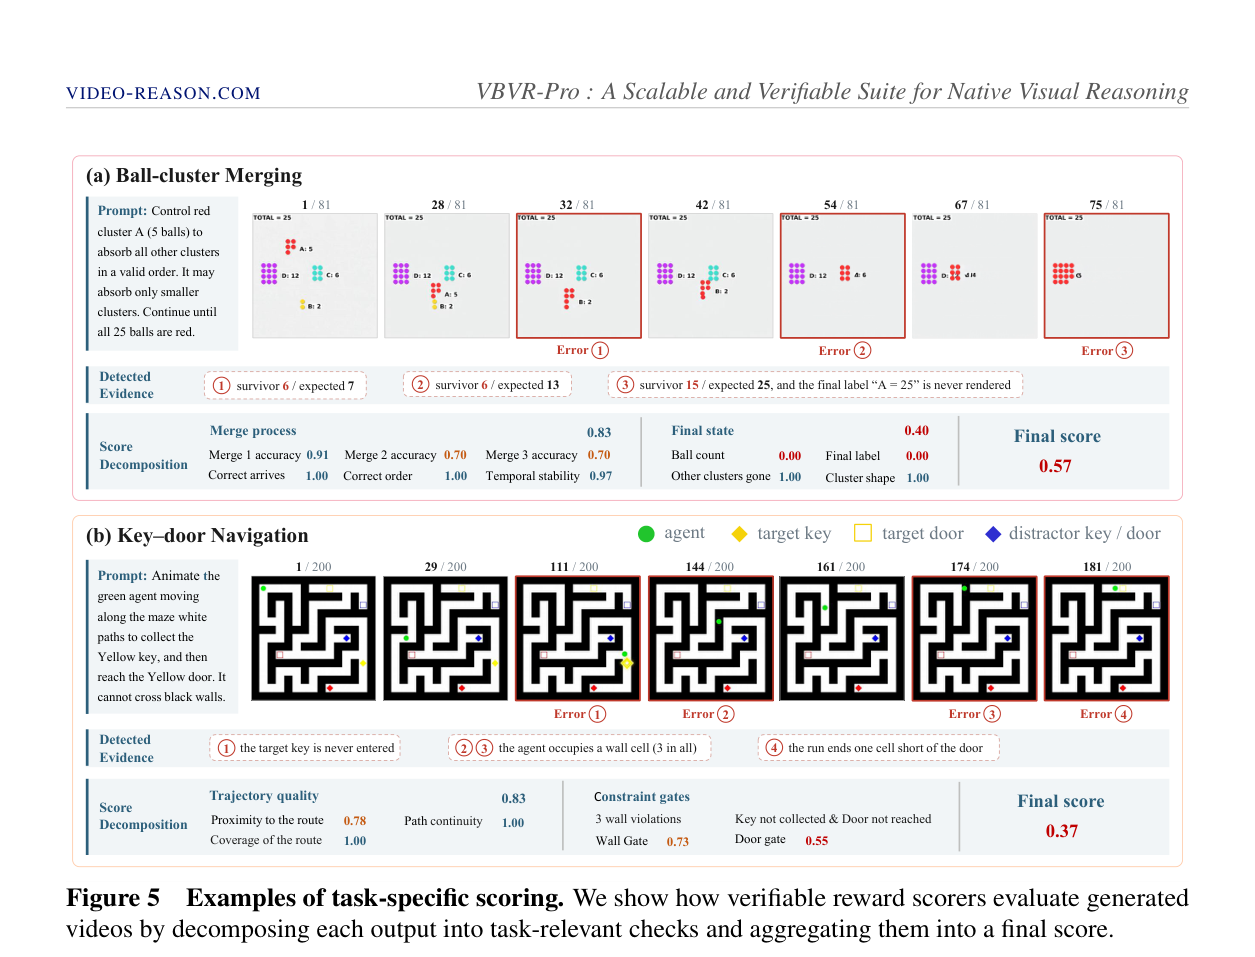
- 设计100个任务专用可验证奖励评分器,基于语义实体提取和任务规则验证,实现确定性、可复现、低成本且与人类判断高度对齐的评估
- 系统识别VLM-as-a-judge的三种失败模式:感知不精确、细节遗漏、任务误解
- 通过消融和反事实诊断证明视觉轨迹(而非文本思维链)是原生视觉推理的关键基底
- 将可验证评分器用作强化学习奖励信号,实现大规模多任务RLVR,展示稳定的域内和域外性能提升
- 构建图像模态的三种输出机制(Last-Frame、Key-Frame、Multi-Frame),在保留视频解信息的同时提供紧凑表示
方法概览
VBVR-Pro 包含三大组件:(1) 300个程序化任务生成器,覆盖感知、空间、变换、抽象、知识五大认知能力,同步渲染视频、图像(Last-Frame/Key-Frame/Multi-Frame三种输出模式)和交错文本-图像模态;(2) 基于经典计算机视觉方法(HSV分割、轮廓检测、OCR、轨迹跟踪)的100个任务专用可验证评分器,输出可解释的分解分数;(3) 在统一任务分布下训练9个开源模型(图像、视频、交错),并用可验证奖励进行大规模多任务强化学习(RLVR)。
- 任务空间设计:300个程序化任务生成器覆盖五大认知能力——感知、空间、变换、抽象、知识。每个任务可以同步渲染为视频、图像(Last-Frame、Key-Frame、Multi-Frame三种输出模式)和交错文本-图像三种模态,保证跨模态对比的公平性。
- 可验证奖励评分器:100个任务专用评分器基于经典计算机视觉方法(HSV分割、轮廓检测、OCR、轨迹跟踪)提取语义实体,再根据任务规则进行确定性验证,输出可解释的分解分数。
- 图像模态的三种输出机制:Last-Frame用于最终答案即可评估的简单任务;Key-Frame用于迷宫导航等多步规划任务,只保留关键中间帧;Multi-Frame用于需要时序连续性的任务。这一设计在保留视频解信息的同时提供紧凑表示。
- RLVR训练:将可验证评分器直接作为强化学习的奖励信号,在统一任务分布下对9个开源模型进行大规模多任务强化学习。与使用VLM评委作为奖励的RLVLM形成对照。
- 反事实诊断:通过移除输入图像、移除中间视觉状态、将中间文本替换为占位符等干预手段,检验模型是否真正依赖视觉轨迹进行推理。
- Chain-of-Step可视化:采用Wang et al.的方法解码不同去噪步骤的潜在表示,观察模型在推理过程中的行为模式,包括多路径探索和基于叠加的探索。
逐图理解论文
评估不可靠的代价
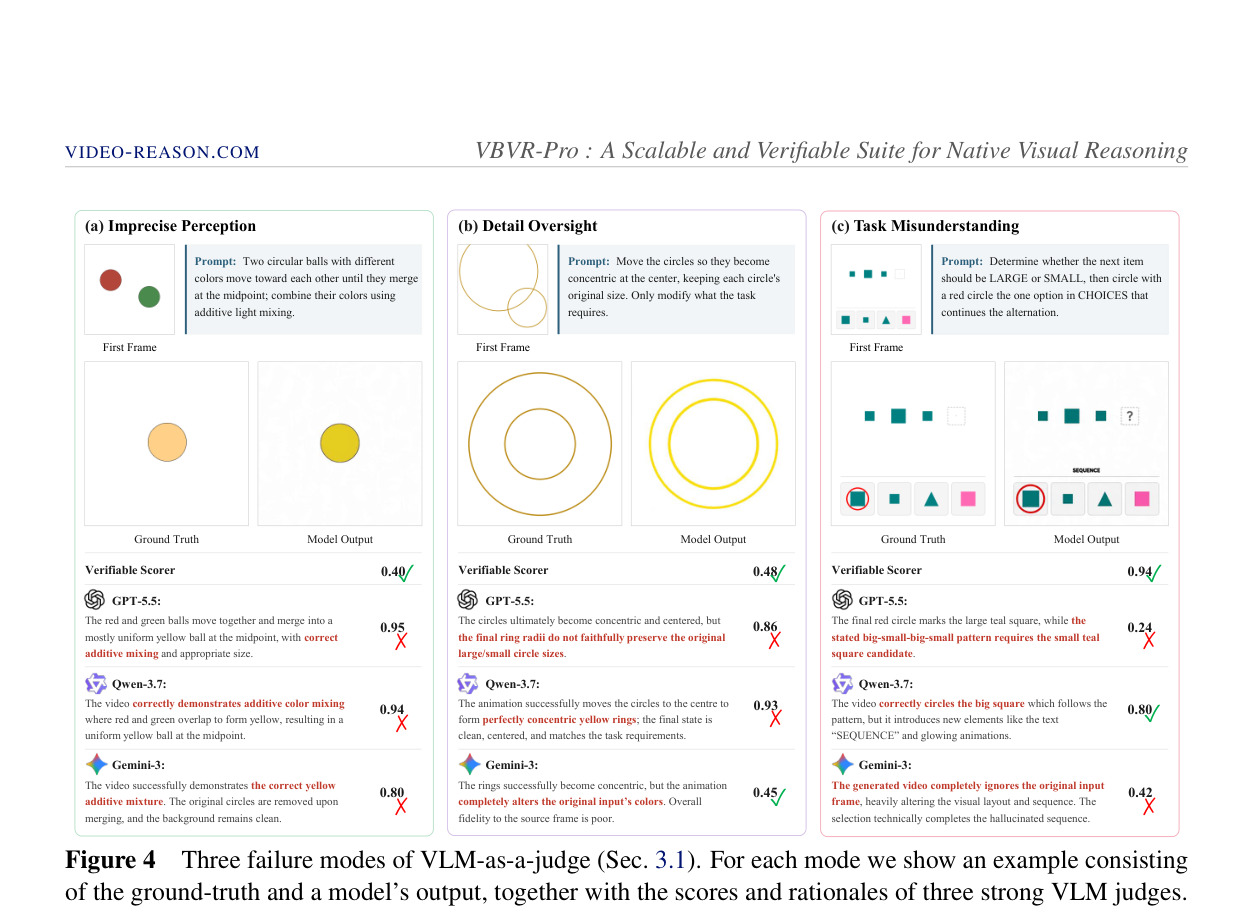
图4展示了VLM-as-a-judge的三种失败模式:感知不精确、细节遗漏、任务误解。每个案例中三个强VLM评委给出不同分数和理由,说明VLM评委的不可靠性不是个别现象,而是系统性缺陷。
研究缺口
这里暴露的是一个更深层的缺口。原生视觉推理声称以视觉状态作为推理基底,但领域里既没有可扩展的训练任务,也没有确定性的反馈机制,更没有在统一任务分布下对图像、视频、交错三种生成模态做过受控对比。结果就是:大家都在展示漂亮的个例,却没人能系统回答——哪种模态更适合视觉推理?模型是真的在看,还是在猜?
可验证评分器与RLVR
VBVR-Pro的贡献就是把这条断掉的闭环重新接上。它做了三件事。第一,用300个程序化任务生成器覆盖感知、空间、变换、抽象、知识五大能力,同一任务可以同步渲染成视频、图像和交错模态,保证对比公平。第二,设计了100个任务专用的可验证评分器,基于经典计算机视觉方法提取语义实体,再按任务规则做确定性验证。这个评分器与人类偏好的逐票一致性超过了GPT-5.5和Gemini-3.1-Pro,而且成本低几个数量级。第三,也是最关键的一步,把这个评分器直接当作强化学习的奖励信号,做大规模多任务RLVR。
视觉轨迹才是关键
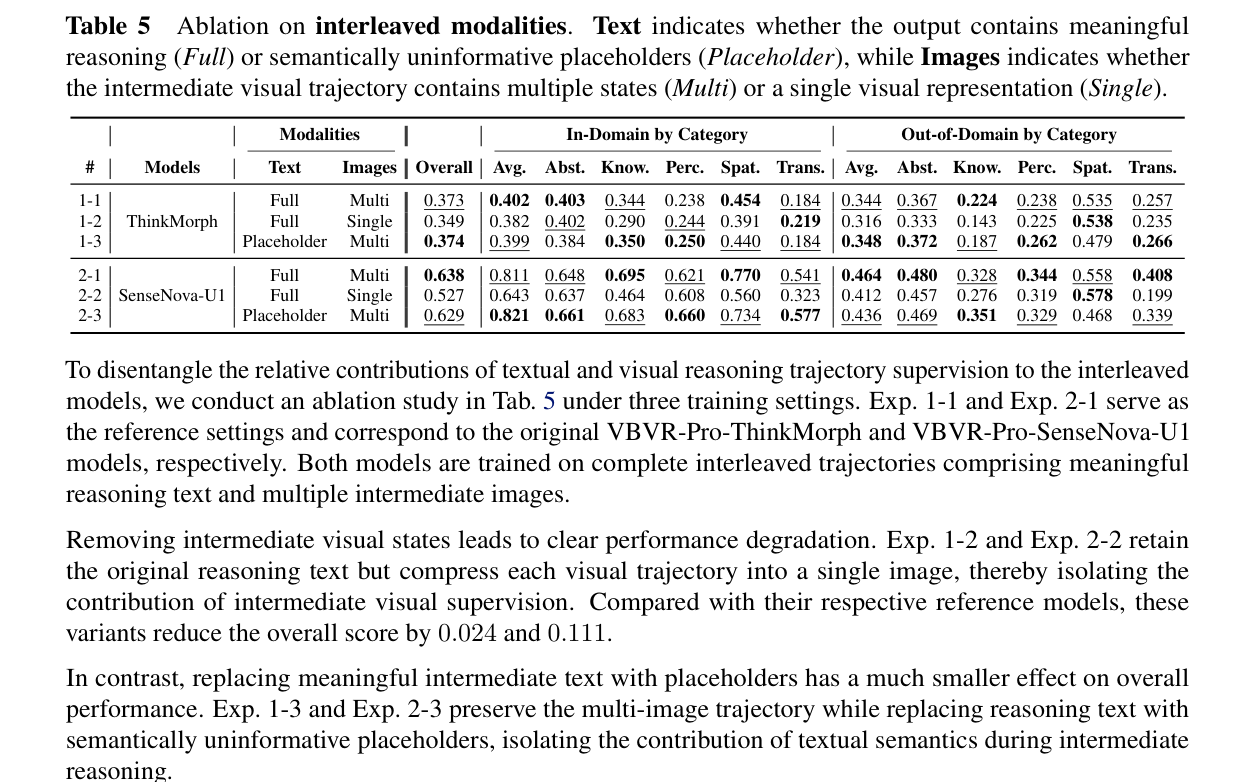
论文最有说服力的证据来自反事实诊断。他们训练了一个交错模型,然后做干预实验:把中间文本替换成语义无关的占位符,性能几乎不变;但移除中间视觉状态,性能显著下降。再进一步,移除输入图像,性能直接跌到接近零。这说明什么?说明模型真正依赖的是视觉轨迹,而不是文本思维链。原生视觉推理的"原生"二字,在这里得到了实验层面的证实。
结论与局限
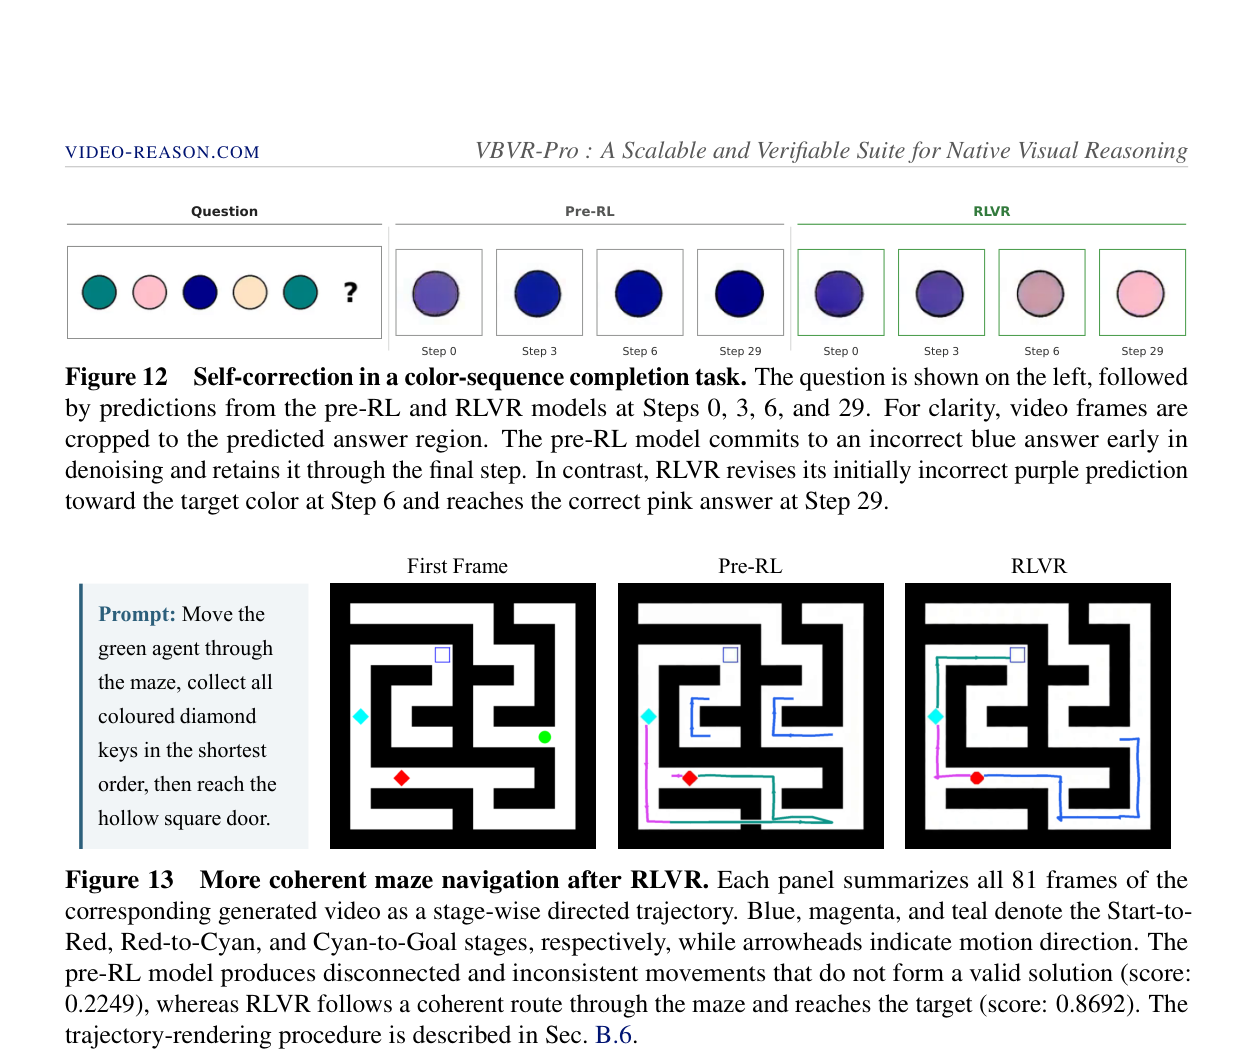
图13用轨迹渲染对比了RLVR前后迷宫导航任务的表现。RLVR前模型生成不连贯运动(得分0.2249),RLVR后模型沿有效路径到达目标(得分0.8692)。这是RLVR带来质变的最直观证据。
实验如何设计?
- 在VBVR-Pro-Bench上对30多个专有和开源模型进行基准测试,报告整体、域内(ID)和域外(OOD)分数(表4,第11页)。
- VLM-as-a-judge失败模式分析:系统收集三个强VLM评委的评分和理由,归纳出感知不精确、细节遗漏、任务误解三类失败(图4,第7页)。
- 评分器可复现性对比:在相同视频上重复运行可验证评分器和VLM评委,统计分数变化比例(表2,第8页)。
- 人类对齐研究:采用竞技场式设计,比较可验证评分器与GPT-5.5、Gemini-3.1-Pro等VLM评委与人类偏好的逐票一致性(图6,第9页)。
- 交错模态消融:控制中间文本是否有意义、中间视觉状态是单一还是多重,分离文本语义与视觉轨迹的贡献(表5,第12页)。
- 迁移性评估:在V-ReasonBench、VideoThinkBench、MME-CoF-Pro等七个外部基准上测试训练后模型的泛化能力(表7,第15页)。
关键结果与论文证据
- 可验证评分器与人类偏好的逐票一致性超过0.60,优于GPT-5.5(0.54)和Gemini-3.1-Pro(0.52),达到人类一致性上限(0.77)的约78%(第9页图6)。
- VLM评委在温度0下重复评估仍有54.6%-92.8%的样本分数变化,而可验证评分器为0.0%(第8页表2)。
- 移除中间视觉状态导致ThinkMorph整体分下降0.024,SenseNova-U1下降0.111;替换文本为占位符影响较小(第12页表5)。这表明视觉轨迹而非文本思维链是原生视觉推理的关键基底。
- 反事实诊断中,移除输入图像使性能降至0.064,移除中间图像降至0.099,移除中间文本降至0.533(第13页表6)。输入图像和中间视觉状态对推理至关重要。
- RLVR在整体、ID和OOD指标上呈现持续上升趋势,而RLVLM增益较小且不稳定,在Step 400-500出现暂时性下降(第18页图11)。
- RLVR后迷宫导航任务得分从0.2249提升至0.8692(第19页图13),模型从生成不连贯运动变为沿有效路径到达目标。
- 训练后模型在外部基准上取得显著迁移:VBVR-Pro-Wan2.2-I2V-A14B在V-ReasonBench上从10.21提升至38.22,在VideoThinkBench-mini上从25.71提升至52.86(第15页表7)。
- 最近邻分析显示,模型在外部基准上的预测与训练集最近邻在视觉和语义上均不相似,排除了直接记忆化的解释(第15页图9)。
阅读时需要注意
- 即使最强的训练模型仍远低于人类水平性能,原生视觉推理的绝对能力上限仍然很低。
- 单图像生成在变换任务上表现显著弱于视频和交错模态,图像模态的时序推理能力存在结构性短板。
- 可验证评分器依赖经典CV方法进行语义提取,对复杂真实场景的泛化能力有限,目前仅覆盖100个基准任务。
- VBVR-Pro-Bench的OOD任务与训练任务共享底层生成框架,域外泛化到真实世界仍需谨慎解读。
- RLVR训练中CPS高随机性(η=0.9)会导致背景视觉保真度暂时下降,需要在多样性与保真度之间权衡。
关联工作
- VBVR是VBVR-Pro的前身,提供150个任务和可验证评估框架,但仅支持视频模态。VBVR-Pro在此基础上扩展至300个任务,并增加图像和交错模态支持。
- Chain-of-Step(Wang et al.)提供了视频扩散模型推理行为可视化工具,VBVR-Pro采用该方法分析原生视觉推理行为,发现模型在早期去噪步骤中探索多个候选解路径后收敛。
- ThinkMorph和SenseNova-U1是交错文本-图像生成模型,作为VBVR-Pro训练的基础模型。训练后SenseNova-U1取得最强交错模态性能,整体分0.638,与最强视频模型在ID任务上表现相当。
- 外部基准V-ReasonBench、VideoThinkBench、RULER-Bench、MME-CoF-Pro、BabyVision-Gen、IntelligentVBench用于验证VBVR-Pro训练的迁移性,覆盖视频推理、具身推理、图像推理等不同场景。