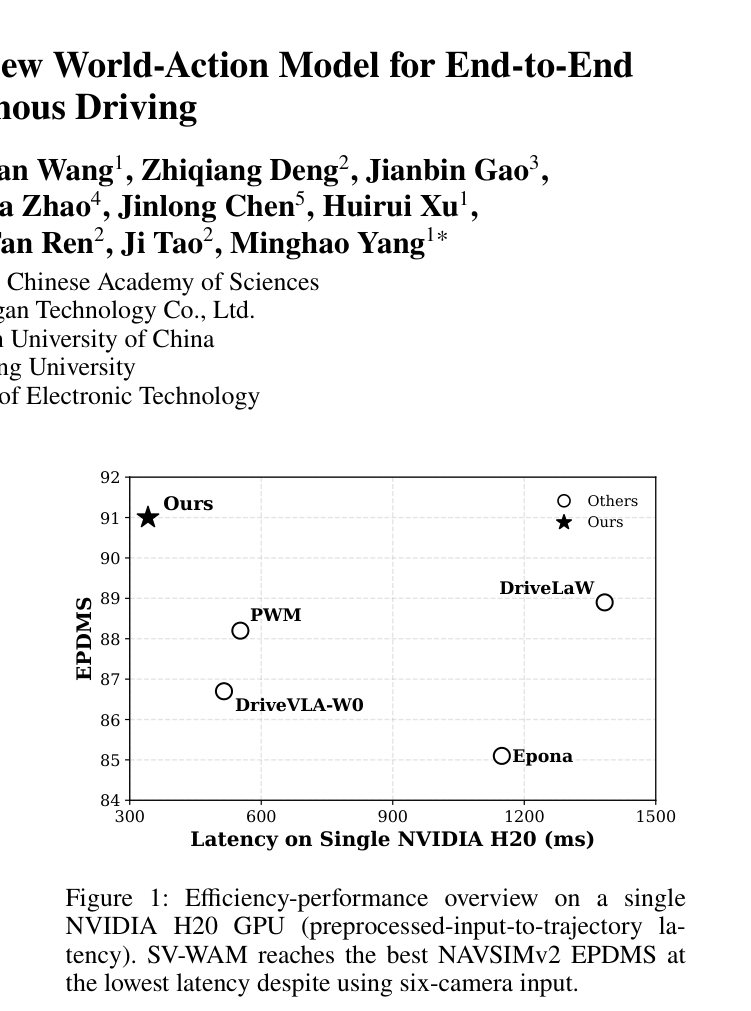
快速导读:SV-WAM 提出了一种基于 action-centered causal mask 的环视世界-动作模型,通过训练时联合去噪未来视频与动作、推理时仅保留动作分支,实现了在保持六路相机全景感知优势的同时,显著降低推理延迟并提升 NAVSIMv2 规划性能。
SV-WAM 针对现有基于世界模型的端到端自动驾驶规划器在推理效率与空间感知覆盖之间的权衡问题,提出了一种高效的环视世界-动作模型。该模型通过引入 action-centered causal mask,在训练阶段联合去噪未来动作与六路未来视频 latent,而在推理阶段仅保留动作分支,从而在保持六路相机全景感知优势的同时,显著降低了推理延迟。
本文的核心贡献在于证明了未来视频监督可以作为训练时的辅助信号,而不必在推理时承担计算开销。SV-WAM 在 NAVSIMv2 navtest 上取得了 SOTA 的 EPDMS 分数,并在单 NVIDIA H20 GPU 上实现了低于单前视基线的在线延迟,展示了其在安全关键场景下的实用价值。
英文题目:SV-WAM: An Efficient Surround-View World-Action Model for End-to-End Autonomous Driving
论文出处:arXiv 每日论文精选 · arXiv:2609.03602
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有基于世界模型(WM)的端到端自动驾驶规划器,如 Epona、PWM 和 DriveVLA-W0,通常仅使用单路前视相机输入以降低推理成本。然而,在变道、合流、转弯等安全关键场景中,缺乏侧后方空间上下文会导致规划器做出不安全决策。例如,在无信号交叉口,前视-only 规划器可能因缺乏横向上下文而误判周围车辆意图。
直接扩展至六路环视未来视频生成虽然能提供更丰富的空间上下文,但会大幅增加视觉 token 数量和推理延迟,使其难以满足实时性要求。近期工作如 Fast-WAM 和 GigaWorld-Policy 虽探索了高效 WAM,但仍未完全解决环视输入下的延迟问题。SV-WAM 旨在打破这一权衡,实现全景感知与低延迟推理的统一。
此外,现有方法在道路合规性方面存在不足,车辆足迹可能接近或越过可行驶边界。SV-WAM 通过引入可微分 drivable-area compliance regularizer,利用 LQR 轨迹展开和符号距离场计算边界违规惩罚,进一步提升了规划的安全性。
核心创新
- 提出 action-centered causal mask,允许训练时联合去噪未来动作和视频,但阻止动作 token 关注视频 token,使推理时可安全移除视频分支而不损失动作性能。
- 引入可微分 drivable-area compliance regularizer,通过 LQR 轨迹展开和符号距离场计算车辆足迹边界违规惩罚,提升道路合规性且无额外推理成本。
- 实现高效环视规划,在保持六路相机全景输入的同时,通过移除视频分支和 KV 缓存复用,将推理延迟降至 341.6 ms,低于单前视基线。
方法概览
SV-WAM 包含四个组件:1. 输入 Tokenization:将六路历史环视图像、自车状态和动作序列转换为 Transformer 兼容 token,使用 Wan2.2-TI2V-5B 的冻结 3D 因果 VAE 编码器提取视频 latent;2. 环视世界-动作模型:在共享扩散 Transformer 骨干中联合去噪未来动作和六路未来视频 latent,引入 action-centered causal mask 阻止动作 token 关注未来视频 token,实现动作预测与视频生成的解耦;3. 可行驶区域合规正则化器:通过可微分 LQR 轨迹展开和符号距离场,惩罚车辆足迹接近或越过可行驶边界的行为;4. 高效动作专用推理:推理时移除未来视频分支,缓存条件前缀 KV 状态,仅对动作 token 进行两步去噪,实现低延迟规划。
- 输入 Tokenization:将六路历史环视图像、自车状态和动作序列转换为 Transformer 兼容 token,使用 Wan2.2-TI2V-5B 的冻结 3D 因果 VAE 编码器提取视频 latent,确保输入表示的高效性与一致性。
- 环视世界-动作模型:在共享扩散 Transformer 骨干中联合去噪未来动作和六路未来视频 latent。引入 action-centered causal mask,阻止动作 token 关注未来视频 token,实现动作预测与视频生成的解耦,使推理时可安全移除视频分支。
- 可行驶区域合规正则化器:通过可微分 LQR 轨迹展开和符号距离场,惩罚车辆足迹接近或越过可行驶边界的行为。该正则化器在训练时生效,无额外推理成本,显著提升了道路合规性。
- 高效动作专用推理:推理时移除未来视频分支,缓存条件前缀 KV 状态,仅对动作 token 进行两步去噪。通过 KV 缓存复用和分支移除,将推理延迟降至 341.6 ms,低于单前视基线。
- 训练策略:采用联合去噪策略,未来视频作为辅助监督信号,帮助模型学习更丰富的场景动态。最终通过微调(FT)进一步优化动作预测性能,确保在移除视频分支后动作性能不下降。
逐图理解论文
失败案例
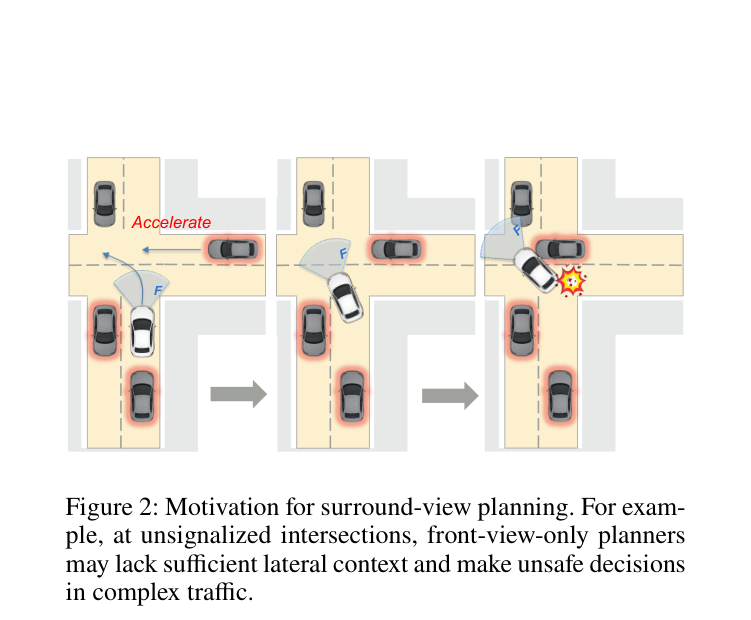
在无信号交叉口,单前视规划器因缺乏侧后方上下文,常误判周围车辆意图,导致不安全决策。
核心贡献
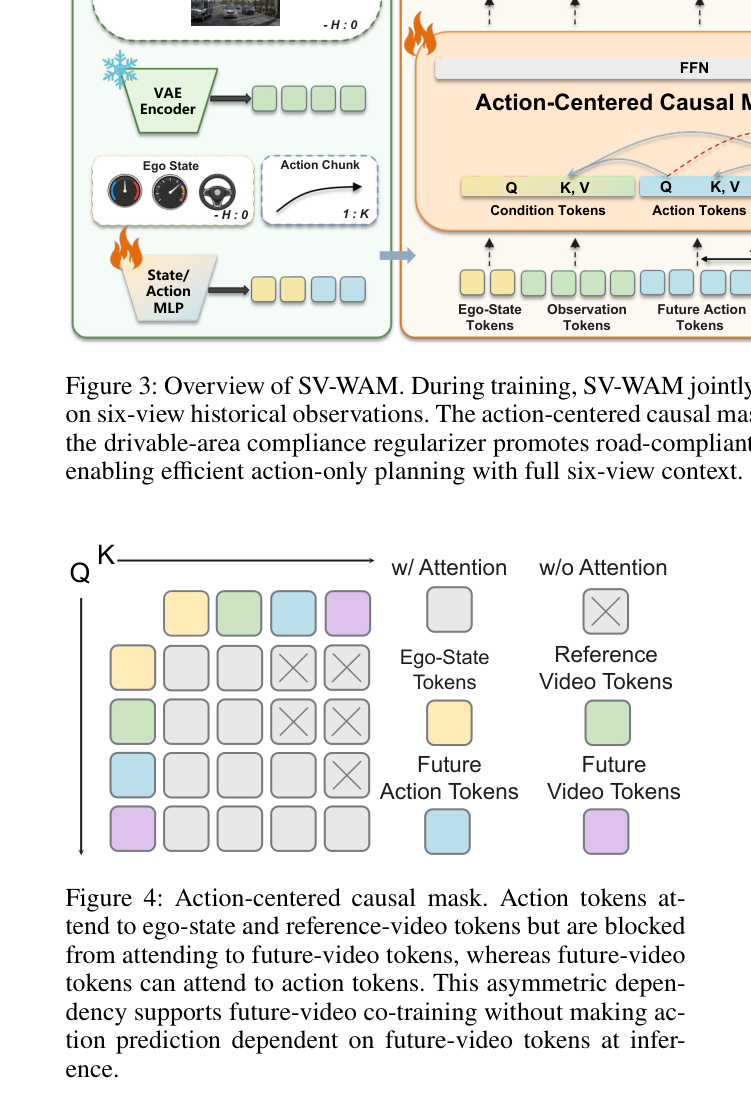
该图详细展示了 action-centered causal mask 的机制。动作 token 关注自车状态和参考视频 token,但被阻止关注未来视频 token;而未来视频 token 可以关注动作 token。这种不对称依赖关系支持了未来视频的联合训练,同时确保动作预测在推理时不依赖于未来视频 token,是 SV-WAM 高效推理的关键。
实验验证
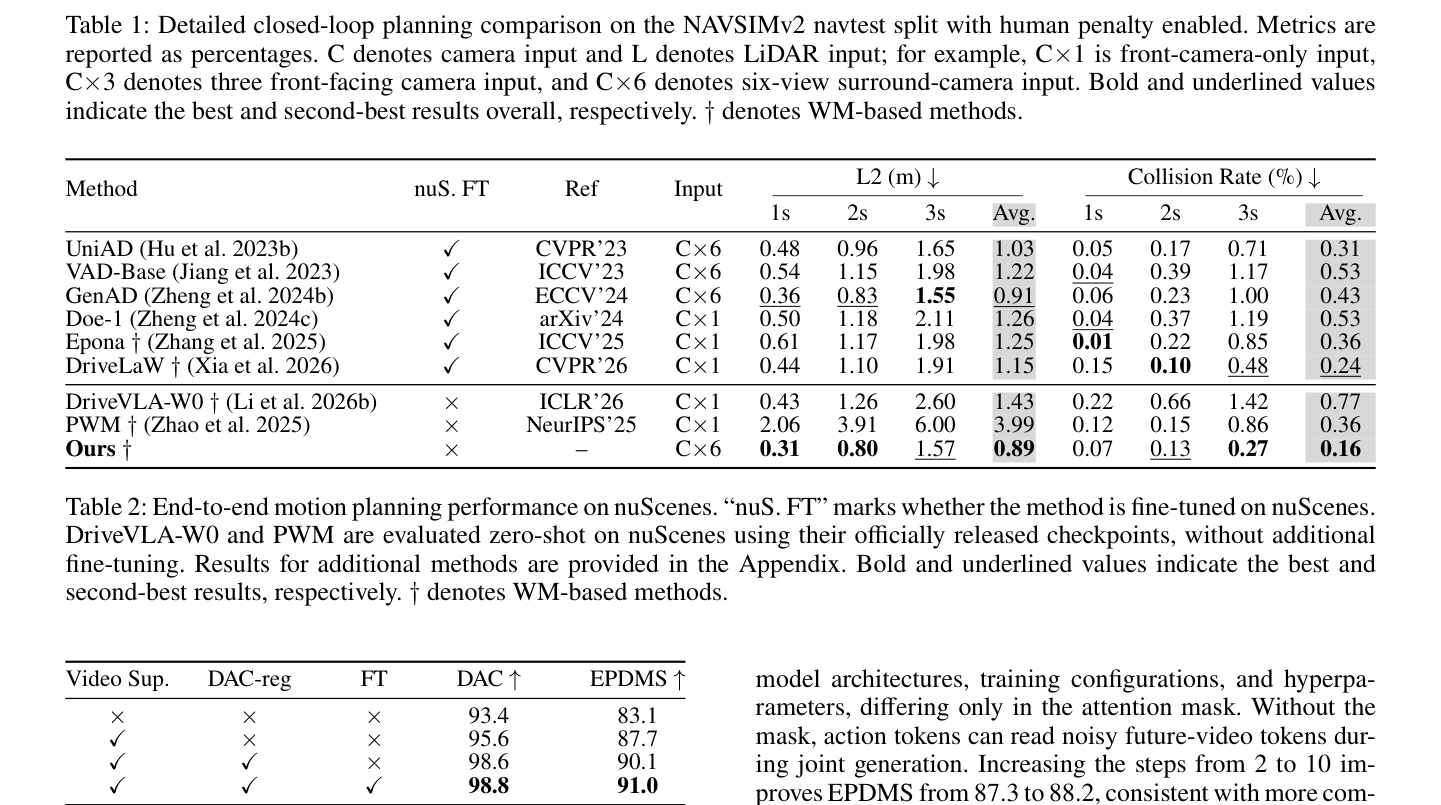
该表提供了 NAVSIMv2 navtest 上的详细闭环规划比较。SV-WAM 在 EPDMS 及各子指标上均取得最优或次优结果,显著优于单前视基线。该表验证了 SV-WAM 在安全关键场景下的规划性能,是其核心贡献的重要证据。
结论与局限
该图展示了 SV-WAM 的代表性失败案例。在模糊左转几何结构中,SV-WAM 与其他方法一样选择错误路径;在暴雨遮挡前视视野时,SV-WAM 失败;在绿灯后加速过于保守,导致被追尾。这些案例揭示了 SV-WAM 的局限性,提示其在复杂几何、极端天气和动态响应策略方面仍有提升空间。
实验如何设计?
- 在 NAVSIMv2 navtest 上进行闭环规划评估,比较 EPDMS 及各子指标(NC, DAC, DDC, TLC, EP)。
- 在 nuScenes 上进行零样本迁移评估,比较 L2 误差和碰撞率,验证模型的泛化能力。
- 在 NAVSIMv1 和 NAVSIMv2 navhard 上进行补充评估,确保模型在不同难度场景下的鲁棒性。
- 在单 NVIDIA H20 GPU 上测量从预处理输入到轨迹输出的在线延迟,排除可选的视频渲染和未来视频 VAE 解码成本。
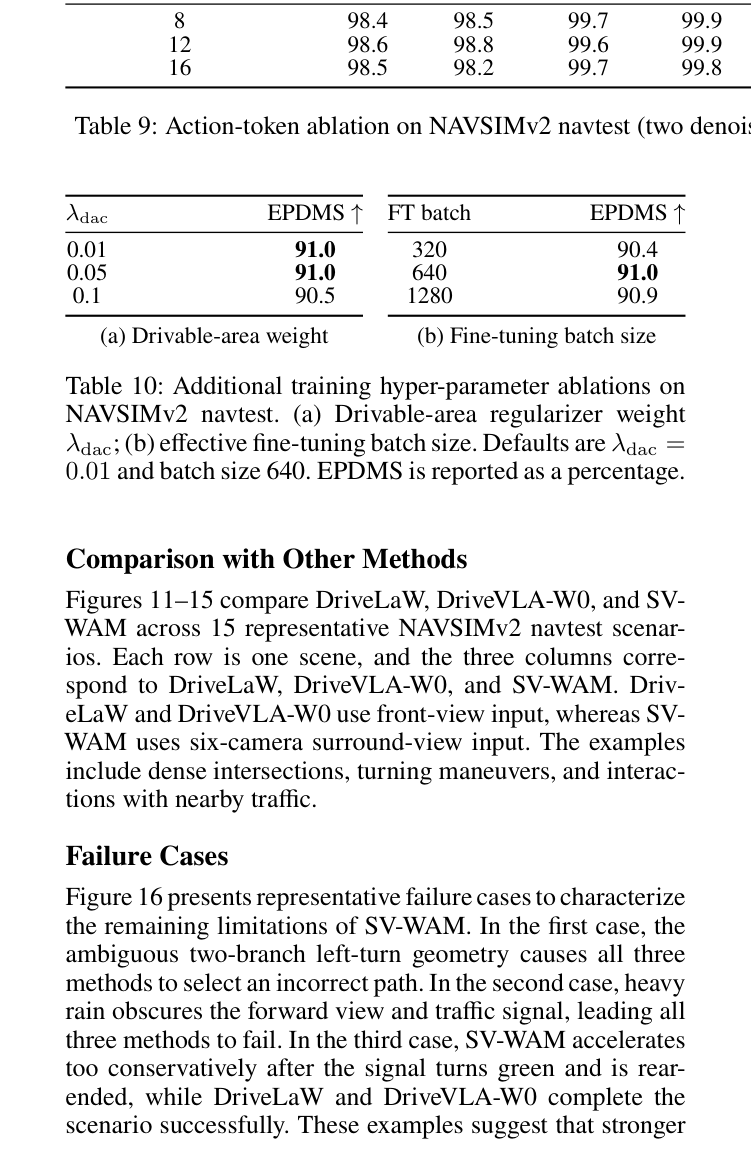
- 消融实验:验证未来视频监督、DAC 正则化器、因果掩码、推理步数、相机覆盖范围、动作 token 数量及超参数的影响,明确各组件的贡献。
关键结果与论文证据
- NAVSIMv2 navtest EPDMS: 91.0 (SOTA),显著优于单前视基线(如 Epona, PWM),证明环视输入与高效推理策略的有效性(Page 6)。
- NAVSIMv2 navtest Latency: 341.6 ± 2.1 ms (lowest among WM-based),低于单前视基线,验证了动作专用推理的高效性(Page 7)。
- nuScenes Zero-shot Avg L2 Error: 0.89 m, Avg Collision Rate: 0.16%,表明模型在跨数据集迁移中具有良好的泛化能力(Page 6)。
- Ablation: Video Sup. + DAC-reg + FT improves EPDMS from 83.1 to 91.0,证明未来视频监督与 DAC 正则化器的协同作用(Page 6)。
- Ablation: Causal mask with 2 steps achieves 91.0 EPDMS vs 87.3 without mask,验证 action-centered causal mask 对动作性能的关键作用(Page 7)。
- NAVSIMv1 PDMS: 90.2, NAVSIMv2 navhard EPDMS: 36.1 (tied with EponaV2),显示模型在不同基准上的稳定表现(Page 13)。
阅读时需要注意
- 在模糊的左转几何结构中,SV-WAM 与其他方法一样可能选择错误路径,表明模型在复杂几何场景下的鲁棒性仍有提升空间。
- 在暴雨遮挡前视视野和交通信号时,SV-WAM 会失败,暴露出其在极端天气条件下的感知局限性。
- 在绿灯后加速过于保守,可能导致被追尾,而基线方法能成功完成场景,提示模型在动态响应策略上需进一步优化。
- nuScenes 零样本结果受 ego-status 捷径影响,仅作为跨数据集健全性检查,而非主要结果,需谨慎解读其泛化能力。
关联工作
- Epona, PWM, DriveVLA-W0, DriveLaW: 单前视 WM-based 基线,SV-WAM 在 EPDMS 和延迟上均优于这些方法,证明环视输入的优势。
- Fast-WAM, GigaWorld-Policy: 高效 WAM 相关工作,SV-WAM 通过 action-centered causal mask 进一步解耦动作与视频,实现更高效的推理。
- World4Drive, WorldRFT: Latent WM 方法,SV-WAM 在环视输入下实现了更低的延迟和更高的 EPDMS,展示了其在全景感知场景下的独特价值。
- UniAD, VAD, DiffusionDrive: BEV-based 和 Diffusion-based 基线,SV-WAM 在 nuScenes 零样本评估中表现优于这些方法,验证了其泛化能力。