快速导读:本文构建了包含约100万张智能手机照片的 LAION-Mobile 数据集,审计了12个 SOTA Deepfake 检测器,发现它们在现代 AI 生成内容上性能大幅下降,且在真实手机照片上产生高达 91% 的误报率,证实了计算摄影对检测器构成的挑战。
本文构建了 LAION-Mobile 数据集,包含约 100 万张经过严格清洗的智能手机照片,旨在填补大规模真实手机照片在 Deepfake 检测评估中的空白。现有检测器在基准测试中报告接近完美的 AUC,但忽略了现代智能手机计算摄影的影响。
通过审计 12 个 SOTA Deepfake 检测器,本文发现它们在现代 AI 生成内容上性能大幅下降,且在真实手机照片上产生高达 91% 的误报率。这一结果证实了计算摄影对检测器构成的挑战,并揭示了校准漂移现象。
英文题目:LAION-Mobile: Evaluating Deepfake Detectors On One Million Smartphone Photos
论文出处:arXiv 每日论文精选 · arXiv:2609.11134
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现代智能手机的神经 ISP 管线使得设备从记录图像转向生成图像,模糊了真实与合成的界限。现有评估主要依赖旧互联网数据或小规模实验室数据,缺乏对大规模真实手机照片的测试。
ICML 2026 立场论文指出,计算摄影对 Deepfake 检测的挑战被严重低估。由于缺乏大规模现代智能手机图像数据集,无法验证检测器是否会将普通手机照片误判为伪造内容。
现有检测器在基准测试中表现优异,但这些基准通常不包含现代智能手机照片。因此,检测器在真实世界中的表现存在巨大不确定性。
核心创新
- 构建了 LAION-Mobile 数据集,包含约 100 万张带 EXIF 元数据的智能手机照片,填补了大规模真实手机照片评估集的空白。
- 揭示了“校准漂移”(Calibration Drift)现象:在旧 GAN 数据上校准的阈值在现代 AI 内容上失效,导致检测器在真实手机照片上产生高误报。
- 证明了当前 SOTA 检测器在现代智能手机照片上不可部署,没有检测器能同时在现代 AI 内容上超过随机猜测并在真实照片上保持低误报率。
方法概览
从 re-LAION-5B 中通过高分辨率过滤、EXIF 存在性检查和智能手机制造商匹配,蒸馏出 935,399 张清洗后的真实手机照片(LAION-Mobile)。使用 12 个检测器的原始论文检查点,在三个域进行评估:ForenSynths(域内验证)、NTIRE 2026(现代 AI 混合)和 LAION-Mobile(真实手机照片)。报告 AUC 和在不同校准阈值下的 FPR。
- 从 re-LAION-5B 中通过高分辨率过滤、EXIF 存在性检查和智能手机制造商匹配,蒸馏出 935,399 张清洗后的真实手机照片。
- 使用 12 个检测器的原始论文检查点,在三个域进行评估:ForenSynths(域内验证)、NTIRE 2026(现代 AI 混合)和 LAION-Mobile(真实手机照片)。
- 报告 AUC 和在不同校准阈值下的 FPR,以评估检测器在不同域上的泛化能力。
- 分析设备年代(ISP 时代)对误报率的影响,发现现代 ISP 设备在数据集中占比极低。
逐图理解论文
直觉与失败案例
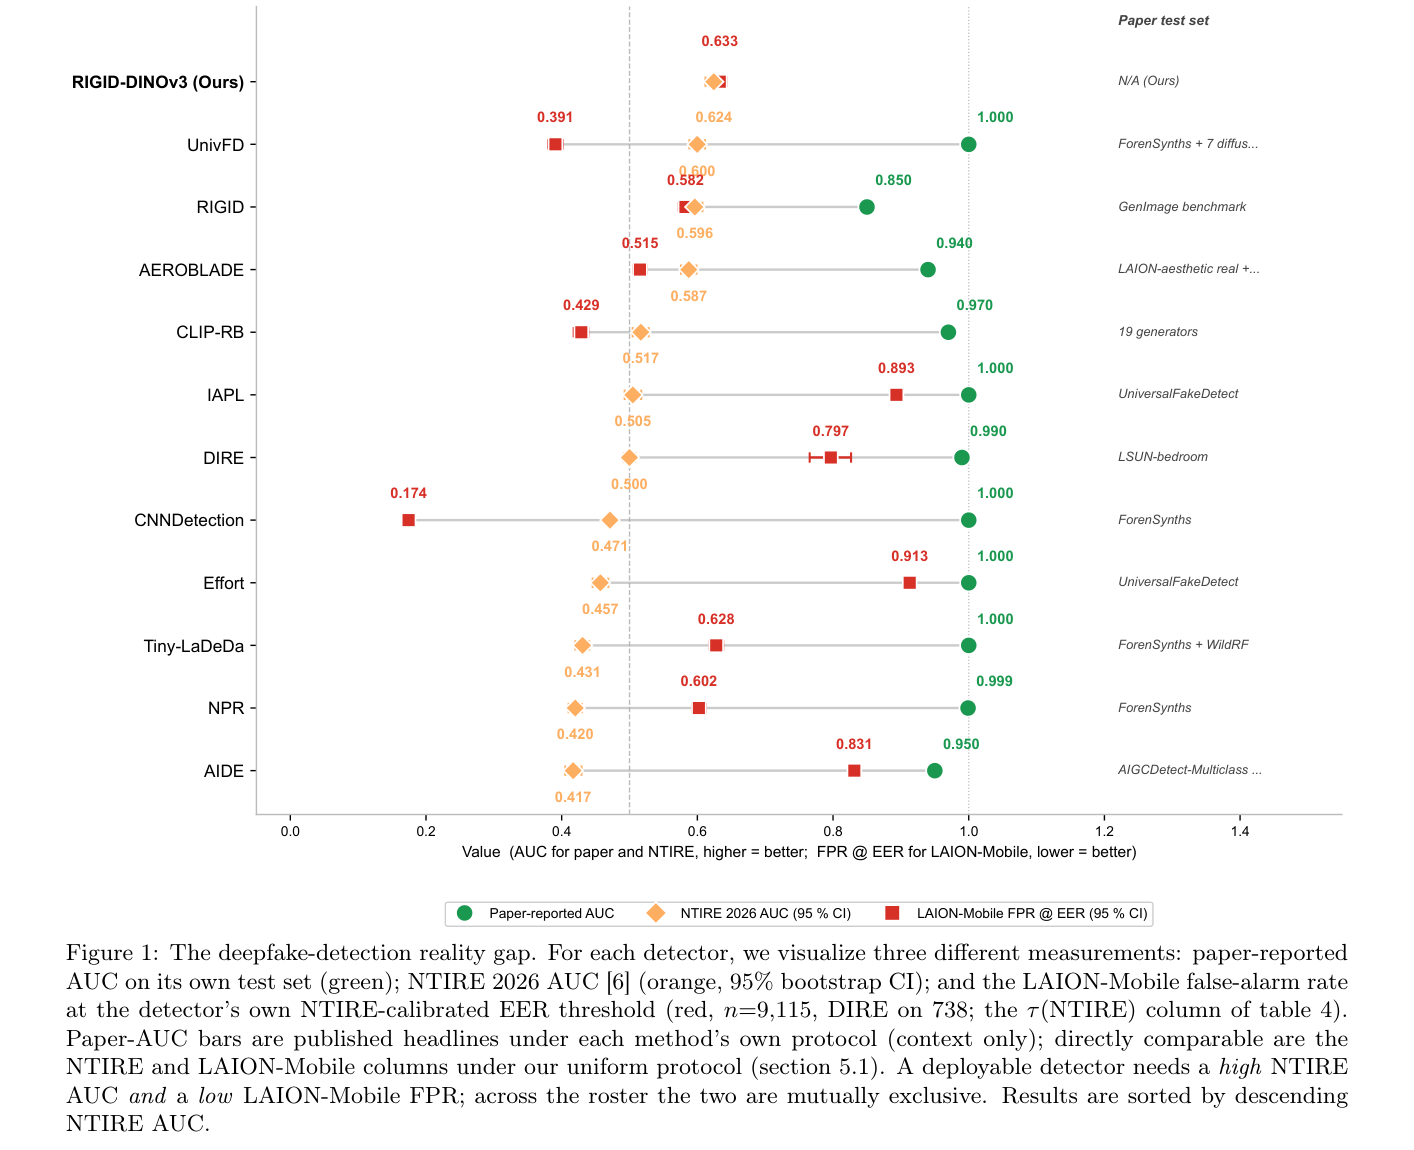
该图展示了 Deepfake 检测的现实差距。每个检测器在三个不同测量上的表现:论文报告的 AUC、NTIRE 2026 AUC 和 LAION-Mobile 误报率。可部署的检测器需要高 NTIRE AUC 和低 LAION-Mobile FPR,但在整个名单中,这两者是互斥的。
核心区分与研究空白
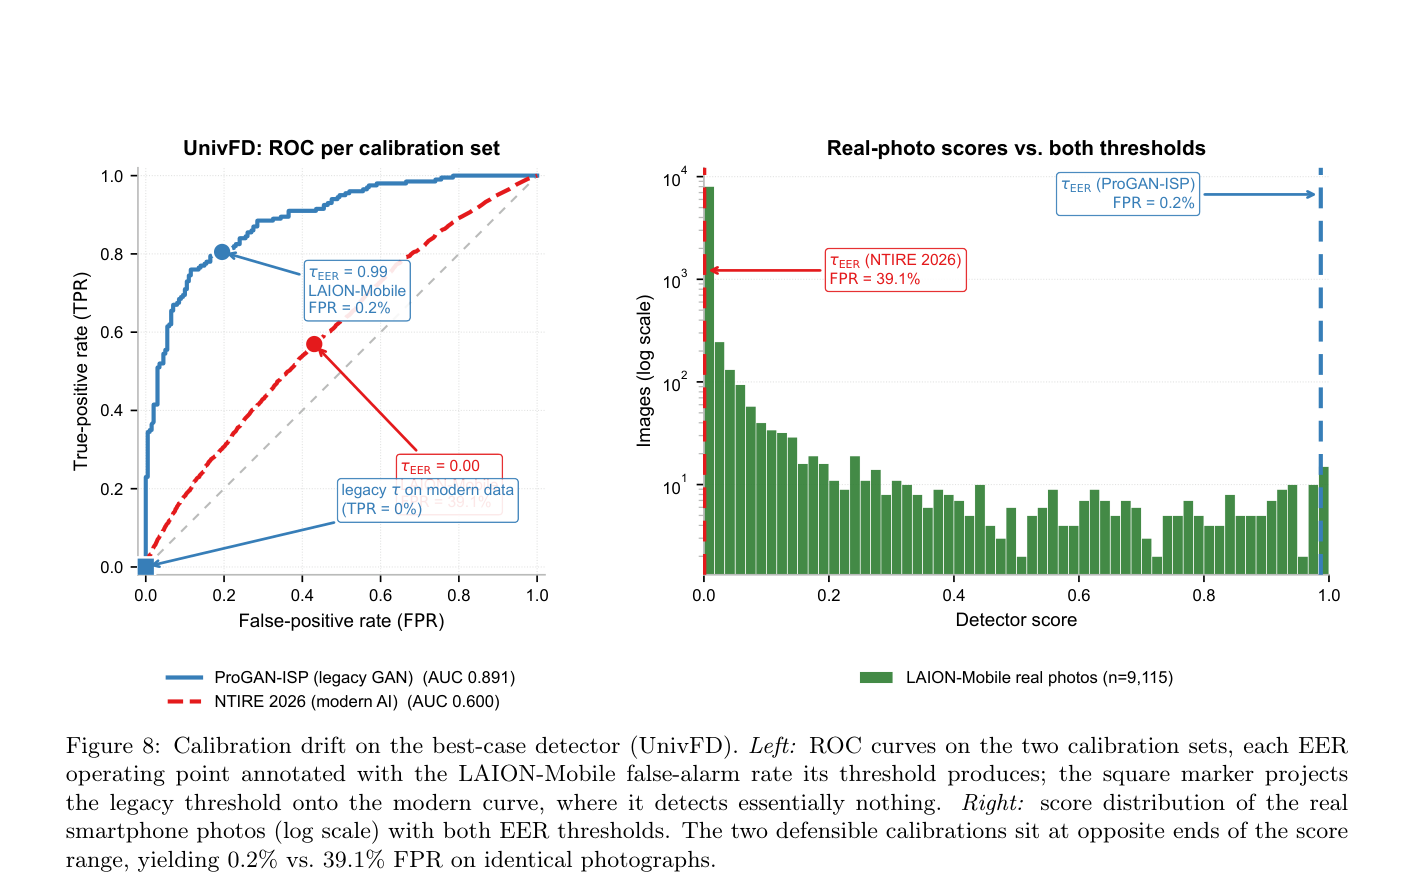
该图展示了最佳情况检测器(UnivFD)上的校准漂移。左侧:两个校准集上的 ROC 曲线,每个 EER 操作点都标注了其阈值在 LAION-Mobile 上产生的误报率;方形标记将遗留阈值投影到现代曲线上,在那里它几乎检测不到任何东西。右侧:真实智能手机照片的分数分布(对数尺度),带有两个 EER 阈值。
论文贡献与测试方法
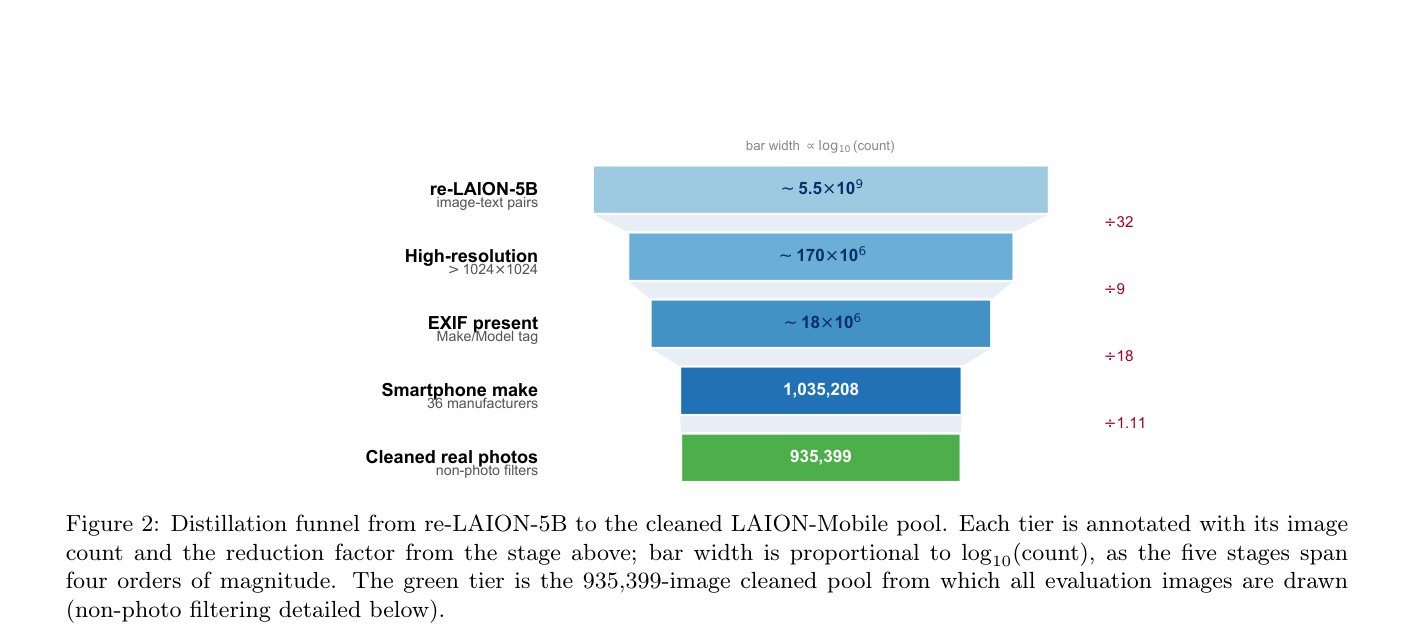
该图展示了从 re-LAION-5B 到清洗后的 LAION-Mobile 池的蒸馏漏斗。每个层级都标注了其图像数量和从上一步骤的减少因子;条形宽度与 log10(count) 成正比,因为五个阶段跨越四个数量级。
意义与局限
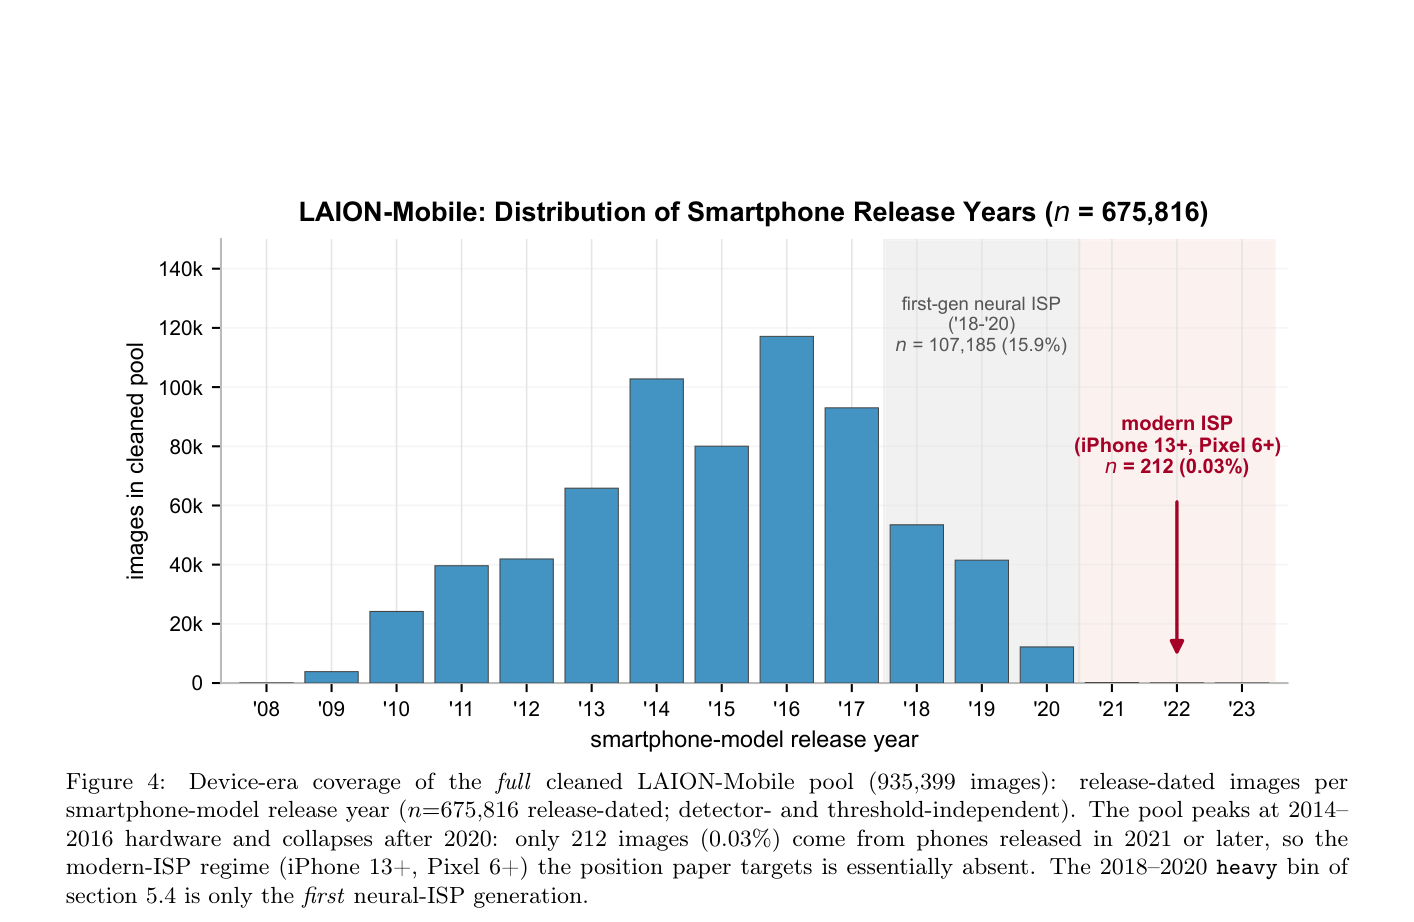
该图展示了完整清洗后的 LAION-Mobile 池(935,399 张图像)的设备年代覆盖情况。池在 2014-2016 年硬件上达到峰值,并在 2020 年后急剧下降:仅有 212 张图像(0.03%)来自 2021 年或以后发布的手机。
实验如何设计?
- 在 ForenSynths 上复现论文结果,验证实现正确性。
- 在 NTIRE 2026 上评估 12 个检测器的跨域泛化能力。
- 在 LAION-Mobile 的 9,115 张样本上评估检测器的误报率(FPR),对比不同校准阈值(ProGAN-ISP vs NTIRE)。
关键结果与论文证据
- NTIRE 2026 AUC 最高仅为 0.624 (RIGID-DINOv3),表明检测器在现代 AI 内容上性能大幅下降。
- 在 NTIRE 校准阈值下,LAION-Mobile 误报率高达 91% (Effort),证实了校准漂移现象。
- UnivFD 在 ProGAN-ISP 校准下 FPR 为 0.2%,但在 NTIRE 校准下升至 39.1%,进一步验证了校准漂移。
- 数据集中 2021 年及以后发布的手机图像仅占 0.03% (212张),限制了现代神经 ISP 管线影响的充分测试。
阅读时需要注意
- LAION-Mobile 是单类(仅真实)数据集,无法直接计算二分类 AUC。
- 数据集中现代智能手机(2021+)占比极低,无法充分测试最新神经 ISP 管线的影响。
- 真实标签基于 EXIF 和启发式过滤,非逐像素验证,可能存在少量误标。
- 仅报告单次运行结果,未包含训练方差。
关联工作
- 本文验证了 ICML 2026 立场论文的核心假设,即计算摄影对 Deepfake 检测的挑战。
- NTIRE 2026 Challenge 作为现代 AI 生成内容的基准,用于评估检测器的跨域泛化能力。
- 被审计的 12 个 SOTA Deepfake 检测器涵盖卷积指纹、CLIP 特征和重建误差等类别。