快速导读:本文提出了一种基于 inpainting 和物理渲染逆问题的基准测试方法,通过让生成模型在真实场景中插入“光探针”(diffuse spheres),定量评估了 16 个 SOTA 生成模型对场景光照方向、颜色及空间变化的物理准确性。
生成式图像模型在视觉真实感上取得了巨大进步,但“看起来真实”并不等同于“物理上正确”。光照是决定图像真实感的核心因素,然而光照与几何、材质、曝光深度纠缠,使得定量评估其物理准确性成为长期难题。现有指标如 FID 和 LPIPS 主要关注感知质量或美学,无法直接回答模型是否真正理解了场景的光照条件。
本文提出 Shedding Light 基准,通过一个巧妙的实验设计解决了这一难题:在真实场景中掩码化参考光探针,提示生成模型通过 inpainting 插入灰色漫反射球体,再利用物理逆渲染从生成的球体中反推光照参数。该方法将光照评估从主观感知拉回到可测量的物理量,为 16 个 SOTA 模型提供了标准化的物理光照准确性度量。
英文题目:Shedding Light: A Benchmark for Evaluating Lighting Understanding in Generative Image Models
论文出处:arXiv 每日论文精选 · arXiv:2609.10787
原始论文:PDF / 论文页面
这篇论文解决什么问题?
光照理解是计算机视觉中的经典难题。在真实世界中,光照由光源方向、颜色、强度及空间分布共同决定,但在图像中,这些信息被几何形状、材质反射特性和相机曝光所混淆。传统重光照方法依赖已知的环境贴图或几何模型,而生成模型直接输出像素,缺乏显式的物理参数,这使得直接评估其光照理解能力变得极其困难。
现有工作尝试从不同角度切入。PhyBench 使用 VLM 对物理合理性进行评分,但 VLM 的判断带有主观性且缺乏物理精度;LumosBench 依赖自然语言描述光照,但语言描述的粒度不足以捕捉细微的光照变化;Giroux et al. 提出了光照准确性感知指标,但需要 ground-truth 环境贴图,限制了其适用性。Farid 在 2022 年分析了 DALL·E 2 生成图像中球体的光照,指出了模型的前向光照偏好,但缺乏系统性的定量基准。
本文的核心洞察是:如果模型真正理解光照,那么当它在场景中插入一个简单的漫反射球体时,该球体的光照应与场景真实光照一致。漫反射球体的反射特性简单且已知,其表面亮度分布直接编码了入射光照信息。通过掩码化真实场景中的参考光探针并让模型 inpainting 新的探针,可以隔离几何和材质因素,直接测量模型生成的光照与真实光照的差异。
核心创新
- 提出了基于 inpainting 和物理逆渲染的光照理解基准测试协议,隔离了几何和材质因素,直接评估光照准确性。
- 引入了无需优化的辐射分布比较方法(KL divergence),作为逆渲染结果的验证。
- 系统分析了 16 个不同架构(U-Net, DiT, Rectified Flow)和类型(inpainting, editing)的 SOTA 模型,揭示了光照准确性随时间未显著提升、模型存在前向光照偏好等规律。
方法概览
1. 数据准备:使用 Multi-Illumination 数据集,将参考光探针(diffuse/chrome spheres)掩码化。2. Inpainting:提示生成模型在掩码区域插入灰色漫反射球体(light probes)。3. 探针检测:使用 SAM3 检测并分割生成的球体,通过梯度能量、径向一致性等阈值过滤无效探针。4. 光照估计:利用 Cook-Torrance BRDF 模型进行逆渲染(inverse rendering),优化材质和光照参数,提取主导光方向(dominant light direction)和颜色。5. 评估指标:计算光方向角度误差(angular error)、颜色差异(ΔEab)、球谐系数(SH coefficients)及辐射分布的 KL 散度。
- 数据准备:使用 Multi-Illumination 数据集,该数据集包含 1006 个真实室内场景,每个场景带有校准的漫反射和金属光探针,覆盖 24 个光照方向。参考光探针被掩码化,作为 inpainting 的目标区域。
- Inpainting 提示:向生成模型提供掩码图像和文本提示,要求其在掩码区域插入灰色漫反射球体。该设计确保生成的探针材质简单,便于后续物理分析。
- 探针检测与过滤:使用 SAM3 检测并分割生成的球体,通过梯度能量、径向一致性等阈值过滤无效探针(如裁剪、噪声、遮挡等),确保后续分析的可靠性。
- 逆渲染光照估计:利用 Cook-Torrance BRDF 模型对生成的探针进行逆渲染,优化材质和光照参数,提取主导光方向(dominant light direction)和颜色。该方法无需环境贴图,直接从像素反推光照。
- 评估指标:计算光方向角度误差(angular error)、颜色差异(ΔEab)、球谐系数(SH coefficients)及辐射分布的 KL 散度。KL 散度作为无需优化的辐射分布比较方法,验证了逆渲染结果的稳健性。
- 测量误差验证:在合成 PBR 数据集上验证逆渲染算法的测量误差,中位角度误差为 2.55°,确保证据的可靠性。
逐图理解论文
直觉与失败案例
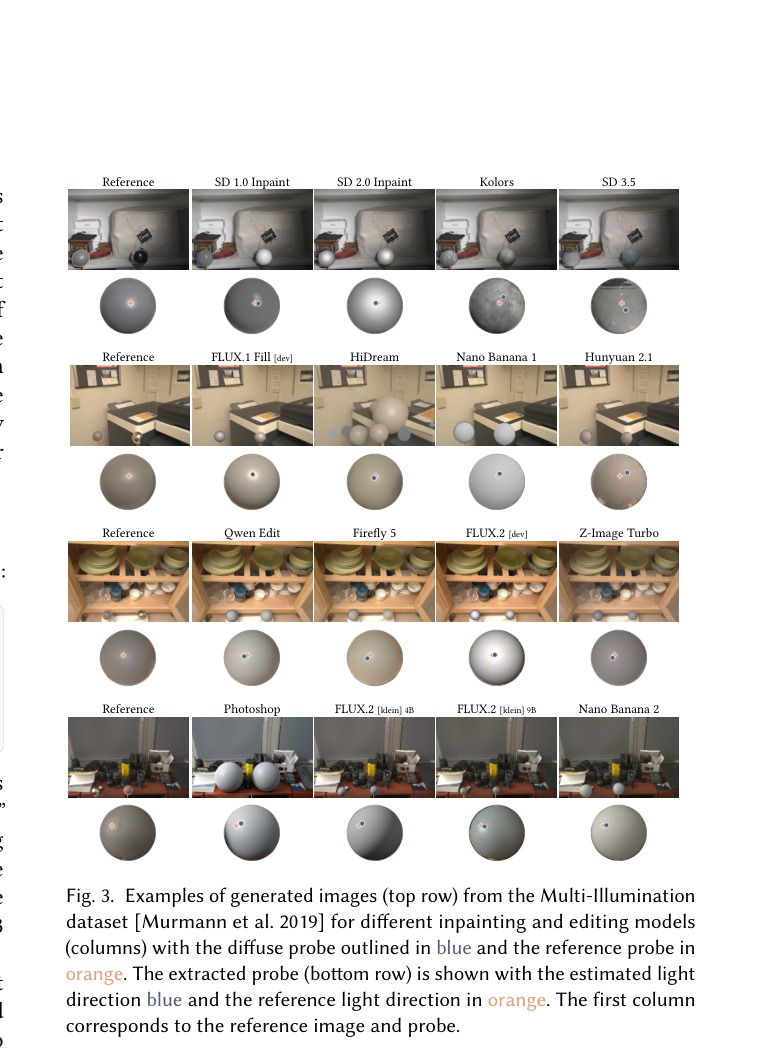
想象一个房间,光源在左后方。模型生成的图像看起来合理,但如果你插入一个灰色球体,它的高光却指向右前方。这种“看起来对但物理错”的现象,正是现有 FID 等指标无法捕捉的盲区。
研究空白
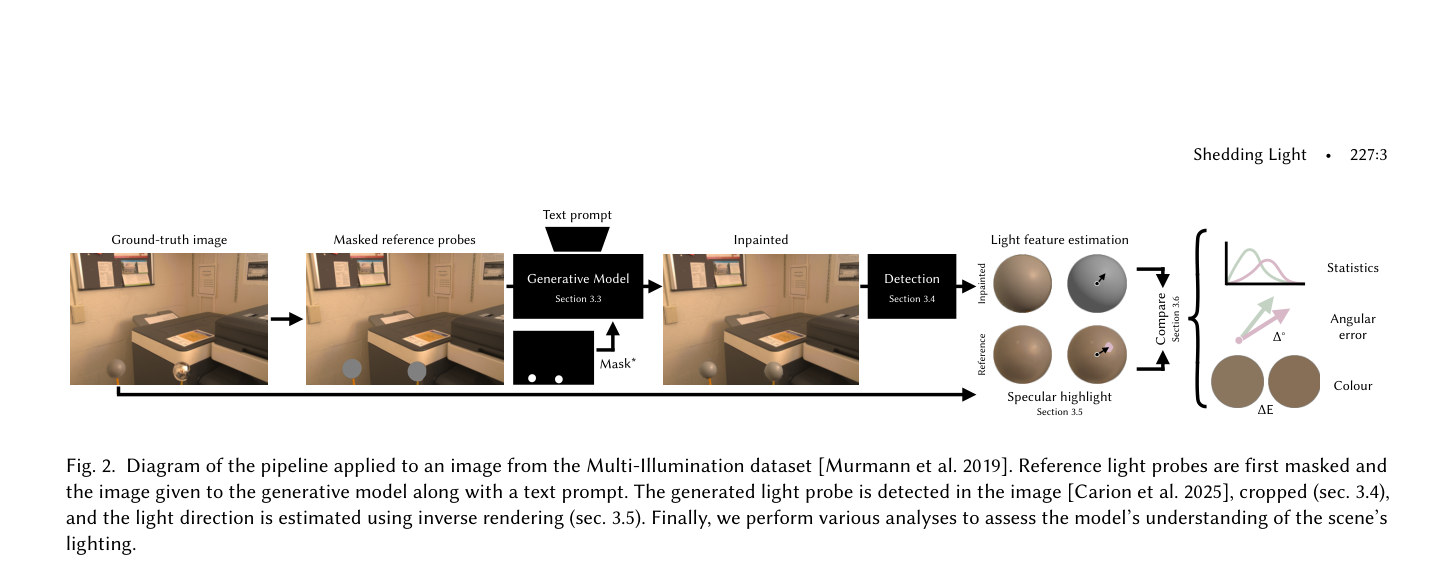
该图展示了完整的 pipeline:掩码参考探针、inpainting 生成探针、检测分割、逆渲染估计光照。理解该流程有助于把握方法的技术细节。
核心发现
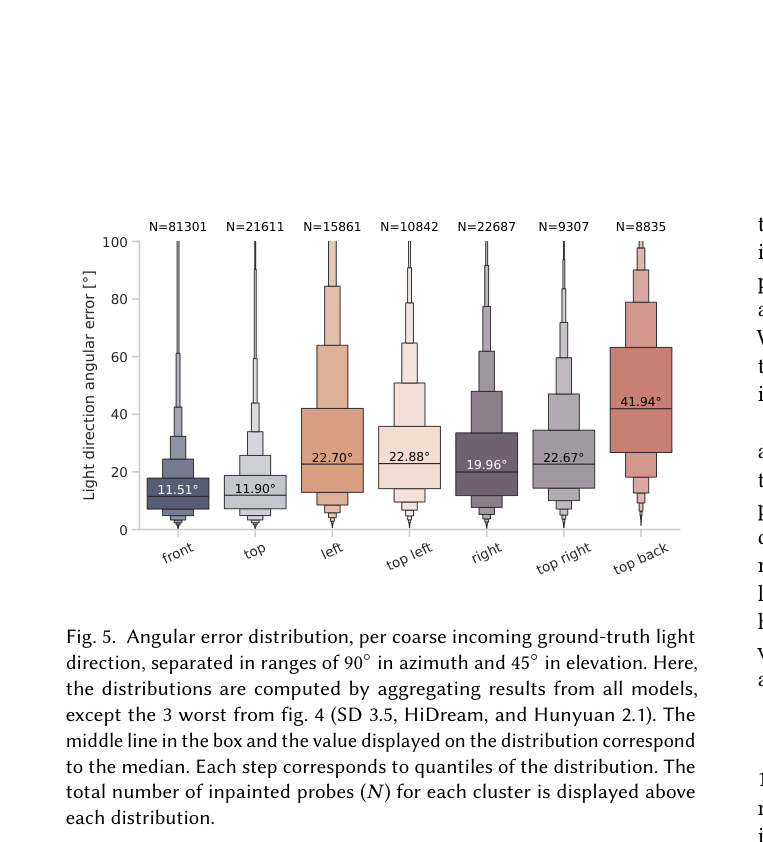
该图展示了不同光照方向下的角度误差分布。观察“top back”方向的误差峰值,可以直观理解模型的前向光照偏好。
意义与局限
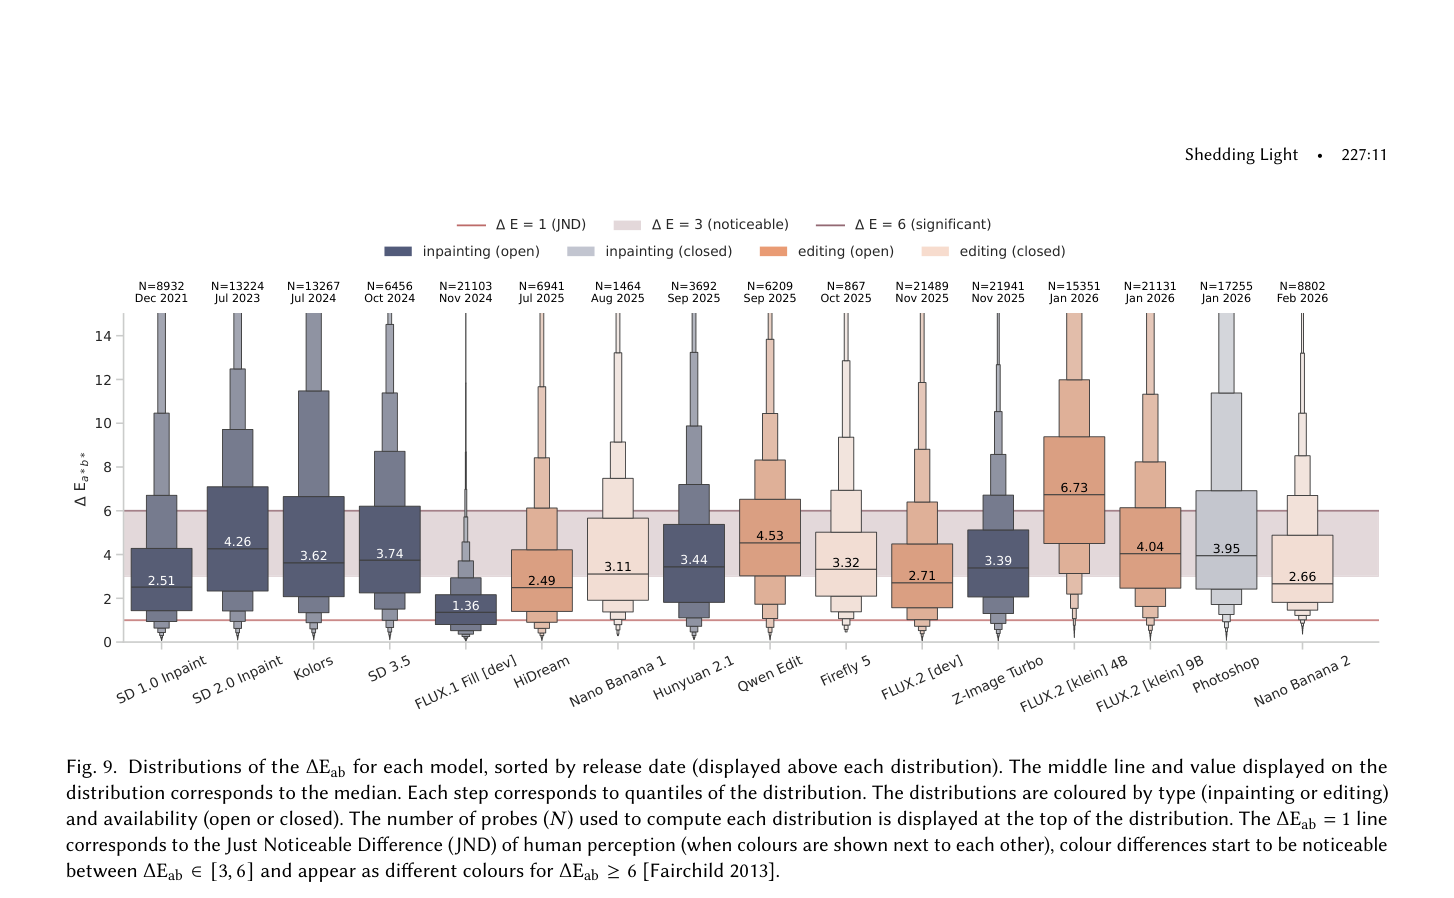
该图展示了不同模型的颜色误差分布。观察 ΔEab=3 阈值线,可以判断模型颜色理解是否达到人类可察觉水平。
实验如何设计?
- 评估 16 个 SOTA 生成模型,涵盖 U-Net、DiT、Rectified Flow 等架构,以及 inpainting 和 editing 两种任务类型,包括开源和闭源模型。
- 在 Multi-Illumination 数据集的 23,023 张图像上进行评估,覆盖 1006 个场景和 24 个光照方向,确保统计显著性。
- 比较不同模型在光方向角度误差、颜色误差、空间光照变化一致性、球谐系数相关性等方面的表现。
- 分析模型参数数量、发布时间、开放/闭源属性与光照准确性之间的关系,揭示光照理解能力的演进规律。
- 通过合成 PBR 数据集验证逆渲染算法的测量误差,确保基准测试的可靠性。
关键结果与论文证据
- 光照准确性未随模型参数增加或发布时间推移而显著提升,表明当前训练目标可能更侧重美学而非物理准确性。
- 模型普遍存在前向光照偏好(frontal bias),在“top back”光照方向下表现最差,而在“front”和“top”方向下表现最好。
- Inpainting 模型和 Editing 模型的中位角度误差差异极小,表明任务类型与光照准确性无显著相关。
- 大多数模型的颜色误差中位数低于 ΔEab=3(可察觉阈值),表明颜色理解相对较好,但方向误差仍是主要瓶颈。
- KL 散度分析显示,部分模型的辐射分布与真实光照存在显著差异,进一步验证了逆渲染结果的可靠性。
- 存在幸存者偏差:生成无效探针较多的模型在统计中可能被低估,因为它们的可用探针更少且质量更差。
阅读时需要注意
- 基准测试假设场景中存在单一主导光源,无法评估多光源复杂场景。
- 仅使用简单的灰色漫反射球体作为探针,无法评估复杂几何和材质对象的光照质量。
- 逆渲染过程存在测量误差,且受探针材质不确定性影响。
- 部分闭源模型因 API 限制未能在全数据集上测试。
- 颜色误差(ΔEab)未包含亮度通道,因为亮度与球体反照率混淆,无法单独评估。
关联工作
- PhyBench 使用 VLM 评分物理理解,而本文使用直接物理测量,提供了更客观的评估。
- LumosBench 评估重光照方法,依赖 VLM 和自然语言描述,本文聚焦于生成模型的光照一致性。
- Giroux et al. 提出光照准确性感知指标,但需要 ground-truth 环境贴图,本文方法无需环境贴图。
- Farid 分析了 DALL·E 2 生成的花园球体光照,本文扩展了该思路并引入定量基准。
- Multi-Illumination 数据集为本文提供了带有校准光探针的真实室内场景,是基准测试的基础。