快速导读:本文提出了涵盖9个推理维度的VWG-Bench基准和基于强化学习的Vid-PRE提示增强模块,旨在诊断并提升视频生成模型在逻辑、物理及空间推理任务中的表现。
随着Veo 3、Sora-2等视频生成模型的演进,行业关注点正从单纯的视觉逼真度转向世界模拟能力。然而,现有模型在执行符号规则、物理定律及复杂目标等“视频思维”(Think-with-Video)任务时,往往表现出显著的认知缺陷。本文旨在解决这一核心矛盾,通过系统性的基准测试与针对性的提示增强技术,提升视频生成模型的推理准确性。
本文提出了VWG-Bench基准与Vid-PRE增强模块。VWG-Bench通过自动化管道构建了涵盖9个核心推理维度的测试集,并设计了三级VLM-as-Judge评估协议,以区分视觉流畅性、任务规则遵守和具体目标实现。Vid-PRE则是一个模型无关的提示重写器,通过将认知推理负担卸载给专用VLM,并利用SFT和基于纯文本奖励的GRPO进行训练,在不修改视频生成器架构的前提下显著提升了推理表现。
英文题目:From Evaluation to Enhancement: Benchmarking and Improving Think-with-Video Reasoning for Video Generative Models
论文出处:arXiv 每日论文精选 · arXiv:2609.11242
原始论文:PDF / 论文页面
这篇论文解决什么问题?
当前视频生成模型在视觉渲染上已接近人类水平,但在需要逻辑推理、物理常识或长程目标执行的任务中表现不佳。例如,模型可能生成视觉上流畅但逻辑错误的视频,如物体违反重力规律或GUI交互操作错误。这种“渲染高分但推理低分”的现象揭示了现有评估体系的不足。
现有基准如TiViBench、V-ReasonBench等往往覆盖范围有限,且多采用整体评分,无法细粒度地诊断失败模式。它们混淆了视觉质量与认知正确性,导致研究者难以区分模型是缺乏视觉生成能力还是缺乏推理能力。此外,现有提示优化方法如Prompt-A-Video主要关注美学质量,而非推理准确性,缺乏针对认知任务的专门设计。
因此,亟需一个能够全面覆盖多种推理维度、提供细粒度诊断能力的基准,以及一种能够有效提升视频生成模型推理能力的增强方法。本文的研究正是基于这一背景展开,旨在为Think-with-Video任务提供系统性的评估与优化框架。
核心创新
- 首个联合覆盖9个核心推理维度和38个任务的Think-with-Video基准VWG-Bench,支持自动化数据构建。
- 提出三级VLM-as-Judge评估框架,解耦视频质量、任务规则遵守和样本目标实现,提供细粒度诊断。
- 提出Vid-PRE,一个通过SFT和基于纯文本奖励的GRPO训练的通用提示增强模块,无需修改视频生成器架构即可显著提升推理准确性。
方法概览
1. VWG-Bench: 构建包含9个核心推理维度、38个细粒度任务的基准,采用自动化数据管道生成样本,并设计三级VLM-as-Judge评估协议(视频级流畅性、任务级规则遵守、样本级目标实现)。2. Vid-PRE: 提出模型无关的提示重写器,将认知推理负担卸载给专用VLM。通过SFT在拒绝采样的推理元组上初始化,随后使用GRPO进行策略对齐,采用纯文本奖励信号(意图保持、视觉空间一致性、解的正确性、格式合规)以增强推理能力。
- VWG-Bench构建了包含9个核心推理维度、38个细粒度任务的基准,涵盖符号逻辑、图形模式、具身经验、GUI交互、假设反事实、空间几何、多尺度时间、自然物理和社会常识。
- 采用自动化数据管道生成样本,通过VLM生成初始提示并筛选高质量实例,确保数据的一致性和多样性。
- 设计三级VLM-as-Judge评估协议:视频级流畅性评估整体视觉质量,任务级规则遵守评估是否遵循特定规则,样本级目标实现评估是否达成具体目标。
- Vid-PRE是一个模型无关的提示重写器,将认知推理负担卸载给专用VLM,通过SFT在拒绝采样的推理元组上初始化。
- 使用GRPO进行策略对齐,采用纯文本奖励信号,包括意图保持、视觉空间一致性、解的正确性和格式合规,以增强推理能力。
- Vid-PRE无需修改视频生成器架构,仅通过优化提示词来提升推理准确性,具有高度的通用性和易用性。
- 通过人类专家与Gemini-3.0-Pro的评分一致性验证评估协议的可靠性,确保自动评估的准确性。
- 在MME-CoF和V-ReasonBench外部基准上验证Vid-PRE的效果,对比基线模型及原生Prompt Extension (PE),证明其泛化能力。
逐图理解论文
研究缺口
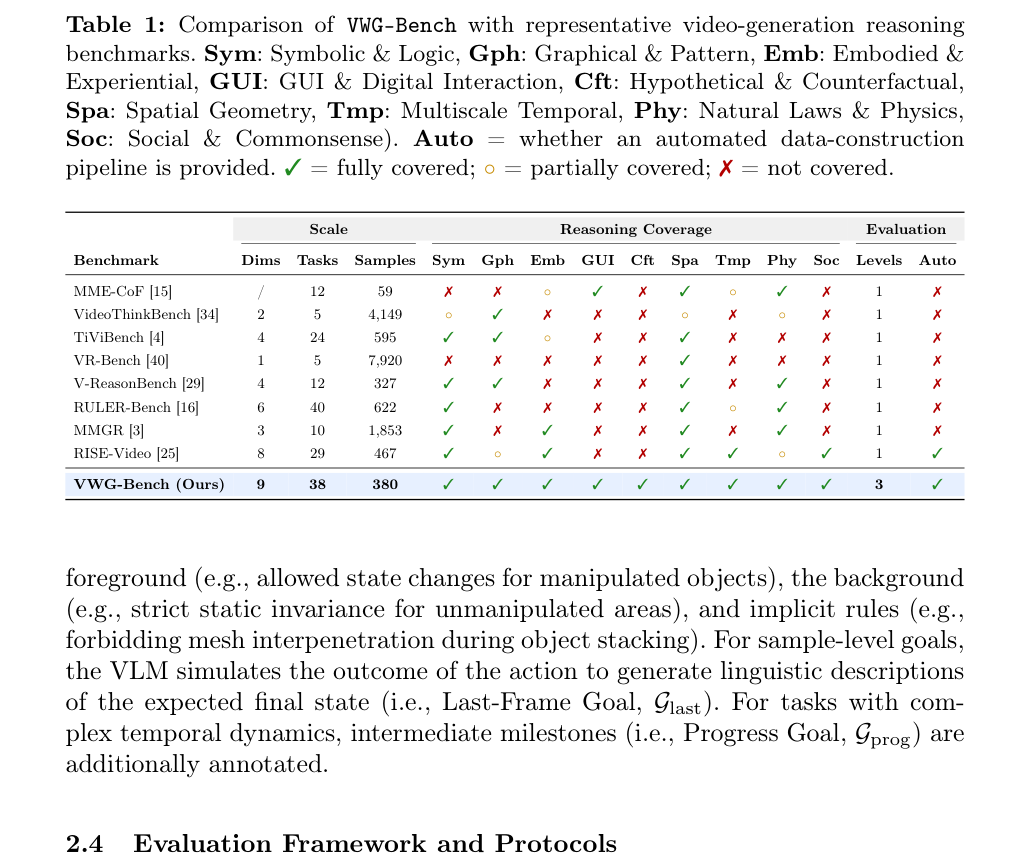
该表比较了VWG-Bench与其他代表性视频生成推理基准。重点观察VWG-Bench在9个维度上的全面覆盖和自动化数据构建能力,理解其相对于现有基准的优势。
核心贡献
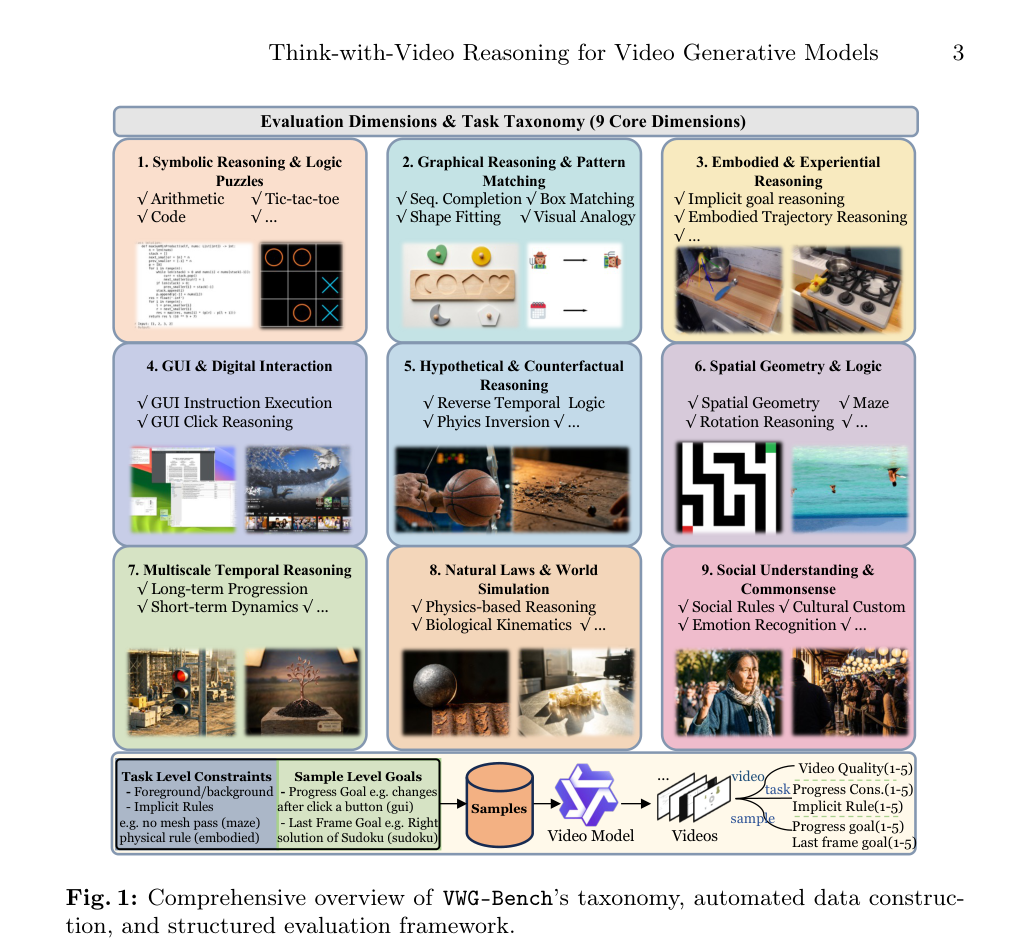
该图展示了VWG-Bench的分类体系、自动化数据构建和结构化评估框架。重点观察9个推理维度的覆盖范围和三级评估协议的设计,理解其如何解耦视觉质量与认知正确性。
最强结论
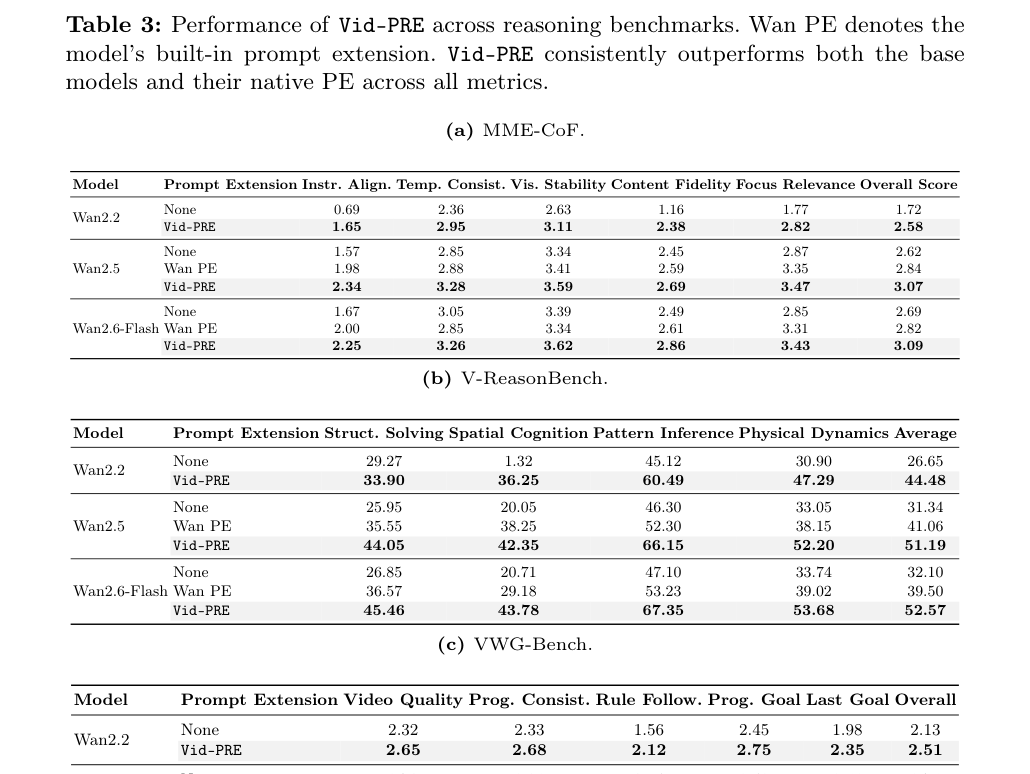
该表展示了Vid-PRE在不同推理基准上的性能。重点观察Vid-PRE相对于基线模型和原生PE的提升幅度,理解其泛化能力和有效性。
意义与局限
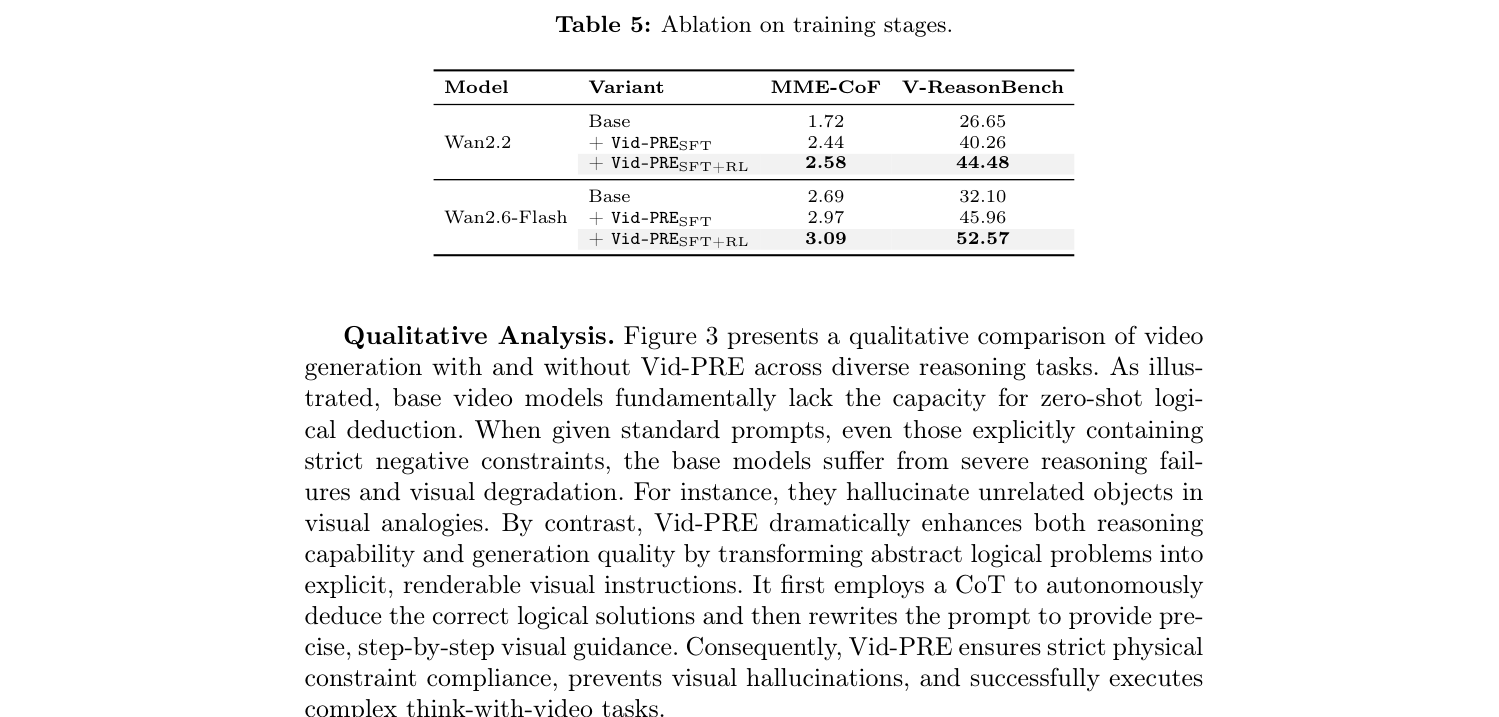
该表展示了训练阶段的消融实验。重点观察SFT和GRPO阶段的贡献,理解各阶段对Vid-PRE性能的影响。
实验如何设计?
- 在VWG-Bench上评估了Wan2.2, Wan2.5, Wan2.6-Flash, Kling-2.5-Turbo-Pro, Sora2, Veo3.1等模型,揭示渲染高分但推理低分的现象。
- 在MME-CoF和V-ReasonBench外部基准上验证Vid-PRE的效果,对比基线模型及原生Prompt Extension (PE)。
- 进行消融实验分析SFT和GRPO阶段的贡献,以及不同奖励组件的影响。
- 通过人类专家与Gemini-3.0-Pro的评分一致性验证评估协议的可靠性。
- 使用Wan2.2作为主要实验模型,因其开源且性能适中,便于对比分析。
- 在VWG-Bench上每个任务类别仅采样10个高质量实例,虽然降低了成本,但可能限制统计显著性。
关键结果与论文证据
- Veo3.1在VWG-Bench上的Overall得分为3.55 (1-5 scale),表明其推理能力相对较强 (p.11)。
- Wan2.2在VWG-Bench上的Implicit Rule Following得分从1.56提升至2.12 (使用Vid-PRE),显示Vid-PRE在规则遵守任务上的显著效果 (p.12)。
- Wan2.2在MME-CoF上的Overall得分从1.72提升至2.58 (50% gain),证明Vid-PRE在外部基准上的泛化能力 (p.12)。
- Wan2.2在V-ReasonBench上的Average Accuracy从26.65提升至44.48 (67% gain),进一步验证Vid-PRE的有效性 (p.12)。
- Wan2.6-Flash在VWG-Bench上的Overall得分达到3.26,超过Wan PE的3.04,表明Vid-PRE优于原生提示扩展 (p.12)。
- 人类专家与Gemini-3.0-Pro的Spearman's ρ在0.69到0.80之间,MAE低于0.55,验证了评估协议的可靠性 (p.13)。
- 消融实验显示SFT和GRPO阶段均对Vid-PRE的性能有显著贡献,其中GRPO在推理准确性上提升更为明显 (p.13)。
- Vid-PRE的效果在逻辑密集和规则约束任务中更为显著,但在纯视觉美学任务中提升有限 (p.14)。
阅读时需要注意
- VWG-Bench每个任务类别仅采样10个高质量实例,虽然降低了成本,但可能限制统计显著性。
- Vid-PRE的训练依赖于Gemini-3.0-Pro作为数据生成器和评估器,可能存在特定模型偏差。
- 评估主要基于VLM-as-Judge,尽管有人类验证,但自动评估仍可能存在幻觉风险。
- Vid-PRE的效果在逻辑密集和规则约束任务中更为显著,但在纯视觉美学任务中提升有限。
- 纯文本奖励信号虽然稳定,但可能无法完全捕捉视频生成中的动态视觉细节。
- 基准中的某些任务(如GUI交互)依赖于特定的界面布局,泛化性需进一步验证。
关联工作
- TiViBench覆盖4个维度,缺乏全面覆盖和细粒度评估 (p.6)。
- V-ReasonBench聚焦空间和物理认知,作为外部评估基准 (p.6)。
- VR-Bench针对空间规划,限于1个维度 (p.6)。
- RULER-Bench针对认知规则遵守,缺乏具身和GUI任务 (p.6)。
- Prompt-A-Video使用DPO,关注美学质量而非推理 (p.14)。
- VPO使用多级反馈,未专门设计用于推理增强 (p.14)。