快速导读:本文提出 Logit Refiner,一个轻量级自回归模块,通过恢复 VAR 模型中尺度内 token 的联合分布依赖,在不重新训练骨干网络的前提下显著提升了图像生成的空间一致性。
视觉自回归(VAR)模型通过 next-scale prediction 实现了高效的图像生成,但其核心假设——在每个尺度内并行独立采样所有 token——构成了 mean-field-style approximation。这种近似忽略了同一尺度内 token 之间的空间依赖关系,导致生成的样本出现局部空间不连贯,如纹理错配和结构断裂。本文提出 Logit Refiner,一个轻量级因果 Transformer 模块,作为插件附加在预训练的 VAR 骨干网络之上,通过自回归方式恢复尺度内 token 的联合分布依赖。
英文题目:Logit Refiner: Improving Visual Autoregressive Models via Intra-Scale Dependency Modeling
论文出处:arXiv 每日论文精选 · arXiv:2609.11804
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VAR 模型在跨尺度上是自回归的,但在每个尺度内并行采样所有 token。这种并行解码构成了 mean-field-style approximation,忽略了同一尺度内 token 之间的空间依赖关系。作者通过 checkerboard 玩具示例证明,正确的边际分布并不保证正确的联合样本。现有的改进方法多关注骨干网络容量或推理加速,未解决解码规则本身的近似误差。
核心创新
- 识别出 VAR 空间不连贯的根本原因是尺度内并行解码的 mean-field-style approximation,而非模型容量不足。
- 提出 Logit Refiner,通过轻量级自回归模块恢复尺度内 token 的联合分布依赖,无需修改或重新训练骨干网络。
- 设计 Identity Initialization 策略,使 Refiner 在训练初期复现基线模型行为,加速收敛并聚焦于学习残差依赖。
- 证明联合尺度内采样(joint intra-scale sampling)是性能提升的关键因素,而非额外的参数容量或训练时长。
方法概览
Logit Refiner 是一个轻量级的因果 Transformer 模块,作为插件附加在预训练的 VAR 骨干网络之上。它接收骨干网络计算的隐藏状态(hidden states),并在每个尺度内以自回归方式(raster-scan order)顺序采样 token,每个 token 的预测条件于之前采样的 token 和骨干特征。骨干网络保持冻结,仅训练 Refiner,使用 teacher forcing 进行并行训练。推理时,骨干网络并行计算隐藏状态,Refiner 利用 KV cache 进行顺序采样。
- Logit Refiner 是一个轻量级的因果 Transformer 模块,作为插件附加在预训练的 VAR 骨干网络之上。
- 它接收骨干网络计算的隐藏状态,并在每个尺度内以自回归方式(raster-scan order)顺序采样 token。
- 每个 token 的预测条件于之前采样的 token 和骨干特征,骨干网络保持冻结,仅训练 Refiner。
- 使用 teacher forcing 进行并行训练,推理时骨干网络并行计算隐藏状态,Refiner 利用 KV cache 进行顺序采样。
- 设计 Identity Initialization 策略,使 Refiner 在训练初期复现基线模型行为,加速收敛并聚焦于学习残差依赖。
逐图理解论文
直觉与失败案例
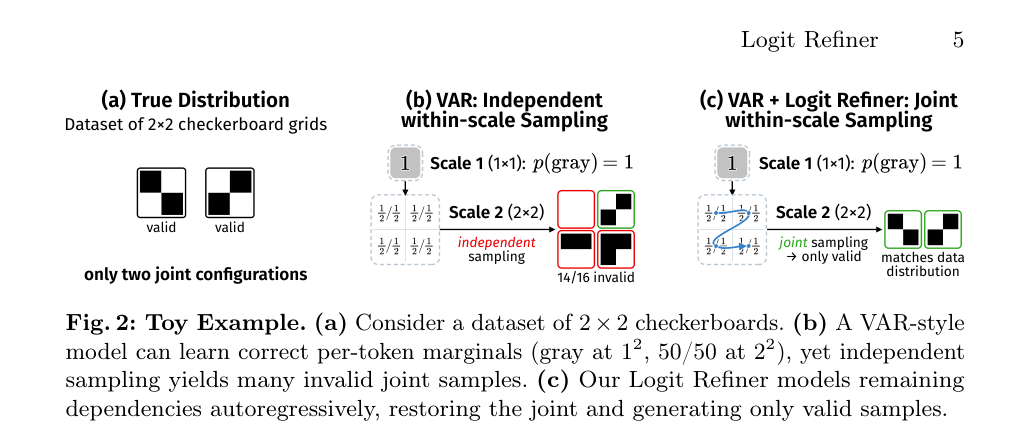
该图通过 checkerboard 玩具示例直观地解释了 mean-field-style approximation 的问题。重点观察 (b) 部分,VAR 风格模型如何学习正确的 per-token marginals,但独立采样导致许多无效的联合样本;以及 (c) 部分,Logit Refiner 如何自回归地建模剩余依赖,恢复联合分布并仅生成有效样本。
研究空白
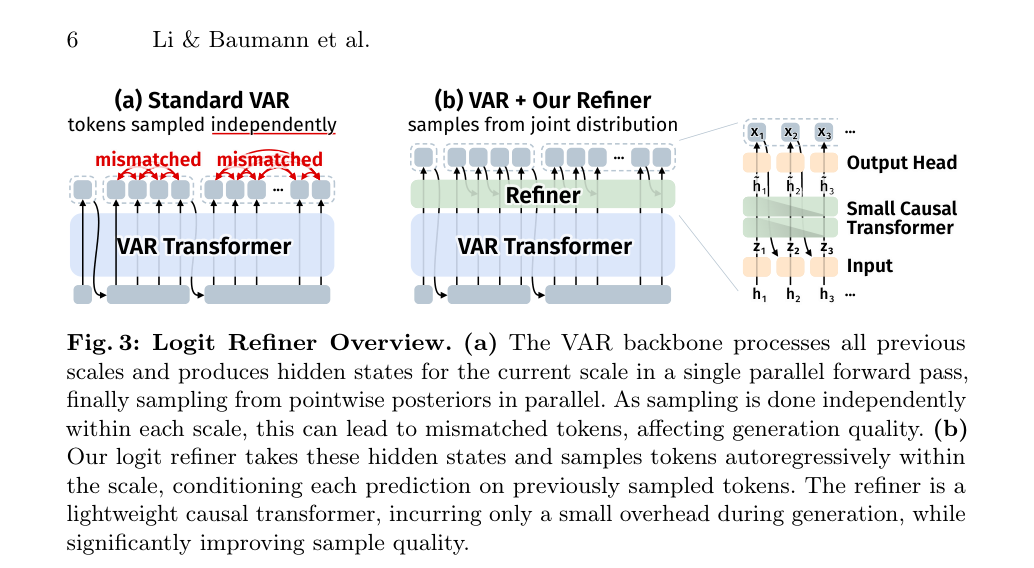
该图概述了 Logit Refiner 的架构和工作流程。重点观察 (a) 部分,VAR 骨干如何并行处理所有先前尺度并产生当前尺度的隐藏状态,以及独立采样如何导致 token 不匹配;以及 (b) 部分,Logit Refiner 如何接收这些隐藏状态并在尺度内自回归地采样 token,每个预测条件于先前采样的 token。
最强结论
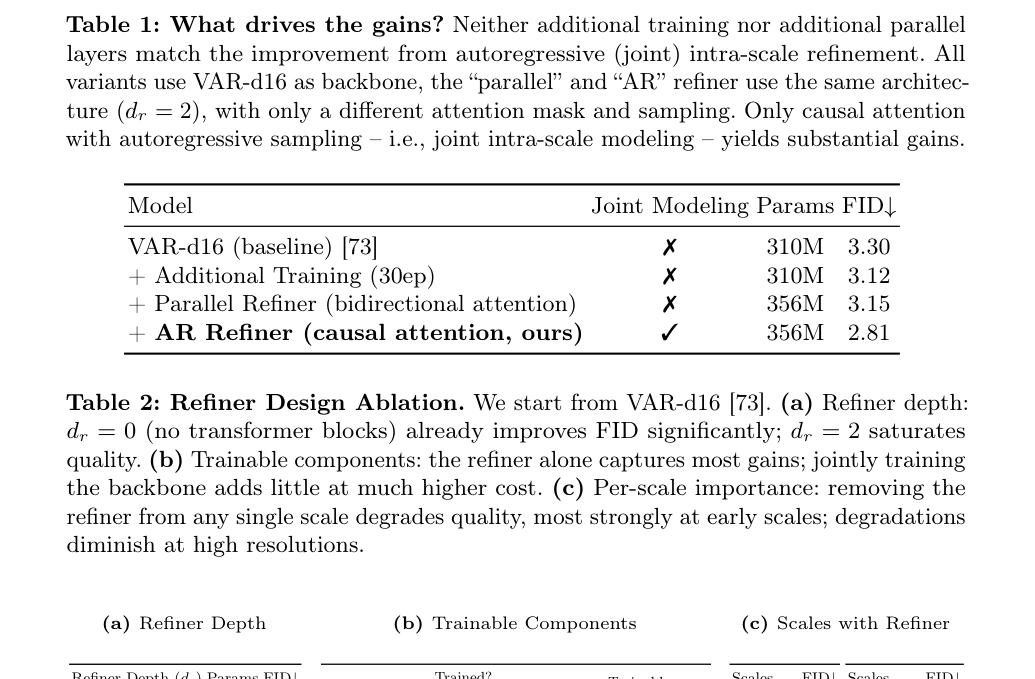
该表通过消融实验揭示了性能提升的根本原因。重点观察不同变体(额外训练、并行 Refiner、自回归 Refiner)的 FID 变化,确认只有因果注意力与自回归采样(即联合尺度内建模)才能带来实质性提升,而非额外的参数容量或训练时长。
意义与局限
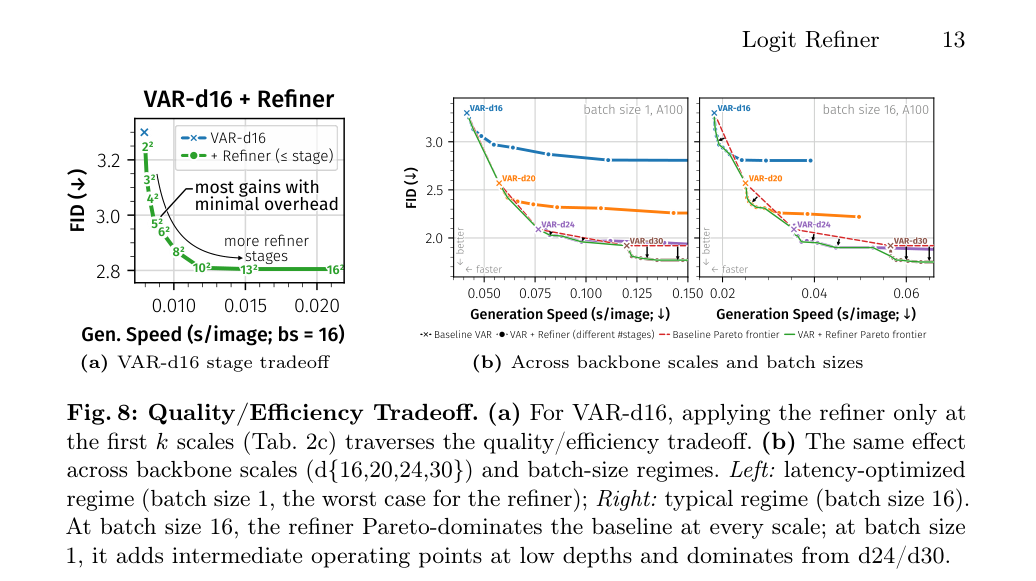
该图分析了质量/效率权衡。重点观察 (b) 部分,在不同批量大小(batch size 1 和 16)和骨干规模(d16 到 d30)下,Refiner 如何遍历质量/效率权衡。在 batch size 16 的典型场景下,Refiner 在所有尺度上 Pareto 占优;在 batch size 1 的延迟优化场景下,它在低深度骨干上增加中间操作点,并在 d24/d30 上占优。
实验如何设计?
- 在 class-conditional ImageNet-256×256 上,对 VAR-d16 到 VAR-d30 不同规模的骨干网络进行 FID、IS、Precision、Recall 评估。
- 消融实验:对比额外训练、并行 Refiner(双向注意力)和自回归 Refiner(因果注意力)的效果,验证依赖建模的作用。
- 在 text-to-image 任务上,将 Refiner 应用于 Infinity-2B 模型,在 HPSv3 基准上评估自动化偏好分数。
- 效率分析:评估不同批量大小和尺度选择下的生成速度与质量权衡(Pareto frontier)。
关键结果与论文证据
- 在 class-conditional ImageNet-256×256 上,VAR-d16 + Refiner FID 从 3.30 降至 2.81 (降低 0.49) (p.9)。
- VAR-d24 + Refiner (1.1B params) FID 1.83,优于 VAR-d30 (2B params) FID 1.92 (p.11)。
- VAR-d30 + Refiner FID 从 1.92 降至 1.76 (降低 0.16) (p.11)。
- Infinity-2B + Refiner HPSv3 平均分从 9.79 提升至 9.91 (p.14)。
- Refiner 仅增加约 10% 参数,训练计算量少于基线模型的 5% (p.1)。
- 消融实验表明,联合尺度内采样(joint intra-scale sampling)是性能提升的关键因素,而非额外的参数容量或训练时长 (p.9)。
阅读时需要注意
- 自回归采样引入了顺序计算开销,尽管通过仅在早期尺度应用 Refiner 可以大幅降低开销,但并未完全消除。
- 在 Inception Score (IS) 和 Precision 上略有下降,主要归因于 Refiner 在最优 FID 下需要更低的 CFG scale。
- 目前主要验证于离散 token 的 scale-wise autoregressive 模型,未探索非自回归的尺度内采样方法。
关联工作
- VAR (Visual Autoregressive Modeling) 是基础模型,本文方法直接应用于其解码阶段 (p.1)。
- Infinity 是扩展 VAR 至 text-to-image 的变体,本文用于 T2I 实验 (p.3)。
- M-VAR, MVAR, HMAR 是其他 scale-wise autoregressive 变体,用于系统级对比 (p.3)。
- Draft-and-Revise 是类似的迭代改进方法,但本文方法更轻量且针对特定近似误差 (p.4)。