快速导读:IMFD 把多人脸伪造做成指令式 LVLM 的单阶段任务:端到端同时定位人脸并判断真伪,再把预测框写回指令当视觉线索。
社交网络上的深伪很少只有一张脸。传统检测器却仍是两阶段:先裁每张脸,再独立做真伪二分类。背景、遮挡、脸与脸的相对位置全被丢掉,裁偏了后面的分类再准也救不回来。OpenForensics 让端到端多人脸检测变得可评,COMICS 一类检测器把对比学习做进框,但仍偏目标中心,对细语义操纵不敏感。Chungnam National University、NAIST 与 Institute of Science Tokyo 的 IMFD 把问题改写成指令:给 LVLM 整图和一段话,让它从左到右给人脸编号,并同时说出哪些是假脸、哪些是真脸。代码与指令格式数据在 https://github.com/somcandy08/IMFD。
关键不只是多一个框损失。IMFD 把预测到的人脸坐标写回同一条指令,当作视觉线索,逼模型把“看哪里”和“判真伪”绑在一起。训练时用真值框;测试时用 CLIP ViT-B/32 加加权框融合得到的预测框,人数从预测框统计,分辨率从图像读取。主实验在 OpenForensics 上用 InternVL2-2B + LoRA。单阶段设定下它超过 COMICS;若把真值框当作两阶段上界,数字更高,但也暴露了框不准时假脸名单会漏。这是 AACL-IJCNLP 2026 Findings 论文。
英文题目:IMFD: End-to-end Multi-Face Forgery Detection through Instruction-based Large Vision-Language Models
论文出处:arXiv 每日论文精选 · arXiv:2609.19693
原始论文:PDF / 论文页面
这篇论文解决什么问题?
扩散模型让换脸图像更逼真。检测路线包括生理线索、频域或重合成伪影,以及数据驱动分类。它们在受控单脸集上可以很强,一到合影、远近不一、姿态杂乱,先检测后人脸分类的误差就会累积。
OpenForensics 专门为多人脸伪造提供端到端评测。COMICS 用双粒度对比让真假脸更好分,但作者认为这类检测器仍是 object-centric,容易错过需要整图语义才能看出的篡改。LVLM 能吃整图和长指令,可是没有现成的“按从左到右编号、输出真假名单和坐标”的数据,微调后也容易数错脸、对不齐编号。
因此要同时解决三件事:把基准改写成可自动打分的指令格式;在指令里放入人数、分辨率和框,减少 LVLM 的计数与对齐错误;在单阶段里自己预测框并写回提示,而不是假设检测器已经完美。
核心创新
- 把多人脸伪造检测写成单阶段指令任务,LVLM 同时完成定位与每张脸的真伪判定,不必先裁脸。
- 把预测人脸框写回指令作为视觉线索,而不是只把框当辅助损失。
- 把 OpenForensics 等数据改成带人数、分辨率和坐标的指令格式,并从左到右编号以便自动评测。
方法概览
每张图配一条指令:给出人数、宽高像素,以及按人脸中心从左到右从 1 编号的框,只给可辨认的脸编号,并要求分别列出假脸与真脸的编号和坐标。回复固定为 the fake faces are … and the real faces are …。训练时注入真值框;测试时用预测框并据此统计人数,分辨率直接读图像。框预测不走分类:用 CLIP ViT-B/32 对查询 “A photo of face” 与网格锚框算相似度,过 τskip 后用 Weighted Boxes Fusion 得到 Bpred。视觉分支按 InternVL:动态高分辨率、Vision Encoder、Pixel Shuffle、MLP Projector,图像向量替换文本里的 [img] 槽。损失为生成交叉熵与框 L1 的平均。主模型 InternVL2-2B + LoRA,输入 448×448。
- 指令模板见图 1。以 <image> 开头,写入人数、宽高像素、所有人脸坐标,要求只给可辨认的脸从左到右从 1 编号,并回答假脸与真脸的编号。标准回复是 the fake faces are {labels and coordinates} and the real faces are {labels and coordinates}。编号按脸中心横坐标。
- 图 2 里绿块是标准 InternVL:Dynamic High Resolution → Vision Encoder → Pixel Shuffle → MLP Projector → LLM,文本经 InternLM2 Tokenizer。红块是 CLIP ViT-B/32 预测 Bounding box Coordinates,加到 User Message 里。图像特征经 MLP 投影后替换 [img] 槽。
- 框预测:查询句为 “A photo of face”,不做类别分类。图像划成网格,每个格子再按不同宽高比生成锚框,CLIP 图像编码器提锚点特征,与查询点积得到分数。min-max 归一后保留 ≥τskip 的锚;若全低于阈值,则仅当整图-文本相似度超过 τtp 时取最高分,若低于 τfp 则清空所有框。保留的锚用 WBF(τiou)融合为 Bpred。实现里 τiou=0.01、τskip=0.8、τtp=0.0、τfp=-2.0。
- 训练用真值框写入指令;测试用 Bpred,并由此统计人数。分辨率直接读图。损失 L=(Lgen+Lbbox)/2,Lgen 是回复的交叉熵,Lbbox 是框的 L1。
- 主骨干 InternVL2-2B(internlm2-chat-1.8b),LoRA 微调,Transformers,seed 42,NVIDIA A6000,输入 448×448。Appendix 还试了 LLaVA-1.5/1.6、InternVL2-4B/8B、MiniCPM 系列。
逐图理解论文
失败直觉
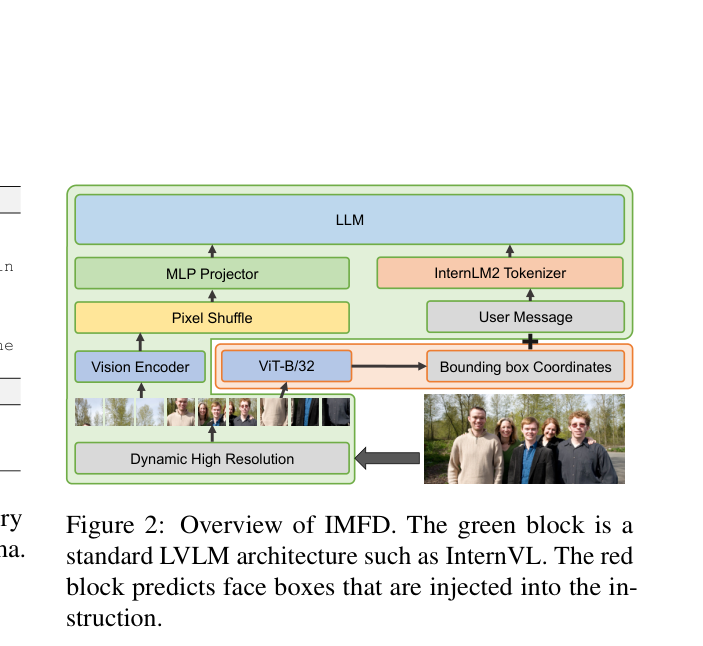
绿框是 InternVL 式 LVLM:动态高分辨率、Vision Encoder、Pixel Shuffle、MLP Projector 接到 LLM,右侧 InternLM2 Tokenizer 处理 User Message。橙红框是 ViT-B/32 预测 Bounding box Coordinates,再加进用户消息。底下四人合影是输入示意。左缘露出 Fig.1 的指令残字。
方法贡献
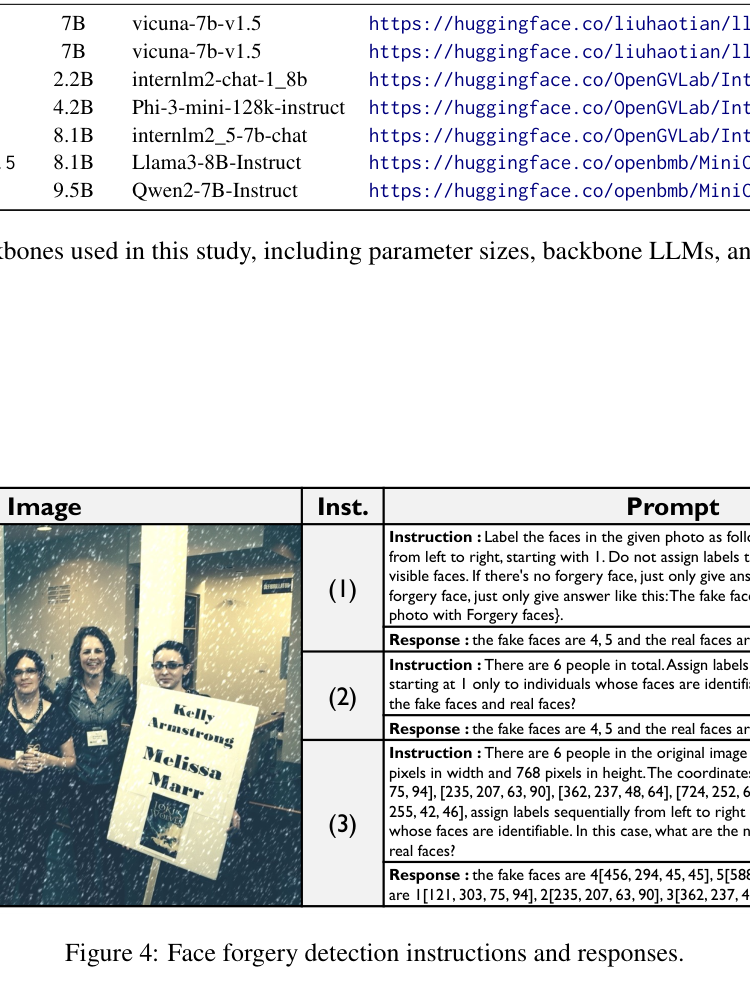
左图是带雪点的室内合影,两人举着 Kelly Armstrong / Melissa Marr 的牌子。右侧三行 Inst.(1)(2)(3) 对应无辅助、只写人数、写人数+分辨率+坐标。回复在 (1)(2) 只给编号,(3) 把坐标写进假脸 4、5 和真脸 1、2、3、6。图上方残留 Table 5 的模型表,不要当指令正文。
关键机制
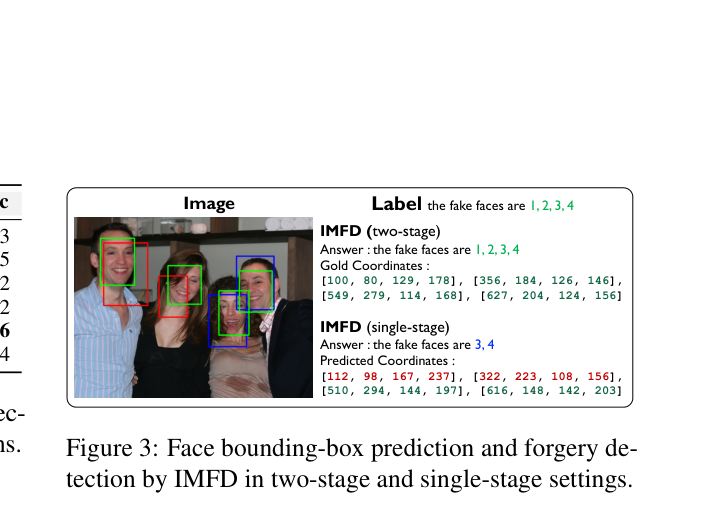
左图四张脸上叠着红/绿/蓝框。Gold 标签写 fake faces 1,2,3,4。两阶段答案同样是 1–4,并列出四组真值坐标。单阶段答案只剩 3,4,预测坐标相对真值有偏移。用来理解:框一旦写进指令,框错就等于名单错。
核心结论
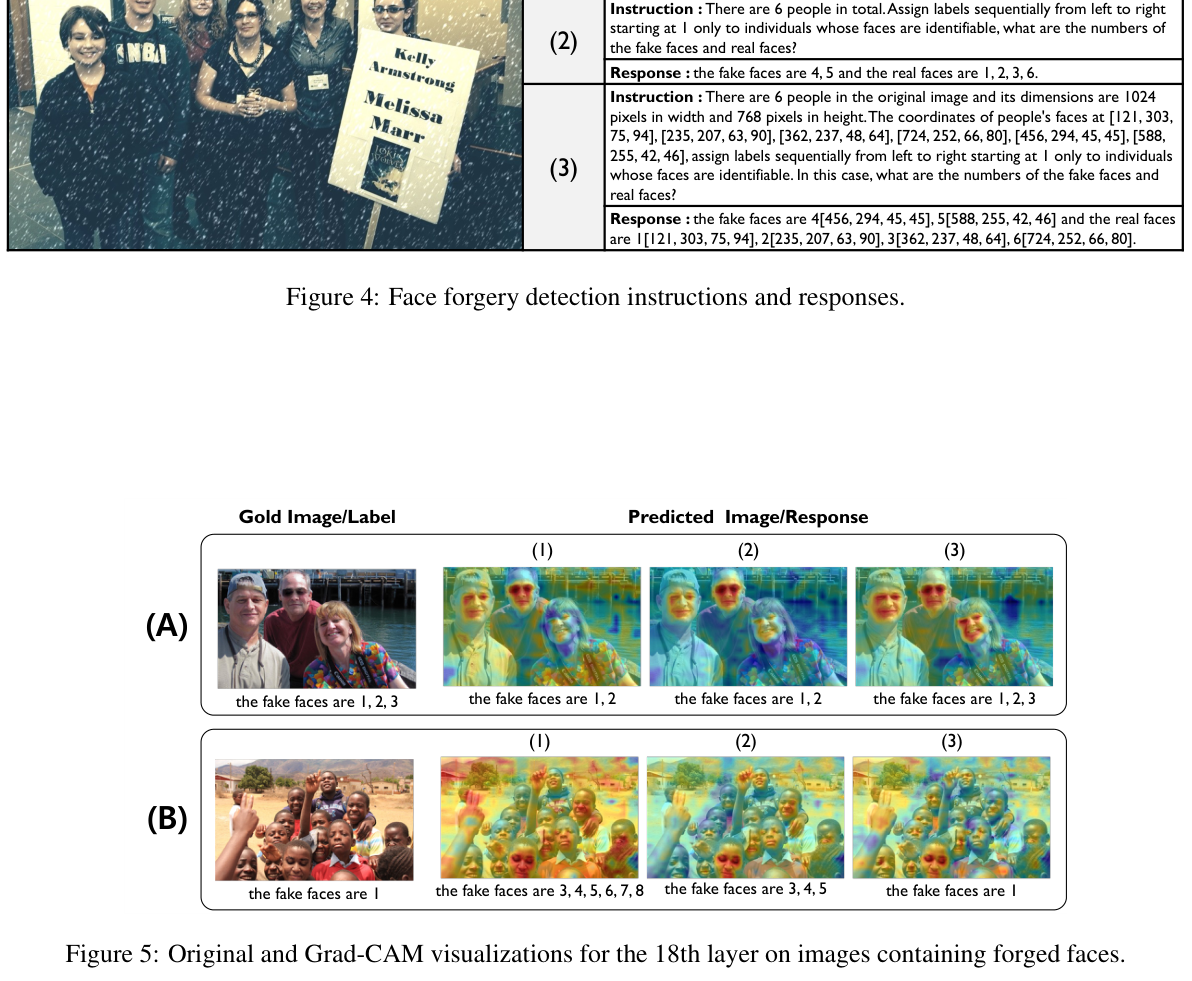
上半仍是 Fig.4 的 (2)(3) 指令残片。下半才是 Fig.5:第 18 层 Grad-CAM。例 A gold 为假脸 1,2,3,(1)(2) 只标 1,2,(3) 才标全;例 B gold 为假脸 1,(1) 标成 3–8,(3) 回到 1。热力图应对着看模型看了哪些脸,而不是看框回归精度。
实验如何设计?
- 数据:OpenForensics 训练 44122、验证 7308、test-development 18895。评测 ALL 的假脸比例 0.58。LARGE 取脸数多于验证集均值 2.63 的 1522 张,用来看人多时是否崩。
- 两阶段方法用真值框再分类:Capsule、UCF、EfficientNet-B4、F3Net,以及同样吃真值框的两阶段 IMFD。单阶段:COMICS 与预测框版 IMFD。COMICS 的假脸判定要求预测框与真值 IoU≥0.5。
- 指标:微平均 F1c、宏平均 F1a、图像级 Acc(假脸集合必须完全一致)。另报时延、最大时延与吞吐。框质量用 COCO AP。显著性为配对 bootstrap,p<0.01。指令消融、多骨干上界、分辨率扫描和 Grad-CAM 见第 4–8 页。
关键结果与论文证据
- Table 1(第 3 页):单阶段 ALL 上 IMFD F1c 0.90、F1a 0.84、Acc 0.77,COMICS 为 0.81、0.74、0.40。LARGE 上 Acc 与 F1a 仍更好(0.40 vs 0.33,0.80 vs 0.74),但 F1c 0.75 低于 COMICS 的 0.81,说明人多时预测框版并不处处领先。两阶段 IMFD 用真值框可到 ALL 0.98/0.98/0.94。作者强调多人场景下它避免逐脸裁剪的串行最大时延。
- 框 AP 在 ALL 为 81.9、LARGE 为 83.6(第 4 页)。Fig.3:两阶段用真值框标出全部四张假脸;单阶段预测框偏移后只答出 3、4 号,说明框错了指令里的名单就会错。
- Table 2:完全不写辅助信息仍有 F1c 0.91,已高于表 1 里最好的两阶段分类器。只写分辨率掉到 Acc 0.32,因为没有空间对应,无法完成从左到右编号。三项全开到 F1c/F1a/Acc 0.98/0.98/0.94。
- Table 3 上界:指令变体 (3)(人数+分辨率+坐标)在 LLaVA、InternVL、MiniCPM 上几乎都最好。InternVL2-2B 不弱于 4B/8B,作者认为对齐指令比单纯放大 LLM 更关键。Table 4:分辨率从 112 升到 672,ALL Acc 从 0.65 升到 0.95。
- Fig.5 Grad-CAM:例 A 三人,(1)(2) 只注意并标出前两张假脸,(3) 才覆盖全部三张;例 B 多人,(1) 乱标成 3–8,(3) 才回到 gold 的假脸 1。
阅读时需要注意
- 只有 OpenForensics,别的多人脸基准不公开。
- 单阶段被框质量绑住,Fig.3 就是漏检样例。
- 不做视频,没有时间一致性。
- 零假脸样本少。
- 算力换精度:单阶段最大时延 875.2ms、吞吐 3.6,明显慢于 EfficientNet 两阶段。
关联工作
- OpenForensics 提供多人脸端到端设定,也限制了结论的外推范围。
- COMICS 是最直接的单阶段检测对照:有框、有对比学习,但没有指令式整图推理。
- Capsule、UCF、F3Net、EfficientNet 代表先裁后分类,用来说明丢掉背景的代价。
- InternVL2 与 CLIP ViT-B/32 分别承担指令生成和人脸锚框。LLaVA、MiniCPM 出现在上界表里,用来说明辅助细节不是某一家模型的专利。