视觉模型学到的是物理约束还是渲染捷径?一项反事实物理一致性基准
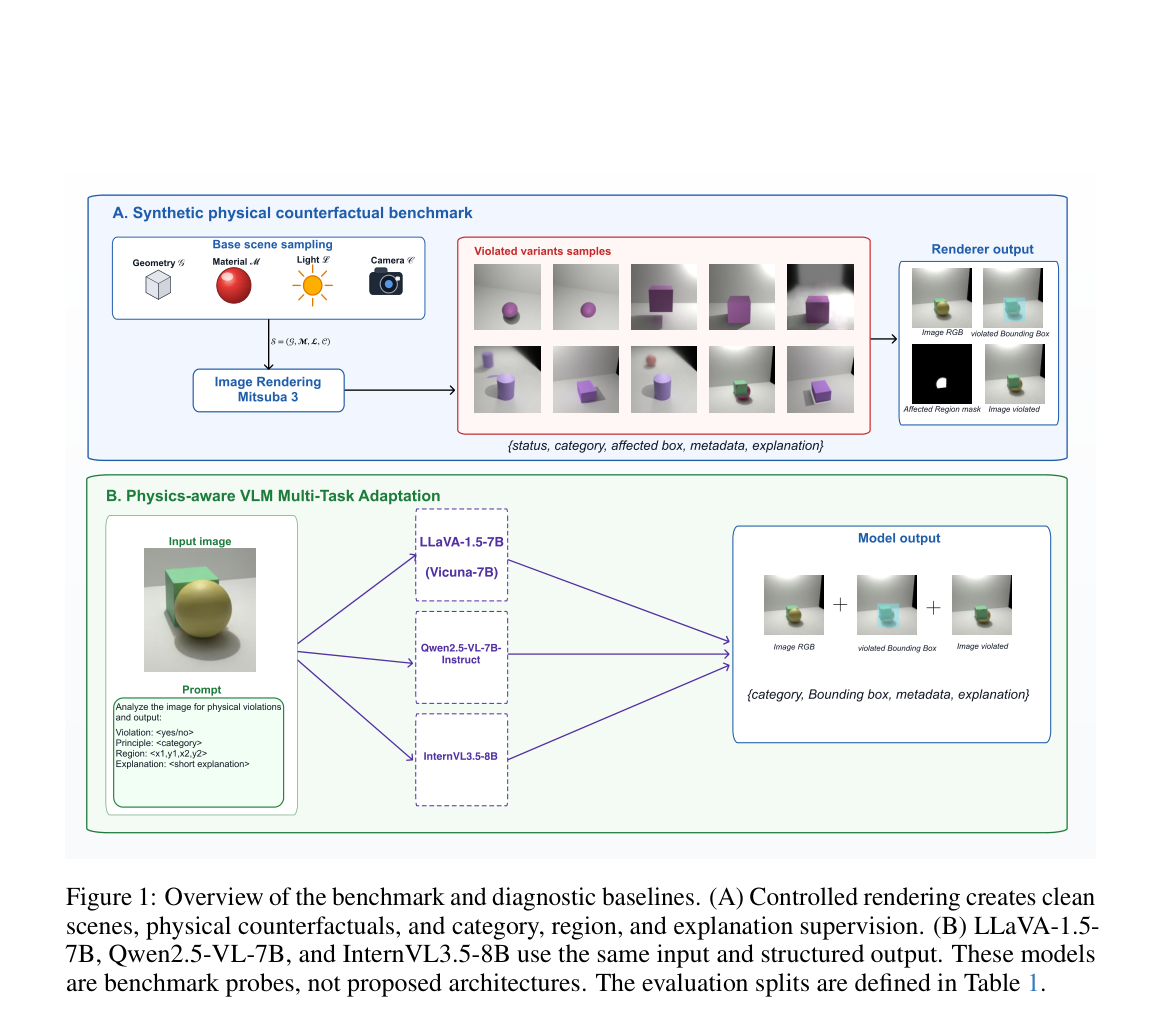
该基准用 Mitsuba 3 成对反事实渲染,把物理一致性诊断拆成违规类型、受影响区域与语言解释,并用干预机制偏移检验模型是否在走渲染捷径。
该基准用 Mitsuba 3 成对反事实渲染,把物理一致性诊断拆成违规类型、受影响区域与语言解释,并用干预机制偏移检验模型是否在走渲染捷径。
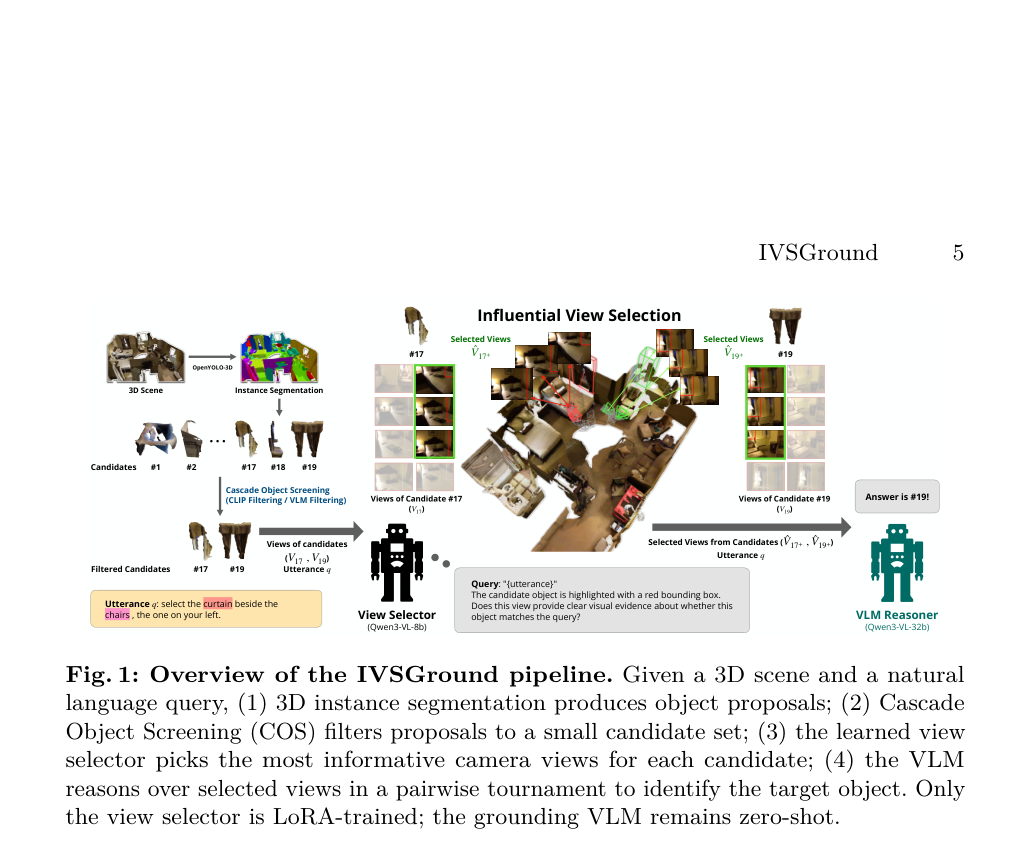
本文提出IVSGround框架,通过拒绝采样从VLM反馈中学习关键视角选择器,在保持推理VLM零样本冻结的前提下,显著提升了3D视觉定位的准确率。
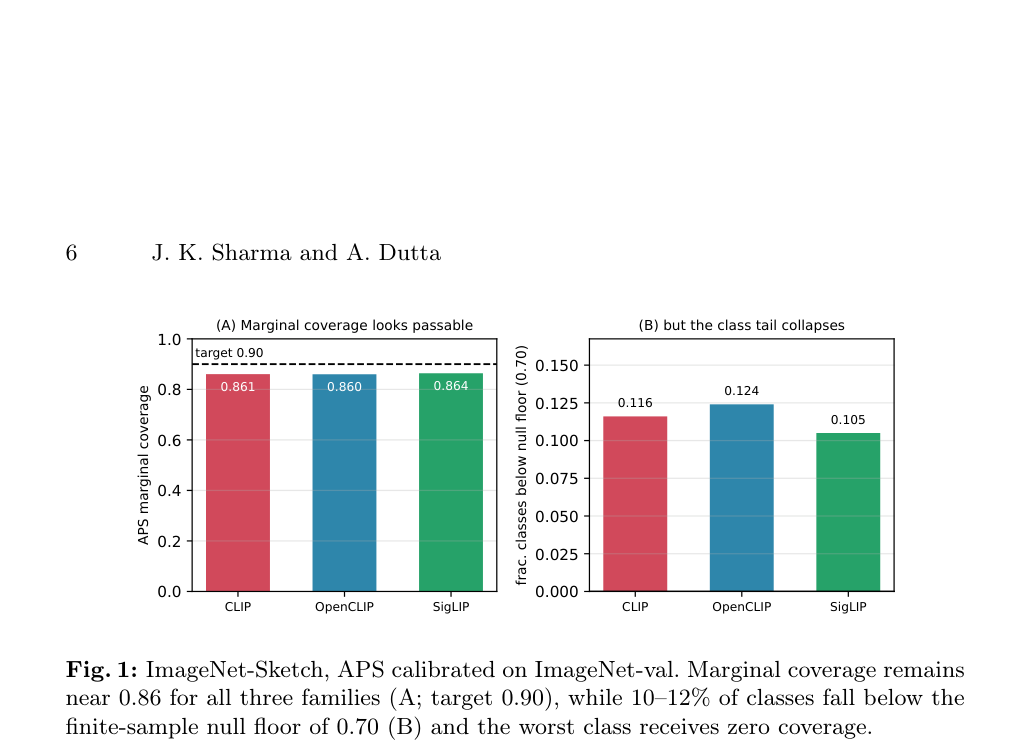
审计发现:零样本VLM的split-conformal预测在分布偏移下边际覆盖看似达标,但最差类别覆盖坍缩至≈0,且源域诊断无法预测该失效。
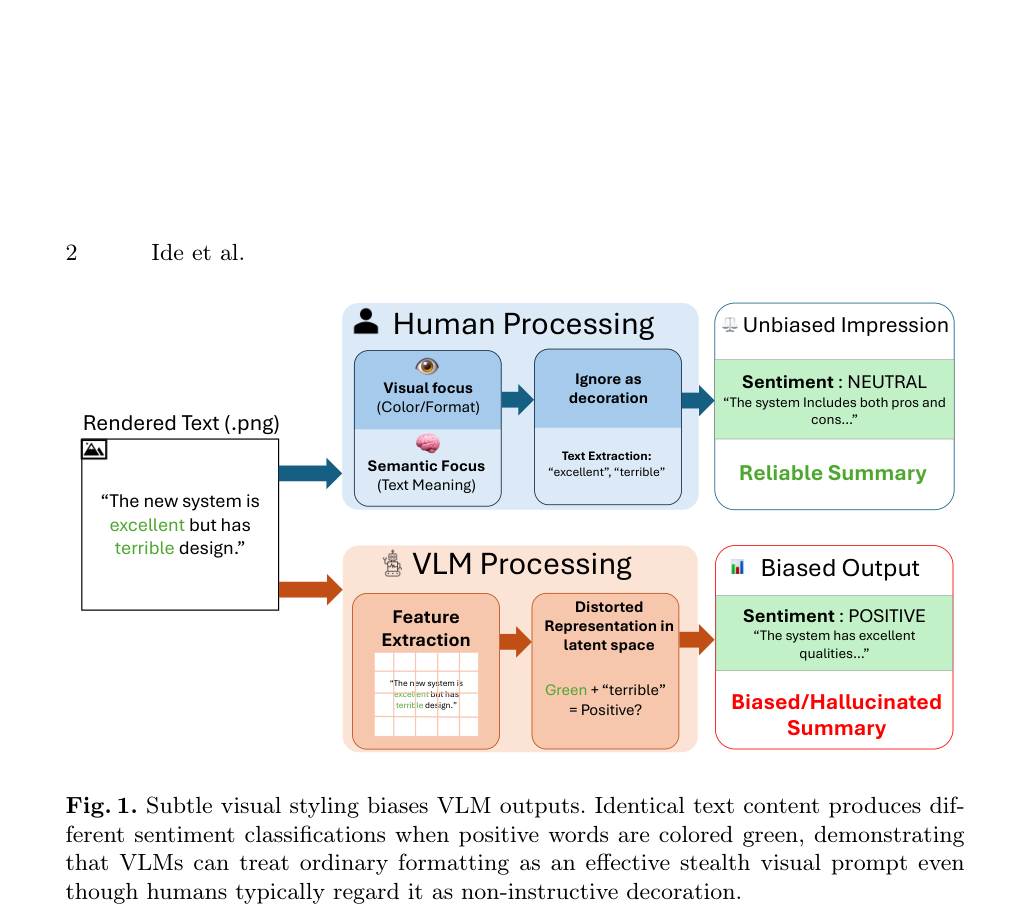
该论文提出 Stealth Visual Prompts 方法,系统研究文本渲染中的颜色与对比度等视觉样式变化如何在不改变语义内容的情况下影响 VLM 的情感分析与 VQA 行为。
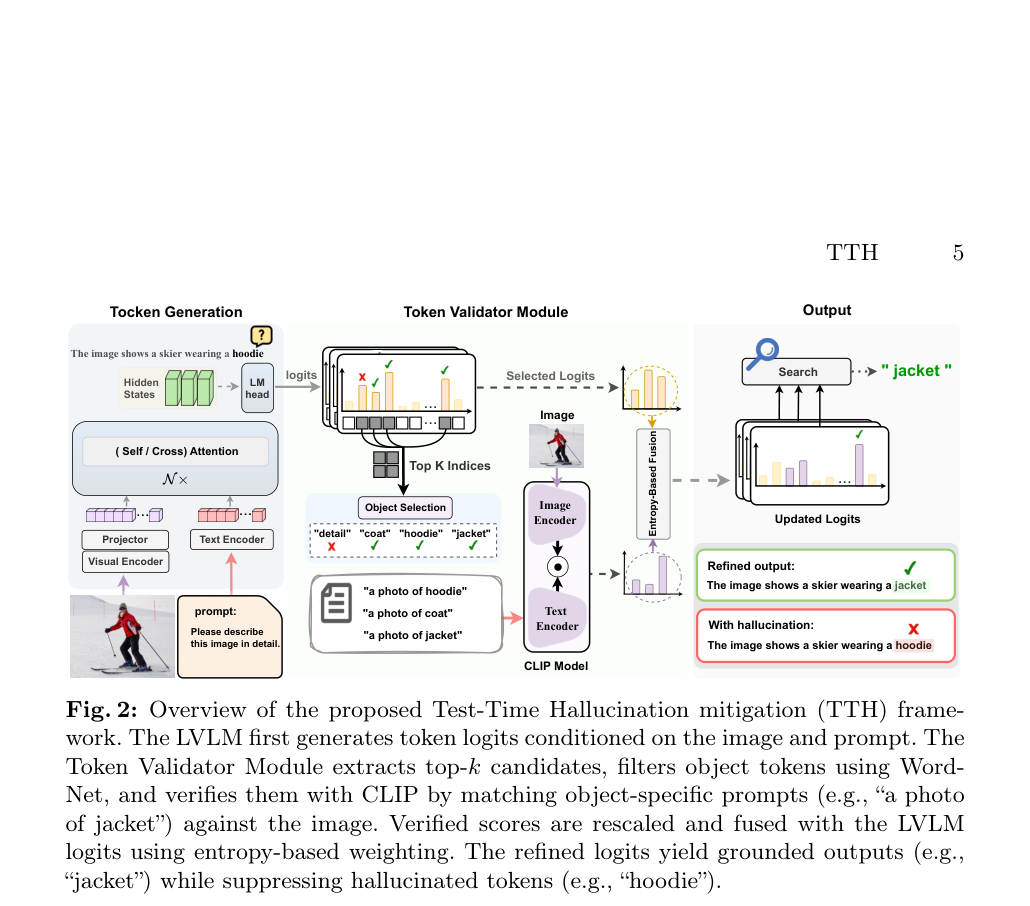
提出 TTH,一种无需训练、单次生成、不改模型权重或隐状态的解码策略,通过 CLIP 验证候选物体 token 并以熵自适应融合来抑制 LVLM 物体幻觉。
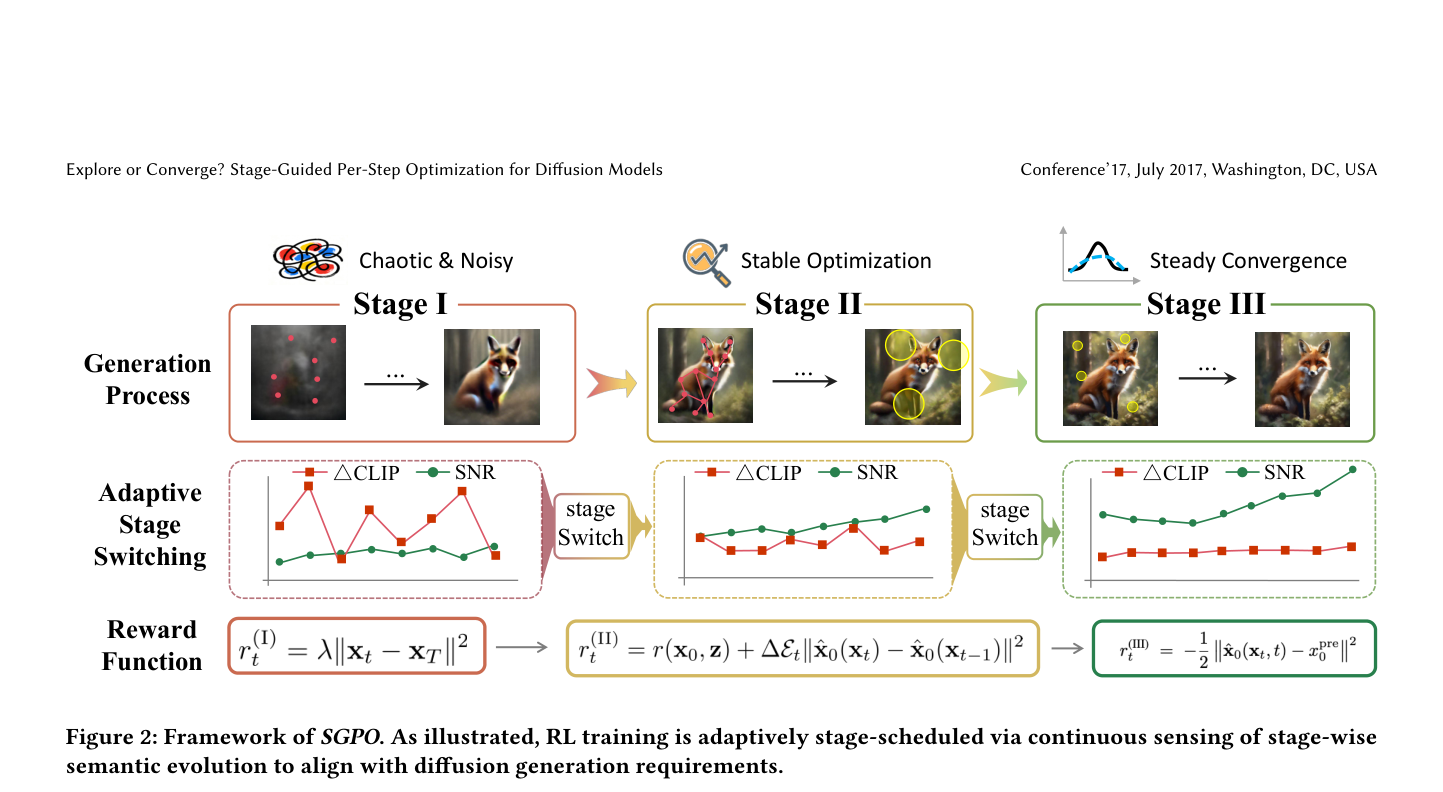
提出SGPO框架,通过感知扩散生成过程中的语义变化和信噪比,自适应地将RL优化划分为混沌逃离、带探索的偏好优化和稳定收敛三个阶段,以缓解奖励黑客问题并提升生成质量与多样性。
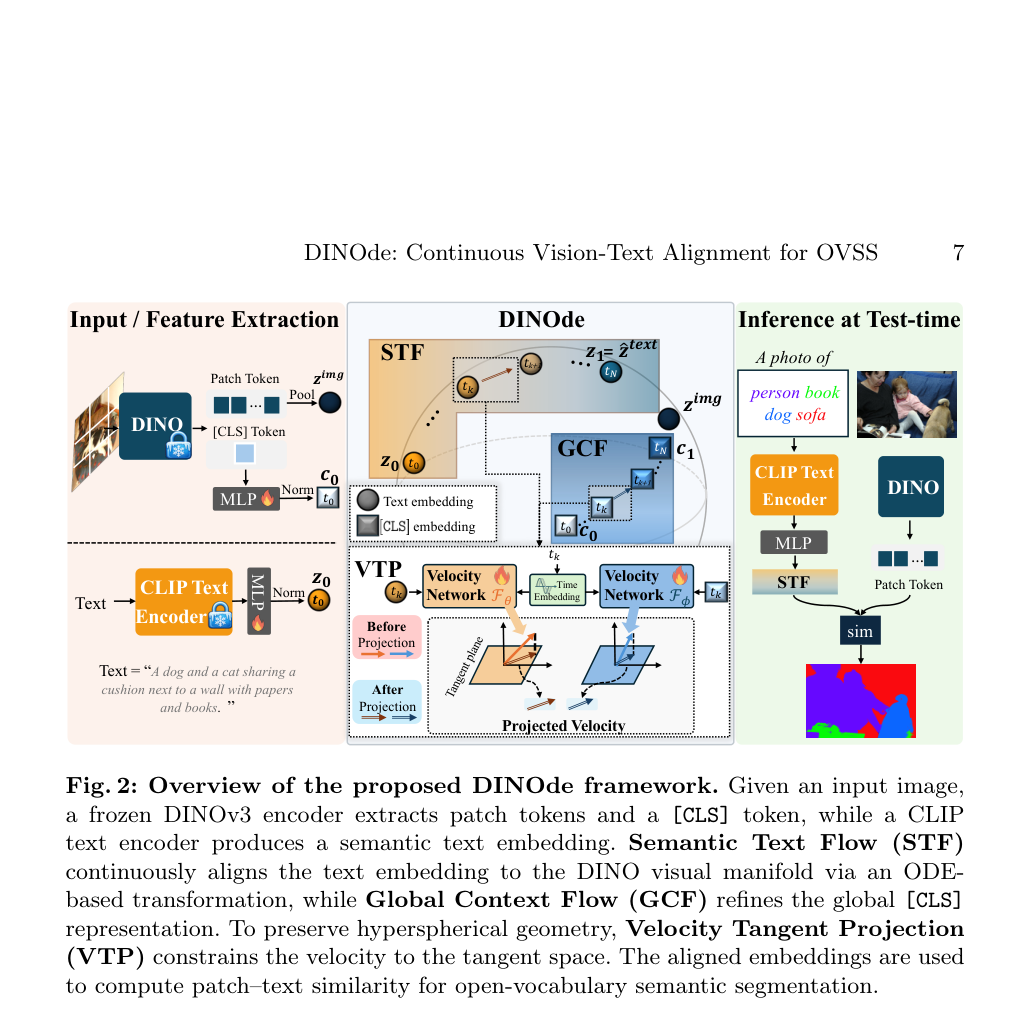
现有开放词汇语义分割方法常因离散投影导致语义纠缠。DINOde引入ODE框架,通过Semantic Text Flow和Velocity Tangent Projection,在超球面上平滑演化文本嵌入。实验显示其几何保持能力优于MLP基线,并在多个基准上超越Talk2DINO。注意:性能依赖后处理,且ODE步数过多可能引入数值误差。