快速导读:上海交通大学的 SVEET 只在冻结的双向 Wan-VACE 上训练逐帧二维控制分支,并用正交解耦训练避开双向到因果的特征差,从而把编辑零样本迁到冻结的 Causal Forcing,在单卡 H100 上达到 15 FPS。
实时换风格、在线补全和由深度生成视频,都希望模型按因果顺序、低延迟地吐出下一帧。现有 DiT 视频编辑却按整段双向去噪设计,推理时要看见未来帧,和流式约束正面冲突。上海交通大学的 SVEET 追问:能不能只在已经预训练好的双向编辑模型上训练,再把学到的控制直接接到一个冻结的流式骨干上,既不重训也不蒸馏那个骨干?
答案是一条外挂控制分支加一次特征空间解耦。控制分支用逐帧二维空间注意力编码源视频,满足条件帧独立;正交解耦训练把 LoRA 更新限制在双向到因果差异主方向的正交补上,减轻两个骨干特征空间错位。默认双向骨干是 Wan2.1-1.3B-VACE,默认流式骨干是 chunk-wise Causal Forcing。作者报告在单张 H100 上、不做额外加速时达到 15 FPS(第1页)。
英文题目:Streaming Video Editing with Easy Adaptation
论文出处:arXiv 每日论文精选 · arXiv:2609.24788
原始论文:PDF / 论文页面
这篇论文解决什么问题?
视频扩散正在从离线整段生成走向流式生成,以支撑互动创作和实时虚拟人。近期工作通常把预训练双向 Diffusion Transformer 改成因果自回归模型,并配合蒸馏来缩小训练与推理的差距。编辑任务没有同步走完这一步:Kong、Liu、Wan 等视频编辑方法都依赖双向全序列处理,因此做不了直播风格迁移或在线补全(第2页)。
直接从零训练流式编辑模型并不现实。预训练一个有竞争力的视频扩散骨干本身就很贵;按近期流式蒸馏的报告,这类适配可以消耗 128 个 H100 GPU 日,并要合成数以千计的 ODE 轨迹对。控制信号再加进来,成本继续上升(第2页)。
作者由此提出两条可迁移原则。骨干特征解耦:控制机制必须和基座分开,才能保住已经封装好的生成先验。条件帧独立:源视频要按帧编码,不能带时间依赖,否则流式推理时条件通路本身就不因果。Figure 3 用三种结构的双向到流式迁移对照了这两条原则(第2、4页)。
核心创新
- 提出不重训、不蒸馏流式骨干的双向到流式视频编辑迁移,并归纳出骨干特征解耦与条件帧独立两条原则。
- 把 VACE 控制分支的全时空注意力改成逐帧二维空间注意力,使源视频编码与因果分块推理兼容。
- 用正交解耦训练把可控性更新限制在双向–因果差异主方向的正交补上,减轻零样本迁移时的特征错位。
方法概览
SVEET 有两块。其一,在 VACE 式外挂分支上把三维时空自注意力换成逐帧二维空间注意力:查询只看同一源帧,条件表示不依赖其他帧,流式推理时控制分支不需要键值缓存。其二,Orthogonal Decoupled Training:用少量校准视频比较冻结双向骨干 Fb 与因果骨干 Fc 的逐块隐状态,岭回归得到线性映射,残差 A=W-I 做薄 SVD,取累计谱能量 80% 的右奇异向量作为差异子空间,把 LoRA 控制更新投影到其正交补。双向骨干与流式骨干的预训练权重都冻结。默认实现是 Wan2.1-1.3B-VACE 加 chunk-wise Causal Forcing。
- 问题设定:Fb 是联合去噪全部帧的双向模型,Fc 是按块自回归的因果流式模型。目标是在冻结的 Fb 上学习编辑,再把同一控制分支直接用到冻结的 Fc,不微调流式骨干(第4页)。
- 外挂控制沿用 VACE。Video Condition Unit 吃进源视频、参考图和掩码,控制块的特征以残差方式加到对应的冻结 DiT 块,再由冻结 VAE 解码成编辑结果。这样基座权重不承担控制学习(第3页,Figure 2a)。
- 逐帧二维注意力:把控制分支里的三维时空自注意力换成只在同一帧内计算的二维空间自注意力。注意力掩码在帧下标相同处为 1,否则为 0。因此第 t 帧的条件只依赖该帧,视频的时间连贯仍由流式骨干的历史缓存负责。控制分支在流式推理时不需要自己的键值缓存,不会在式 (2) 的自回归缓存之外再增加一份随时间增长的开销(第4–5页,Figure 2b)。
- 正交解耦训练先做数据驱动的特征探针。同一批视频–提示喂给 Fb 和 Fc,记录逐块隐状态,用岭回归求把双向特征映到因果特征的线性映射 W。以单位阵为双向参考,残差 A=W−I 表示“把双向表示拧成因果表示”的更新方向。对 A 做薄 SVD,保留累计谱能量 80% 的顶部右奇异向量,构成差异子空间;正交投影 Π⊥=I−Vk Vk^T 在训练中冻结(第5–6页)。
- 控制更新写成 A2=C Π⊥,其中 C 由 LoRA 参数化,骨干侧 W2=Wb+A2。这样可控性梯度被挡在双向–因果主差异方向之外。Figure 2c 把这件事画成特征空间里贴着正交补平面的控制更新。非正式定理说明:若因果相关的更新近似低秩,去掉其主奇异子空间后,它对另一功能的干扰由残差尾能量界定,输出可加性也会更好(第5–6页)。
- 实现细节:LoRA rank 128,AdamW 学习率 1×10^−4,权重衰减 10^−2,全部预训练骨干冻结。每个任务在单张 A100 80GB 上训练 10 个 epoch,batch size 1,片段长 81 帧、分辨率 480×832(第6页)。
逐图理解论文
失败直觉
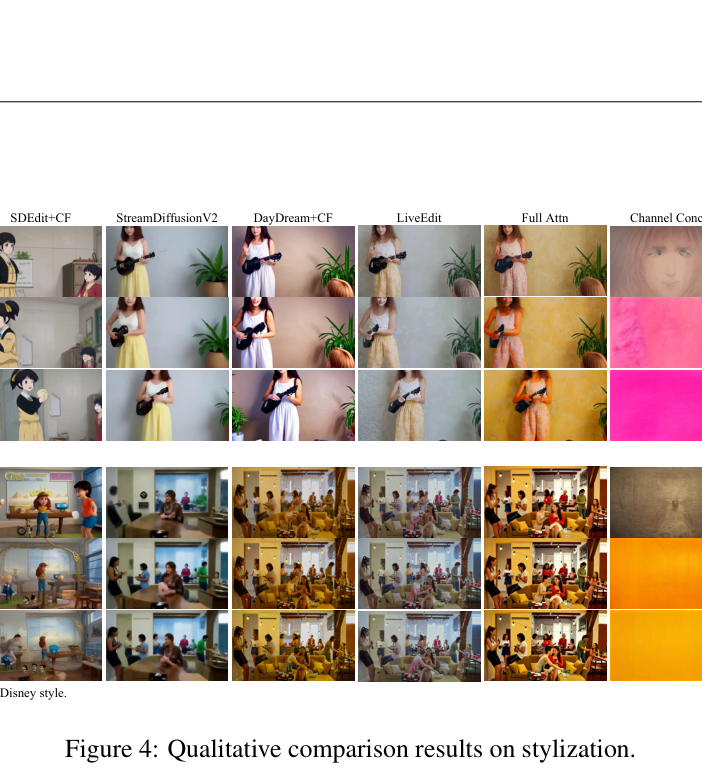
可见列从 SDEdit+CF 到被切掉一截的 Channel Concat,提示包括动漫风吉他女孩和 Disney 风格客厅。SDEdit 明显改写内容,中间几列更像普通照片而不是目标风格,Full Attn 只带一点暖色,通道拼接则塌成粉色或橙色色块。必须注意:这张 PNG 在本文列出现之前就被裁切,看不到 SVEET(Ours)。本文结果要到下一张资产的网格里看,不能凭色块右侧的空白声称已经看见本文。
研究缺口
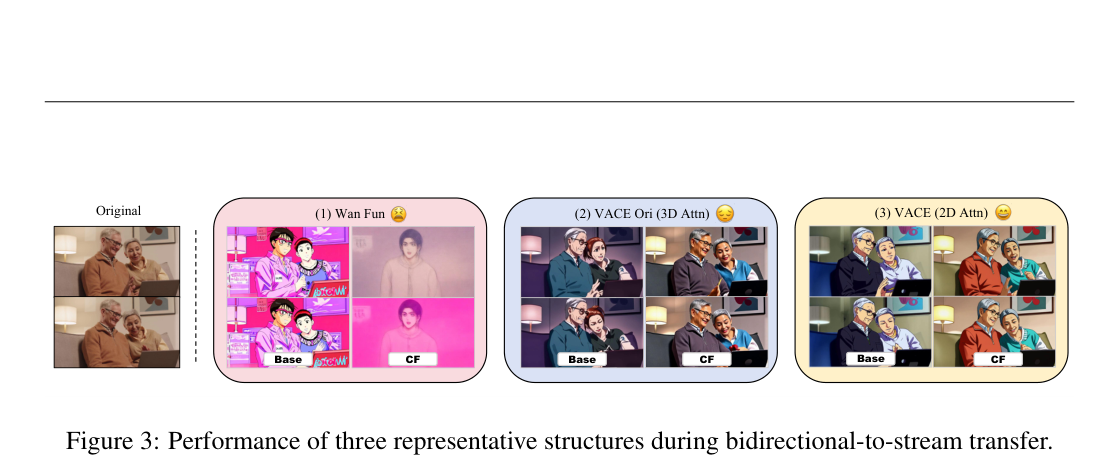
最左是两位老人的原视频帧。往右三组都标了 Base 与 CF:Wan Fun 变成无关卡通并铺满品红,两侧都失败;三维 VACE 还能看出老人的动漫化,但稳定性一般;二维 VACE 在两侧都更干净地保住人物和室内。表情符号只是图作者的定性标记。这张图支持“改骨干会迁坏、全时空注意力只迁一部分、逐帧二维注意力更适合流式”的对照,不要把某一格的颜色饱和度当成定量分数。
方法贡献
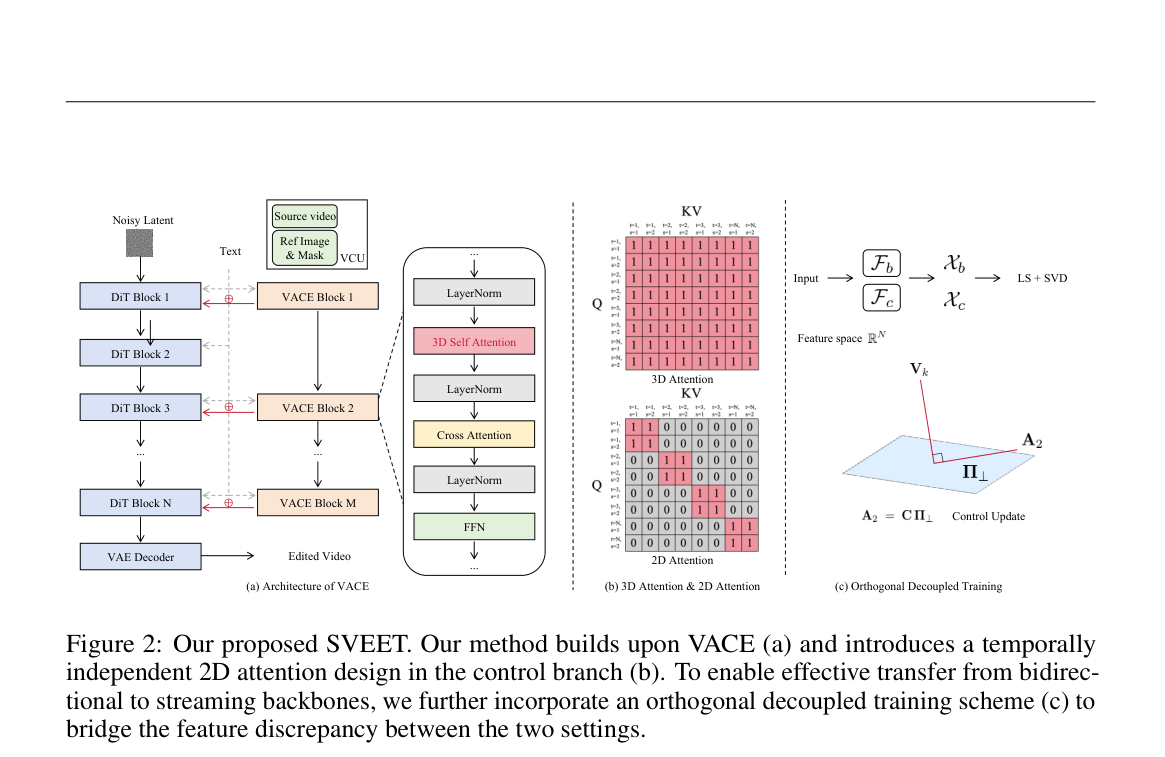
从左到右是三块设计。左侧 VACE 架构里,冻结的 DiT 栈接收噪声潜变量,VCU 编码源视频、参考图和掩码,控制块通过红色加号注入。中间对比全 1 的三维注意力矩阵和按帧分块的二维矩阵。右侧把双向骨干 Fb 与因果骨干 Fc 的特征送进最小二乘加 SVD,控制更新贴在正交补平面上。读图时先看注入是否绕开骨干,再看二维掩码为何能逐帧独立,最后看正交约束在限制哪一个方向。
实验观察
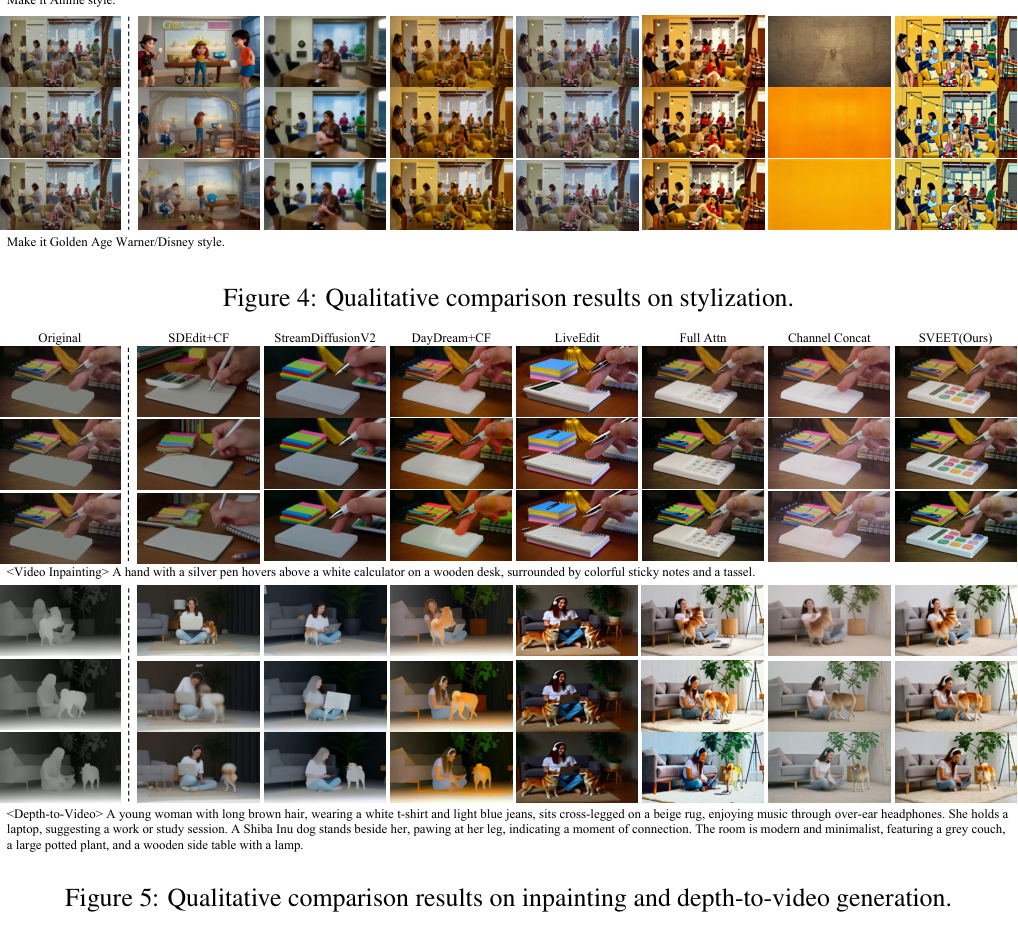
画面上沿其实是 Figure 4 的 Disney 风格行尾巴和图注,不要把它算进 Figure 5。图注下方才是补全和深度两行,列从 Original 到 SVEET(Ours)。补全任务里,若干基线把计算器、便签和手洗掉或只留淡影,最右列仍能看见笔、计算器和彩色便签。深度行的原图是灰度几何,本文列更稳定地保持女生、耳机、笔记本电脑和柴犬的相对位置。这是结构保持的定性证据,单帧观感不能代替 Table 1 的数据集均值。
实验如何设计?
- 任务与数据:风格迁移从 Ditto 采样,补全和 depth-to-video 从 VPData 采样,深度图用 Video-Depth-Anything 提取。每任务约 6K–13K 条训练视频。测试集为 Ditto 留出的 120 对风格视频,以及 VPData 上补全、深度各 80 条(第6页)。
- 外部基线:SDEdit 接到 Causal Forcing、StreamDiffusionV2、Daydream+CF、LiveEdit。作者指出开源实时视频编辑模型仍然很少。
- 受控基线与本文共享总管线:Full-Attn 保留控制分支的全时空注意力;Channel-Concat 取消控制分支,改为把源潜变量和噪声潜变量在通道上拼接(第6–7页)。
- 自动指标分三路。GPT-4o 按 1–10 分评指令忠实和视觉连贯;CLIP-T 用 CLIP ViT-L/14 计算编辑提示与抽帧的余弦相似度;VBench 取主体一致性、背景一致性、时间闪烁、运动平滑、美学质量和整体一致性。另有 10 名参与者对 15 条视频打编辑正确性、结构保持和运动平滑(第7页)。
- 消融先交叉二维/三维注意力与有无 ODT,再比较推理期投影和两阶段 teacher forcing。秩选择比较固定 k=32、64、128 与保留 60% 或 80% 谱能量的自适应策略(第8–9页)。
关键结果与论文证据
- Table 1 风格迁移(第7页):Ours 的 VLM 编辑分 7.4322,高于 LiveEdit 5.8672、三维 VACE 注意力 7.0653 和通道拼接 1.8902;CLIP-T 0.2287,主体一致性 0.9447,背景一致性 0.9298,美学 0.5550。通道拼接的整体一致性 0.1229 略高于 Ours 的 0.1123,不能把“每一列都第一”当成表意。
- 补全:Ours VLM 8.4667,LiveEdit 7.7833,三维注意力 8.0583,通道拼接 6.8913;主体一致性 0.9653。美学分 Ours 0.5297,低于 LiveEdit 的 0.5498 和 SDEdit+CF 的 0.5496。Depth-to-video:Ours VLM 8.4083,明显高于 DayDream+CF 的 7.1502 和三维注意力的 5.7484;运动平滑 0.9882,低于 SDV2 的 0.9961(第7页)。
- Figure 4 的可见列是 SDEdit+CF、StreamDiffusionV2、DayDream+CF、LiveEdit、Full Attn,以及被裁切的 Channel Concat。动漫与 Disney 风格提示下,前几列常常把人物和客厅改成另一种照片或卡通,最右侧色块则是通道拼接失败。这张 PNG 没有 SVEET 列(第8页)。Figure 5 才在最右列给出 SVEET:补全保住便签与计算器,深度行保住女生与柴犬的相对关系(第8页)。
- Figure 3:Wan Fun 在 Base 与 CF 两侧都严重崩坏;三维 VACE 能留下部分风格但时序不稳;二维注意力变体在两侧都更可靠。这是原则的定性证据,表情符号不是分数(第4页)。
- Table 2 消融(第9页):仅换二维注意力(2D w/o ODT)VLM 从 7.0653 升到 7.1898;只加 ODT 的三维版本到 7.3315;二者合用 7.4322,运动平滑 0.9898,为表中最高。推理期投影掉到 6.4250,说明事后投影会伤结构。两阶段 teacher forcing 为 7.0927,仍低于合用方案,而且要额外适配流式骨干。
- 用户研究(第9页,Table 3):Ours 编辑正确性 9.0800、结构保持 9.2067、平滑 8.1133。DayDream+CF 为 7.8533 / 8.6200 / 7.9533,结构分已不低,但编辑正确性仍落后。SDEdit+CF 的结构保持只有 2.8133,和定性图里内容被改写一致。自适应谱能量 80% 优于固定秩,固定小秩相对直接迁移只有边际收益(Figure 7,第9页)。
阅读时需要注意
- 结论部分写明:方法仍然依赖底层双向编辑模型的能力。双向分支覆盖不到的指令,流式迁移不会凭空补上。
- 主文定量集中在风格、补全和 depth-to-video。首页示意图还展示了增强和上色,但它们不在 Table 1 的三任务协议里。
- 差异子空间是线性岭回归加 SVD 的主方向,且按层用谱能量截断。更异构的骨干若特征差不能由少数奇异方向概括,正交约束的收益会下降。作者把更广任务和更异构骨干列为后续工作(第9页)。
关联工作
- 早期视频编辑把图像扩散加上时间模块或注意力传播;近期工作改用统一条件架构做多任务编辑,但绝大多数仍是双向全序列,服务不了实时流(第3页)。
- 实时视频生成分因果自回归,以及一致性模型、蒸馏等推理加速。把自回归和扩散蒸馏合在一起可以缩小训推差距,目标仍是生成而不是编辑,而且通常要重训流式骨干。SVEET 把“编辑学习”留在双向侧(第3页)。
- 理论动机来自模型合并与可组合扩散:两个功能更新若在主奇异子空间上重叠,非线性耦合会破坏输出可加性。ODT 用正交投影压低这种耦合,而不是再蒸馏一个学生模型(第5–6页)。