快速导读:SparkDiffusion 把高稀疏下的终端失败定位到高噪声结构误差,再用短热身、轨迹混合蒸馏和 FP8 融合核把极高稀疏变成实测加速。
视频扩散 Transformer 把长时空序列的注意力做成每一步的主成本。稀疏注意力可以少算查询键块,但推到极高稀疏时,逐步验证损失还在下降,终稿却结构断裂、语义漂移、出现马赛克和闪烁。北大、清华与阿里等提出的 SparkDiffusion 把这种现象叫做高稀疏陷阱,并认为它是监督问题:主要误差注入在高噪声的结构生成阶段,终端对齐的后训练能纠正继续加长逐步训练也纠不了的终稿误差。项目页为 https://sparkdiffusion.github.io/ ,代码为 https://github.com/AlibabaResearch/SparkDiffusion 。
框架分三期,都不从头训练稠密骨干。短稀疏热身把补偿稀疏模块接进 Wan2.1 或 Wan2.2,得到粗先验;轨迹混合蒸馏在高噪声做一致性、在低噪声做分布匹配,学生默认只走三步且不用分类器无关引导;部署时把线性层收成 FP8 并融合核。作者报告 Wan2.1-T2V-14B-720P 在单张 RTX 5090 上相对 50 步带引导的稠密基线达到 265×,H100 为 220×;Wan2.1-T2V-1.3B-480P 在 90% 稀疏下 5090 时延 1.3 秒。这些倍数是全栈相对长采样基线,不是稀疏一项的加速。
英文题目:SparkDiffusion: Mitigating the High-Sparsity Trap — A Unified Framework for up to 265× Single-GPU Acceleration of Visual Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.23153
原始论文:PDF / 论文页面
这篇论文解决什么问题?
块稀疏把注意力矩阵切成查询键块,稀疏率是稀疏支路不算的块比例。补偿稀疏注意力写成稀疏支路加上门控的低秩或线性支路:高能量块保留语义交互,补偿支路补被丢掉的全局背景。RoLA、VSA 和 SLA 都在保留块上做精确 softmax,差别主要在补偿。论文说这种结构原则上可以超过 90% 稀疏,因为视频注意力本身像稀疏加低秩。
从 90% 提到 97%,保留块从一成降到约 3%,稀疏支路的块计算大约只剩 90% 时的三成。在已经是三步推理的 Wan2.1-T2V-14B-720P 上,这一步把 H100 从 10.5 秒降到 8.0 秒,RTX 5090 从 23.7 秒降到 18.0 秒,大约再快 1.31 到 1.32 倍。前提是画质还在。作者观察到模型可以逐步损失收敛、推理也快,终稿仍坏。
流匹配在插值 xt=(1-t)x0+tε 上回归速度 ε-x0。它监督的是单个噪声水平,终稿要等许多步合成之后才出现。稠密模型的逐步残差通常小,间接监督就够;极高稀疏的误差更大,而且集中在高噪声,于是逐步损失和终端分布可以同时一个变好、一个变差。
中心问题因此是:视觉生成器能不能在 90% 以上注意力稀疏下保住质量,并把这种稀疏换成测得到的墙钟加速。Figure 6 给出可见失败,Figure 4 把误差定位到高噪声。
核心创新
- 诊断高稀疏陷阱:极端稀疏下逐步损失与终端质量脱钩,误差主要注入在高噪声结构阶段。
- 分期原则:先短热身适应稀疏架构,再用轨迹混合蒸馏对齐终端分布。
- 把少步、极高稀疏和 FP8 融合核连成可测的单卡墙钟加速,而不是只报 FLOPs。
方法概览
三期。Stage 1 短稀疏热身:把 RoLA 式补偿稀疏插入稠密检查点,只用逐步流匹配或教师速度回归,得到粗先验。Stage 2 轨迹混合蒸馏:冻结稠密多步教师,按 CrossDistill 在交叉点切开,高噪声用 PCM 守结构、运动和多样性,低噪声用 DMD 修正终端;默认三步学生(一步 PCM、两步 DMD)。Stage 3 部署:注意力与前馈线性层做 W8A8 FP8(E4M3),权重量化离线逐通道,激活逐 token 动态缩放并融进单核;归一化、门控和稀疏掩码选择留在 BF16。Wan2.2 的专家组按各自噪声区间分别热身和蒸馏。
- 高稀疏陷阱的操作定义有三条:逐步验证损失已经平台或继续下降;终端质量或配对终端误差明显差于稠密或较低稀疏;再把逐步训练拉长也救不回终稿。终端误差是同一初始噪声下稀疏与稠密终稿的潜空间 MSE,两边都用 50 步、CFG 尺度 5.0,从而不把去掉引导或减少步数算进稀疏误差。
- Figure 4 的预言实验:固定初始噪声,只在一段噪声区间用稠密教师的速度替换学生。97% 稀疏下,修最高噪声的五步能去掉大部分终端误差,等预算去修最低噪声几乎不动;更宽的二十八步高噪声窗几乎补回全部。图上 97% 处等预算差距标为终端 NMSE 约 3.4 倍,时间一致性 +0.033,审美分 +0.020。Table 1 在一万步逐步训练后把补偿从 rank-64 加到 r=128,终端误差只从 0.124 到 0.121,VBench 从 80.92 到 81.05,说明不是补偿秩不够。
- Stage 1 只做短热身。补偿模块插进稠密检查点,用逐步目标或教师速度回归微调。低秩支路对归一化后的查询和键做低秩投影、SiLU,再用预训练三维旋转位置编码的前 r 个坐标,复杂度对序列长度线性。门控初始接近零,输出是稀疏支路加上按稀疏输出均方根缩放的补偿。Figure 10 用来说明热身不用很长。生产热身大约二百五十步,诊断实验故意拉到一万步仍掉进陷阱。
- Stage 2 采用 CrossDistill 的轨迹混合。交叉点之前的高噪声用 PCM 式一致性,守结构、运动和多样性;之后的低噪声用 DMD 式分布匹配,修终端可见误差。默认学生三步:一步高噪声 PCM,两步低噪声 DMD。纯 PCM 跟得上教师轨迹但对不齐终稿;纯 DMD 对齐终稿但更模式寻求。Table 4 在同一热身检查点上,PCM-only 的 VBench / VBench-2.0 为 81.94 / 56.41,DMD-only 为 82.56 / 57.38,CrossDistill 为 83.15 / 58.05。
- Stage 3 在训练结束后做 W8A8 FP8(E4M3)。权重离线逐通道静态尺度,激活运行时逐 token 动态尺度,这条路径融进单核。归一化、门控和稀疏掩码选择留在 BF16。少步采样下量化误差不太有机会累积。Table 2 和 Table 3 的 SparkDiffusion 数字都是在 FP8 加融合核的部署模型上测的。附录写相对 BF16 的 VBench 变化不超过 0.1,Table 5 的正文表述是最多 0.07。
- Wan2.2 这类混合专家按噪声区间分组,每组先在自己的噪声范围热身和蒸馏再量化。自回归视频被写成兼容:补偿稀疏可限制在因果窗,轨迹混合蒸馏作用在噪声轴而不是时间轴,可与 self-forcing 同用。这不是主实验。附录 C 的几何只说明简化代理里,终端对齐抵消的是误差在终稿上的投影,逐步残差甚至会变大;它不是 VBench 上的定理。
逐图理解论文
失败直觉
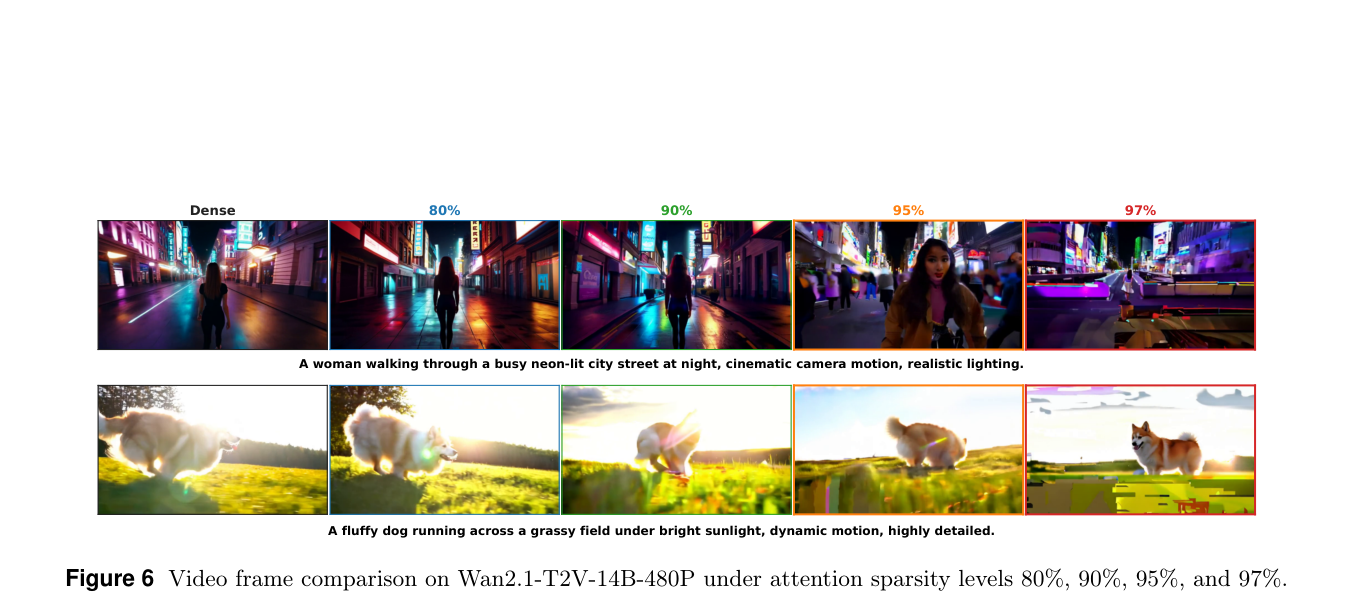
两行提示、五列稀疏,都是逐步训练的 Wan2.1-T2V-14B-480P,不是蒸馏后的成片。80% 和 90% 仍接近左边的稠密帧;95% 的夜街换成近景,狗的运动模糊加重;97% 红框里街景马赛克、狗的轮廓闪断。用它理解陷阱长什么样,最终质量以 Table 2 和 Figure 8 为准。
研究缺口
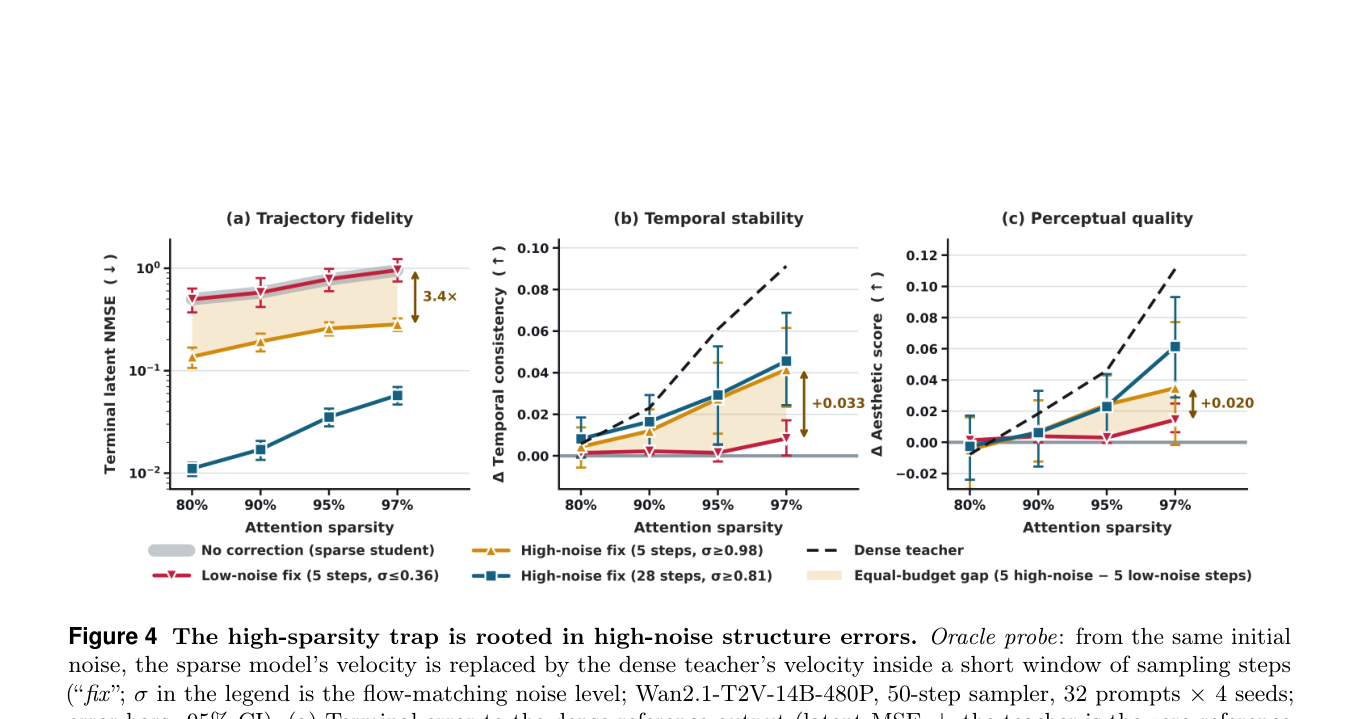
三张图的横轴都是 80% 到 97% 稀疏。先看 (a) 在 97% 的米色带 3.4×:五步高噪声修正比五步低噪声修正去掉更多终端潜空间误差。(b)(c) 的 +0.033 与 +0.020 说明时间稳定性和审美分方向一致,黑虚线是稠密教师。这是带 CFG 的 50 步预言实验,不是 265× 的测时。
方法贡献
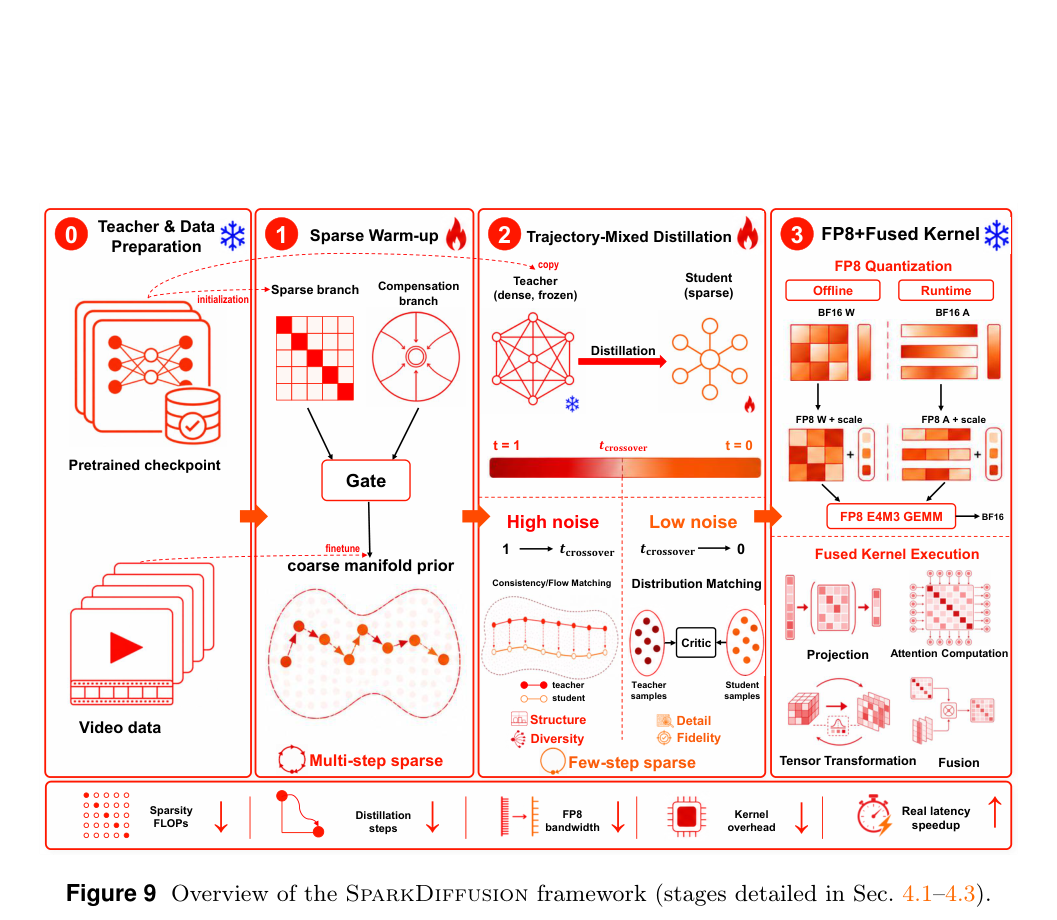
这是方案图,从左到右是数据与教师、稀疏热身、轨迹混合蒸馏、FP8 融合核。栏 2 的色条把高噪声一致性与低噪声分布匹配切开,对应高噪声守结构与多样性、低噪声守细节。底栏里只有实测时延向上,算力、步数、带宽和核开销向下。图中没有新的秒数,倍数要看 Figure 2 和 Figure 3。
关键结论
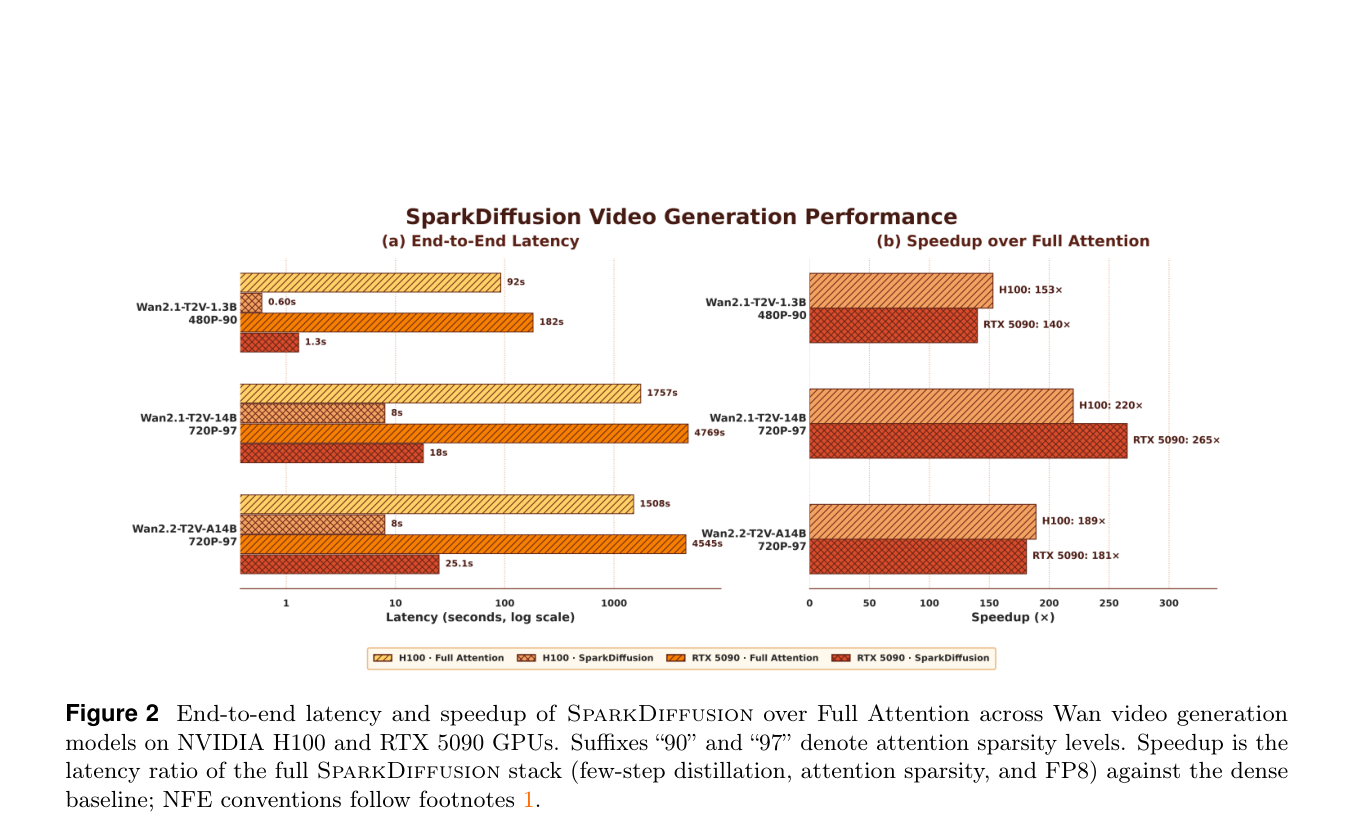
左图是对数时延,右图是相对稠密注意力的倍数。14B-720P-97% 在 5090 上标 18 秒对 4769 秒、265×,在 H100 上标 8 秒对 1757 秒、220×。1.3B 的 1.3 秒和 0.60 秒是 90% 稀疏的另一行;Wan2.2 在 5090 上是 25.1 秒、181×,不要读成也是 8 秒。图注写明这是少步、稀疏和 FP8 的全栈比。
实验如何设计?
- 稠密 Full Attention 用 50 步 CFG,即每步两次前向,NFE=100,BF16;H100 用 FlashAttention-3,RTX 5090 用 FlashAttention-2。所有加速结果是无 CFG 的三步,NFE=3。速度比按这个口径计算。
- Table 2 评 Wan2.1-T2V-1.3B 的 480×832,以及 Wan2.1-T2V-14B 与 Wan2.2-T2V-A14B 的 720×1280,都是 81 帧。基线 FastWan(VSA)和 TurboDiffusion 用官方发布点,主要是 90% 稀疏;SparkDiffusion 同时报 90% 和 97%。二者没有 Wan2.2 官方权重,所以该骨干不列它们。
- Figure 2 是全栈时延和加速。第 5.1 节写明这些扩散生成时延不含文本编码和 VAE 解码。Figure 3 把 5090 上 14B-720P 从 4769 秒拆到 18.075 秒。
- 多样性 Table 3:一千条提示、每条五个种子,用冻结的 V-JEPA 2 和 VideoMAE V2 算平均成对余弦与 ℓ2,稠密模型作参照。定性图覆盖 1.3B/14B、480P/720P、T2V/I2V 和 Wan2.2,加速模型都是三步。
关键结果与论文证据
- Figure 2(第 2 页):Wan2.1-T2V-14B-720P-97% 在 RTX 5090 上 18 秒对稠密 4769 秒,标 265×;H100 上 8 秒对 1757 秒,标 220×。Wan2.1-T2V-1.3B-480P-90% 为 5090 上 1.3 秒对 182 秒(140×)、H100 上 0.60 秒对 92 秒(153×)。Wan2.2-T2V-A14B-720P-97% 为 5090 上 25.1 秒对 4545 秒(181×)、H100 上 8 秒对 1508 秒(189×)。摘要里的 1.3 秒和 265× 不是同一个模型。
- Figure 3(第 2 页)瀑布:4769 秒,加 RoLA 97% 与融合 Triton 到 1463.27 秒(3.3×),加 CrossDistill 到 43.942 秒(33.3×),加 FP8 GEMM 到 25.848 秒(1.7×),去掉 CPU offload 到 23.498 秒(1.1×),再 torch.compile 到 18.075 秒(1.3×),总弧 265×。最大的一段是少步蒸馏,不是稀疏。正文另说,在已经三步的设置里,90% 到 97% 只再快约 1.31–1.32 倍。
- Table 2(第 10 页),Wan2.1-T2V-14B:稠密 VBench 83.69、VBench-2.0 60.20;SparkDiffusion 90% 为 83.42 / 59.36,时延 23.7 秒与 10.5 秒;97% 为 83.15 / 58.05,时延 18.0 秒与 8.0 秒。同为 90% 的 TurboDiffusion 是 82.88 / 57.98、25.3 秒与 16.0 秒,FastWan 是 82.72 / 58.04、54.1 秒与 20.5 秒。97% 的 SparkDiffusion 在聚合质量上略高于这些 90% 基线,同时时延更低,但仍低于稠密,尤其是 VBench-2.0 的 58.05 对 60.20。
- 1.3B 上 SparkDiffusion 90% 的 VBench 82.64、VBench-2.0 55.85,相对稠密 83.21 / 56.02 略低,但 5090 时延 1.3 秒、H100 0.6 秒,作者称比两个基线快约 1.5 到 2.2 倍且 VBench-2.0 更好。Wan2.2-A14B 在 97% 为 VBench 83.36、VBench-2.0 58.46,稠密是 84.21 / 60.36;5090 的 25.1 秒含高低噪声专家在显存间切换的开销,H100 上两组专家同时驻留,时延 8 秒。
- Table 3(第 11 页),V-JEPA 2 平均成对余弦:稠密 0.125,SparkDiffusion 97% 为 0.087,TurboDiffusion 0.078,FastWan 0.075。加速模型里它最接近稠密,但多样性仍然下降,和分布匹配的模式寻求一致。Table 4 说明任一终端对齐目标都能挽回 97% 的大部分质量,混合目标在保真和多样性之间最好。
- Figure 6(第 6 页)应读成陷阱现象而不是最终成绩:80% 和 90% 的夜街与奔跑小狗仍接近稠密,95% 开始换景别或加重模糊,97% 红框里出现马赛克和闪烁。Figure 4 说明把教师速度只补进高噪声窗就能压终端误差。不要把 Table 1 那些约 81 分的逐步训练 VBench 和 Table 2 的 83.15 混为一谈。
阅读时需要注意
- 265× 的分母是 50 步 CFG 稠密模型(NFE=100),分子是 3 步无 CFG 的 FP8 稀疏栈(NFE=3)。同一步数下,90% 提到 97% 只有大约 1.3 倍。
- Figure 2 和 Figure 3 的时延按第 5.1 节不含文本编码和 VAE 解码。摘要使用 end-to-end 一词,读数时要分开。
- 97% 仍略逊稠密画质和种子多样性。附录只证明简化代理,不能当成 VBench 或某条蒸馏损失的保证。
- Wan2.2 缺少 FastWan 与 TurboDiffusion 的官方对照。自回归和全模态生成是作者列出的后续,不是本文结果。预印本未经同行评审。
关联工作
- RoLA 是默认稀疏模块。附录 D 在 VSA 和 SLA 风格上复现同样的陷阱,并称 Stage 2 能在两种选择器上恢复终端质量,用来论证陷阱来自逐步监督而不是某一种稀疏设计。
- CrossDistill 提供高噪声 PCM、低噪声 DMD 的切分。PCM 与 DMD 的单目标消融在 Table 4。
- FastWan(VSA)和 TurboDiffusion 是 Table 2 的少步稀疏基线,官方工作点是 90%。作者认为若把它们训到 97%,按 Figure 6 的单调变差只会更不利于基线;这个论证依赖单调性,不是把基线重新训过。
- Wan2.1 与 Wan2.2 是被加速的稠密检查点。流匹配是逐步监督的来源。