快速导读:RegVGGT 冻结 StreamVGGT,按层按头只把最显著的约 1% 新令牌写进记忆,用 FlashAttention 的对数配分打分,从而在长视频流上少涨显存又少忘几何。
前馈重建模型可以用一次注意力把图像变成点图、深度和相机位姿,但离线做法每来一帧都要重算全部历史,长视频流不现实。改成时序因果注意力之后,历史键值可以留在缓存里,新的麻烦变成记忆要么涨到溢出,要么为了封顶而忘掉早期几何。哈尔滨工业大学的 RegVGGT 认为,一个令牌刚进入流时的显著性,大体就能决定它以后还重不重要,因此可以在线、且非常狠地调控每帧写进记忆的令牌。代码在 https://github.com/amao996/RegVGGT 。arXiv 评论行标明 ECCV 2026。
方法训练免费:冻住 StreamVGGT 的结构和权重,只改推理时的令牌调控。第一帧键值当全局锚点永久保留。查询无关的层之后不再写入中间历史;查询特异的层按头只保留最显著的大约 1% 新令牌。打分使用 FlashAttention 已经缓存的 log-sum-exp,不必把注意力矩阵展开。作者在对齐令牌预算后,报告长序列位姿、深度和重建优于固定预算的流式基线,并在很短的序列上相对未压缩骨干几乎不增加轨迹误差。
英文题目:RegVGGT: Sustainable Visual Geometry Grounding for Streaming via Regulated Memory
论文出处:arXiv 每日论文精选 · arXiv:2609.23286
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VGGT 用全局自注意力在一次前向里预测几何,省掉了 DUSt3R、MASt3R 那种两两点图之后的全局对齐,但显存随视角数平方增长,也强迫新帧到来时重跑历史。流式改造把全局注意力换成时序因果注意力:第 t 帧的查询只对历史加当前的键值做注意力,历史键值放进 KV 缓存。这样不用重算旧帧,缓存本身却随帧数线性膨胀,长视野仍然不可持续。
已有记忆库分成两类。隐式做法把历史压进紧凑状态,例如 Figure 1 里的 CUT3R,省显存,但帧数一长就灾难性遗忘。显式做法如 Evict3R 规定固定预算再决定驱逐谁,可是预算要靠场景尺度的隐含先验:小场景浪费,大场景不够,结果同样忘上下文。无界显式缓存则以 StreamVGGT 为代表,完整保留历史 KV,直到内存溢出。
RegVGGT 要同时避开这三件事:不重算全历史,不把记忆封成一个与场景尺度绑死的常数,也不把将来仍显著的令牌提前扔掉。作者的赌注是显著性在时间上足够稳,当前帧的注意力就足以决定该留谁。
因此中心问题不是再设计一个重建头,而是:在冻结的前馈流式骨干上,能不能用极低的每帧写入率维持几何上下文。Figure 1 把四种范式画在一起,Figure 2 提供留谁的证据。
核心创新
- 用注意力图说明初始显著性对后续帧大体稳定,因此可以在线决定留谁。
- 按层切开记忆:查询无关层只留首帧,查询特异层按头保留极少显著令牌。
- 用 LSE 在 FlashAttention 里恢复打分,避免为了剪枝把注意力矩阵展开。
方法概览
观察是:令牌进入流时的显著性大体决定它以后还重不重要;早期和后期层更查询无关,中间层稀疏且呈对角;同一层不同头不一样。于是第一帧键值做全局锚点,所有层永久保留。Lqa(第 1–10 与 18–24 层)之后不再写入中间历史。Lqs(第 11–17 层)在锚点之外按头保留 top-k,k 为 γ 乘每帧令牌数再下取整,默认 γ=0.01。显著性用当前帧 2×2 窗口左上查询,靠 FlashAttention 已缓存的 LSE 还原分数,不物化整图。记忆规模是首帧加上之后每帧固定的少量令牌,随帧数线性慢涨,不是硬封顶。
- 观察一来自 ScanNet 上步长 100 的因果注意力。Figure 2(b) 把同一键收到的注意力加起来,高响应停在该令牌自己的源帧附近,之后很少突然变重要。观察二把层分成两类:Layer 4 和 Layer 21 这类早期、后期层沿列几乎不挑查询,记为 Lqa;Layer 13 和 Layer 15 这类中间层稀疏、呈对角,记为 Lqs。观察三是同一层里 Head 1、5、9、12 的图案不同,所以不能先把多头平均再剪。
- 全局锚点:VGGT 一类模型用第一帧建立后续帧对齐的坐标系。所有层都永久保留第一帧的完整键值。Table 3 在相同总令牌预算下去掉锚点,ATE 从 0.165 升到 0.175,RPE rot 从 3.930 升到 4.005。
- 按层分配写进配置:24 层里第 1–10 层和第 18–24 层是 Lqa,第 11–17 层是 Lqs。Lqa 在记住第一帧之后,后续帧的键值禁止写入。Lqs 在锚点之外,每帧只追加 top-k,k 等于 γ 乘该帧令牌数再下取整。默认 γ=0.01。记忆大小因此是首帧令牌数加上之后每帧大约 1% ,随 t 线性慢涨,不是 |M|≤B 的硬帽。作者把这叫丢掉大约四分之三层的中间历史;按层号数是 17/24。
- 按头保留:Lqs 里每个头单独算显著性、单独维护记忆,避免多头平均互相淹没。为了少算,当前帧查询按 2×2 不重叠窗口只取左上角,再用这些查询对当前帧的键累加注意力,取得分最高的 k 个。Table 4 里按头保留把额外延迟从 17.66 ms 降到 8.29 ms,ATE 仍是 0.165。Table 6 里 2×2 相对 1×1 同样大约省一半延迟,ATE 从 0.165 几乎不动;3×3 和 4×4 再快有限,RPE rot 变差。
- LSE-Saliency:FlashAttention 前向时为每个查询缓存 log-sum-exp 归一化项。作者用这个统计量把当前查询对当前帧键的精确注意力分数还原出来,避免构造 O(N·|历史|) 的完整注意力矩阵。正文把这写成与 FlashAttention 兼容的在线打分,而不是改写注意力本身的输出。
- 这些超参在主实验里跨数据集固定。另有一组星号实现采用 FastVGGT,丢掉后续模块用不到的 20 层中间特征。公平对照不是各基线论文的原始预算,而是先数出 RegVGGT 在该长度下保留多少令牌,再把 Evict3R、InfiniteVGGT、XStreamVGGT 的预算设成同一个数。
逐图理解论文
失败直觉
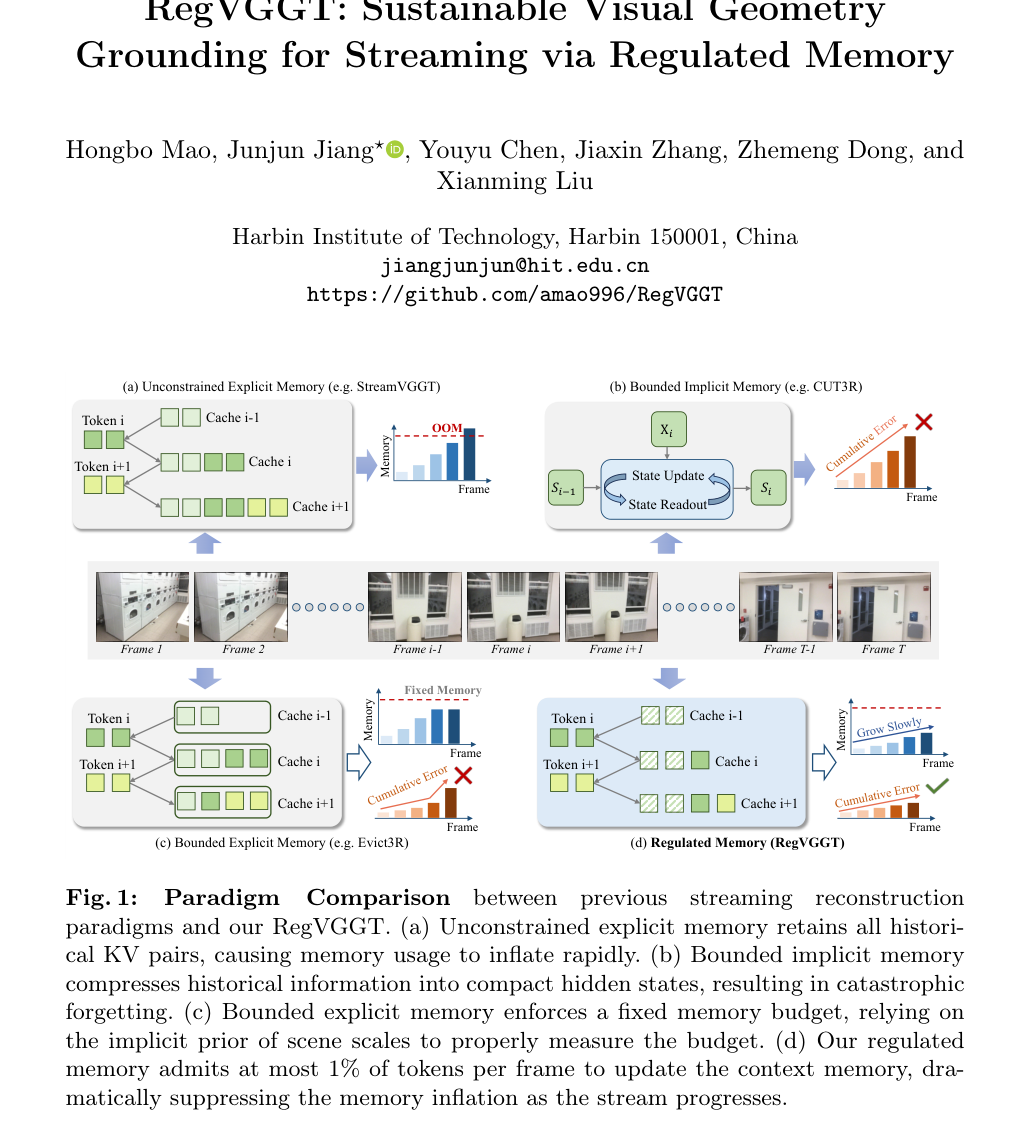
先跳过题目和作者。四格分别是无界显式缓存、隐状态、固定预算和本文调控,前三格走到 OOM 或红叉,调控记忆停在慢涨虚线以下并打绿勾。绿勾是示意,图注里的最多 1% 是每帧新写入,不是历史总量。记忆柱仍然在上升,不要读成水平封顶。
研究缺口
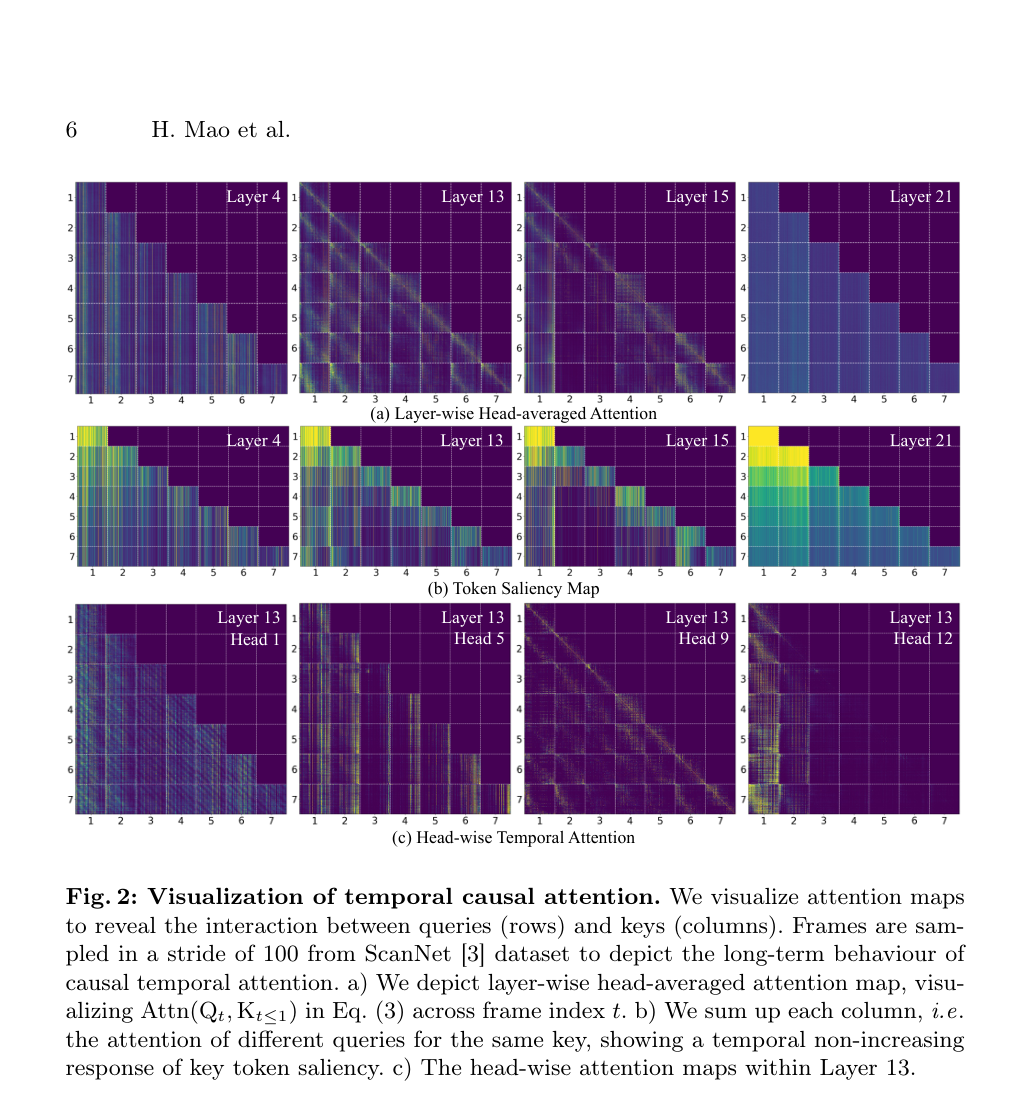
三行都是 ScanNet 步长 100 的七个时间位置。(a) 里 Layer 4 和 Layer 21 整列较匀,Layer 13 和 Layer 15 沿对角更稀疏;(b) 的亮区集中在早期键。(c) 同一 Layer 13 的四个头图案不同,所以打分必须按头。没有色标,不要读出精确注意力值。
方法贡献
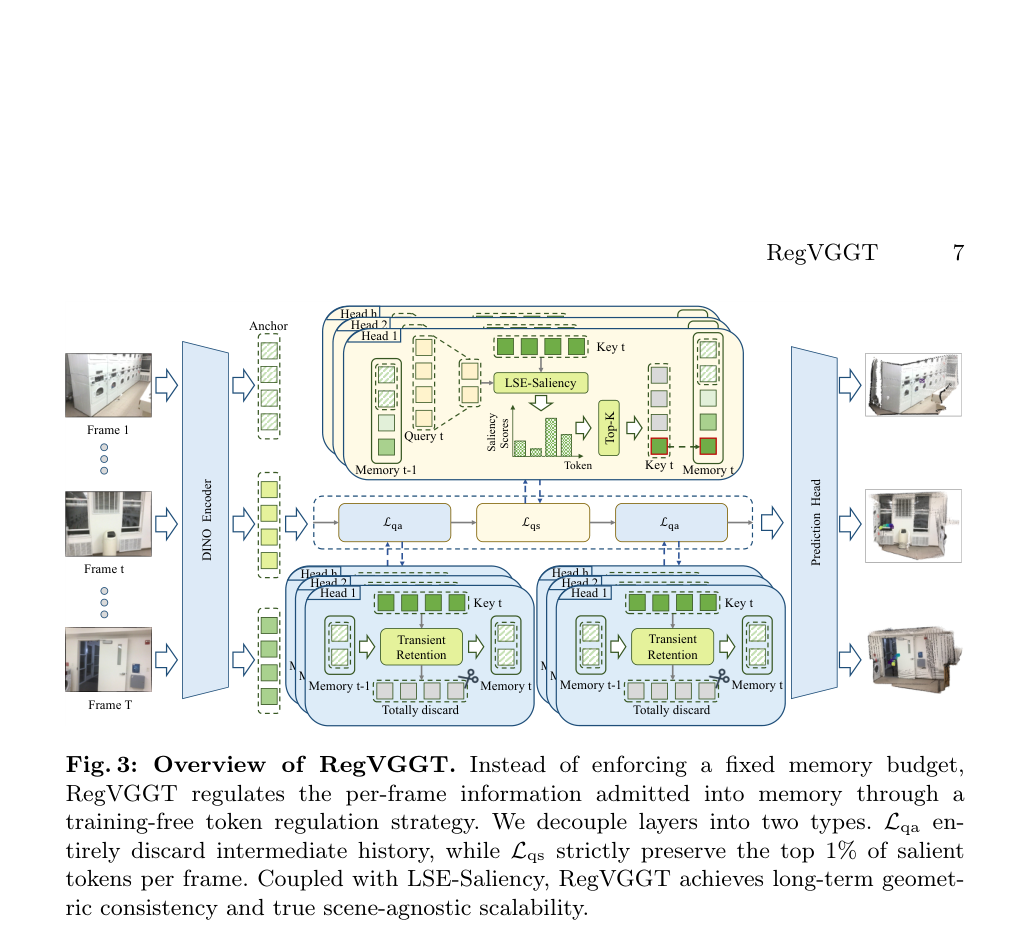
这是方案图:左帧进 DINO,右端是预测头。上半黄框按头做 LSE-Saliency 和 Top-K,只把少数键写入新记忆;下半蓝框的 Totally discard 对应查询无关层不再保存后续帧的中间历史。中带的 Lqa、Lqs、Lqa 就是第 1–10 层、第 11–17 层和第 18–24 层。不要把 Totally discard 理解成连第一帧锚点一起丢。
关键结论
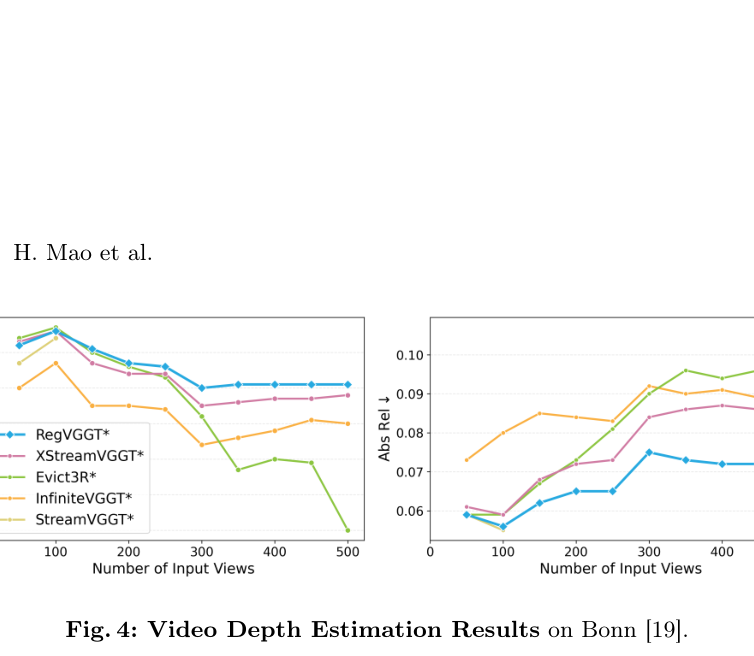
右图纵轴写着 Abs Rel,长序列上蓝线 RegVGGT 最低,短序列与绿线 Evict3R 接近。左图纵轴被裁掉,只能看见约 500 帧处 Evict3R 和 StreamVGGT 骤降、RegVGGT 较平。正文说配对指标含 δ<1.25,但不要替左轴补名字或补精确百分数。五条线都是星号设置。
实验如何设计?
- 任务是相机位姿、视频深度和三维重建,强调长序列。位姿用 TUM Dynamics 与 ScanNet,指标 ATE、RPE trans、RPE rot。TUM 取每条序列开头,ScanNet 时间步长 3,长度从 50 到 1000 帧。Table 1 列出 800、900、1000 帧。
- 重建用 7-Scenes 与 NRGBD,按 CUT3R 协议,时间步长 2,取前 50 到 300 帧,指标是准确度、完整度和法向一致性的均值与中位数。Table 2 给出 200、250、300 帧。
- 深度用 Bonn。丢掉每条序列前 30 帧后,取 50 到 500 帧的连续子序列,指标是 Abs Rel 和 δ<1.25。Figure 4 画的是随视点数变化的曲线。全部默认实验在一张 RTX 3090 24GB 上。
- 消融在 ScanNet 上看锚点、按层分配和按头保留,并扫描 γ、层切分比例和查询下采样。Figure 7 把未压缩 StreamVGGT 与 RegVGGT 比 ATE,但长度只到 5–40 帧。Table 8 用大约每百帧抽一帧模拟大运动。Table 9 在 Layer 13 上计算令牌显著性相对第 10 帧的 Spearman 相关。
关键结果与论文证据
- Table 1(第 10 页),1000 帧:RegVGGT 在 TUM 上 ATE 0.135、RPE trans 0.016、RPE rot 1.431,ScanNet 上 ATE 0.997、RPE trans 0.072、RPE rot 6.656。同长度 XStreamVGGT 为 TUM 0.174/0.027/1.866、ScanNet 1.054/0.090/11.182;Evict3R 为 TUM 0.174/0.027/2.004、ScanNet 1.114/0.101/15.333;InfiniteVGGT 的 ScanNet ATE 为 1.061、RPE rot 11.622。800 帧时 RegVGGT 的 TUM ATE 是 0.109,仍低于 XStreamVGGT 的 0.121 和 Evict3R 的 0.162。帧数从 800 增到 1000,RegVGGT 的涨幅小于固定预算方法。这些对比发生在作者对齐后的相同令牌数上。
- Table 2(第 11 页),7-Scenes 平均准确度:200 帧 RegVGGT 0.036,低于 InfiniteVGGT 的 0.067、XStreamVGGT 的 0.075 和 Evict3R 的 0.106;300 帧时 RegVGGT 为 0.038,Evict3R 升到 0.163,XStreamVGGT 0.129,InfiniteVGGT 0.122。作者说 Evict3R 的平均准确度误差涨了五成以上。NRGBD 上 300 帧的平均准确度是 RegVGGT 0.068,对照 Evict3R 0.168、XStreamVGGT 0.102。完整度和法向一致性大多也是 RegVGGT 更好或接近,但不是每一格中位数都领先,例如 300 帧 NRGBD 的完整度中位数 RegVGGT 为 0.006,InfiniteVGGT 为 0.004。
- Figure 4(第 12 页)右图 Abs Rel:短序列上 RegVGGT 与 Evict3R 接近,视点数增加到数百后 RegVGGT 保持最低,其余方法升到大约 0.09 附近。左图纵轴被裁,只能看见 Evict3R 与 StreamVGGT 在约 500 帧处骤降,RegVGGT 较平。正文说左图对应的另一指标是 δ<1.25,但图上标签不可读,不要把目测高度写成精确百分比。
- Figure 7(第 14 页):5 到 40 帧上 RegVGGT 与未压缩 StreamVGGT 的 ATE 几乎重合,末端 RegVGGT 略高。这支持“每帧最多 1% 仍能留下关键几何”,但只覆盖短序列,因为全量缓存在长流上会涨爆。不能把它说成数千帧相对完整历史无损。
- 消融(第 12 页):去掉锚点或去掉按层分配,ATE 大约从 0.165 升到 0.175–0.176,旋转误差更明显,按层分配去掉后 RPE rot 到 4.970。按头保留几乎不改变 0.165 的 ATE,却把延迟从 17.66 ms 降到 8.29 ms。γ 低于 0.01 时精度掉得快、显存省得有限;超过 0.1 后几何收益变小、峰值显存继续涨。Figure 6 把默认切分定在前 10 层加后 7 层作为 Lqa。
- 迁移与边界:Table 7 把固定预算的 Evict3R 换成每帧调控,Bonn 上 400 帧 Abs Rel 从 0.073 到 0.071,500 帧从 0.076 到 0.069,δ<1.25 从 95.8 到 96 或 96.1,是小幅一致提升,不是另一个数量级。Table 8 大运动下 γ=0.01 的位姿 ATE 0.155,接近骨干的 0.159,但点图 CD 从 0.054 升到 0.099,NC 从 0.750 降到 0.731;γ=0.10 把 CD 收回 0.066。Table 9 里 Head 1 在 +90 帧仍有 Spearman 0.976,Head 12 降到 0.299,观察一要按头理解。
阅读时需要注意
- 上下文完整性实验最长 40 帧。作者关于消费级 GPU 上数千帧的说法,没有在同一张图里相对未压缩骨干验证。
- 默认 1% 假设相邻帧高度冗余。大运动、抽得很稀时,点图误差明显变差,需要把保留率放到 0.1。
- 层划分和 2×2 查询下采样绑在这条 24 层 StreamVGGT 上。Lqa 一旦丢弃中间历史,就只剩首帧锚点。
- 记忆仍然线性增长。与基线比的是匹配后的令牌数,不是把对方论文里的原始预算原样拿来。星号结果共用了 FastVGGT 的特征丢弃。
- 部分头的长期显著性相关衰减很快,不能把 Figure 2 的印象写成所有头都一样稳。
关联工作
- VGGT 把重建收成一次全局注意力;StreamVGGT 与 Stream3R 一类工作改成因果缓存,换来可在线、也换来无界显存。
- CUT3R、TTT3R 代表把历史压进状态或测试时训练的路线。Evict3R、InfiniteVGGT、XStreamVGGT 代表显式预算。RegVGGT 的主表对手是后三者,并在 Table 7 把调控插回 Evict3R。
- FlashAttention 使精确注意力图不可直接读取,所以 LSE 打分是实现条件,不是另一套几何损失。DINOv2 是图中的图像编码器。