快速导读:Self-Adaptive VLA 用漂移条件下的上下文专家数据训练插入式编码器,使 VLA 能在部署时凭借自身 rollout 迭代补偿未知硬件漂移。
Vision-Language-Action(VLA)在大规模机器人数据上很能打,但多数策略几乎无记忆:部署时一旦出现磨损、装配公差或标定漂移,就会反复犯同一类错,而现场又很难每次人工重标定。UMass Amherst 与 Genesis AI 的 Self-Adaptive VLA(arXiv:2609.30092)给出一条后训练配方:让策略在部署时把自己的失败 rollout 当作上下文,迭代补偿未知硬件漂移。
做法分三步:先在刻意注入的硬件漂移下收集策略 rollout;再把原专家演示改写成“漂移上下文 + 预补偿专家动作”的条件数据;最后训练一个轻量插入式上下文编码器,把视觉、本体感觉与动作序列压成 context token,经 AdaLN 调制扩散 Transformer 策略。测试时可对多轮 token 求和做集成,逐步定位并纠正过补偿/欠补偿。项目页 https://icefoxzhx.github.io/self-adaptive-vla。本文聚焦配置空间可建模的硬件漂移,不是任意环境干扰的万能适应器。
英文题目:Self-Adaptive VLA for Robust Robot Deployment
论文出处:arXiv 每日论文精选 · arXiv:2609.30092
原始论文:PDF / 论文页面
这篇论文解决什么问题?
人类看到连续失败会调整,但无记忆或短上下文 VLA 对重复失败模式几乎“看不见”,难以在多样部署条件下自愈(第1页)。
硬件漂移在机器人尤其常见:制造公差、磨损、工作站搬迁都会让同一策略掉点;若每次都靠现场校准,规模化部署成本过高(Fig.1a)。
扩展上下文窗口、测试时训练或跨试验记忆等方法能缓解,但仍需在“推理开销、可插入任意 DiT-VLA、能否迭代纠偏”之间取舍;作者选择后训练插入式上下文,而不是重训整个基础策略。
核心创新
- 提出面向部署硬件漂移的 VLA 后训练自适配配方。
- 自动把标准专家演示改写成硬件漂移上下文条件数据。
- 插入式上下文编码器 + 多轮 token 集成,推理几乎零额外开销。
- 在多任务、多硬件与新工作站迁移上显示稳健恢复。
方法概览
收集注入漂移 rollout,预补偿专家动作构成条件数据;训练轻量 Context Encoder 压成 token,经 AdaLN 调制 DiT-VLA;测试时对多轮 token 求和迭代纠偏。
- 数据:用基策略在注入漂移 δ 下 rollout 得到 D_shift;把基数据集中专家动作按已知漂移预补偿,得到与上下文配对的条件专家演示 D_contextualized(Fig.2a,第3–4页)。
- 架构:Context Encoder 接收多相机图像序列、关节状态与动作,经 ViT/投影器、类型嵌入、自注意力与 multi-head attention pooling(可学习 query)输出单个 context token;该 token 与扩散时间步相加后,经 AdaLN 调制各 DiT block(Fig.2b、Fig.3)。
- 训练:上下文编码器与基策略用同一条件流匹配损失;设计解耦后,推理时 token 算完即可,闭环控制几乎零额外开销。
- 测试时集成:多轮失败/部分成功 rollout 各自编码后求和,形成累积上下文,使策略能逐步识别漂移并修正过/欠补偿(Fig.2c、Fig.1b)。
逐图理解论文
失败模式
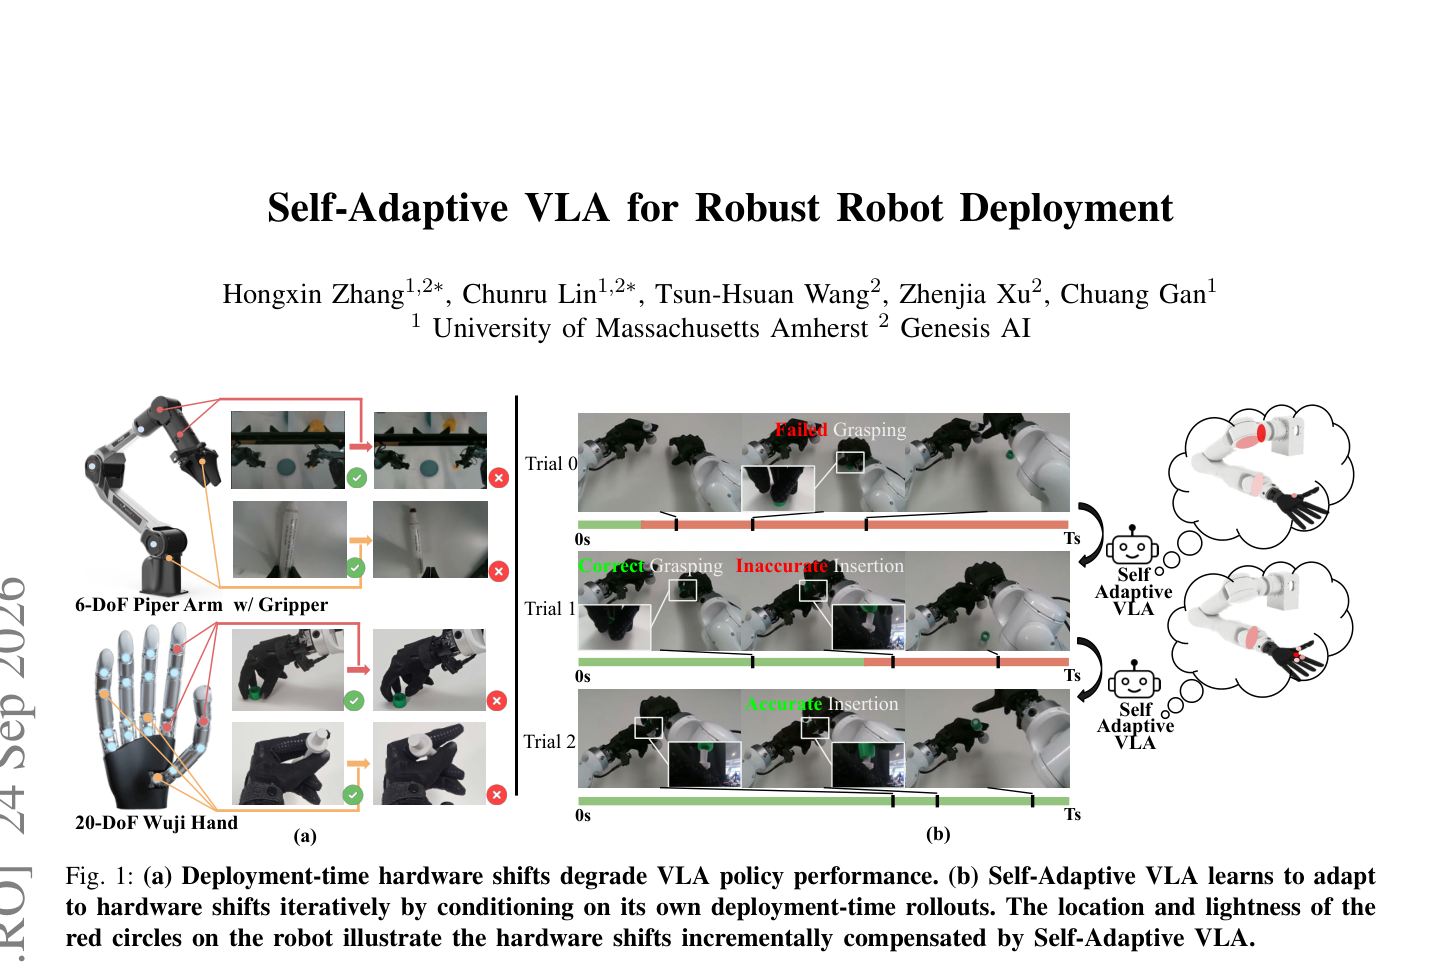
Fig.1:(a) Piper 臂与 Wuji 手上标注可能漂移关节,展示同一任务成功/失败对照;(b) Trial0 抓取失败→Trial1 抓取对但插入偏→Trial2 精确插入,红色圆点由亮到消失表示漂移被逐步补偿。适合开场讲“部署漂移 + 迭代自适配”。
方法总览
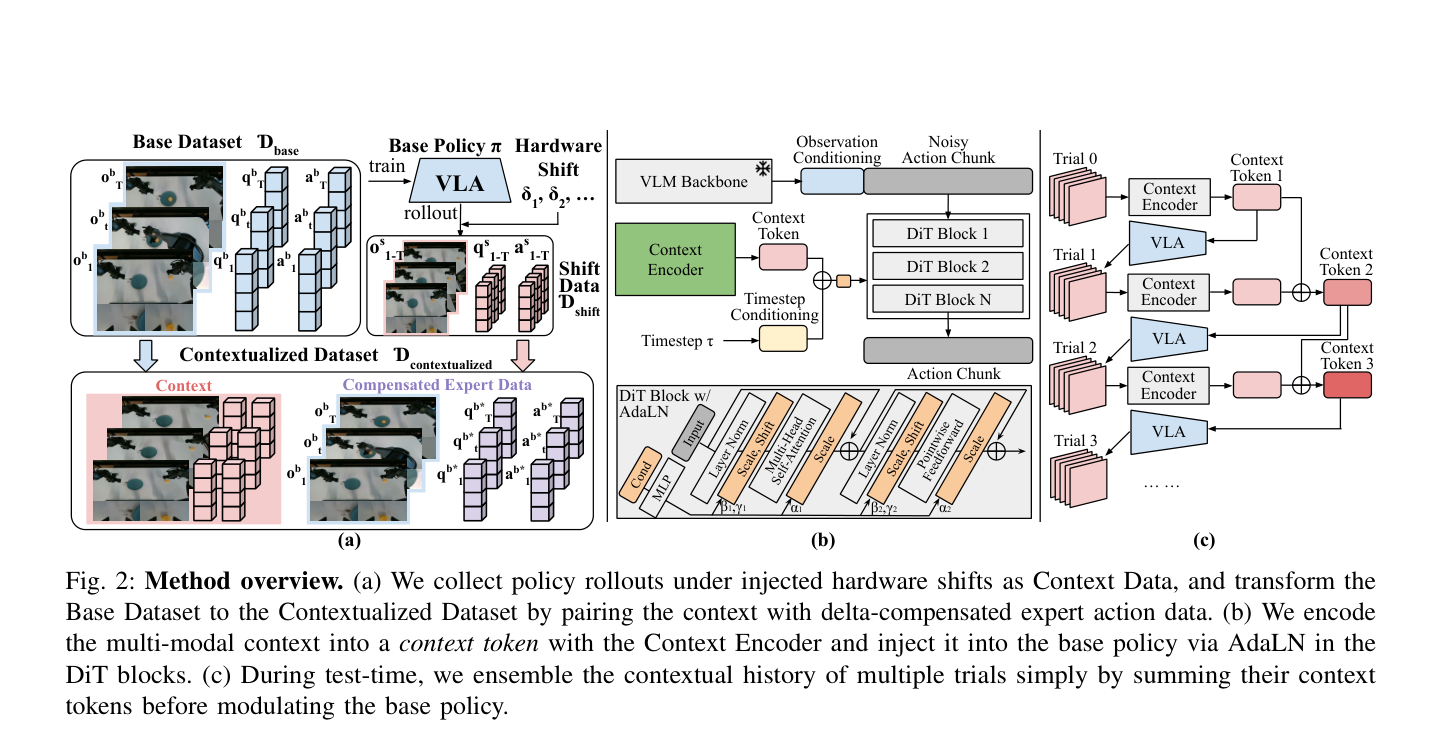
Fig.2 方法三块:(a) 基数据+注入漂移 rollout→上下文条件专家数据;(b) Context Encoder 产出 token,经 AdaLN 进 DiT;(c) 测试时多轮 token 求和集成。适合作为方法主图与特色图。
编码器与集成
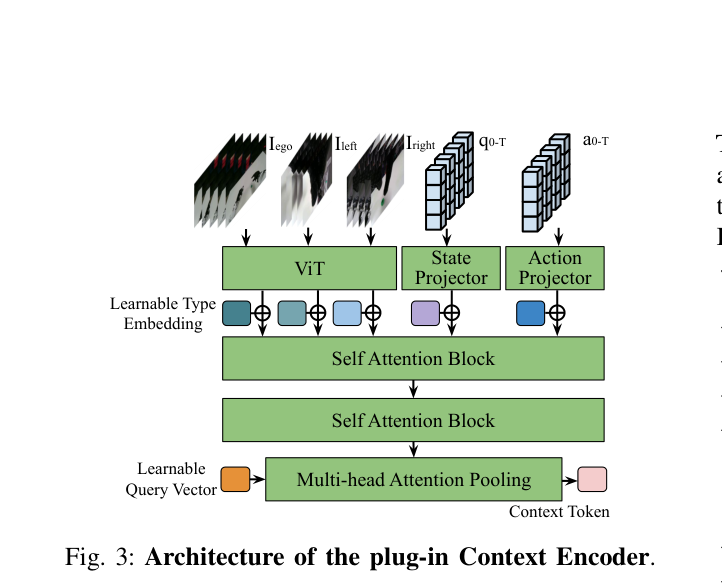
Fig.3 插入式 Context Encoder:多视角图像进 ViT,状态/动作进投影器,加类型嵌入后经两层自注意力,再用可学习 query 做 multi-head attention pooling,输出单个 Context Token。解释“轻量、可插入、推理几乎零开销”的结构来源。
实验如何设计?
- 任务:Transport Corn、Insert Tube、Cap Marker、Assemble Ring 四类精密操作;硬件含 6-DoF Piper 臂与 20-DoF Wuji 灵巧手等设定。
- 漂移类型:actuation bias 与 joint encoder offset;每设置平均 20 次,允许最多 6 轮试验;报告成功率与相对基线跌幅的恢复比 ρ(Table I,第5页)。
- 基线:记忆无关 Base;Base+Shift Data(有漂移数据但无上下文编码器);Gated Memory Policy;以及 Self-Adaptive VLA / Ours+Ensemble。
- 补充:上下文编码器消融、多轮成功率曲线、新工作站零校准迁移、上下文 token 的余弦相似与 PCA 结构分析(Fig.6–9)。
关键结果与论文证据
- 名义标定下 Base 四任务均成功约 88.8%。actuation bias 下 Base 均成功仅 7.5%;Ours+Ensemble 升至 72.5%(恢复比约 80%)。joint encoder offset 下 Base 5.0%,Ensemble 75.0%(约 84%)(Table I)。
- 单轮 Self-Adaptive VLA 已明显超过 Base+Shift Data;加 Ensemble 后在 Transport Corn 两类漂移均可回到 100%,Assemble Ring 在 encoder offset 下到 90%。
- Cap Marker 上成功率随试验轮数上升,显示迭代上下文有效(Fig.6);定性时间线可见从抓取失败→抓取成功但插入不准→最终完成(Fig.5、Fig.1b)。
- 新工作站无校准迁移:Assemble Ring 上 Base 从训练站 95% 掉到 70%/10%;最多 2 轮上下文后 Self-Adaptive VLA 恢复到 90%/50%(Fig.9)。
- 学到的 context token 近似按漂移轴分离:同轴正负符号余弦约 −0.987〜−0.991,跨类型近 0;PCA 显示类内散布 0.27、类心距 10.27,有效维数约等于漂移轴数(Fig.7)。
阅读时需要注意
- 当前主要覆盖可在机器人配置空间直接建模的漂移(驱动偏差、关节编码器偏置等),相机标定误差等更广环境差异仍待扩展(第8页)。
- 把次优轨迹压成静态 token 消除了闭环额外开销,但也排除了试次内在线改上下文;假设允许安全采集次优 rollout,安全关键任务可能不成立。
- 需要先做带注入漂移的后训练数据构造,不是纯零样本即插即用。
- 恢复比依赖基线跌幅定义,跨论文横向对比需统一协议。
关联工作
- 相对加长上下文或 TTT 序列历史,本文强调插入式 token + 多轮集成,推理期几乎无额外算力。
- Gated Memory Policy 作为跨试验记忆强基线;Base+Shift Data 说明“只看漂移数据、没有条件上下文”不够。
- 与 RMA 等快速运动适应工作同属部署适应叙事,但对象是操作 VLA 与硬件漂移后训练。